【优选算法篇】揭秘快速排序:分治算法如何突破性能瓶颈(上篇)

【优选算法篇】揭秘快速排序:分治算法如何突破性能瓶颈(上篇)
熬夜学编程的小王
发布于 2024-12-24 10:21:58
发布于 2024-12-24 10:21:58
须知
💬 欢迎讨论:如果你在学习过程中有任何问题或想法,欢迎在评论区留言,我们一起交流学习。你的支持是我继续创作的动力! 👍 点赞、收藏与分享:觉得这篇文章对你有帮助吗?别忘了点赞、收藏并分享给更多的小伙伴哦!你们的支持是我不断进步的动力! 🚀 分享给更多人:如果你觉得这篇文章对你有帮助,欢迎分享给更多对C++算法感兴趣的朋友,让我们一起进步!
1. C++ 分治(快速排序)算法 详解
1.1 模拟 分治(快速排序) 的重要性
分治法是一种非常高效的算法设计策略,广泛应用于计算机科学的多个领域,尤其是在解决复杂问题时,它通过将大问题拆解成更小的子问题来降低问题的复杂度。快速排序(QuickSort)是分治法中的经典例子,能够在许多实际场景中提升性能。它的重要性体现在以下几个方面:
- 时间复杂度优化:分治法通过拆解问题,使得大规模问题能够分步解决,从而显著提高计算效率。比如快速排序的平均时间复杂度为O(n log n),优于许多传统排序算法(如冒泡排序、插入排序)O(n²)的时间复杂度。
- 提高算法的可扩展性:分治法能够有效地应对大规模数据集,许多现代应用都依赖于这种方法来优化性能,如大数据处理、数据库查询等。
- 简化问题的求解:分治法将复杂问题拆分成多个简单的子问题,通过递归或迭代逐步求解,最终汇总结果,极大地简化了解决问题的过程。
1.2 分治法的定义
**分治法(Divide and Conquer)**是一种通过递归将一个问题分解成多个子问题的算法设计策略。这些子问题通常是原问题的规模较小的变体,并且这些子问题的求解方式与原问题相同。每个子问题得到解后,再将结果合并成原问题的解。
分治法的步骤包括:
- 分解(Divide):将一个大问题分解为多个规模较小、相似的子问题。
- 求解(Conquer):递归地解决这些子问题,通常子问题的规模逐渐变小,直到达到基准情况。
- 合并(Combine):将子问题的解合并成原问题的解。
1.3 分治法的核心思想
分治法的核心思想是**“将大问题拆解为多个小问题,再通过递归解决小问题,最后将结果合并”**。这一思路的关键在于能够有效地将问题拆解成更易于解决的部分,并利用递归的方式进行求解。
对于快速排序(QuickSort)来说,分治法的应用非常典型,它通过如下步骤执行:
- 选定基准元素(Pivot):从待排序的数组中选择一个元素作为“基准元素”。
- 划分(Partition):将数组中的其他元素根据基准元素的大小进行分组。具体来说,把比基准元素小的放在基准元素的左边,把比基准元素大的放在右边。
- 递归排序:对基准元素左边和右边的子数组分别递归应用快速排序。
通过不断递归和分治,最终整个数组被排序完成。
1.4 快速排序的核心思想
快速排序是分治法的一种经典应用,它的核心思想就是通过选择基准元素,划分数组并递归地对各个子数组进行排序。
快速排序的具体步骤如下:
- 选择一个基准元素:通常选择数组的第一个元素、最后一个元素或中间的元素。
- 划分操作(Partition):通过交换数组中的元素,将小于基准元素的放在左边,大于基准元素的放在右边,并最终将基准元素放到合适的位置。
- 递归排序:递归地对基准元素左边和右边的子数组进行相同的排序操作,直到子数组的大小为1。
1.4.1 时间复杂度分析:
- 最优情况下,快速排序的时间复杂度是 O(n log n),即每次分割都能将数组对半分。
- 最坏情况下(例如每次都选择最小或最大元素作为基准),时间复杂度为 O(n²)。
1.4.2 为什么快速排序如此高效?
- 快速排序的高效性主要来自其 划分操作,通过对数组的分割,将整个排序问题分解成多个较小的子问题,避免了无意义的全数组遍历。
- 分治法可以使得每次操作都针对数据的较小部分,从而减少了操作的冗余,提高了性能。
1.5 快速排序的经典应用
快速排序广泛应用于各种需要高效排序的场景。以下是几个经典应用:
- 大数据处理:快速排序是处理大规模数据集时常用的排序算法,尤其是在数据量非常大的情况下,快速排序能显著提高数据排序的效率。
- 数据库排序:在数据库系统中,排序操作是常见的需求,尤其是在索引建立、查询优化、数据分析等过程中。快速排序通常被用作数据库中默认的排序算法之一。
- 在线算法:快速排序在处理流式数据时非常高效,能够在线处理数据并进行排序。例如,实时数据分析和流媒体数据的排序。
- 并行计算:通过分治法的思想,快速排序适合于并行化处理。多个处理器可以并行地对数据子集进行排序,最终将结果合并。
- 应用于搜索和图像处理:在需要排序的算法中,快速排序由于其较高的效率,常常应用于大规模图像处理、数据清洗以及需要频繁排序的机器学习算法中。
2. 题目1:颜色分类
题目描述:

2.1 算法思路:
这个算法通过 双指针 来解决问题,利用一个 left 指针来管理所有 0 的位置,一个 right 指针来管理所有 2 的位置,i 指针用来遍历数组。通过这三个指针的移动,逐步调整数组元素的顺序。
具体步骤如下:
- 初始化指针:
left: 用来标记当前数组中0的末尾。初始值为-1。right: 用来标记当前数组中2的起始位置。初始值为nums.size(),即数组的长度。i: 用来遍历整个数组,指向当前处理的元素。
- 遍历数组并交换元素:
- 当
nums[i] == 0时,表示当前元素是0,将其与left + 1位置的元素交换(left增加),然后i继续向右移动。 - 当
nums[i] == 2时,表示当前元素是2,将其与right - 1位置的元素交换(right减少),但是由于交换后的元素需要重新判断,所以i不增加。 - 当
nums[i] == 1时,表示当前元素是1,无需交换,只需要将i增加,继续检查下一个元素。
- 当
- 终止条件: 当
i大于等于right时,表示数组已经被完全排序,退出循环。
2.2 代码示例:
class Solution {
public:
    void sortColors(vector<int>& nums) {
        // 初始化指针
        int left = -1;          // left指针表示当前0的最后位置,初始为-1(即0还没被放置)
        int right = nums.size();  // right指针表示当前2的开始位置,初始为数组长度
        int i = 0;               // i为遍历指针,从数组的开头开始

        // 当i小于right时继续遍历,i表示当前处理的位置,right表示处理2的边界
        while (i < right) {
            if (nums[i] == 2) {
                // 如果当前元素是2,将其放到right-1位置,并将right指针向左移动
                // 交换nums[i]和nums[right-1]的值,right减小,继续处理交换后的元素
                swap(nums[--right], nums[i]);
            }
            else if (nums[i] == 0) {
                // 如果当前元素是0,将其放到left+1位置,并将left指针向右移动
                // 同时i向右移动继续处理下一个元素
                swap(nums[++left], nums[i++]);
            }
            else if (nums[i] == 1) {
                // 如果当前元素是1,不需要交换,i指针向右移动,继续处理下一个元素
                i++;
            }
        }
    }
};
2.2.1 注释详细解释:
- 初始化指针:
left初始化为-1,代表数组中0的最后一个位置。因为在最开始0还没有被放置。right初始化为数组长度,表示数组中2的起始位置。right会从右向左移动,直到遍历完成。i初始化为0,指向当前正在处理的元素。
- 遍历数组:
while (i < right):当i小于right时,继续遍历数组。如果i超过right,表示所有元素已经排序完成。
- 处理
nums[i] == 2:- 如果当前元素是
2,将其交换到right-1位置,并将right向左移动。 swap(nums[--right], nums[i]);:交换当前元素和right-1位置的元素。此时right减少,表示2的区域已经确定,避免处理已经排序好的部分。
- 如果当前元素是
- 处理
nums[i] == 0:- 如果当前元素是
0,将其放到left+1位置,表示已找到一个0,并且left向右移动,指向下一个可插入0的位置。 swap(nums[++left], nums[i++]);:将当前元素交换到left+1位置,并且i向右移动,因为交换后当前位置的元素已经正确排序。
- 如果当前元素是
- 处理
nums[i] == 1:- 如果当前元素是
1,则不需要交换。直接将i向右移动,继续处理下一个元素。
- 如果当前元素是
2.2.2 运行流程:
- 通过三个指针
i、left和right,我们将数组分成三个区域:[0, left]:所有的0。[left+1, i-1]:所有的1。[right, nums.size()-1]:所有的2。
- 每次移动
i或交换元素,确保元素正确地分配到相应的区域,最终整个数组按照0、1、2排序。
例子:
假设输入为 nums = [2, 0, 2, 1, 1, 0]:
- 初始化:
left = -1, right = 6, i = 0
- 第一轮遍历(i = 0):
nums[i] == 2,将nums[5]和nums[0]交换,right--,数组变为[0, 0, 2, 1, 1, 2],right = 5。
- 第二轮遍历(i = 0):
nums[i] == 0,将nums[0]和nums[0]交换,left++,i++,left = 0,i = 1。
- 第三轮遍历(i = 1):
nums[i] == 0,将nums[1]和nums[1]交换,left++,i++,left = 1,i = 2。
- 第四轮遍历(i = 2):
nums[i] == 2,将nums[4]和nums[2]交换,right--,数组变为[0, 0, 1, 1, 2, 2],right = 4。
- 第五轮遍历(i = 2):
nums[i] == 1,直接i++,i = 3。
- 第六轮遍历(i = 3):
nums[i] == 1,直接i++,i = 4。
- 结束:
- 当
i = right时,循环结束,数组已经排序完成。
- 当
最终排序结果:[0, 0, 1, 1, 2, 2]
2.3 多种解法
2.3.1 解法 2:计数排序
计数排序是一个简单直接的解法,时间复杂度为 O(n),空间复杂度为 O(1)(如果我们忽略计数数组的常数空间)。
思路:
我们可以利用计数排序的方法,首先统计 0、1 和 2 的数量,然后按照数量依次填充数组。
代码实现:
class Solution {
public:
    void sortColors(vector<int>& nums) {
        int count[3] = {0};  // 记录 0, 1, 2 的数量

        // 统计每个元素的个数
        for (int num : nums) {
            count[num]++;
        }

        // 根据计数结果填充数组
        int idx = 0;
        for (int i = 0; i < 3; i++) {
            while (count[i] > 0) {
                nums[idx++] = i;
                count[i]--;
            }
        }
    }
};
解释:
- 我们首先用一个大小为
3的数组count来记录0、1和2的出现次数。 - 然后根据
count数组中的数量依次将元素放回原数组,完成排序。
这种方法虽然简单,但会用到额外的空间来存储计数数组。
2.3.2 解法 3:两次遍历(插入排序)
插入排序是一种简单的排序方法,但它的时间复杂度较高,不太适合这个问题。不过,在数组大小比较小或者元素种类较少时,它可能会比较简洁。
思路:
- 第一次遍历,找出所有
0并把它们排到前面。 - 第二次遍历,处理剩下的元素,找出所有
1并把它们放到中间。
代码实现:
class Solution {
public:
    void sortColors(vector<int>& nums) {
        int count0 = 0, count1 = 0, count2 = 0;

        // 统计各个数字的出现次数
        for (int num : nums) {
            if (num == 0) count0++;
            else if (num == 1) count1++;
            else if (num == 2) count2++;
        }

        // 填充数组
        int idx = 0;
        while (count0--) nums[idx++] = 0;
        while (count1--) nums[idx++] = 1;
        while (count2--) nums[idx++] = 2;
    }
};
解释:
- 使用
count0、count1和count2来统计0、1和2的数量。 - 然后通过
while循环将每个数字按照其出现的次数填回到数组中。
2.3.3 解法 4:暴力排序(冒泡排序/快速排序等)
这种方法的时间复杂度通常较高,最坏情况下为 O(n²),但可以通过常见的排序算法(如冒泡排序、快速排序)来实现。
思路:
我们可以将数组按常规排序算法进行排序,然后根据 0、1 和 2 排列的顺序获得结果。
代码实现(使用 C++ sort()):
class Solution {
public:
    void sortColors(vector<int>& nums) {
        sort(nums.begin(), nums.end());
    }
};
解释:
通过使用 C++ 的标准库 sort() 函数,快速对数组进行排序。虽然这种方法简单,但它的时间复杂度为 O(n log n),比荷兰国旗问题的解法效率稍低。
2.3.4 总结:
- 荷兰国旗问题(三指针法):这是最高效的解法,时间复杂度为 O(n),空间复杂度为 O(1),适用于大部分情况。
- 计数排序:通过统计每个数字的频率来排序,时间复杂度为 O(n),空间复杂度为 O(1)(不考虑计数数组)。
- 两次遍历(插入排序):适用于小规模数据,空间复杂度低,但时间复杂度相对较高。
- 暴力排序:利用现有的排序算法(如快速排序、归并排序等),时间复杂度通常为 O(n log n),但可能会浪费更多的计算资源。
建议:
对于此题,推荐使用 荷兰国旗问题法,它不仅时间复杂度最优,而且空间复杂度也最小。
2.4 总结:
这段代码通过巧妙地使用三个指针实现了对只有 0、1、2 的数组进行排序。它是一种非常高效的 荷兰国旗问题(Dutch National Flag Problem)的解法,时间复杂度为 O(n),空间复杂度为 O(1),并且通过原地排序减少了额外的空间使用。
3. 题目2:排序数组
题目描述:
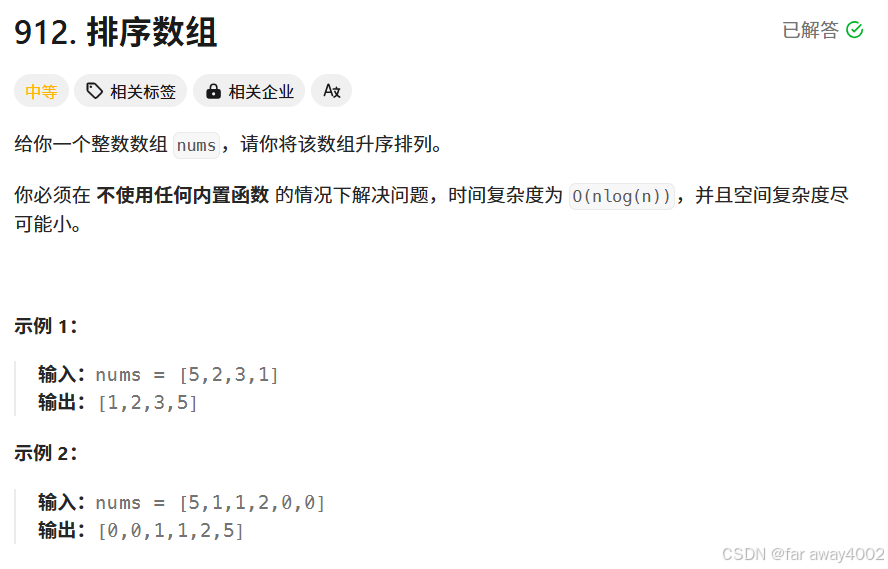
3.1 算法思路:
这段代码是使用 随机化快速排序(Randomized Quick Sort) 的方式进行排序。与普通的快速排序不同,随机化快速排序通过随机选择 pivot 来避免排序时遇到最坏情况(例如已经有序的数组)。这种方式能够确保平均情况下快速排序的时间复杂度保持在 O(nlog n),并且极大地降低了退化为 O(n²) 的概率。
快速排序概述:
- 选择一个 pivot 元素,然后将数组按照这个 pivot 划分成两个部分:左侧部分的元素都比 pivot 小,右侧部分的元素都比 pivot 大。
- 递归地排序 这个两部分数组。
3.2 代码示例:
class Solution {
public:
    // 主函数,返回排序后的数组
    vector<int> sortArray(vector<int>& nums) {
        srand(time(NULL));  // 使用当前时间作为随机数生成器的种子
        qsort(nums, 0, nums.size() - 1);  // 调用递归快速排序函数
        return nums;  // 返回排序后的数组
    }

    // 快速排序的递归实现
    void qsort(vector<int>& nums, int l, int r) {
        if (l >= r)  // 递归结束条件,当左指针大于或等于右指针时,无需排序
            return;

        int k = getRandom(nums, l, r);  // 随机选择一个枢纽元素
        int left = l - 1, i = l, right = r + 1;  // 初始化指针,left指向枢纽元素左侧,right指向枢纽元素右侧,i用于遍历

        // 分区过程,将元素分为小于、等于、大于枢纽的三部分
        while (i < right) {
            if (nums[i] < k) {  // 当前元素小于枢纽元素
                swap(nums[++left], nums[i++]);  // 将该元素交换到小于枢纽元素区,并移动i
            } else if (nums[i] == k) {  // 当前元素等于枢纽元素
                i++;  // 直接跳过该元素,因为它已经在正确的区域
            } else {  // 当前元素大于枢纽元素
                swap(nums[--right], nums[i]);  // 将该元素交换到大于枢纽元素区,并移动right
            }
        }

        // 递归调用,对左部分和右部分继续进行快速排序
        qsort(nums, l, left);  // 排序小于枢纽元素的部分
        qsort(nums, right, r);  // 排序大于枢纽元素的部分
    }

    // 获取一个随机的枢纽元素
    int getRandom(vector<int>& nums, int left, int right) {
        int n = rand();  // 获取一个随机数
        return nums[n % (right - left + 1) + left];  // 通过随机数选择一个在[left, right]范围内的元素
    }
};
3.2.1 代码详细解释:
1. sortArray 函数:
- 作用: 这是主函数,负责调用
qsort来执行快速排序,并返回排序后的数组。 -
srand(time(NULL)):使用time(NULL)获取当前时间作为随机数生成的种子,确保每次程序运行时,随机数生成器的种子不同。 -
qsort(nums, 0, nums.size() - 1):调用qsort函数,对整个数组进行排序,0和nums.size() - 1表示数组的左右边界。
2. qsort 函数:
- 作用: 这是快速排序的递归实现。它将数组分为三部分:小于枢纽、等于枢纽、大于枢纽。
-
if (l >= r):当左边界大于或等于右边界时,表示该部分数组已经是有序的,不需要继续排序。 -
getRandom(nums, l, r):在每一轮排序中,通过调用getRandom随机选择一个枢纽元素,避免排序退化为最坏情况。 -
left = l - 1, i = l, right = r + 1:初始化三个指针:-
left:指向左侧区域的最后一个元素的前一个位置。 -
i:当前遍历的元素。 -
right:指向右侧区域的第一个元素的后一个位置。
-
-
while (i < right):通过i遍历数组:-
nums[i] < k:如果当前元素小于枢纽元素,则将其移到left区域,left和i同时向右移动。 -
nums[i] == k:如果当前元素等于枢纽元素,i向右移动,继续遍历。 -
nums[i] > k:如果当前元素大于枢纽元素,则将其移到right区域,right向左移动,i不变,因为交换后需要重新判断该元素。
-
-
qsort(nums, l, left)和qsort(nums, right, r):分别递归地对小于枢纽部分和大于枢纽部分进行快速排序。
3. getRandom 函数:
- 作用: 随机选择一个枢纽元素,用于分区操作。
-
int n = rand():生成一个随机数。 -
return nums[n % (right - left + 1) + left]:使用随机数对[left, right]区间内的索引进行取模,确保生成的随机索引在指定范围内,返回对应位置的元素。
3.3.2 工作流程:
- 在每一轮排序中,
qsort会随机选择一个枢纽元素k。 - 然后,通过遍历
i,将小于k的元素移动到left区域,大于k的元素移动到right区域,等于k的元素保持不变。 - 递归地对左半部分和右半部分继续进行快速排序。
- 随机选择枢纽元素可以避免快速排序在最坏情况下退化为 O(n^2),提高排序效率。
3.3 多种解法
3.3.1 解法 2:使用 C++ 内置排序 (快速排序)
C++ STL 提供了非常高效的排序函数 std::sort,底层使用的是 快速排序 或 堆排序,通常会选择最适合的数据结构来实现排序。这个方法的时间复杂度通常为 O(n log n),空间复杂度为 O(log n)(递归调用栈的空间)。
代码实现:
class Solution {
public:
    vector<int> sortArray(vector<int>& nums) {
        sort(nums.begin(), nums.end());  // 使用 C++ STL 的 sort 排序
        return nums;
    }
};
解释:
-
sort(nums.begin(), nums.end()):直接调用 STL 中的sort函数进行排序。 - 由于
std::sort是基于快速排序、归并排序或堆排序实现的,效率非常高。
时间复杂度:
- 最坏情况:O(n log n)(基于快速排序和堆排序的平均性能)。
- 平均情况:O(n log n)。
空间复杂度:
- O(log n)(递归栈空间)。
3.3.2 解法 3:归并排序
归并排序是一种典型的分治算法,时间复杂度始终为 O(n log n),并且在最坏情况下也能保持这种性能。归并排序的空间复杂度较高,需要 O(n) 的额外空间。
代码实现:
class Solution {
public:
    vector<int> sortArray(vector<int>& nums) {
        mergeSort(nums, 0, nums.size() - 1);
        return nums;
    }

    void mergeSort(vector<int>& nums, int left, int right) {
        if (left >= right) return;
        int mid = left + (right - left) / 2;
        mergeSort(nums, left, mid);  // 对左半部分递归排序
        mergeSort(nums, mid + 1, right);  // 对右半部分递归排序
        merge(nums, left, mid, right);  // 合并两部分
    }

    void merge(vector<int>& nums, int left, int mid, int right) {
        int n1 = mid - left + 1, n2 = right - mid;
        vector<int> leftArr(n1), rightArr(n2);

        // 拷贝数据到临时数组
        for (int i = 0; i < n1; i++) leftArr[i] = nums[left + i];
        for (int i = 0; i < n2; i++) rightArr[i] = nums[mid + 1 + i];

        // 合并临时数组
        int i = 0, j = 0, k = left;
        while (i < n1 && j < n2) {
            if (leftArr[i] <= rightArr[j]) {
                nums[k++] = leftArr[i++];
            } else {
                nums[k++] = rightArr[j++];
            }
        }

        // 如果左半部分还有剩余,直接复制到 nums
        while (i < n1) {
            nums[k++] = leftArr[i++];
        }

        // 如果右半部分还有剩余,直接复制到 nums
        while (j < n2) {
            nums[k++] = rightArr[j++];
        }
    }
};
解释:
-
mergeSort:递归地将数组分成两部分,直到每部分包含一个元素。 -
merge:合并两个已排序的子数组。
时间复杂度:
- 最坏情况:O(n log n)。
- 平均情况:O(n log n)。
空间复杂度:
- O(n),因为需要额外的空间来存储临时数组。
3.3.3 解法 4:堆排序
堆排序是一种基于完全二叉树的排序算法,其时间复杂度为 O(n log n),适用于大规模数据的排序。堆排序是一种不稳定的排序。
代码实现:
class Solution {
public:
    vector<int> sortArray(vector<int>& nums) {
        heapSort(nums);
        return nums;
    }

    void heapSort(vector<int>& nums) {
        int n = nums.size();

        // 构建大顶堆
        for (int i = n / 2 - 1; i >= 0; i--) {
            heapify(nums, n, i);
        }

        // 逐步交换堆顶元素与最后一个元素,并重新调整堆
        for (int i = n - 1; i >= 1; i--) {
            swap(nums[0], nums[i]);
            heapify(nums, i, 0);  // 调整堆
        }
    }

    void heapify(vector<int>& nums, int n, int i) {
        int largest = i;
        int left = 2 * i + 1;
        int right = 2 * i + 2;

        if (left < n && nums[left] > nums[largest]) {
            largest = left;
        }
        if (right < n && nums[right] > nums[largest]) {
            largest = right;
        }

        if (largest != i) {
            swap(nums[i], nums[largest]);
            heapify(nums, n, largest);  // 递归调整
        }
    }
};
解释:
-
heapSort:首先构建大顶堆,然后交换堆顶元素与数组最后一个元素,逐步缩小堆的范围并调整堆。 -
heapify:维护堆的性质,通过递归调整堆结构。
时间复杂度:
- 最坏情况:O(n log n)。
- 平均情况:O(n log n)。
空间复杂度:
- O(1),因为堆排序是原地排序。
3.3.4 总结:
- 内置排序(如
std::sort)是最简单且高效的实现,适用于大多数情况。 - 快速排序和归并排序通常具有 O(n log n) 的时间复杂度,归并排序需要额外的空间,而快速排序则依赖于递归栈空间。
- 堆排序也是一种 O(n log n) 的排序方法,但它不稳定,且空间复杂度较低,适用于内存有限的情况。
3.4 复杂度分析:
- 时间复杂度:
- 最坏情况下,快速排序的时间复杂度为 O(n²),但由于随机选择枢纽的方式,期望时间复杂度为 O(nlogn)。
- 空间复杂度:
- 空间复杂度为 O(log n),因为递归的深度取决于数组的大小。
3.5 优化建议:
- 虽然随机选择枢纽有助于避免最坏情况,但在一些极端情况下,快速排序的性能仍然会受到影响。因此,在实现中,我们通常会结合使用 三数取中(median of three)来选择枢纽,从而进一步优化性能。
4. 总结:
分治法作为一种基础而高效的算法设计策略,广泛应用于计算机科学中的排序、查找、矩阵运算等问题。快速排序作为分治法的经典应用,通过高效的分解和递归策略,将一个庞大的排序问题转化为多个小问题,从而实现了高效排序。无论在理论研究还是实践应用中,分治法和快速排序都是不可或缺的核心工具。
5. 最后
- 快速排序 是一种高效的排序算法,通过分治法和基准元素的选择,具有平均 O(n log n) 的时间复杂度。
- 颜色分类问题 使用双指针法(荷兰国旗问题)来处理 0、1、2 排序问题,效率高且空间复杂度低。
- 对于大多数排序问题,快速排序是常见的解决方案,但在一些特定情况下(如已排序数据),需要采取随机化方法。
路虽远,行则将至;事虽难,做则必成
亲爱的读者们,下一篇文章再会!!!
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2024-12-21,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号