七条 SubAgent 编排黄金规则!让最贵的模型只"动嘴",账单立降一半

七条 SubAgent 编排黄金规则!让最贵的模型只"动嘴",账单立降一半
Tinywan
发布于 2026-09-15 14:33:29
发布于 2026-09-15 14:33:29
七条 SubAgent 编排黄金规则
写在前面:最近在群里看到不少朋友问同一个问题——大模型 token 消耗太快,怎么压下来?讨论到最后,绕不开的答案都是"用 subagent 分流"。正好我把这套打法实测沉淀成了完整规则,于是专门写了这篇文章,把编排思路、三种组合的配置、实战验收方法一次讲透。
文 / Tinywan
让最贵的模型从头干到尾,是最常见的用法,也是最浪费的用法。本文分享一套在实际使用中沉淀下来的多模型编排规则:贵的模型只做"动嘴"的活,便宜的模型负责"动手",主 Agent 只做需求澄清、方案拆解、任务分发、结果验收,实现类工作一律派给 subagent。文末附完整的实战测试验收流程。
01 问题:贵模型"全包"又慢又烧钱
用旗舰大模型跑完整的编码任务,你会遇到两个绕不开的问题:
第一,慢。旗舰模型的思考量大、生成详尽,端到端耗时明显更长。让它一个人读完几千行代码再动手改,等待时间长得让人想关掉终端。
第二,贵。旗舰模型的输出单价往往是中档模型的两倍甚至二十倍。而一个编码任务里,真正"值钱"的部分——需求理解、方案拆解、结果把关——可能只占全部 token 的 10%,剩下的 90% 是读文件、写样板代码、跑测试这种"体力活"。
换句话说:我们花旗舰的价格,买了大量"体力劳动"。这笔账显然不划算。
02 核心思路:贵模型编排,便宜模型执行
解法很直接:把任务拆成两类角色。主 Agent(编排者)= 贵模型,只做需求澄清、方案拆解、任务分发、结果验收,token 消耗极低,但每一步都在刀刃上;SubAgent(执行者)= 便宜模型,承接所有实现类工作:读大量代码、写代码、跑测试、批量修改,单价低、速度快,有的还支持高并发和超长上下文。
这个分工成立的前提是:编排恰恰是便宜模型做不好的事——拆解模糊需求、识别任务边界、判断结果是否达标,这些都需要最强的推理能力;而一旦任务被描述清楚,执行本身并不需要旗舰智商。
导读:下面先给七条通用规则,再给三种模型组合的完整配置(可直接复制),然后用一次真实测试演示如何验收编排是否生效,最后列出六个常见误区。
03 七条通用编排规则(三种组合通用)
不管用哪家的模型组合,下面七条规则都适用。它们是踩坑之后总结出来的,每一条都对应一个真实的教训。
1. 先澄清,后派发。SubAgent 没有机会向用户提问,需求模糊就派发,等于让它瞎猜,返工成本更高。有疑问,主 Agent 先问清楚再动手分发。
2. 小任务豁免。改个错别字、查个函数定义,也要起一个 SubAgent?编排本身的开销比任务还贵。单文件小改动、快速查询这类低成本操作,主 Agent 自己做。
3. 独立任务并行派发。三个互不依赖的任务,串行派发要等三倍时间。编排模式的最大优势就是并行,别浪费。
4. Prompt 必须自包含。SubAgent 看不到主对话的任何上下文。每次派发都要写清楚:背景与目标、相关文件路径、约束条件、完成标准。少一样,质量就打折一样。
5. 验收不轻信汇报。SubAgent 说"完成了"不等于真完成了。主 Agent 必须自己读 diff、跑测试、核对关键结论。这是编排者最重要的一道闸。
6. 指定模型要写具体参数。"派给便宜模型"是愿望,model: xxx 才是指令。不写具体参数,模型只会按默认配置执行。
7. 验收后向用户汇报。改了什么、怎么验证的,一句话说清楚。用户不关心你派了几个 SubAgent,只关心结果可不可信。
04 三种组合的具体打法与完整配置
骨架相同,细节因"模"而异。下面以三种主流组合为例,给出分工说明和可直接复制的配置。
组合 A:Anthropic(Fable 5 编排 + Opus 执行)
Fable 5 的单价是 Opus 的两倍(约 10/50 对 5/25,每百万 token),但它长任务把控能力强,适合做多步拆解和验收。所以规则很简单:实现类工作全部用 Agent 工具指定 model: opus 派发,Fable 5 一个 token 都不许浪费在读文件写代码上。
以下以 ~/.claude/CLAUDE.md 为例,给出完整配置:
## SubAgent 编排规则(Fable 5 + Opus)
你的角色是编排者:只做需求澄清、方案拆解、任务分发、结果验收。
- 先澄清后派发:subagent 无法向用户提问,需求不明确时先问用户,确认后再派发。
- 实现类工作派给 Opus:读大量代码、写代码、跑测试、批量修改等,用 Agent 工具派发并指定 model: opus。
- 豁免:单文件小改动、快速查询、读少量文件等低成本操作,自己直接做,不要派发。
- 并行:相互独立的任务并行派发多个 Opus subagent。
- 派发要求:每个 subagent prompt 必须自包含——背景与目标、相关文件路径与关键位置、约束条件、明确的完成标准。
- 验收:不轻信 subagent 汇报。读 diff 确认改动符合预期,跑测试/构建验证,关键结论自己核查;不合格则带具体反馈重新派发。
- 汇报:验收通过后向用户简要汇总改了什么、如何验证的。
注意:不要写"当主 agent 是某某型号时"这种条件——模型识别不了自己的型号,条件分支永远不生效,直接写无条件规则。
组合 B:GPT-5.6 三档分工(Sol / Terra / Luna)
这是最适合玩"分级派发"的组合。Sol 输出 15,能力对标上代旗舰、成本减半);机械批量类任务派给 Luna(1/
以下以 ~/.codex/AGENTS.md 为例,给出完整配置:
## SubAgent 编排规则(GPT-5.6:Sol / Terra / Luna)
你的角色是编排者(Sol):只做需求澄清、方案拆解、任务分发、结果验收,使用高推理档位。
- 先澄清后派发:subagent 无法向用户提问,需求不明确时先问用户,确认后再派发。
- 分级派发:
- 编码实现类(读大量代码、写代码、跑测试)→ 派给 Terra(指定 model: terra)。
- 机械批量类(批量重命名、格式转换、文档整理、分类提取)→ 派给 Luna(指定 model: luna)。
- 豁免:单文件小改动、快速查询等低成本操作,自己直接做,不要派发。
- 并行:相互独立的任务并行派发多个 subagent。
- 派发要求:每个 subagent prompt 必须自包含——背景与目标、相关文件路径与关键位置、约束条件、明确的完成标准。
- 验收:不轻信汇报。读 diff 确认改动符合预期,跑测试/构建验证,关键结论自己核查;不合格则带具体反馈重新派发。
- 汇报:验收通过后向用户简要汇总改了什么、如何验证的。
注意:派发时按任务性质分流(编码 → Terra,机械批量 → Luna),是这套组合省钱的关键。
组合 C:国产组合(Qwen3.8-Max 编排 + DeepSeek-V4-Flash 执行)
这组的价差最悬殊:Qwen3.8-Max 的输出单价约为 DeepSeek-V4-Flash 的 20 倍以上。所以 Qwen 只做编排,实现工作全部交给 Flash(输入 ¥1/M、输出 ¥2/M,缓存命中输入仅 ¥0.02/M,还有 1M 上下文)。
以下以 ~/.qoder/AGENTS.md 为例,给出完整配置:
## SubAgent 编排规则(Qwen3.8-Max + DeepSeek-V4-Flash)
你的角色是编排者(Qwen3.8-Max):只做需求澄清、方案拆解、任务分发、结果验收。
- 先澄清后派发:subagent 无法向用户提问,需求不明确时先问用户,确认后再派发。
- 实现类工作派给 DeepSeek-V4-Flash:读大量代码、写代码、跑测试、批量修改等,用 Agent 工具派发并指定该模型。
- 豁免:单文件小改动、快速查询等低成本操作,自己直接做,不要派发。
- 并行:相互独立的任务并行派发多个 subagent(DeepSeek 支持高并发)。
- 派发要求:每个 subagent prompt 必须自包含——背景与目标、相关文件路径与关键位置、约束条件、明确的完成标准;项目背景前缀保持稳定,最大化缓存命中(缓存价仅为普通输入价的 1/50)。
- 格式要求写明确:Flash 在严格格式约束下偶有越界,派发时格式说明要具体,验收时自己逐项核对结构化输出。
- 验收:不轻信汇报。读 diff、跑测试/构建验证,关键结论自己核查;不合格直接带反馈重派(Flash 试错成本极低,宁可多验一轮)。多模态验收(截图、图表、界面审查)由你自己完成,不派给纯文本的 Flash。
- 峰谷调度:DeepSeek 自 2026-08-17 起分峰谷计价(高峰约为闲时两倍),非紧急的大批量任务尽量排在闲时执行。
- 汇报:验收通过后向用户简要汇总改了什么、如何验证的。
注意:Flash 试错成本极低,验收不合格不要纠结,直接带反馈重派,宁可多验一轮;多模态验收(截图、界面审查)由 Qwen 主 Agent 自己做。
05 实战测试验收规则
规则写进全局指令文件只是第一步,必须验证它真的生效了。下面用 Codex(组合 B)做一次完整演示,其他工具同理。记住这三步,缺一不可:
1开一个新会话
当前会话不会重新加载全局指令文件,必须新开。进入任意受信项目目录,先确认 SubAgent 规则加载了没有:
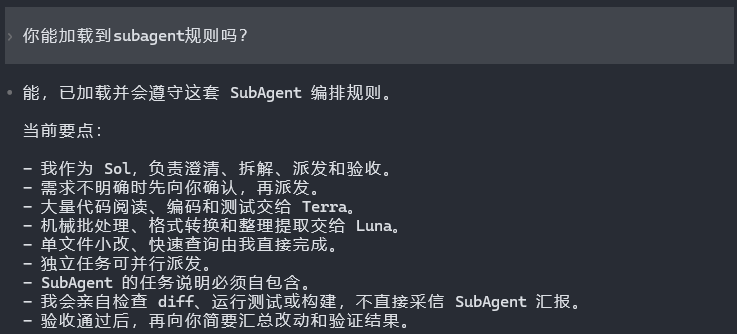
图 1 · 新会话里直接问"你能加载到 subagent 规则吗",模型复述分工:Sol 编排、Terra 编码、Luna 机械活
2给一个中等规模任务
例如:新增格式化字节函数 format_byte_size 并补测试。太小看不出派发,太大不利于定位问题。任务执行完成后,编排者给出验收汇报:
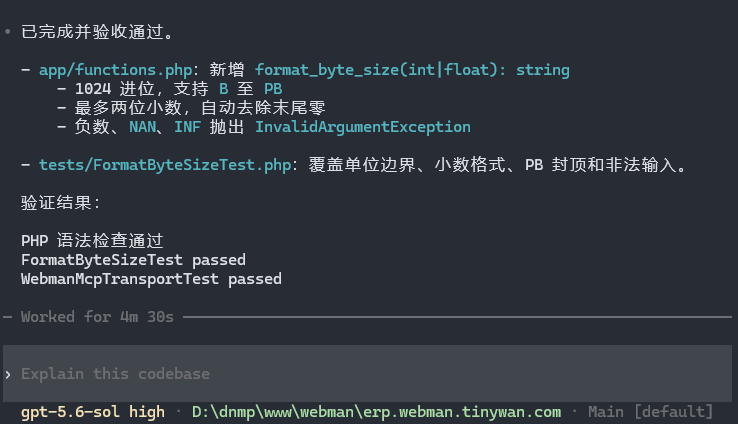
图 2 · 任务完成:新增函数 + 测试全部通过,注意状态栏主模型是 gpt-5.6-sol
3验证本次是否真的按规则执行
这是最关键的一步——不验证就等于没测试。两种方式:
方式一:直接问大模型。让它自己交代派发情况——注意这只是"汇报",按规则不能全信,用作快速 sanity check:
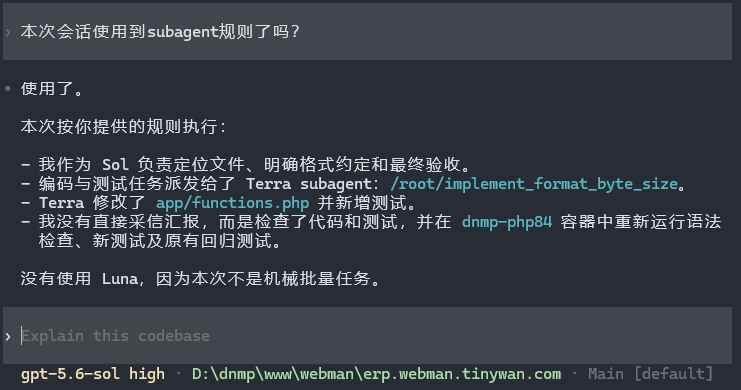
图 3 · 主 Agent 自述:Sol 定位与验收、Terra 实现并修测试、未用 Luna(因为不是机械批量任务)
方式二:查看代理后台的模型使用情况。这是最硬的证据——每条请求用了哪个模型、花了多少钱,平台记录不会骗人:
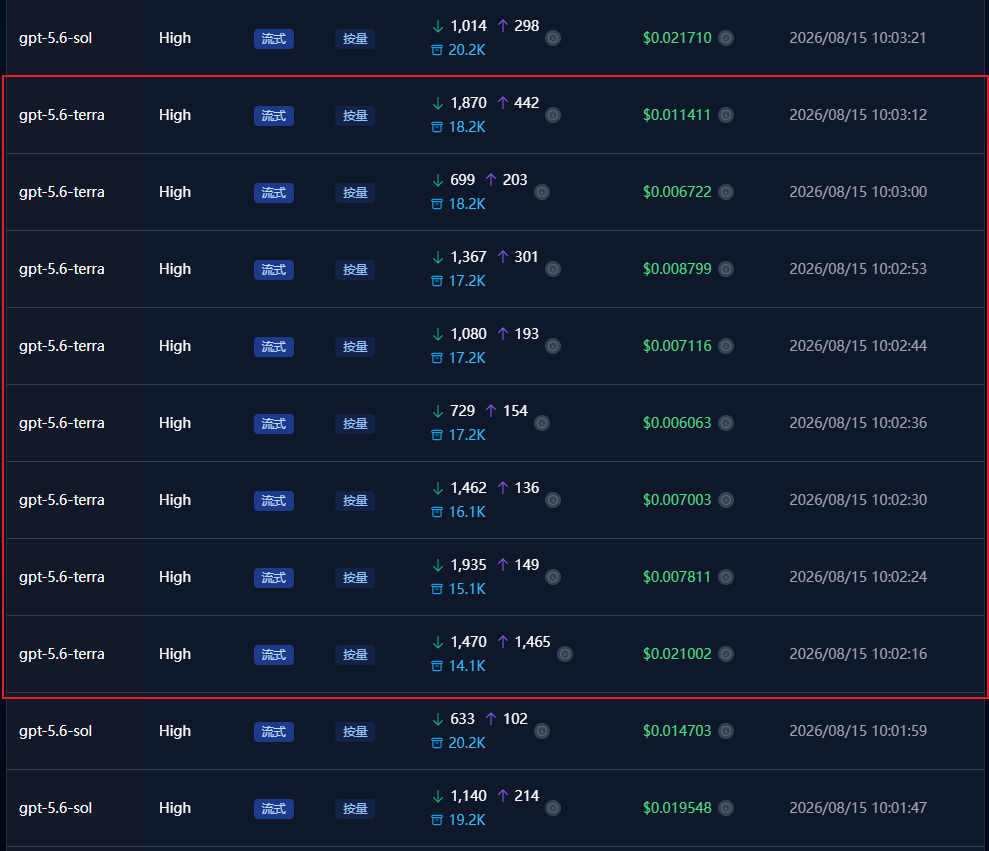
图 4 · 代理后台请求日志:首尾是 sol(编排与验收),中间红框一连串 terra(实现),分工一目了然,且 terra 单次成本最低仅 $0.006
注意:后台出现两个模型 ID 只是必要条件。还要看序列形态——首尾贵模型、中间便宜模型交替才是编排;如果只有一个切换点(前一半全 sol、后一半全 terra),那是你手动换了模型,不算编排。
没有代理后台也没关系,会话记录同样可查。Codex 的 rollout 文件每条消息都带模型字段:
# 找到当前会话的 rollout
f=$(find ~/.codex/sessions -name "rollout-*.jsonl" | tail -1)
# 统计各模型消息数:编排者应远少于执行者
grep -o '"model":"[^"]*"' "$f" | sort | uniq -c
# 看模型出现顺序:频繁交替 = 编排,单一切换点 = 手动换模型
grep -o '"model":"[^"]*"' "$f" | uniq
验收清单逐项打勾才算测试通过:① 需求模糊时先澄清再派活;② 实现类工作派发且指定了便宜模型;③ 小改动自己做、没起 subagent;④ 独立子任务并行派发;⑤ 结束后亲自读 diff / 跑测试并简要汇报。
06 六个常见误区
这些坑我都踩过,列出来帮你省点学费:
1. 写型号条件分支。"当主 agent 是 X 时……"——模型不知道自己是谁,条件永远不生效。
2. 一律派发,不设下限。小任务也派发,编排开销比任务本身还贵。
3. 派发时上下文缺失。SubAgent 看不到主对话,一句话丢过去只能得到一份瞎猜的结果。
4. 串行派发独立任务。把并行优势白白扔掉了。
5. 验收只看汇报。不读 diff、不跑测试,等于没有验收。
6. 没澄清就派发。SubAgent 问不了用户,模糊需求的代价是整轮返工。
07 写在最后
编排的本质,和人类团队管理是一回事:最贵的人负责做判断,而不是搬砖。模型之间的价差越大,这套打法的收益越明显——国产组合里 20 倍的单价差,意味着同样的预算可以干 10 倍的活。
规则不复杂,难的是坚持执行:坚持先澄清、坚持自包含 prompt、坚持亲自验收。把这三件事做到位,剩下的就是看着账单变薄、速度变快。
说明:文中价格均为 2026 年 8 月各厂商公开报价,随时可能调整,请以官方最新价为准。各模型能力评价基于公开基准与实测文章,仅供参考。
如果这篇文章对你有帮助,欢迎点赞、在看、转发。
关注本号,获取更多 AI 工程实践的一线经验。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号