从PDF中提取Excel,这个工具真的好用

从PDF中提取Excel,这个工具真的好用
派大星的数据屋
发布于 2026-09-15 21:51:29
发布于 2026-09-15 21:51:29
因为工作原因,我每天都要接触大量的数据报表,PDF转Excel这种格式转换场景也非常多。
目前市场上有很多pdf工具,大部分是阅读类,也有支持对pdf的修改、转换等功能,但这部分工具不少是收费的。
这次介绍一个开源python工具库-pdfplumber,可以方便地获取pdf的各种信息,包括文本、表格、图表、尺寸等。
python中有很多库可以处理pdf,比如PyPDF2、pdfminer等,那pdfplumber的优势在哪呢?
首先,pdfplumber能轻松访问有关PDF对象的所有详细信息,且用于提取文本和表格的方法高级可定制,使用者可根据表格的具体形式来调整参数。
最关键的是pdfplumber作者持续在维护该库,而同样受欢迎的PyPDF2已经不再维护了。
同其他python库一样,pdfplumber支持使用pip安装,在命令行输入
pip install pdfplumber
如果遇到安装慢的问题,可以替换镜像源,会快很多。
pdfplumber安装后,用import导入即可使用。
再看下如何用pdfplumber提取pdf表格?
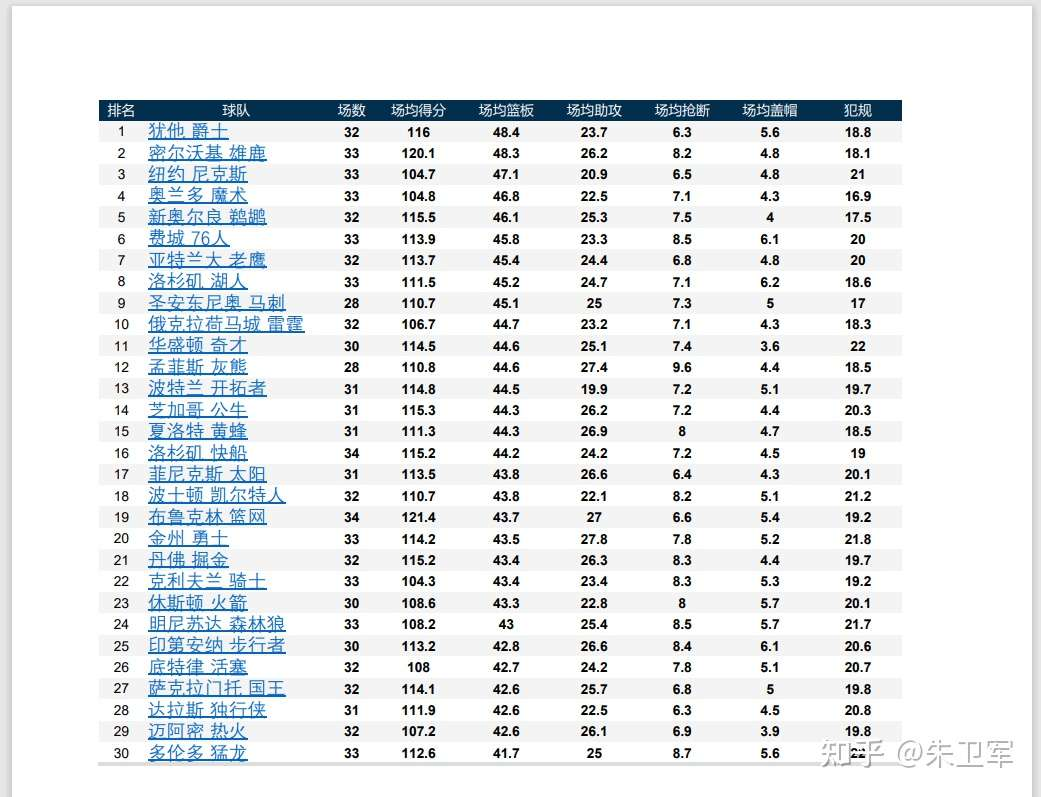
以NBA 2020-2021 常规赛数据作为范例,pdf表格如下:
第一步:使用pdfplumber提取表格文本
# 导入pdfplumber
import pdfplumber

# 读取pdf文件,保存为pdf实例
pdf =  pdfplumber.open("E:\\nba.pdf")

# 访问第二页
first_page = pdf.pages[1]

# 自动读取表格信息,返回列表
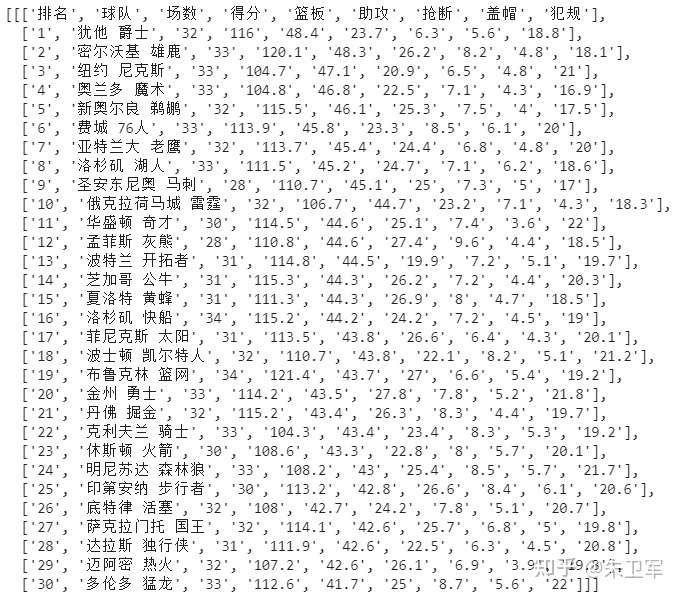
table = first_page.extract_table()
输出:
第二步:整理成dataframe格式,保存为excel
import pandas as pd

# 将列表转为df
table_df = pd.DataFrame(table_2[1:],columns=table_2[0])

# 保存excel
table_df.to_excel('test.xlsx')

table_df
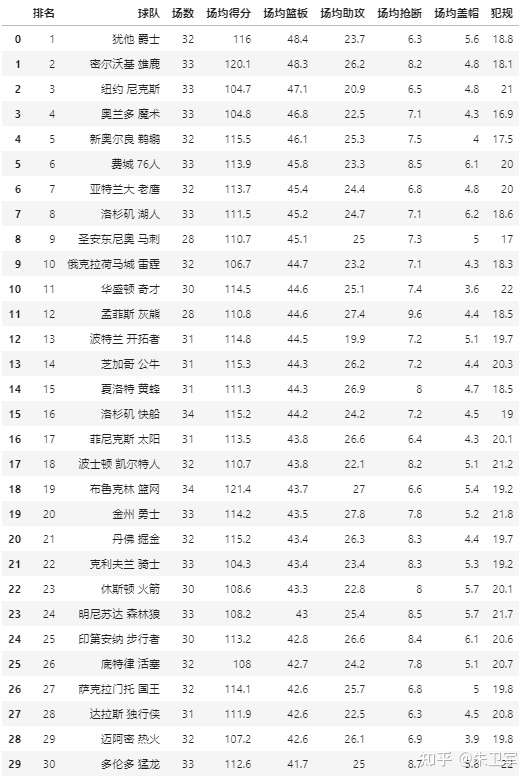
一个小小的脚本,不到十行代码,便将pdf表格提取并转化为dataframe格式,最终保存到excel。
可见pdfplumber处理PDF表格数据还是蛮方便的,而且比较准确。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2025-11-21,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号