Milvus 3.0 精排之后,为什么不能翻页了?
原创
🚩 2026 年「术哥无界」系列实战文档 X 篇原创计划 第 206 篇,Milvus 最佳实战「2026」系列第 32 篇
大家好,欢迎来到 术哥无界 | ShugeX | 运维有术。
我是术哥,一名专注于 AI 编程、AI 智能体、Agent Skills、MCP、云原生、AIOps、Milvus 向量数据库的技术实践者与开源布道者!
Talk is cheap, let's explore。无界探索,有术而行。
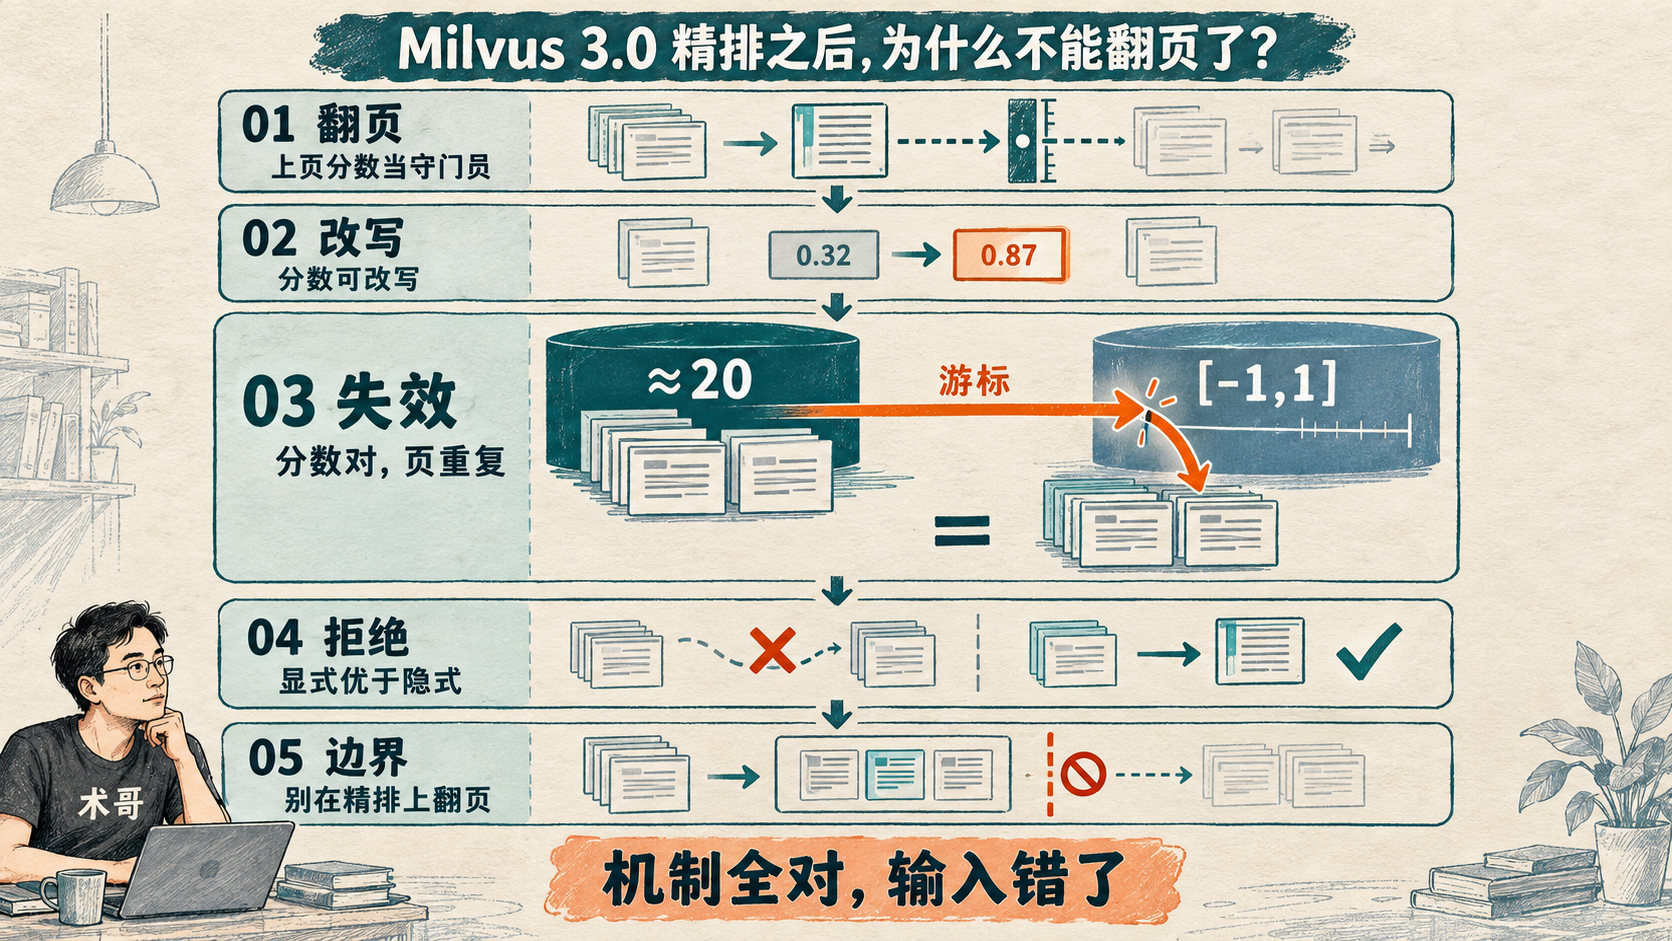
封面:机制全对,输入错了
有人在项目里给检索加了精排:collection 上挂了 L0 的 XGBoost Function Chain,然后用 search_iterator() 一页一页翻结果。翻到第二页,拿回来的是一条和第一页一模一样的 id 列表。你第一反应多半是:Milvus 的分页迭代器有 bug。
官方 bug 单的标题就把症状写死了:L0 FunctionChain causes search iterator v2 to repeat the first page(issue #51306)。里面贴出的复现输出很扎眼。不带 FunctionChain 的对照组,两页 id 不相交;带上 XGBoost 重排,两页 id 逐条相同。分数还全对:每条返回的 distance 和本地 XGBoost 原始预测误差都在 1e-5 以内。分数对、排序对,页重复。
也就是说,翻页逻辑没坏——这是按 PR #51334 社区分析得出的推断,不是官方确认。是它赖以工作的某个前提,被上游悄悄换掉了。这篇想把这条因果链拆开:游标凭什么能翻页,$score 对它做了什么,官方最后为什么宁可禁止组合也不去修续页。结论先放一半:你以为这是一个 bug 修不修的问题,其实是一类设计假设在精排之后的存活问题。这个假设只有八个字:向量库的分数是同类可比较的距离。
01 游标凭什么能翻页
01 游标凭什么能翻页
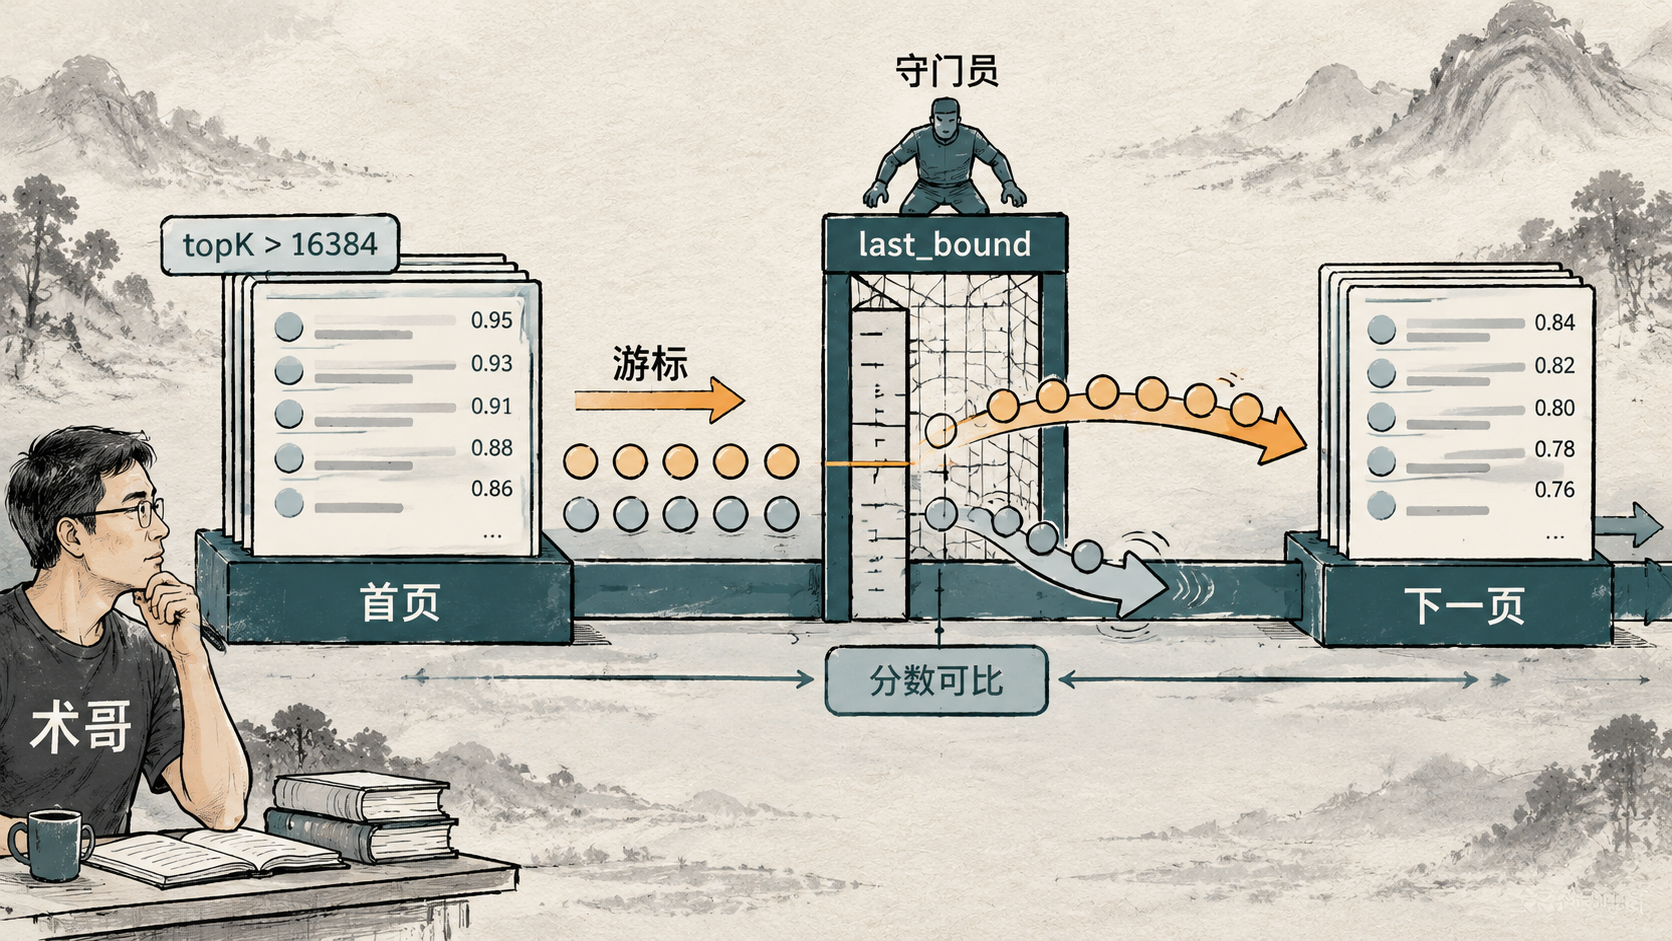
先看迭代器是什么。官方文档(with-iterators.md)说得很直白:单次查询能返回的实体数有上限,topK 超过 16,384 就建议改用 SearchIterator;用法是循环调 next(),batch_size 决定每页返回多少实体。文档到这里就停了:没说下一页的起点怎么定。答案在社区根因分析里。
按 PR #51334 的描述:iterator v2 的续页边界,来自上一页最后一条的分数。internal/proxy/task_search.go 里的 getLastBound 读取结果里的 Scores,把上一页最后一名的分数当作下一次请求的 last_bound;下一页的 ANN 搜索带着这个边界回到 segcore,由 CachedSearchIterator::IsValid 按 dist > last_bound 过滤掉已经见过的那批。这一段按 PR #51334 的社区分析转述(该 PR 未合并);getLastBound 读 Scores 的具体实现与 segcore 侧 IsValid 的过滤细节,未经源码逐行核验。
翻译成白话:系统把上一页的最后一名当成守门员,下一跳只放行分数比它更高的候选,已经翻过的(分数只会更低)被直接挡在外面。这套机制要成立,背后压着两个假设。第一,分数是单调的,排在前面的分数更高。第二,上一页的分数和下一页拿出来比对的分,是同一个量纲的同类量,都是 ANN 距离:COSINE 在自己 -1,1 的区间里比,L2 在 [0,+∞) 里比(区间按 PR #51334 的社区分析)。这两个假设平时没人提,因为默认成立。游标拿同一个世界的距离比大小,逻辑闭环——整个搜索引擎默认的世界观,就四个字:分数可比。
Function Chain 把这个默认世界观改了。
02 $score 被设计成可以改写
02 $score 被设计成可以改写
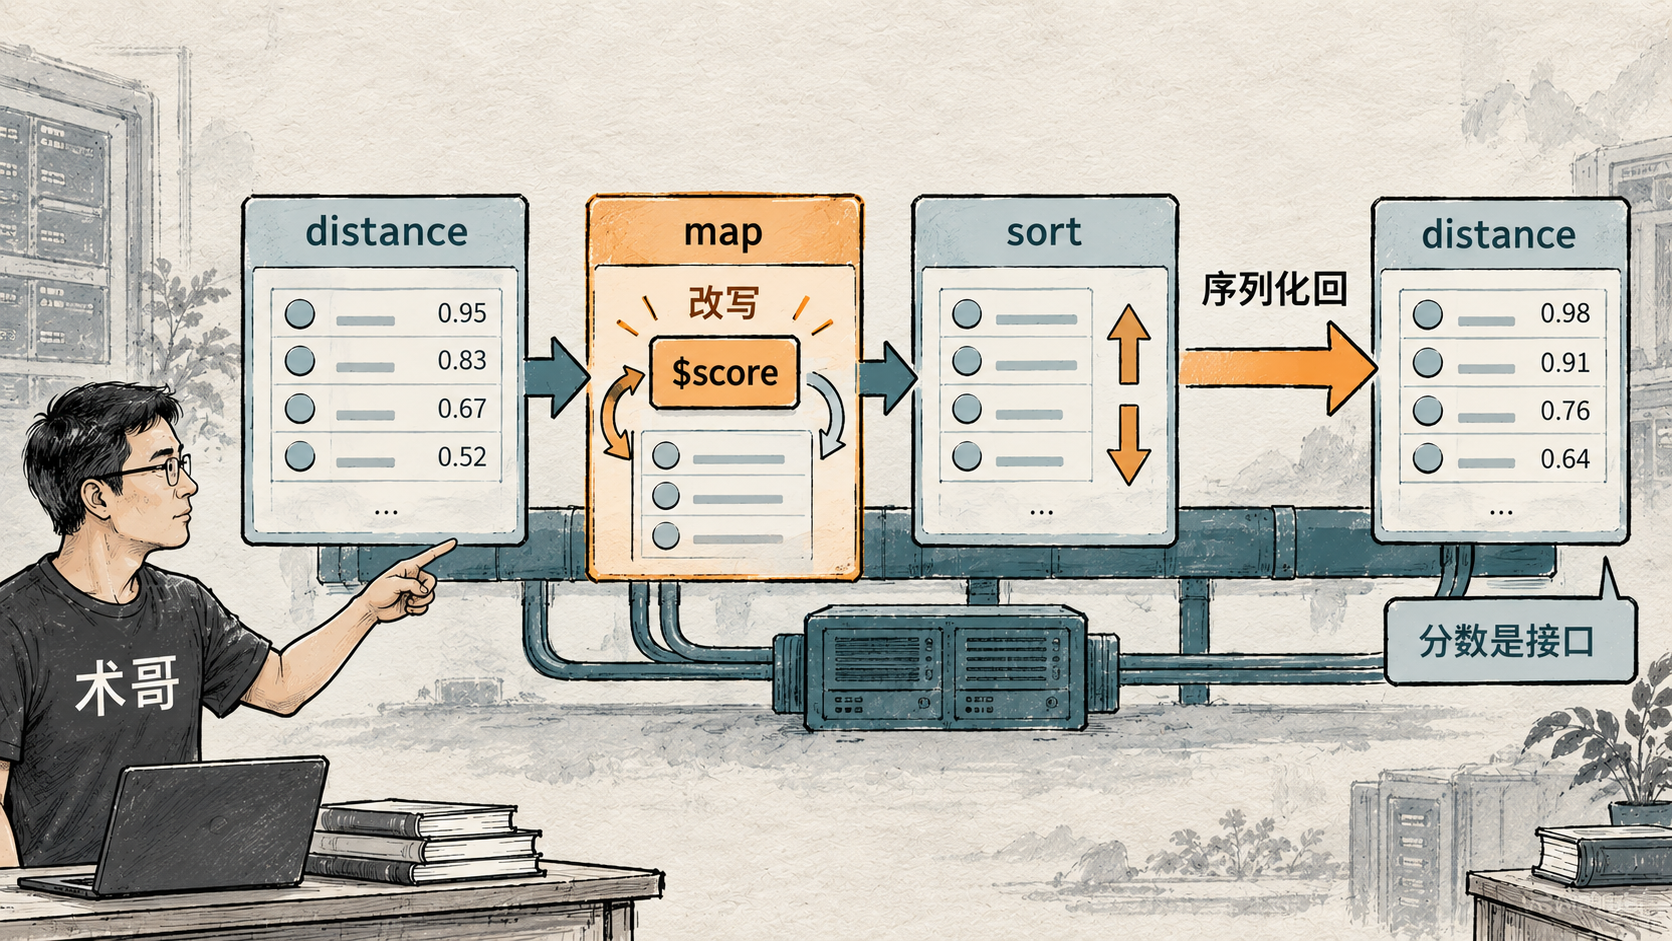
Milvus 3.0 的 Function Chain(设计文档 Draft @2026-06-24)引入一个系统虚拟列 $score,原话是 “$score is a system virtual column, not a collection field”。它是可读也可写的:运行时先从当前结果的距离初始化,map("$score", expr) 能把分数寄存器整体覆盖掉,sort 按改写后的分数排序,最终 $score 又序列化回结果的 score/distance 字段返回,SDK 用户看到的还是那个普通的 hit distance。
这里我要停一下。序列化回 distance 字段,是整个故事的扳机:上游把 $score 改了,改完还放回 distance 的位置。于是用户以为是距离的东西,可能根本不是距离。它可以是加权组合,比如设计文档示例里这种:
.map("$score", fn.num_combine(col("$score"), col("freshness"), col("popularity"),
                              mode="weighted", weights=[0.7, 0.2, 0.1]))
可以是 decay 衰减乘出来的分;在 XGBoost 场景里,直接就是模型输出。XGBoost 设计文档(20260708-xgboost-function-chain.md)原话说得干脆:use native model prediction as the rerank score,模型预测就是重排分数,output=raw 时连变换都不做,直接返回原始 tree margin。精排之后你拿到的“距离”,量纲由你的模型决定,和向量索引的 metric 一点关系都没有了。
设计文档还有一句更露骨的原话:“Milvus does not infer ordering direction from vector metric type after a chain sort is present”——链里出现 sort 之后,排序方向都不再从 vector metric 类型推断。这等于承认:分数的语义由用户改写,是设计层面接受的既成事实,不是 bug 副产品。
这个改写后的分数,在 L0 和 L2 两层都被当成排序依据消费。L0 在 QueryNode 的每个 segment 上先跑,只允许 map,并自动追加 Sort($score desc, $id asc) 的 reduce 契约(l0_function_chain.go 的 appendL0RerankReduceContract),改写过的分数在归并之前就掌握了排序权。L2 在 Proxy 全局 reduce 之后由 rerankOperator 按用户链原样执行 map/sort/limit(search_pipeline.go)。无论哪一层,最终用户拿到的分数都是改写值。我翻源码到这里,倾向于把这个设计概括成一个判断:分数是接口,不是实现细节。Milvus 从这一刻起,不再向你承诺分数等于 ANN 距离。
03 失效链:游标读到了不属于自己的世界
03 失效链:游标读到了不属于自己的世界
把前两节拼起来,bug 就不神秘了。
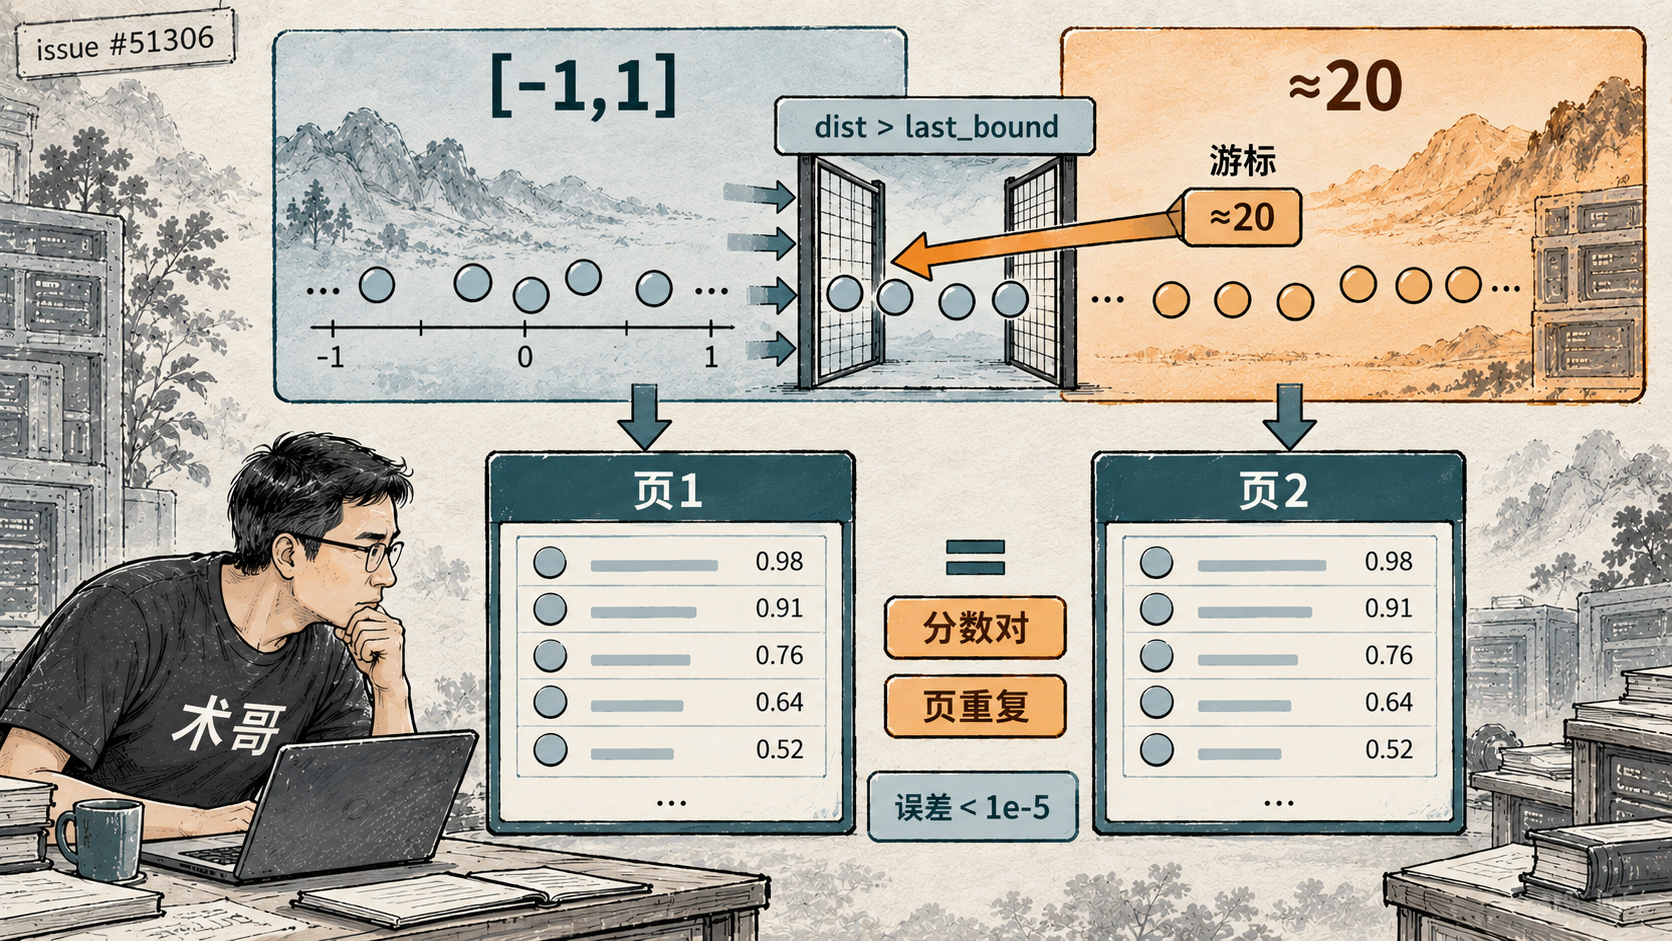
场景是 issue #51306 那种:L0 XGBoost 重排。第一页排完,iterator 要从这页最后一名的分数取 last_bound(按 PR #51334 描述)。可这页的分数是 XGBoost 的 raw 预测,量纲大概在 20 附近;而下一页要做 ANN 续搜的空间是 COSINE 的 -1,1(机制链按 PR #51334 的社区分析)。
下一跳带着 last_bound ≈ 20 回到 segcore 过滤:dist > last_bound 在一个上限只有 1 的空间里根本不成立,过滤条件等于没起作用——PR #51334 的原话是 the continuation filter excludes nothing。ANN 依旧从同一起点把同一批 top 结果捞回来,重排之后又是一模一样的第一页。
值得反问的是:很多人以为下一页应该从上一页断掉的地方继续找。问题是,“断掉的地方”这个坐标,是谁给的?是上一页的分数给的。分数被换到另一个量纲,坐标就跟着平移到了模型的世界。游标从头到尾都在忠实地执行指令,它唯一做错的事,是把新世界的分数当成旧世界的坐标去用。机制全对,输入错了。
issue 的复现里,对照组最能说明问题:两组之间只换了一个变量——结果里的分数(不带重排两页不相交,带上重排逐条相同,issue #51306)。
也别急着把责任推给 L0 一个档位。按 PR #51334 的分析,L2 function chain、function_score 重排、以及 iterator v1(客户端在返回的 distance 上做续页)全都中了同一类污染。凡是游标从结果分数取边界、而那里的分数被改写过的场景,都会中。这是一整类问题,不是一个端点。
04 官方为什么宁可拒绝组合,也不修续页
到这里有个更反直觉的问题:根因这么清楚,为什么不把续页逻辑修好,让它能正确处理改写后的分数?
社区确实提议过正修。PR #51334 的修法写得很完整:正确支持“重排 + 迭代”,需要把原始 ANN 距离和改写后的分数同时携带穿行整个 reduce 链路,原话是 “a feature-level change for #51192”,这是特性级的改动。短期方案则简单得多:在 Proxy 上显式拒绝组合,让 function_chains 或 function_score 配 iterator 直接报 ParameterInvalid,而不是静默返回重复页。
Milvus 选了后者,而且写成了三条明文:Search API 组合限制、L1 兼容性说明、校验规则第 18 条,三处措辞一致——Function rerank 与 Search Iterator(legacy 或 v2)互斥,L1 同理,且都不支持配 order_by;L1 拒绝 order_by 的理由原话是 “because both define ordering behavior”。落地也不含糊:PR #51347 于 2026-07-17 合并,正文第 2 点就是 “search iter v2 reject chain”,改动落在 internal/proxy/task_search.go。
注意顺序。官方是先被 issue #51306 打脸(静默重复页),再在 #51347 里主动拒绝(显式报错)。同一个组合,从一个没法察觉的坏行为,变成一句明确的“不允许”。
我不买账的是“官方偷懒,不敢修续页”这个说法。修续页的代价不是多几行代码,而是动 reduce 契约:让原始距离跟着改写分数一路走到归并尽头,等于改变整个 Function Chain 特性的合并语义。这项取舍还连着设计文档反复强调的“显式优于隐式”:链按用户原样执行,系统不偷偷补 limit、group-by 这类公开算子(L0/L1 自动追加的非公开归一化 sort 不在此列——它是内部归并行为,不改变用户链选中的候选),自然也不会偷偷替你续页。拒绝组合是一行校验、语义自洽,还能对齐全已有的 group_by/offset/order_by 守卫。我倾向于认为这是个负责任的决定,不是技术上的退却。
再往深一层,两代设计对“分数语义”的态度根本相反。旧的混合检索重排体系对“分数不可比”极度警惕:WeightedRanker 明确不同路径的分数分布差异大、不能直接比较(IP 的范围里到得了 -∞,+∞,L2 是 [0,+∞)),必须用 arctan 压到 0,1 再比;decay 重排的最终分等于归一化相似度乘衰减分;RRF 干脆不读分数,只看排名(metric-agnostic)。旧世界面对“分数不可比”的办法是绕开:归一化,或者不读。Function Chain 的选择正好反过来,把分数开放给用户改写。而分页,恰恰是系统里最依赖“分数可比”假设的一个角落。两代方向相反,撞车偏要选在分页,几乎是必然。
这题还没结束。官方维护者在 issue #52319 里把现状写成 “function chains currently reject search-iterator-v2 and order_by”,然后把 “define the intended semantics instead of blanket rejection” 列为未来工作项:官方自己承认现在是 blanket rejection,一刀切拒绝,“续页的分数语义到底是什么”留给 future。(issue #52319 写于 2026-08-07,当时 L1 仍被拒绝;L1 已在 2026-08-21 随 PR #52376 合入,但设计文档对 L1 × iterator、L1 × order_by 的组合限制依然成立。)
05 边界:什么场景可以碰,什么场景别碰
05 边界:什么场景可以碰,什么场景别碰
把约束收敛成一张可操作的判据。
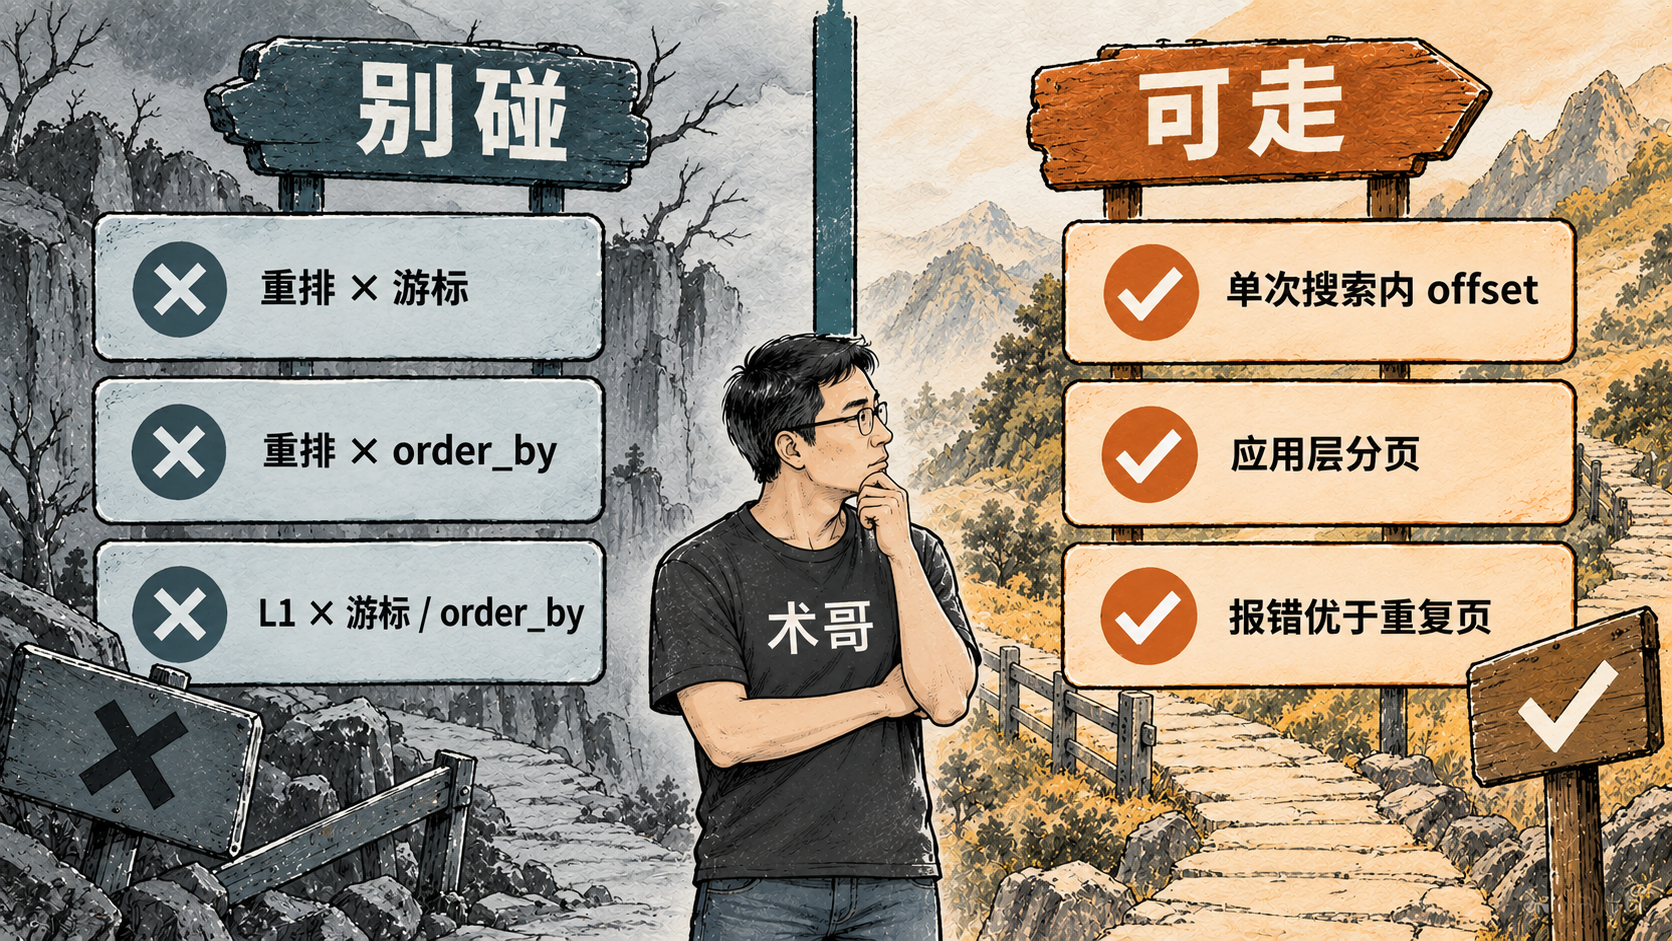
别碰的组合(设计文档明文加已合入实现):
- Function rerank(
function_chains,以及 SDKranker对应的function_score)×search_iterator(legacy 和 v2 都算):拒绝; - Function rerank ×
order_by:拒绝,因为它俩都在定义排序行为; - L1 ×
search_iterator、L1 ×order_by:同样拒绝。
这些拒绝的共性很清楚:iterator 和 order_by 都是消费排序语义的接口。游标要拿上一页分数当下一页坐标,order_by 要拿分数当排序键,它们都默认“分数是可控的同类量”。分数一旦被 Function Chain 改写成用户定义的语义,这类接口就没有立足点。对照一下:设计文档允许 group-by 与 L1 的 map/sort/limit 组合(“Search-level group-by may be combined with L1 map, sort, or limit, matching L2 compatibility”)。原因我推断是 group-by 不消费同样的排序假设——文档只给了组合矩阵,没解释为什么;同一个拒绝决策,顺手把“哪些接口在消费分数”画了一条清晰的分界线。
还有路可走的场景,按证据级别说清楚:
- 如果你的结果量级还在单次搜索的上限之内,普通 search 走
rerankOperator的 reduce → rerank → pick 管线,offset 是在 reduce 阶段完成的(search_pipeline.go注释原话:“Search performs Offset in the reduce phase”)。它不靠上一页分数做坐标、不是游标续页,受不到这套失效影响。这是我读源码和文档的理解,没在你环境里实测过。 - 如果真要翻过 topK > 16,384 的大集合(这正是 iterator 存在的原因),而当前 master 的组合限制下
function_chains和 iterator 是互斥的。我的建议:要么放弃服务端精排,用普通 iterator 拉候选,把重排放到你的应用层自己做、自己分页;要么把重排控制在单次搜索兜得住的量级,别把跨页交给一个不认新分数的游标。这条是基于源码与文档的建议,不是实测结论。 - 如果你的请求直接拿到
ParameterInvalid而不是重复页,说明你用的版本已经带上了 #51347 的拒绝逻辑。这其实是好消息:系统把“分数语义未定义”这件事摆到了台面上,而不是让你对着重复数据排查半天。
最后回到那个 1e-5。issue #51306 里最扎眼的一行是:分数全对,页全是重复的。两个各自正确的组件叠在一起,产出了一个错误的结果——中间缺的不是一个修 bug 的补丁,而是一份关于分数语义的契约:谁来保证分页游标拿到的,是它认识的同类量。Milvus 3.0 在这份契约上做了一个明确的选择:精排之后,不保证。所以别在精排之上依赖自动翻页,这就是这个 bug 最值钱的遗产。
好啦,谢谢你观看我的文章,如果喜欢可以点赞转发给需要的朋友,我们下一期再见!敬请期待!
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号