文本转人声音频‑文字播报合成‑TTS 语音生成处理 API 接口介绍
原创
文本转人声音频‑文字播报合成‑TTS 语音生成处理 API 接口介绍
原创
聚美智数
发布于 2026-09-18 17:28:38
发布于 2026-09-18 17:28:38
前言
语音播报、有声读物、短视频配音、智能设备提示音等产品,都需要把文本内容转化为流畅自然的人声音频。如果选择人工录音,不仅周期长、成本高昂,内容修改后还需要重新录制,迭代效率很低。自行搭建 TTS 语音合成模型,又需要投入算力、语料与模型调优工作,技术门槛高。文本合成语音接口可以直接输入文字,快速生成接近真人质感的语音音频,帮助各类业务快速补齐语音输出能力。
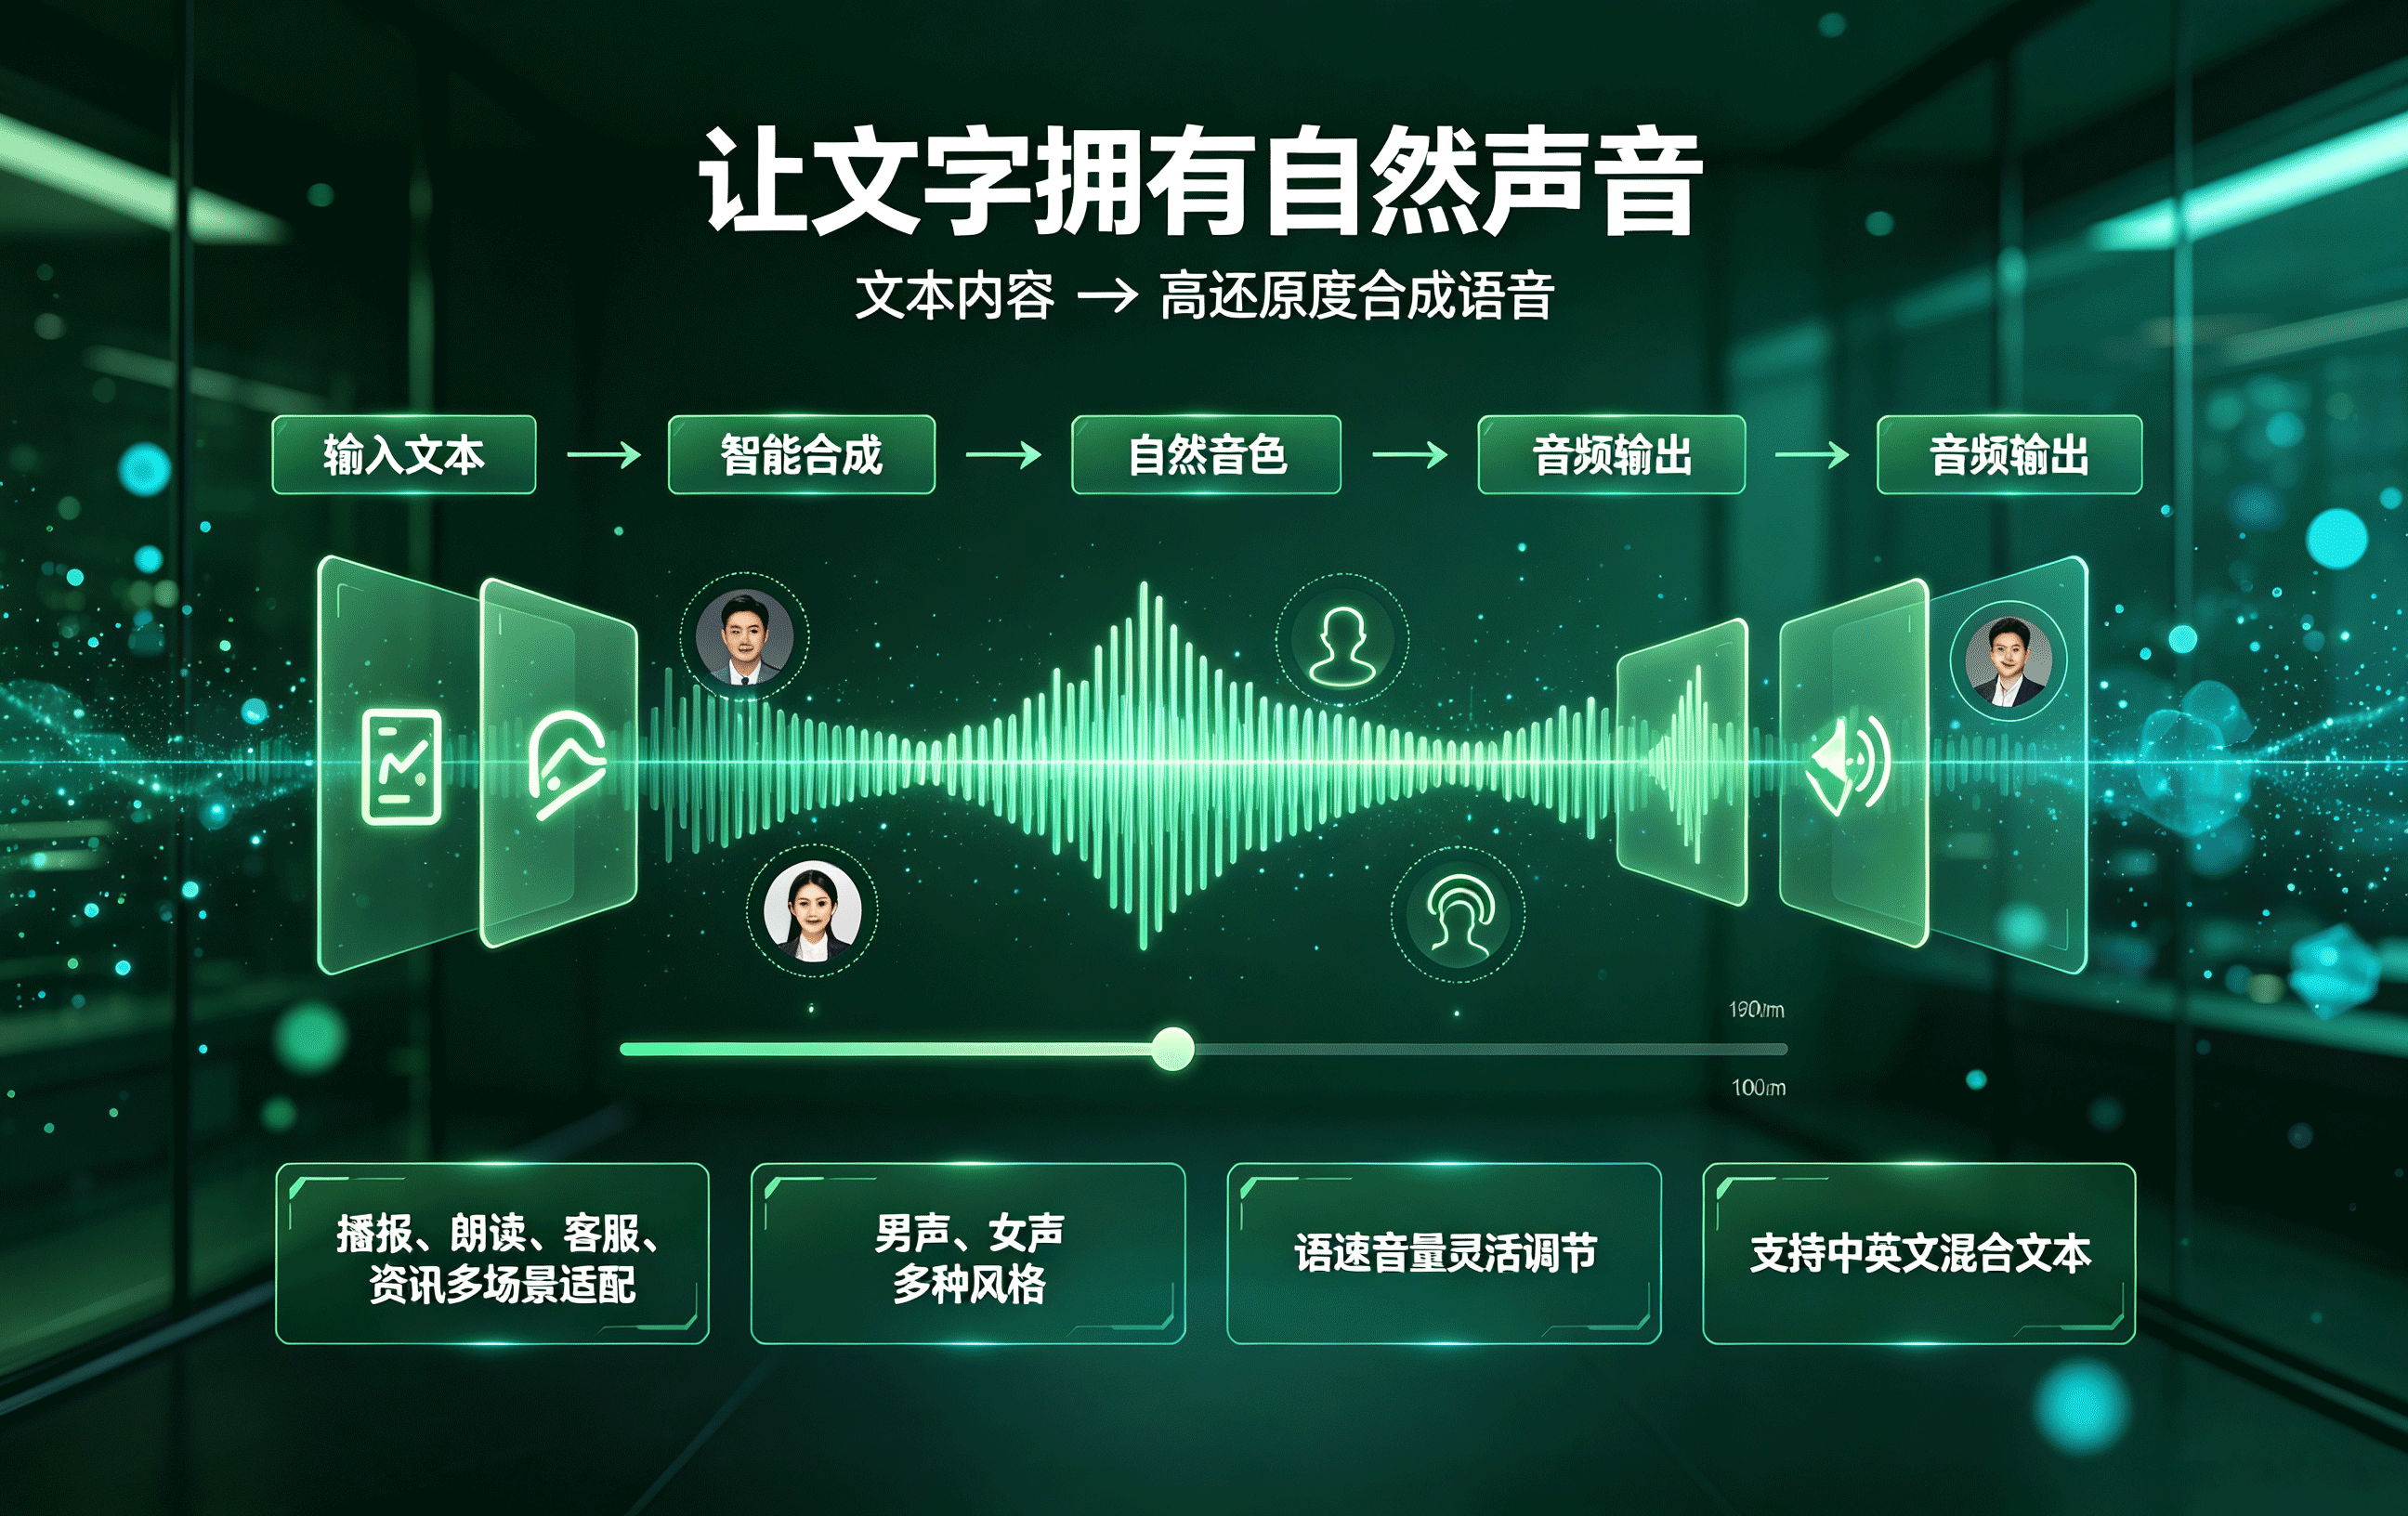
核心能力
- 支持将普通文本转换为高还原度合成语音;
- 提供多款不同风格的人声音色,涵盖男声、女声,适配播报、朗读、客服、资讯等不同业务风格;
- 可灵活调节语速、音量参数,适配快读播报、慢速朗读等差异化需求;
- 支持常见音频输出格式,音频发音连贯流畅,多音字、标点停顿处理自然,可适配中英文混合文本内容。
API介绍
请求说明
名称 | 类型 | 必须 | 说明 |
|---|---|---|---|
text | String | 是 | 待合成的文本 总字数不超过10万个字符,1个中文字、英文字母、数字或符号均算作1个字符 |
speed | String | 语速 取值0-15,默认为5中语速 | |
pitch | String | 否 | 音调 取值0-15,默认为5中语调 |
volume | String | 否 | 音量,取值0-15,默认为5中音量(取值为0时为音量最小值,并非为无声) |
per | String | 否 | 语音库 |
aue | String | 否 | 3为mp3格式(默认); 4为pcm-16k;5为pcm-8k;6为wav(内容同pcm-16k); 注意aue=4或者6是语音识别要求的格式,但是音频内容不是语音识别要求的自然人发音,所以识别效果会受影响。 |
返回样例
{
  "code": 200, // 返回码,详见返回码说明
  "msg": "成功",  // 返回码对应描述
  "taskNo": "65605503936940344488", // 本次请求号
  "data": {
   "result":""// 合成结果地址,有效期1天
  }
}
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号