【制造·硬件】AI 帮我重排 16 个客户的项目资料库:只移动不删除的完整实录
原创
【制造·硬件】AI 帮我重排 16 个客户的项目资料库:只移动不删除的完整实录
原创
用户12774540
发布于 2026-09-20 15:48:09
发布于 2026-09-20 15:48:09
一、输入材料:一个"不敢动"的项目资料库
我是电池保护板(PCM)工程师,日常对接 BYD、NVT、VIVO、索尼、欣旺达等 16 个客户。几年下来,D:\项目资料\ 已经变成了这样:
• 客户目录平铺在根目录,有的带编号有的不带,汉字、英文、项目号混排;
• 「文件夹套同名文件夹」嵌套到 8~10 层,一部份资料路径超过 260 字符,资源管理器里打不开、复制报错;
• 文件名里混着全角符号、不可见空格(U+00A0)、错别字;
• NPI(试产)转 MP(量产)阶段时,有人复制整个目录改名,同份资料存了两三份。
最麻烦的不是乱,而是不敢乱动:客户原始目录名和文件名(比如 EE-1004687-04.A FAB, SIP, BATTERY PACK, ... 这类料号串)是客户系统固定的,改一个字符对不上账;文件位置本身编码了「这份资料是谁给的、处于哪个阶段」——按扩展名归类会毁掉这些信息。
这就是我的输入材料:一棵不敢靠"直觉整理"、只能靠规则整理的真实工程目录树。
二、WorkBuddy 配置:先立铁律,再干活
我没有让 AI "帮我整理文件夹"就开跑,而是先把不可协商的契约写进了一个自建 Skill(windows-folder-tree-reorg),核心 5 条铁律:
1. 只移动、只重命名、只新建。绝不删除任何文件。
唯一允许的删除是"拍平后变空的壳目录"(os.rmdir,且确认为空)。
2. 同盘改名用 os.rename —— 只改 MFT 项,瞬时完成,天然可回滚。
3. 每一步都要台账 CSV + 一键回滚脚本(列:源, 目标, 动作, 备注)。
4. 每步先出映射表 / dry-run 给人过目,再执行。
5. 绝不按扩展名猜文件归属——要问清来源。
第 5 条是我踩过坑之后加上去的:AI 最初按 .pdf/.xlsx 扩展名想把资料归类,被我叫停——在制造业项目里,同名 PDF 在"客户资料"和"我们外发"里是完全不同的两份东西。
配着用的还有一个 safe-recycle-bin-batch-delete 技能:即使最终要清掉确认无用的空壳目录,也走回收站(SHFileOperationW + FOF_ALLOWUNDO),每 10 个文件一批、删完复核、出审计 CSV,而不是直接 rm。
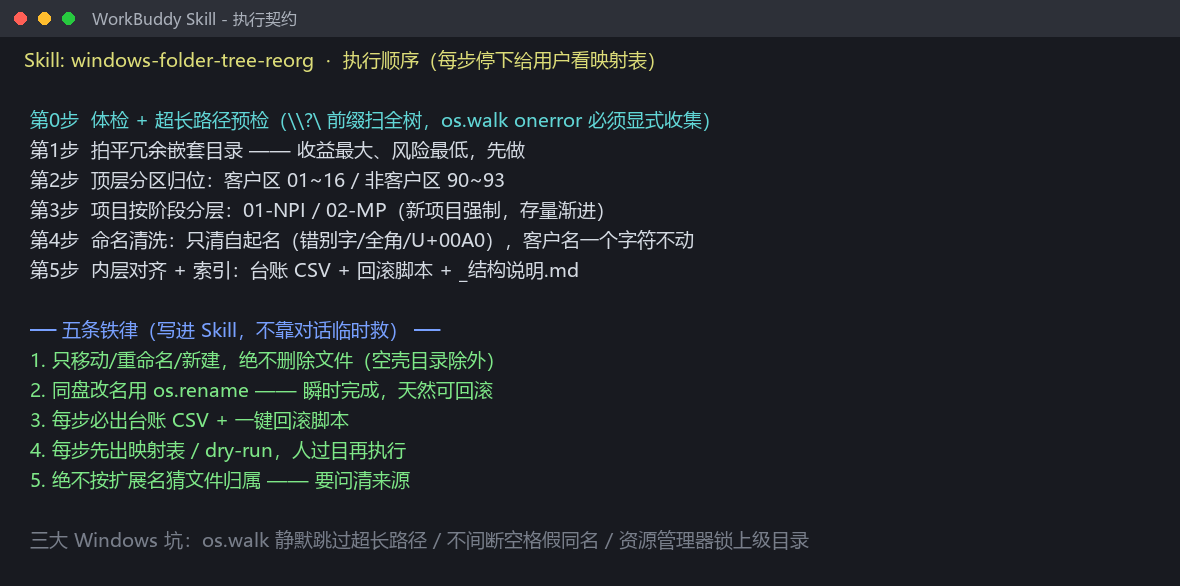
▲ Skill 执行契约:六步工作流与五条铁律
三、操作步骤:六步走,每步都留后悔药
Skill 把整个重组固定成六个阶段,AI 每完成一步都停下来给我看映射表:
第 0 步 · 体检 + 超长路径预检。 先用 \\?\ 前缀扫描全树(绕过 260 字符限制),统计目录数、层数分布、超长路径清单。这里有个 Windows 的坑:os.walk 默认 onerror=None,遇到超长路径会静默跳过整棵子树,统计数字看起来正常,实际上少了东西。所以体检脚本必须显式收集 onerror 回调里的异常并汇报。
第 1 步 · 拍平冗余嵌套。 收益最大、风险最低的一步。所有「文件夹里套着一个同名文件夹」的结构直接上提一层,比如 07-德赛电池\07-德赛电池\01-NPI\... → 07-德赛电池\01-NPI\...。拍平后变空的壳目录才允许 os.rmdir。
第 2 步 · 顶层分区归位。 设计成两段式编号:客户区 `01~16`(按名称拼音排序,客户是工作主体排最前),非客户区 `90~93` 永远排最后:
01-18S2003项目\ ... 16-珠海藤佳\
90-归档项目\ ← 空壳/暂停/结案/作废(按客户分)
91-公共资源\ ← 供应商报告、物料库、ATE 测试
92-模板\ ← 新建项目用的空骨架
93-参考与预研\
第 3 步 · 项目按阶段分层(先立规范、存量渐进)。 每个客户内部统一 01-NPI\<项目号>\ 与 02-MP\<项目号>\ 两段,MP 内部再固定 9 个子目录(00-报价资料、01-PCM样品承认书、02-设计&外发资料、03-供应商资料、04-客户资料、05-测试数据及可靠性报告、06-设计输入输出评审表、07-不良分析、08-性能点检样板、09-客户需求资料)。项目从 NPI 转 MP 只在客户内部平移,不改名不复制——从源头消灭"复制出第二份"的问题。这里我的策略是新项目立即按模板建、存量项目只在客户提出或触碰该目录时才迁移:16 个客户几百个存量项目一口气全迁,映射表和验证成本远超收益,且搬家期间正被客户引用的路径会瞬间失效。
第 4 步 · 命名清洗。 只清我们自己起的名:错别字、全角符号、U+00A0 不可见空格、日期目录里的冗余词。客户原始目录名和文件名一个字符都不动,写进铁律第 1 层。
第 5 步 · 内层对齐 + 索引。 生成机器可读索引 CSV + 人类可读的 _结构说明.md。
过程中有两处"中途调整"值得一提:
• AI 第一版方案想把客户按"重要程度"排序,被我否掉——排序规则必须是机械的(拼音序),否则每来一个新客户都要人工判断插哪;
• 命名铁律里专门加了"新增客户接在当前最大编号之后,不要中间插号",否则 17 号新客户一来,02~16 全部要重排、所有台账引用全部失效。
四、产出物:可验收的东西
最终交付的不是"整理好了"一句话,而是:
1. 规整后的顶层目录树(截图见下)——20 个顶层目录,两段式编号,客户区/非客户区一眼区分;
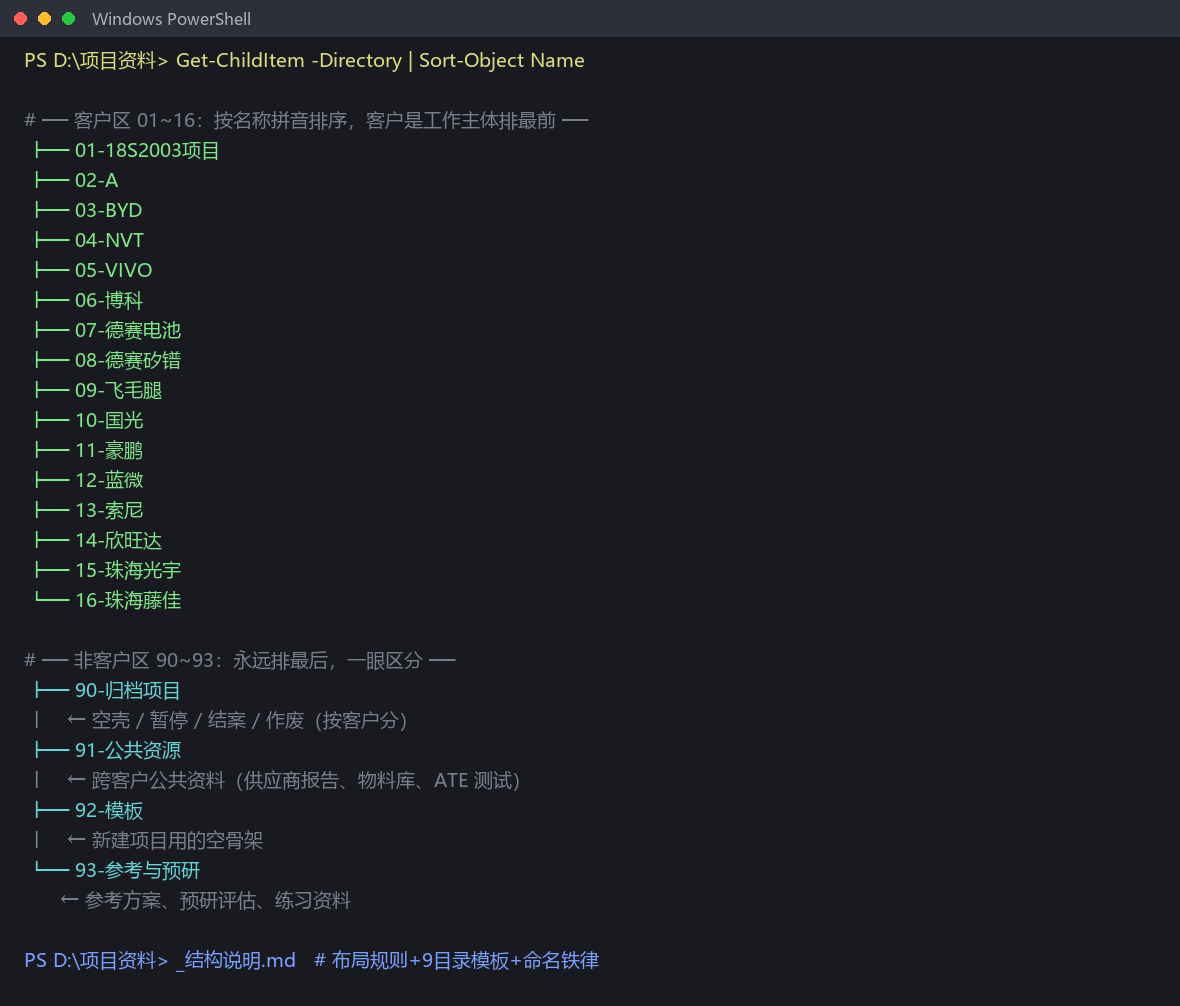
▲ 规整后的顶层目录树:客户区 01~16 + 非客户区 90~93(真实目录输出)
2. `_结构说明.md`——写清布局规则、客户内部 9 目录模板、三条命名铁律,新人接手照着就能放对文件;
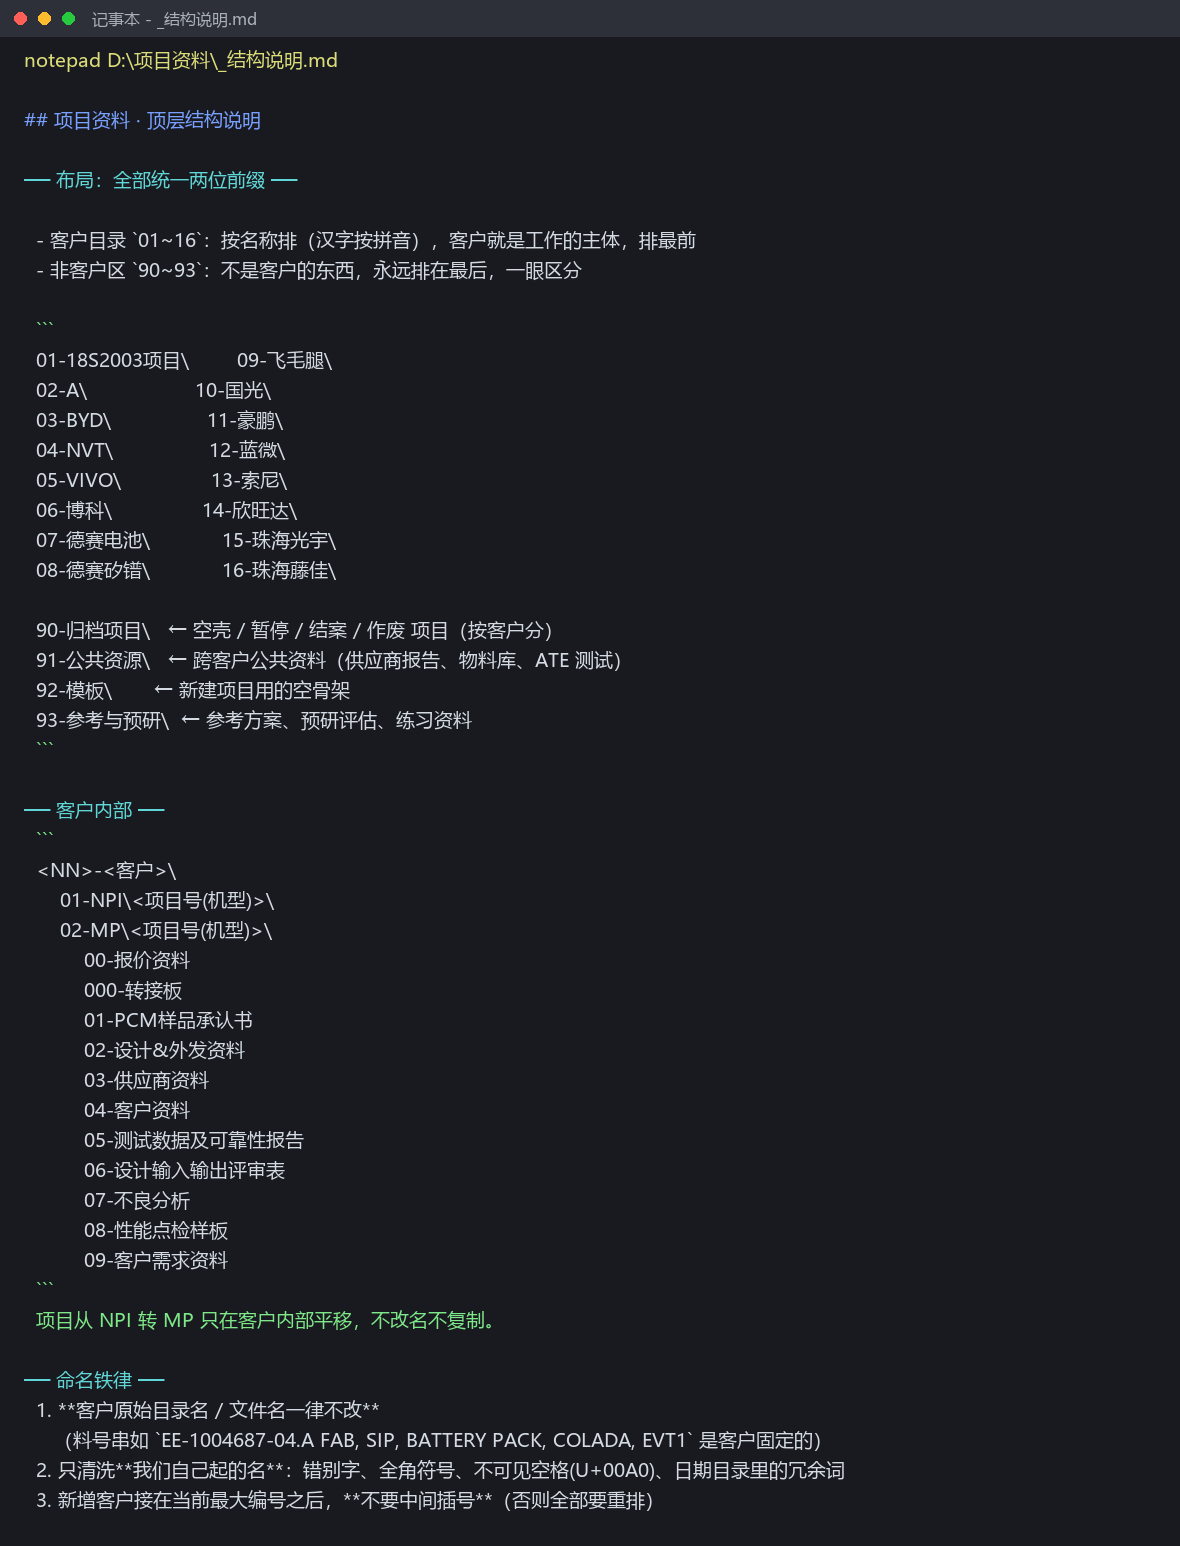
▲ 结构说明文档:布局规则 + 客户内部 9 目录模板 + 命名铁律
3. 全量台账 CSV(源, 目标, 动作, 备注)+ 对应的一键回滚脚本——任何一步不满意都可以整体退回;
4. 机器可读索引,后续可以用脚本直接定位任意项目号的资料位置。
如实说明完成度:顶层分区与编号已全部落地(这是收益最大、风险最低的一层),客户内部的 NPI/MP 9 目录属于"新项目强制、存量渐进迁移"的规范层——我认为这恰恰是这套方法论可落地的关键:先让规则跑起来,而不是追求一步到位的完美结构。
五、复盘:AI 在这件事里的正确用法
这轮做下来,我认为 AI 在"整理制造业项目资料"这件事里的正确位置是:
• AI 出规则和执行,人出业务约束。"客户料号不能动""按扩展名归类会毁掉来源信息"这类业务判断,AI 不问就不会知道——所以铁律要先写进 Skill,而不是靠对话里临时救。
• 台账比结果重要。目录树随时可以再排,但"哪个文件从哪挪到了哪"一旦丢了,客户对不上账就是事故。每步强制台账 + 回滚,AI 才敢放手干活。
• 规则要机械到"新人也能执行"。凡是需要"判断"的规则(客户重要度、文件该归谁)都会在半年后失效;凡是查表就能执行的规则(拼音序、编号递增)才能活下来。
这套 Skill(含三大 Windows 坑的处理:os.walk 静默跳过超长路径、不间断空格导致假同名、资源管理器锁死上级目录)我已经沉淀成可复用模板,同类"大目录重组"需求可以直接套。
---
本文为《WorkBuddy 行业应用指南》有奖征集投稿,讲述一个真实发生的制造业工作流案例。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号