不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线

不让模型写作文,直接从它脑子里读答案:Jev 决策在 .NET 的两条路线
张善友
发布于 2026-09-26 08:28:43
发布于 2026-09-26 08:28:43
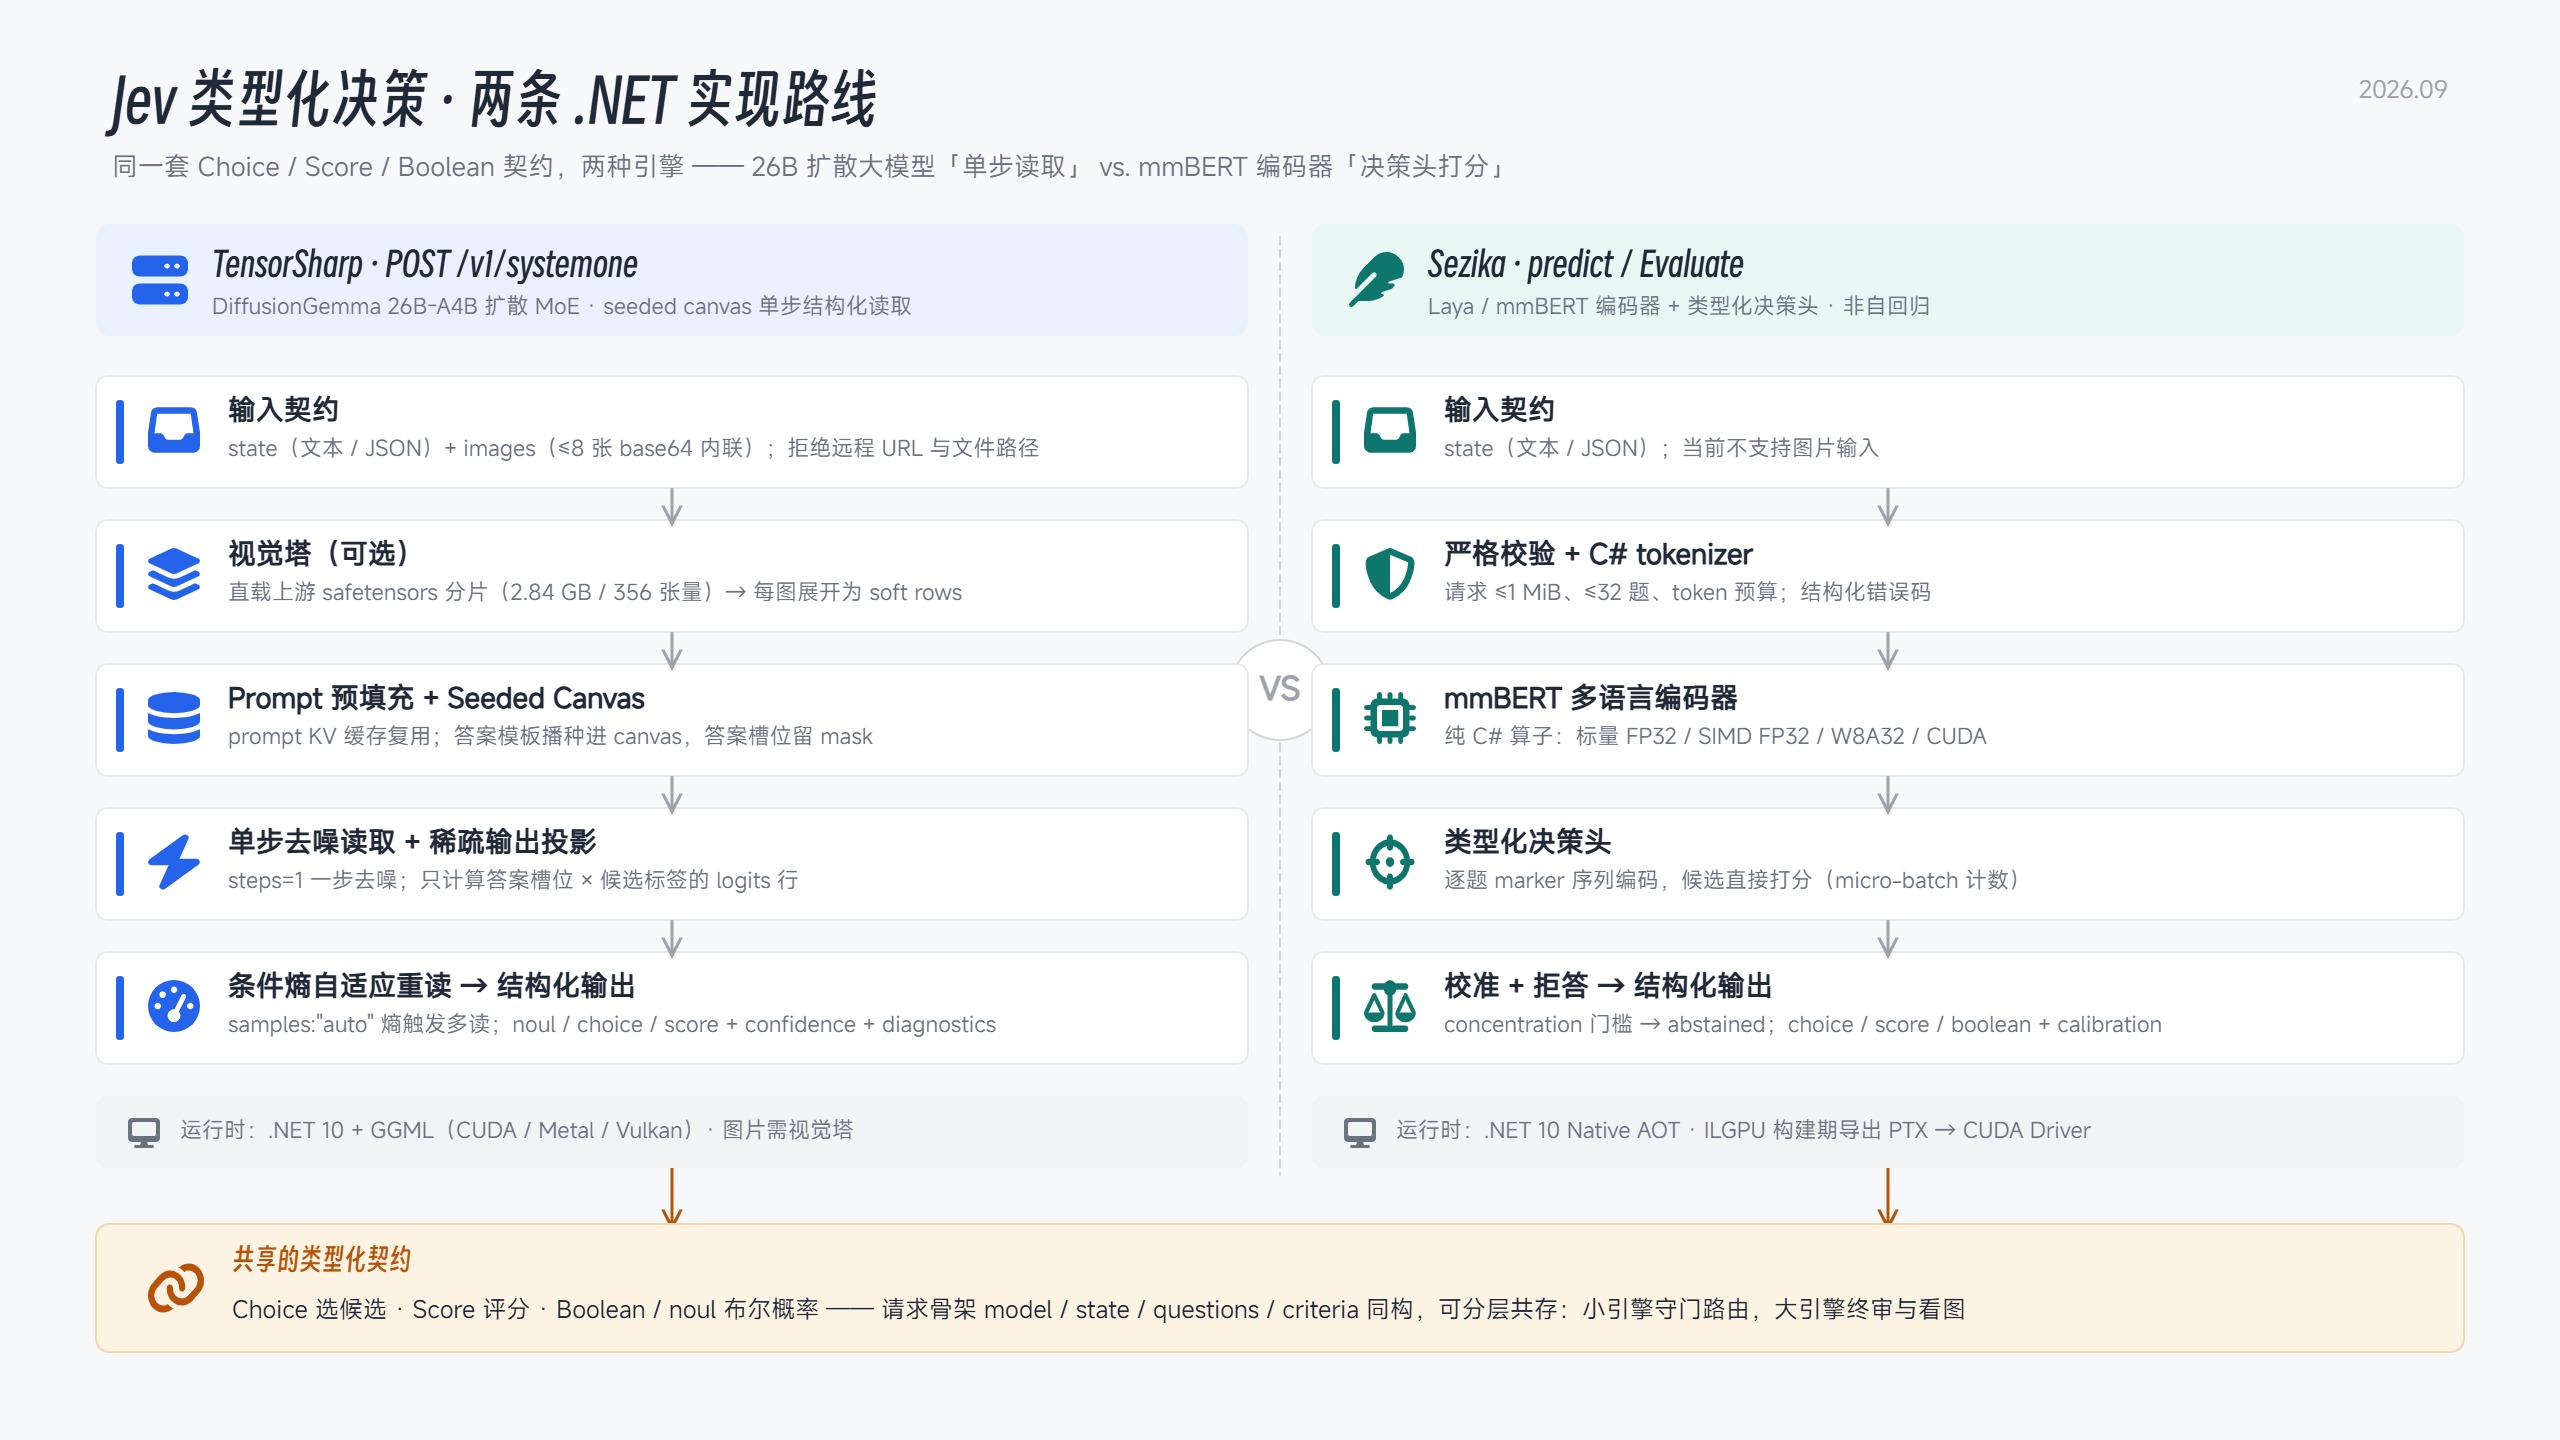
Jev 类型化决策的两条NET实现路线架构对照
这一周翻 GitHub 的时候,看到两个前后脚冒出来的项目更新,碰巧都指向同一件事:让 AI 直接给出程序能用的判断,而不是生成一段给人看的文字。
很多业务场景要的其实不是一段话。客服系统收到一条消息,要的是"转账单组还是技术组";审核系统拿到一张图,要的是"过还是不过";工单系统要的是一个严重度评分。答案就是一个选项、一个概率、一个分数,程序拿到就走自己的逻辑,没有人去读它。
以前这种需求的做法是:让大模型输出 JSON,程序解析,格式错了就重试。用过的人都知道这条路有多烦。最近流行的 Jev 风格做法换了个思路——不让模型"写"答案,直接从模型的输出层把概率"读"出来。
这篇文章聊聊我看到的两条 .NET 实现路线:一个是 TensorSharp 用 26B 扩散大模型做的 /v1/systemone,最近刚支持图片输入;另一个是 IoTSharp 开源的 Sezika,用小编码器加决策头,跑在 Native AOT 里。两条路几乎是反着走的,放在一起看挺有意思。最后我把我翻源码整理出来的请求/响应字段对照表也放在文章里,给想接入的人省点时间。
先说说上游发生了什么
9 月 22 日,vLLM 合并了 PR #57250,把 Google 的文本扩散模型 DiffusionGemma 改造成了一台结构化读取引擎。
扩散语言模型和自回归模型不太一样:它生成文本时是在一块叫 canvas 的区域里反复去噪,每次迭代刷新整段内容。vLLM 的做法是把这个机制反过来用——canvas 宽度从默认 256 缩到 16 或 32,刚好放下一小段 JSON;然后往 canvas 里预填一份答案模板,比如 "billing": "?",只在答案的位置留空;最后只跑一步去噪,直接读那个空位上各个候选词的 logprobs,归一化一下就是概率分布。
全程没有逐 token 生成,没有 JSON 解析,自然也没有格式错误和重试。一次前向,出来的就是三种类型化结果:布尔概率(noul)、有限候选选择(choice)、有序评分(score)。
Google Cloud 的 Karl Weinmeister 在 Medium 上写了完整的教程,还把它部署到了 Cloud Run 上。思路本身不复杂,但确实打开了一个口子:原来大模型不一定非要"说话",它也可以只"表态"。
路线一:TensorSharp,26B 大模型做决策,最近还会看图了
TensorSharp 是一个纯 .NET 写的本地 LLM 推理引擎,作者 Zhongkai Fu。vLLM 的 PR 合并第二天(9 月 23 日),它的 PR #225 就进了主线,实现了 Jev 兼容的 POST /v1/systemone 端点,底层跑的是 26B-A4B 的 DiffusionGemma。
它同样用 seed canvas 单步读取,但多做了一件事:稀疏输出投影。vLLM 原型是算完整词表的 logits 再挑需要的几个,TensorSharp 只计算答案位置和候选标签对应的那几行,不分配完整的 canvas×词表张量。按项目文档的说法,同硬件下比 LocalJev 那种"生成 JSON 再解析"的路子快 4 到 5 倍。
不过我觉得真正值得说的是图片输入,这是 vLLM 原型和 Jev 云端服务都没有的能力。
请求里加一个 images 字段(最多 8 张,base64 内联),图片就直接参与决策。这里有个工程上的小麻烦:市面上所有 DiffusionGemma 的 GGUF 文件都是纯文本的,转格式的时候视觉塔被丢掉了,也没有官方的 mmproj 投影文件。TensorSharp 的解决办法挺直接——上游官方 checkpoint 的第 11 个 safetensors 分片(2.84 GB)里装着视觉塔全部 356 个张量,那就直接读这个分片,不转格式。
另外有个细节我挺欣赏:如果服务器没加载视觉塔,收到带图的请求会返回 503 明确拒绝,而不是假装处理了;远程图片 URL 和本地文件路径也一律拒绝,免得推理服务器被人当成免费代理或文件读取器。
项目里自带的红绿灯例子(docs/examples/jev-traffic-light.json)设计得很巧。请求里嵌了一张合成的绿灯照片,但 state 文本只说"车辆正在接近路口",一个字没提灯:
{
  "model": "jev-latest",
  "state": "Dashcam frame captured as the vehicle approaches the intersection.",
  "images": ["data:image/png;base64,iVBORw0KGgo..."],
  "questions": {
    "signal": {
      "type": "choice",
      "instructions": "Which lamp of the traffic light is lit?",
      "criteria": { "red": "The top lamp is lit", "yellow": "The middle lamp is lit", "green": "The bottom lamp is lit" }
    },
    "stop": { "type": "noul", "instructions": "Must the vehicle stop before entering the intersection?" }
  },
  "samples": 1,
  "seed": 42
}
模型回答绿灯、不用停车——文本里没有这个信息,答案只能来自像素。更妙的是文档里写了对照:同一个请求把图去掉,模型会很有把握地回答"红灯,必须停车"。等于自带了一个反事实实验,证明模型真的在看图,而不是靠文本瞎猜。
路线二:Sezika,不用大模型,编码器加决策头就够了
IoTSharp 团队的 Sezika 走的是完全相反的方向:既然只要一个判断,那为什么要用一个 26B 的生成模型?
它的底座是 mmBERT-base 级别的多语言编码器(固定的 Laya 检查点),上面接类型化决策头。输入进来,编码器过一遍,决策头直接给每个候选打分。没有 canvas,没有去噪,是真正的非自回归——连"一步"都不需要。
这个项目最吸引我的是它的纯粹程度。整个推理栈都是 C# 写的:embedding、attention、RoPE、归一化、MLP、决策头,CPU 上有标量 FP32、SIMD FP32、W8A32 量化三条路径,不碰 Python、PyTorch、ONNX Runtime 这些外部依赖。GPU 路径的做法我没在别的 .NET 项目里见过:构建期用 ILGPU 把 kernel 编译成 PTX,运行时 Native AOT 程序通过静态绑定直接调 CUDA Driver 执行——这么做是为了绕开 ILGPU 的运行时代码生成,因为它和 Native AOT 不兼容。cuBLAS、cuDNN 一概不用。
性能方面项目给了一组很克制的数据:Core Ultra 9 185H 加 RTX 4070 Laptop,CUDA FP32 后端,1 个问题(13 tokens)热路径约 40 毫秒,8 个约 311 毫秒,32 个约 1.23 秒。数字本身不算惊人,但作者把限定条件写得很全:只预热一次、采样五次,明说"五次采样不足以证明稳定的尾延迟";W8A32 量化路径目前比 SIMD 还慢,也照实写了;所有输出标记为 uncalibrated,没校准就是没校准。
这种"丑话说在前面"的文档风格,在这个人人吹 benchmark 的年代还挺少见的。
值得一提的是,Sezika 的 README 里写明了参考"TypeSafe Jev 的公开协议与边界",同时声明不复现 Jev 的闭源模型。也就是说,它是把 Jev 的接口契约搬到了一个能嵌进任何 .NET 程序的小引擎里——这也是为什么两条路线的 schema 会那么像。
像到什么程度?我把字段逐个对了一遍
为了搞清楚两边的兼容程度,我翻了 TensorSharp 的 JevRequest.Parse 和 JevInference.Run 源码,以及 Sezika 的 DecisionRequest/DecisionResponse 定义和输出文档,把请求和响应逐字段对了一遍。
请求顶层字段
字段 | TensorSharp /v1/systemone | Sezika predict / Evaluate |
|---|---|---|
model | 可选;jev-latest / jev-preview 是已加载模型的别名 | 必填;必须是固定的 convaiinnovations/laya-multilingual,加载时校验 revision 和逐张量 hash |
state | 必填;string / object / array,非字符串取 JSON 原文 | 必填;任意 JSON 值都行,取 JSON 文本当提示 |
顶层 instructions | 可选,注入系统提示 | 没有这个字段 |
images | 可选,≤8 张内联 base64;拒绝 URL 和文件路径 | 无(纯文本编码器,看不了图) |
questions | 必填 map,≤64 题;id 不许带冒号和控制字符 | 必填 map,默认 ≤32 题 |
samples | 1–32 或 "auto"(默认):多读几次取平均 | 无,单次确定性前向 |
auto_max / auto_threshold | 第一次读出来条件熵超过阈值(默认 0.1 nats)就自动多读,最多 auto_max 次(默认 4) | 无 |
seed | 默认 42;只保证同运行时同后端可复现 | 无(编码器没有随机性) |
chunk_rows / chunk_prompt | canvas 放不下时把 schema 切块 | 无(逐题编码,没有 canvas) |
steps / think | 必须是 steps=1、think=0,否则报错 | 无 |
显式拒绝的字段 | depends_on、ask_if、sequential、audio/video 等,每个都带具体理由 | 重复属性直接报 decision_duplicate_property |
体积限制 | 请求体 ≤8 MiB(可调) | 请求 ≤1 MiB、JSON 深度 ≤32、state ≤256 KiB |
questions 条目
字段 | TensorSharp | Sezika |
|---|---|---|
type | "noul" / "choice" / "score" | "boolean" / "choice" / "score" |
instructions | 可选,默认空串 | 必填 |
criteria(choice) | 候选名 → 描述,2–26 个 | 候选 ID → 描述,≤32 个 |
criteria(score) | 有序等级数组,2–26 级 | 有序等级数组,≤10 级 |
criteria(boolean/noul) | 可选 {"true": ..., "false": ...} | 可选 {"true": ..., "false": ...},完全一样 |
类型名差一个:noul 对 boolean。这个名字差异背后是实现思路的不同——TensorSharp 要把候选编译成具体的 token 标签(布尔固定用 yes/no,choice 用 A/B/C…,score 等级少的时候用数字),然后在完整模板里重新分词,验证每个标签恰好占一个 token,验证不过直接拒绝请求。Sezika 没这层编译,每题编码成固定 marker 序列,决策头直接打分。
响应顶层字段
字段 | TensorSharp | Sezika |
|---|---|---|
model | 有 | 有,还带 model_revision 和可选的 tokenizer_revision |
backend | 无(diagnostics 里有 engine 字段) | 有,比如 cpu-modernbert-marker-head |
answers | map(问题 id → 答案) | map(问题 id → 答案) |
usage | input_tokens / output_tokens(图片占的 soft token 也算进去) | question_count / token_count / micro_batch_count / workspace_bytes |
诊断信息 | 单独的 diagnostics 块:概率语义声明、seed、采样策略、耗时、分块情况、每题的条件熵和标准误 | 没有独立块,诊断信息放在每个答案的 calibration 和 status 里 |
单个问题的答案
公共部分:
字段 | TensorSharp | Sezika |
|---|---|---|
type | 回显 | 回显 |
status / abstention_reason | 无拒答概念,要么给答案要么整体报错 | 有 answered / abstained;低于置信门槛时照样返回 argmax 和概率,但标记拒答,文档明说不许拿它当执行依据 |
calibration | 无(语义说明在 diagnostics) | 有,uncalibrated / calibrated / out_of_scope 三态 |
logits | 不输出 | 可选输出原始 logits,方便和参考实现对齐 |
三种原语:
原语 | TensorSharp | Sezika |
|---|---|---|
choice | choice + probabilities + confidence(最大概率) | choice + probabilities + concentration(分布集中度) |
score | score(Σ i·pᵢ,从 0 开始算期望)+ legend + probabilities + confidence | score(公式相同)+ legend + probabilities + concentration |
boolean/noul | {"type":"noul", "noul": P(yes)} | {"type":"boolean", "probability_true": P(true)} |
字段之外,几个容易踩坑的差异
字段长得像,不代表行为一样。有几个语义差异我觉得比字段差异更值得注意。
confidence 和 concentration 不是一个东西。 TensorSharp 的 confidence 是条件分布里最大那个概率;Sezika 的 concentration 是归一化熵算出来的集中度。同一个请求在两边跑出来的这两个数没有可比性,别混着用。
对"不确定"的处理思路相反。 TensorSharp 遇到不确定的题会自己多读几次(这就是 samples: "auto" 干的事),最后给平均值,还在 diagnostics 里告诉你几次读取之间的一致性和标准误。Sezika 是确定性的,一次前向就一个答案,但它把"这个答案信不信得过"做成了协议的一部分:你可以设最低浓度门槛,不达标的答案标记为 abstained,由调用方决定怎么办。一个靠"多想几遍",一个靠"明说不敢答"。
可复现性的含义不同。 TensorSharp 有 seed,但文档坦白说不保证和 Python/NumPy 产生一样的噪声,只保证同环境可复现。Sezika 压根没有随机源,复现性靠固定模型版本加完整的 hash 校验链。
两边都很诚实,只是诚实的位置不一样。 TensorSharp 把限制写在 diagnostics 和各种拒绝码里;Sezika 直接写在每个答案的校准状态字段里。共同点是:都不允许"概率高"自动等于"可以执行",动不动手永远由调用方决定。
所以该用哪个
场景 | 建议 |
|---|---|
高频低延迟的本地判断:意图识别、路由、RAG 重排 | Sezika,毫秒级,AOT 编出来嵌进进程就行 |
需要大模型的世界知识和语义理解 | TensorSharp Jev |
答案在图里:质检、票据、红绿灯这种视觉判断 | TensorSharp Jev,目前只有它支持图片 |
业务流程里需要显式的拒答和校准状态 | Sezika,这是协议自带的 |
不确定时希望模型自己多算几遍 | TensorSharp Jev 的 samples: "auto" |
其实两者也不冲突。接口契约几乎一样,完全可以分层用:Sezika 放前面做高频路由和初筛,拿不准的、需要看图或者需要常识的,再丢给 TensorSharp Jev。小引擎守门口,大引擎做终审。
最后
翻这两个项目的文档时,我印象最深的不是性能数字,而是两边都在反复强调同一件事:模型给出的概率只是概率,没校准过就不是正确率。Sezika 把每个答案都标上 uncalibrated,TensorSharp 在文档里专门写"条件置信度不是经验校准的正确率,上线前请用自己的数据评估"。
判断引擎这类东西,接入业务的门槛从来不在 API 好不好调,而在你敢不敢信它。这两个项目至少在这点上很清醒——先把丑话写进协议里,再谈怎么用。
参考资料
- TensorSharp 仓库(Jev 文档在
docs/models/jev.md):https://github.com/zhongkaifu/TensorSharp/ - vLLM PR #57250:https://github.com/vllm-project/vllm/pull/57250
- How to Build a Jev-Style Classifier with DiffusionGemma and vLLM(Karl Weinmeister):https://medium.com/google-cloud/how-to-build-a-jev-style-classifier-with-diffusiongemma-and-vllm-ef2e0bfa9ad7
- Sezika 仓库:https://github.com/IoTSharp/Sezika
- 《Sezika:用 C# 为本地应用构建一个"判断引擎"》( https://mp.weixin.qq.com/s/IMnsFV5t9khDKPXiALmi9g )
- LocalJev:https://github.com/githubnext/localjev
文中的性能数据都来自各项目的公开文档,测试条件以原文为准。
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-09-25,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号