我的 WorkBuddy 装了 24 个 Skill,然后我花一小时做了一次体检
原创
我的 WorkBuddy 装了 24 个 Skill,然后我花一小时做了一次体检
原创
用户12797714
发布于 2026-10-02 11:02:38
发布于 2026-10-02 11:02:38
我的 WorkBuddy 装了 24 个 Skill,然后我花一小时做了一次体检
用了几个月,Skill 目录攒到 24 个、141 个文件、1.76MB。
然后我发现一个问题:我知道每个 Skill 是干什么的,但我不知道什么时候该用哪个。
更麻烦的是,我改完一个 Skill,过两周就忘了自己为什么这么改;Skill 之间还会互相抢活——我跟它说"写个小说",它有时候不挑那个专门写网文的 Skill,挑了个通用的。
所以花了大概一小时做体检。结果比预想的严重。
一、先说体检怎么做的
没有上来就动手。先只读扫描,不动任何文件。
分四项:
- 清点体积 — 每个 Skill 有多少文件、占多大
- 找垃圾 — 文件名里带"备份""副本""_old"的,或者
__pycache__编译缓存 - 交叉引用检查 — SKILL.md 里提到的其他 Skill 名,是不是还存在
- 路由冲突扫描 — 逐个比对 description,找职责重叠
跑完之后发现:目录很干净。没有备份垃圾混进来。
但真问题四个,一个都不轻。
二、问题一:一个大 Skill 的描述塞了 1673 字
我那个主力 Skill(用来写小说正文的)有个问题:
它的 description 字段1673 字。
description 是干什么的?它是路由依据——你说话的时候,模型靠读各个 Skill 的 description 来判断该用哪个。
正常应该 200–600 字。
我这 1673 字是怎么来的?把 27 份参考文档的能力清单 + 所有触发词,全堆进去了。
长这样:
短篇正文生成主力 skill。八阶段闭环 + 九卷章法 + 逻辑闭环卡 + 分节体例 + 丰满度微观落地(感官/动作/情绪物理化/时间膨胀/潜台词)+ 情绪工程(核心情绪源出一孔/情绪拉扯压三次/三翻四震/震惊反应靠配角兑出)+ 口语化(第一要务)+ 心理描写准入规则 + 盐选投稿硬线自查 + 情感描写技法 + 感觉描写技法 + 手部动作技法 + 表情与神态技法 + 心理变化技法 + 字数纪律 + 打斗设计 + 去AI味台词与对话体例 + 动作表情素材 + 逐节量化自检。当用户要写/继续写短篇、女频爽文……或抱怨"有大纲却写不丰满/卡文/开篇写不动/人物没情绪/脸上没戏/神态只会笑和脸色一变/转折写成了结果:愣了一下/心里一紧/恍然大悟/脸绷住了/台词像AI写的/环境描写像说明文/动作太单一,手只会攥和握/同一个动作反复用:张了张嘴/抬起头/站住了 写了十几遍……"
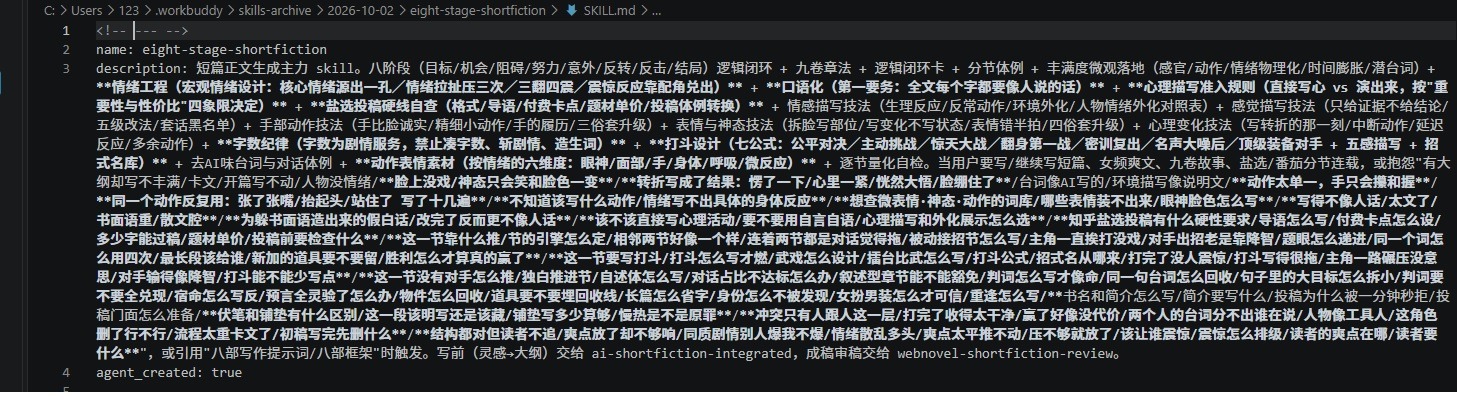
改前 1673 字(一整行)。能力清单 + 触发词穷举,全堆在 description 里。
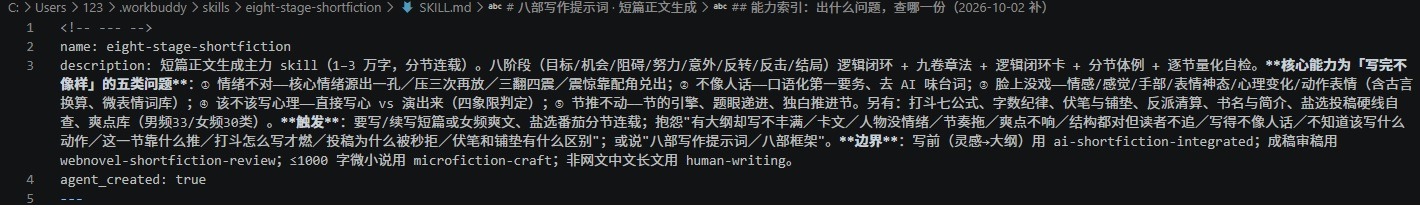
改后 603 字(一整行)。改成"定位 → 核心问题 → 边界"三层。
问题在哪?
两个:
- 能力清单堆在 description 里是浪费。 那个清单是给"已经决定用这个 Skill"的人看的,不是给路由判断用的。路由只需要知道"这个 Skill 管什么、不管什么"。
- 触发词穷举会稀释信号。 我把所有能想到的说法全塞进去,结果是 description 里全是噪声,真正管用的信号(这个 Skill 在哪方面强、边界在哪)反而糊了。
怎么改
description 只保留三层:定位 → 核心问题 → 边界。
改成 603 字:
短篇正文生成主力 skill(1–3 万字,分节连载)。八阶段逻辑闭环 + 九卷章法 + 逻辑闭环卡 + 分节体例 + 逐节量化自检。核心能力为「写完不像样」的五类问题:① 情绪不对 ② 不像人话 ③ 脸上没戏 ④ 该不该写心理 ⑤ 节推不动。另有:打斗七公式、字数纪律、伏笔与铺垫、反派清算、书名与简介、盐选投稿硬线自查、爽点库。触发:要写/续写短篇;抱怨"有大纲却写不丰满/卡文/人物没情绪/节奏拖/爽点不响/结构都对但读者不追/写得不像人话/不知道该写什么动作/这一节靠什么推/打斗怎么写才燃/投稿为什么被秒拒"。边界:写前用 A;成稿审稿用 B;≤1000 字微小说用 C;非网文长文用 D。
关键改动:把"五类问题"提上来。
原来是按"我有什么能力"组织(罗列 27 份文档),现在按"你会遇到什么麻烦"组织。这个顺序一变,description 从资产清单变成了索引。
那 27 份文档的能力清单去哪了?
没丢,移到正文里了。在 SKILL.md 开头新加一节「能力索引」,做成一张表:
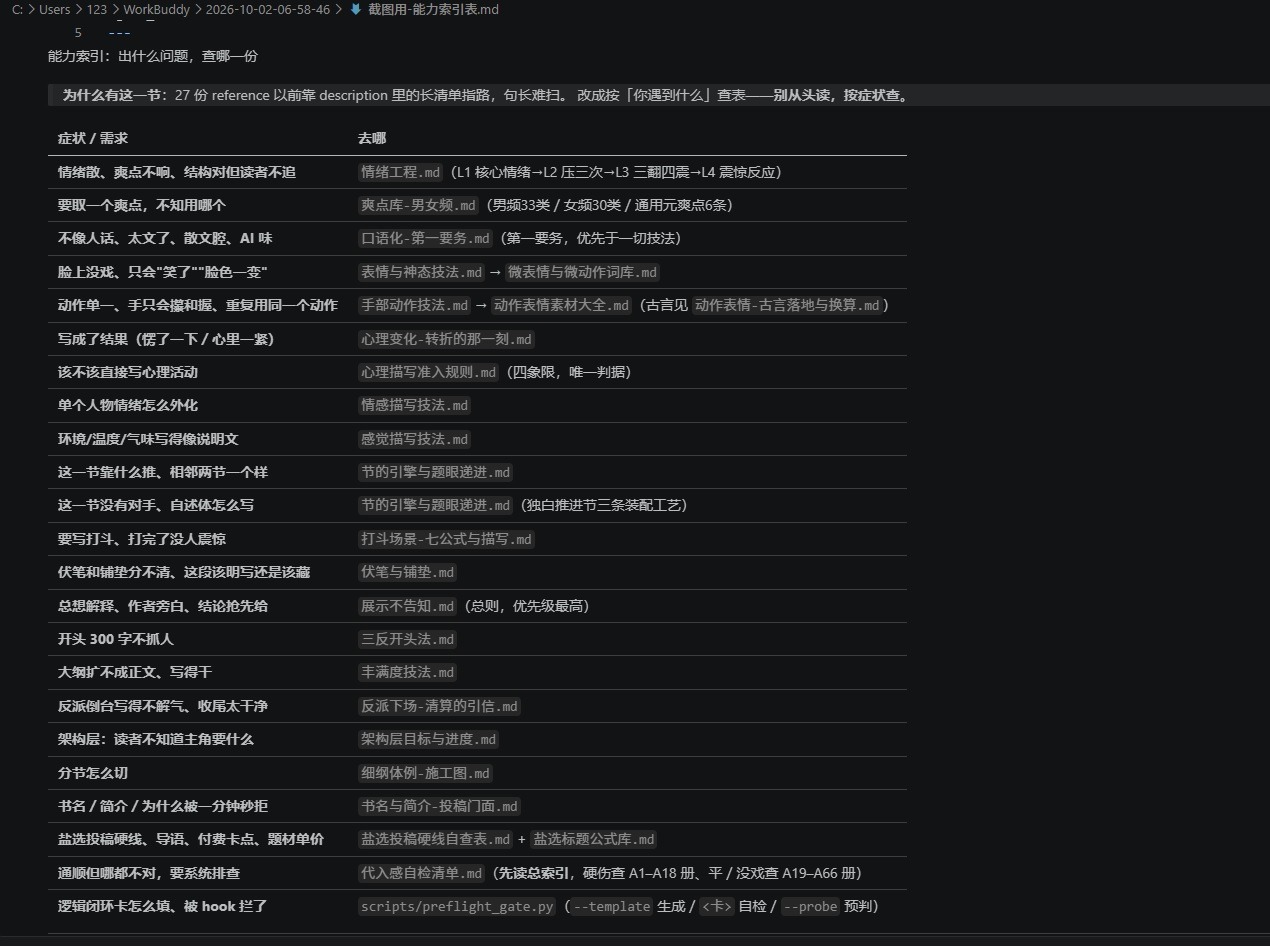
这张 24 行表就是"能力索引"全文。左边是症状(用你自己的话说出来的那个麻烦),右边是该翻哪份文件。
症状 / 需求 | 去哪 |
|---|---|
情绪散、爽点不响、结构对但读者不追 |
|
不像人话、太文了、散文腔 |
|
脸上没戏、只会"笑了""脸色一变" |
|
动作单一、手只会攥和握 |
|
写成了结果(愣了一下/心里一紧) |
|
环境/温度/气味写得像说明文 |
|
这一节靠什么推、相邻两节一个样 |
|
要写打斗、打完了没人震惊 |
|
(实际有 24 行,这里截一段)
这才是它该在的地方。 已经决定用这个 Skill 了,才会去看这 27 份文档;按症状查,比按文档名读快得多。
一句话总结:description 是给你"选"用的,不是给你"读"用的。能力清单属于正文。
补一句反例:这次还改了另一个 Skill 的 description——它是从 325 字改到 566 字,变长了。 为什么反而要加长?因为它的问题是边界不清(它把"小说、故事、对白"也写进了自己的地盘,跟别人抢活),加长的那部分全是边界声明:说清自己管什么、不管什么、别人该找谁。所以"瘦身"不是目的,"分层清楚"才是目的——该砍的砍,该补的补。
三、问题二:两个 Skill 抢同一句话
体检第 4 项抓出来的。
我装了一个通用中文写作 Skill。它的 description 里写着:
用于知乎回答、论坛长帖、公众号文章、博客、评论、人物故事、历史叙事、新闻与行业解读、科普、教程、评测、个人叙事、小说、故事、对白、口播和演讲稿。
看到问题了吗?
"小说、故事、对白"这三个词,和我那个专门写网文的 Skill 完全重叠。
结果就是:我说"写个小说",路由有时候挑通用那个,有时候挑网文那个。挑错了,出来的东西完全不是一回事——通用那个管的是"非虚构长文的活人感",网文那个管的是"八阶段闭环 + 分节钩子 + 情绪工程"。
扫描结果比想象中难看
我把所有 Skill 的 description 拉平,逐个词做交叉统计。以下都是真实命中数:
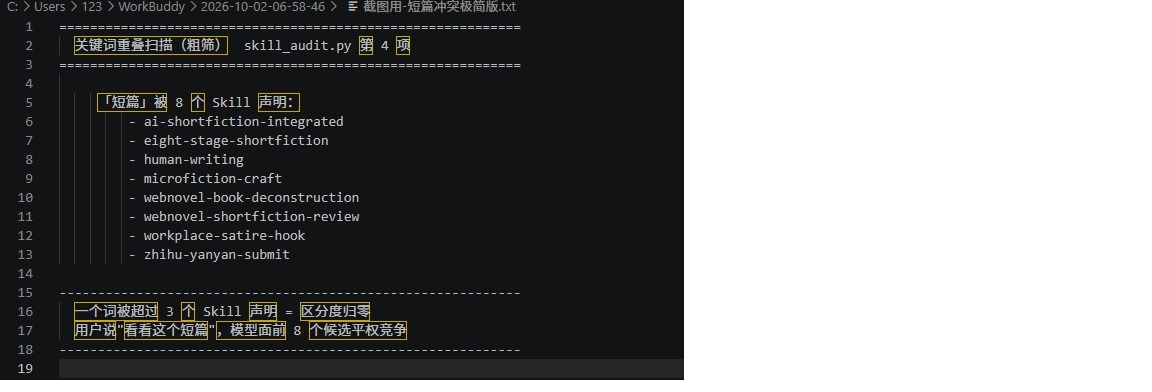
跑体检脚本第 4 项的实际输出截图。注意路径栏——skills-archive 说明这是从归档目录里读的原始数据。
词 | 被几个 Skill 的 description 声明 |
|---|---|
短篇 | 8 个 |
写作 | 5 个 |
小说 / 故事 / 文章 / 公众号 / 网文 | 各 4 个 |
微小说 | 3 个 |
改稿 | 2 个 |
"短篇"被 8 个 Skill 声明。 我全部写作向的 Skill 加起来也才 8 个——等于说,这个词在整个库里没有任何区分度。用户说"帮我看看这个短篇",模型面前就是 8 个候选,它挑哪个全看运气。
"写作"被 5 个声明,同一个病:越大的词,越没有区分度。
不用往深里想:一个词如果被超过 3 个 Skill 声明,它就不该出现在 description 里当卖点。 要么删掉,要么配上限定("≤1000 字短篇"能救,光写"短篇"救不了)。
怎么改
在通用 Skill 的 description 里加边界声明。
两处:
- 把"小说、故事、对白"改成"虚构向仅限非网文的文学短章(散文体、随笔体、人物特写式的虚构),不承担网文职责"
- 末尾追加一段:
路由边界:网文短篇/女频爽文/分节连载(1–3 万字)→ 用 X;微小说/极短篇(≤1000 字单反转)→ 用 Y;写前灵感与大纲 → 用 Z;网文成稿审稿 → 用 W。本 skill 只服务非网文的通用中文写作。
「XX 场景请用 YY skill」这句话,是防路由冲突最有效的手段。 比你把所有触发词都列一遍管用。
一个坑要记住
那个通用 Skill 是第三方装的,不是我自己写的。
第三方 Skill 改了 description,上游更新会覆盖你的改动。所以我改完立刻在索引里记了一条:
⚠️ 它是第三方 skill,上游更新会覆盖这处改动。更新后要回来核这一段还在不在;被覆盖就重加。
不改也可能,但你得知道自己没改。最怕的是改了、忘了、更新后悄悄回滚,出了问题还以为是新 bug。
四、问题三:索引落后了 10 个 Skill
我之前做过一份 INDEX.md,用来记"哪个 Skill 干什么"。
问题是——那份索引是我 8 天前写的,当时只有 14 个 Skill,现在是 24 个。
漏掉的是整条线:公众号写作、公众号推送、投稿格式转换、盐言平台投稿、视频转文字、转写稿精校、尺寸敏感图……
索引的价值全在"新",落后了就是负资产——你按它去找,找不到,还以为自己没装。
索引该怎么写
我重写了一遍,核心是加了一张总图和一张边界表。
总图长这样(八条线,四个层级):
供料层(产物喂给下面) └─ 拆书 skill(拆爆款骨架)/ 写作 DNA skill(蒸馏风格)
主链(按顺序走) └─ 写前 → 正文 → 审稿
并列支线(字数量级不同,别混) ├─ 微小说:≤1000 字单反转 ├─ 导语生成:单段批量 └─ 通用中文:非网文长文
投稿落地 ├─ 转投稿 Word └─ 盐言平台自动投稿
公众号支线 └─ 写 + 排 → 推到草稿箱
为什么要分层画:Skill 之间的关系不是平的。有"上游供料"、有"主链顺序"、有"并列支线"。光列表格看不出这个,分出来一眼就明白。
然后是职责边界速查表——三列:
Skill | 管什么 | 字数量级 | 别人问它、其实该找谁 |
|---|---|---|---|
写前 Skill | 灵感→大纲、人设问卷、萌点库、CP 反差 | 产出大纲 | 已有大纲 → 正文 Skill |
正文 Skill | 八阶段+九卷+情绪工程+口语化+六套表演技法 | 1–3 万字·分节 | 微小说 → 微小说 Skill |
审稿 Skill | 量化取证→打分→P0/P1/P2 补丁 | 1–3 万字 | 要写不是要审 → 正文 Skill |
微小说 Skill | ≤1000 字单反转 | ≤1000 字 | 篇幅长 → 正文 Skill |
第三列是专门治"选错了"的。 你问 A,其实该用 B——把这句话写进表里,比指望模型自己领悟靠谱。
我得出的判断方法是两个问题:
字数量级是多少?我在哪个阶段?
这两个答上来,用哪个 Skill 基本就定了。
五、顺手补了一条维护规范
做完上面三件事,我把经验写成规范,放进索引的维护说明里。三条:
description单行、200–600 字。 别把每个参考文档的能力清单和所有触发词都堆进去。- 必须写边界声明。 "XX 场景请用 YY skill"——防冲突最有效。
- 触发词要写用户的说法。 写"脸上没戏""卡文""不像人话",不要写内部术语。你怎么说,就写什么。
六、安全动作:改前先备份
动了三个文件,改之前全部复制到 ~/.workbuddy/skills-archive/2026-10-02/。
这一步不能省。 Skill 是累积资产——里面可能是你几个月踩坑攒下来的判据。改错了没备份,就是真没了。
备份目录放在 skills/ 外面,这样不会被扫描到(只有文件名恰好是 SKILL.md 的才会被加载,但放外面更干净)。
改完做了一遍校验:
- 24 个 SKILL.md 全部 frontmatter 正常可加载,0 异常
- 7 项关键资产全部在位(几个核心参考文档 + 两支脚本)
七、一个明确不要做的动作
体检时我一度想"按用途把 Skill 分到子目录里,视觉上整齐点"。
查了源码,不能这么干。
WorkBuddy 的 Skill 扫描是这样的(源码级事实):
项 | 值 |
|---|---|
扫描起点 |
|
递归 | 是,深度上限 5 层 |
识别条件 | 文件名恰好等于 |
看起来递归 5 层,放子目录没问题对吧?
问题在于:递归是当前实现细节,官方文档只描述了 skills/ 扁平结构。
上游哪天真做了性能优化、改成只扫一层——你嵌套在子目录里的 Skill 会静默消失。不报错、不提示,你以为它在,实际没加载。
收益只是"看着整齐",代价是"可能全部失效"。不值得。
正确做法:分类信息写进 INDEX.md,路由边界写进各自的 description。目录保持扁平。
八、体检清单(可以直接抄)
动作 | 判据 | |
|---|---|---|
1 | 清点体积 | 每个 Skill 多少文件、多大 |
2 | 找垃圾 | 文件名含"备份/副本/_old"、路径含 |
3 | 交叉引用 | SKILL.md 提到的其他 Skill 名,是否还存在 |
4 | 路由冲突 | 逐个比对 description,找职责重叠(最有价值的一项) |
5 | 查 description 长度 | 超过 800 字就要警惕 |
6 | 查索引新鲜度 | 索引记的 Skill 数 vs 实际数,差几个 |
7 | 备份 | 改前复制到 |
8 | 校验 | 改后断言:全部 SKILL.md 可加载 + 关键资产在位 |
第 4 项是重点。前 3 项查出来的是"卫生问题",第 4 项查出来的是"功能问题"。
最后
体检前后对比:
指标 | 前 | 后 |
|---|---|---|
Skill 数 | 24 | 24 |
主力 Skill description | 1673 字 | 603 字 |
路由冲突 | 1 对(已知) | 已补边界声明 |
索引覆盖 | 14 个 | 24 个 |
索引有无总图 | 无 | 有 |
Skill 数量和文件大小一个都没变。变的是它能不能被找对。
这件事的普遍教训是:装 Skill 是加法,用 Skill 是索引问题。
装到十几个以后,瓶颈不在"有没有这个能力",在"我记不记得它在那儿、遇事想不想得起它"。
索引和边界,就是给这件事上保险。
附录:脚本全文
上面第一节说的"体检四项扫描",就是我跑的那个脚本。贴出来,你可以直接拿去跑自己的库。
存成 skill_audit.py,然后:
python skill_audit.py                    # 默认扫 ~/.workbuddy/skills
python skill_audit.py "D:/path/to/skills"  # 指定目录
无依赖、纯标准库、Python 3.6+ 就能跑。
⚠️ 有一点要注意:脚本里那个关键词列表(小说 / 故事 / 短篇 / 公众号 / 文章 / 写作 …)是我这个库的词,你不一定长这样。
怎么找你的词:打开你几个主要 Skill 的 description,看哪些词反复出现,填进去,跑一遍。判断标准很简单——被 1–2 个声明是正常,3 个开始危险,4 个以上基本可以确定是问题。
完整代码见附件(约 200 行,含"怎么改造成你自己的"和"脚本的边界"两节说明)。
本文数据来自一次真实的 Skill 库体检(2026-10-02)。文中的 Skill 名称用代称,方法通用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号