#WorkBuddy# 62 份 PDF 先体检再归档:损坏、加密、重复一个不漏,783 页合并 7 秒
原创
#WorkBuddy# 62 份 PDF 先体检再归档:损坏、加密、重复一个不漏,783 页合并 7 秒
原创
用户12784192
发布于 2026-10-04 08:10:12
发布于 2026-10-04 08:10:12
手头攒了一大批 PDF 周报要归档,最怕的不是文件多,而是里面混着坏文件:有的传了一半是损坏的,有的设了密码打不开,有的同一份被转存了三四遍。逐个双击打开检查,62 份文件起码耗掉一个下午。这次我用 WorkBuddy 把"收文件 → 体检 → 剔除问题件 → 合并归档"做成一条流水线,62 份文件体检只花 0.49 秒,57 份共 783 页合并归档 7.15 秒,并且把损坏、加密、重复三类问题全部自动拦截。
先说整体思路
整条流水线只有三步,每一步都有可核对的数字:
- 合成样本:60 份周报 PDF,每份 6~24 页不等,其中故意埋了 3 份加密件、1 份损坏件(截断文件)、1 份内容完全相同的重复件,共 62 份进入流水线;
- 体检:逐份读文件,校验"能否打开 / 是否加密 / 页数 / MD5 指纹",指纹相同即判重复;
- 归档:剔除问题件后按顺序合并成一份总档,并输出放行清单。
体检的判定规则很简单:打不开 = 损坏;
is_encrypted = true= 加密;MD5 相同 = 重复。 三条规则互相独立,谁先命中谁先出局,避免同一份文件被重复计数。
实测数字
阶段 | 数量 / 结果 | 耗时 |
|---|---|---|
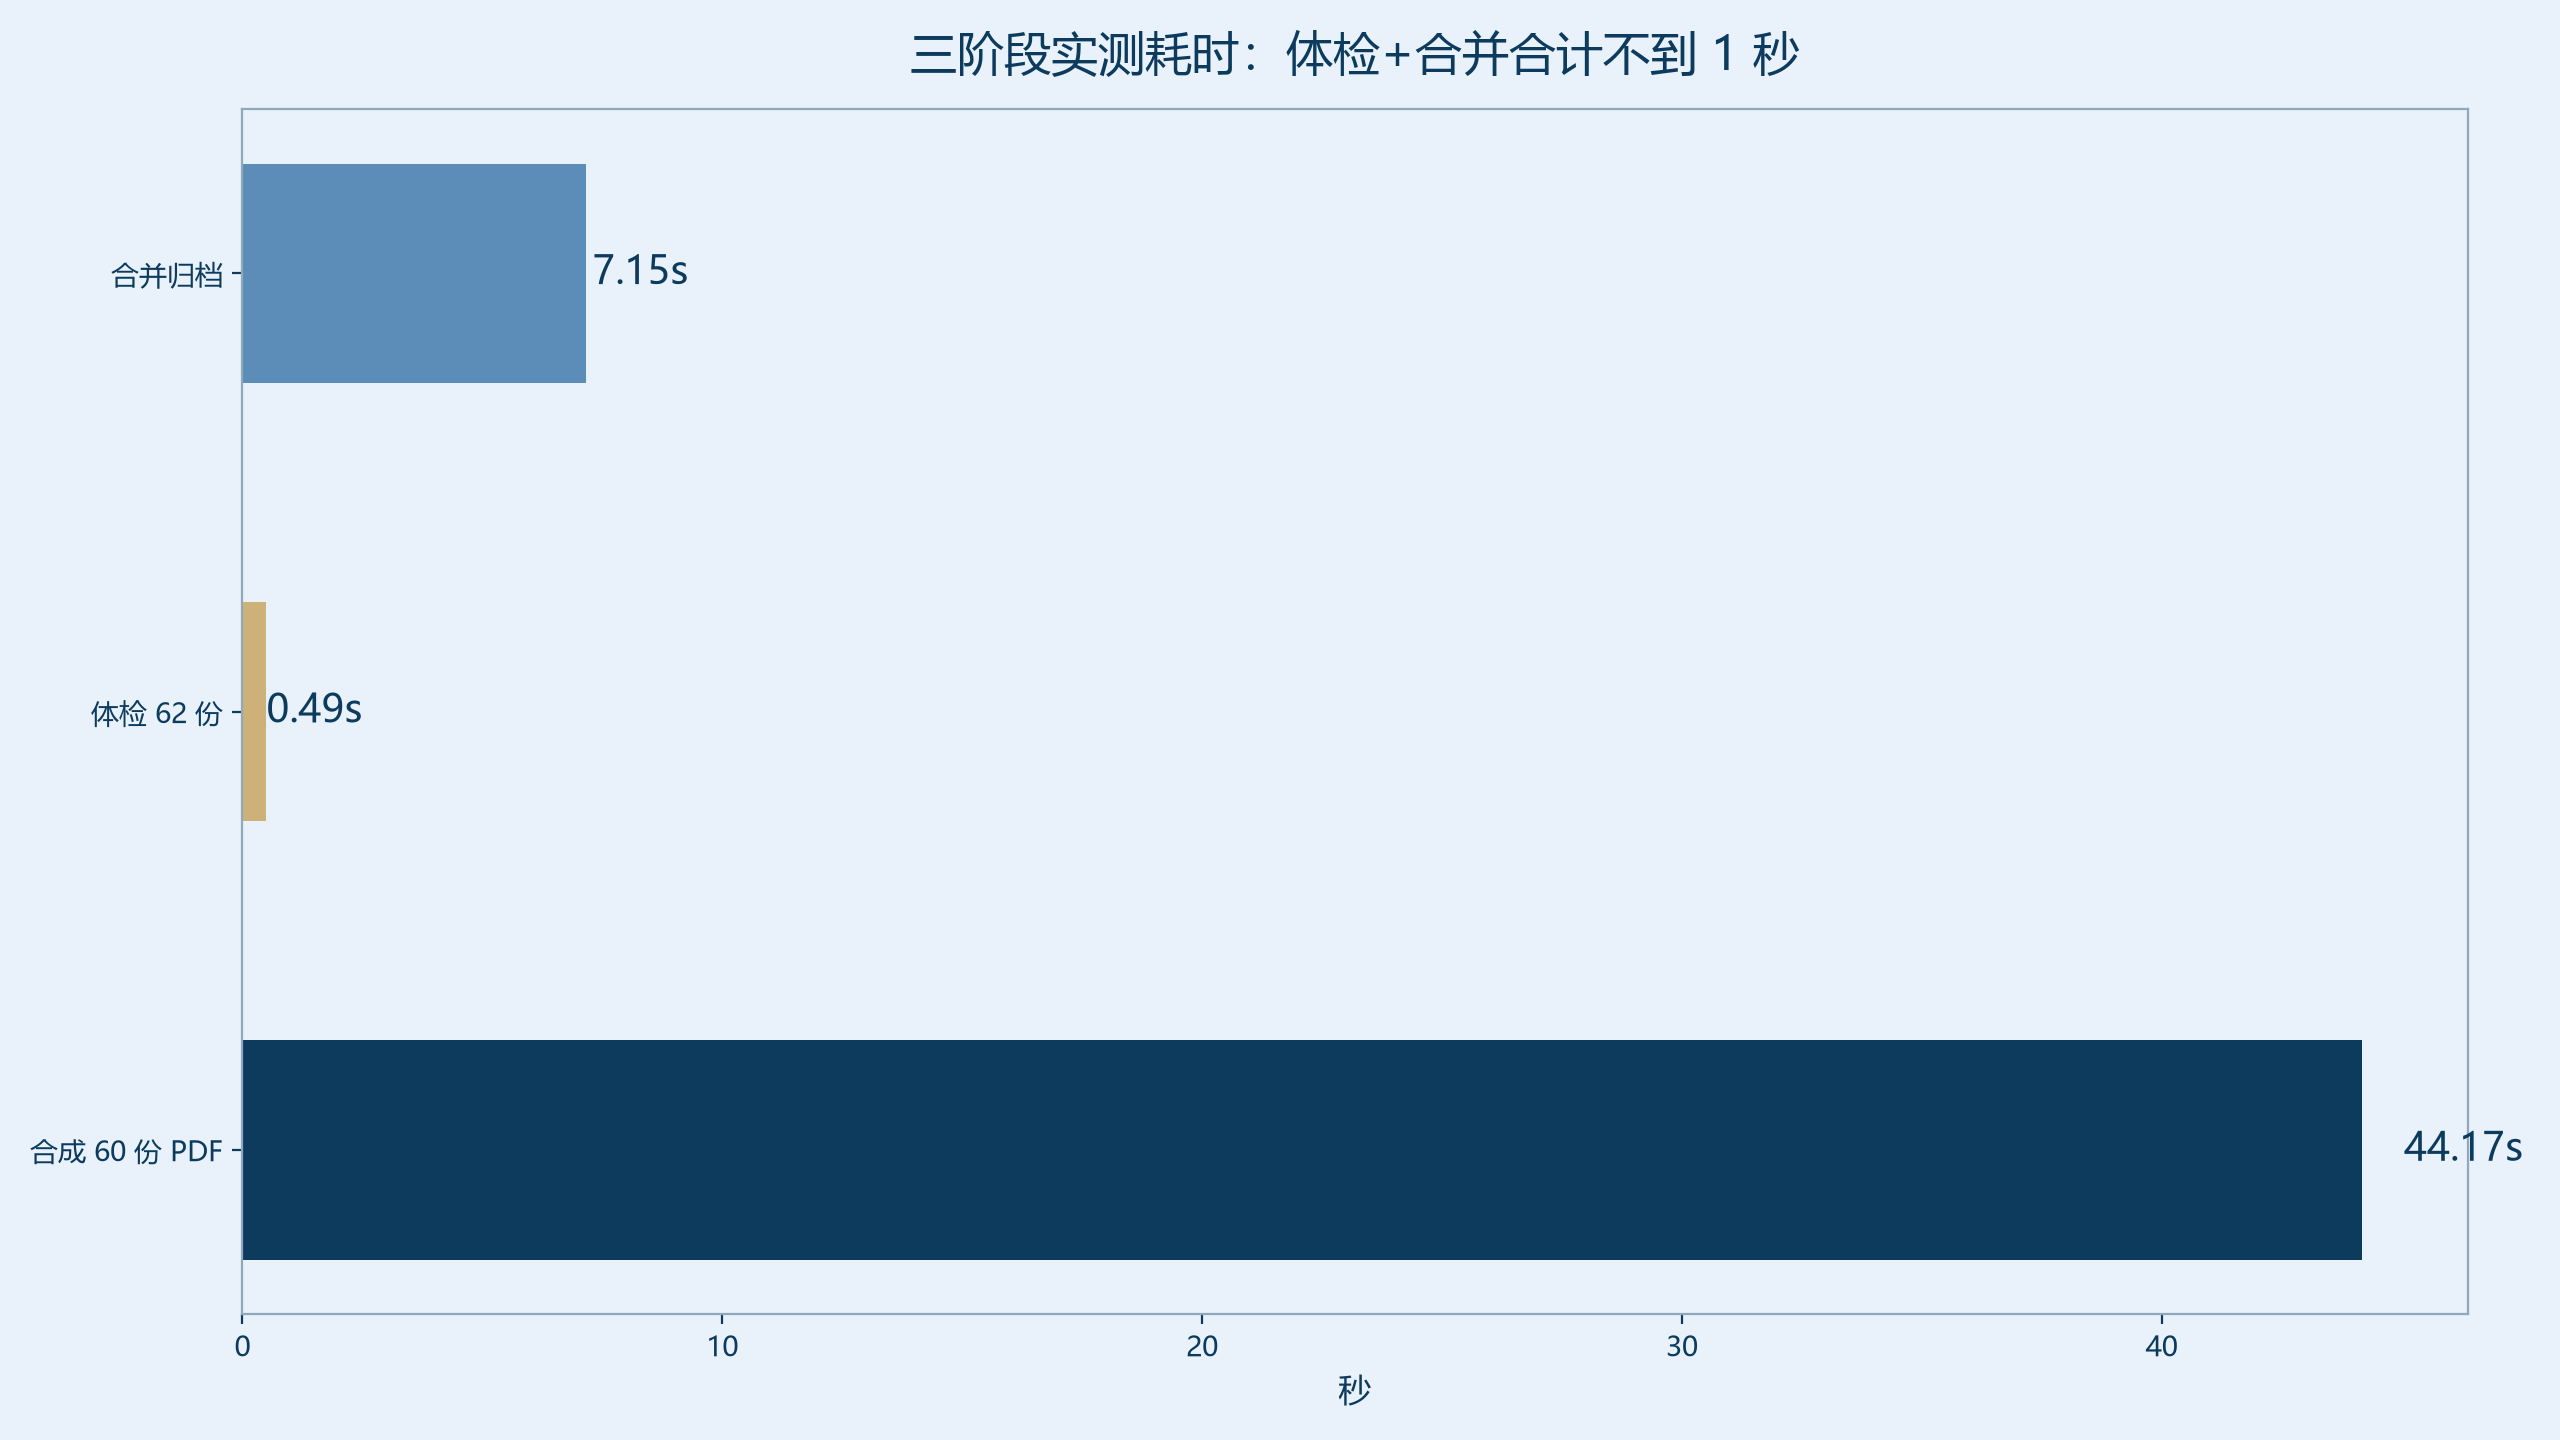
合成 60 份周报(共约 900 页) | 一次性生成 | 44.17 秒 |
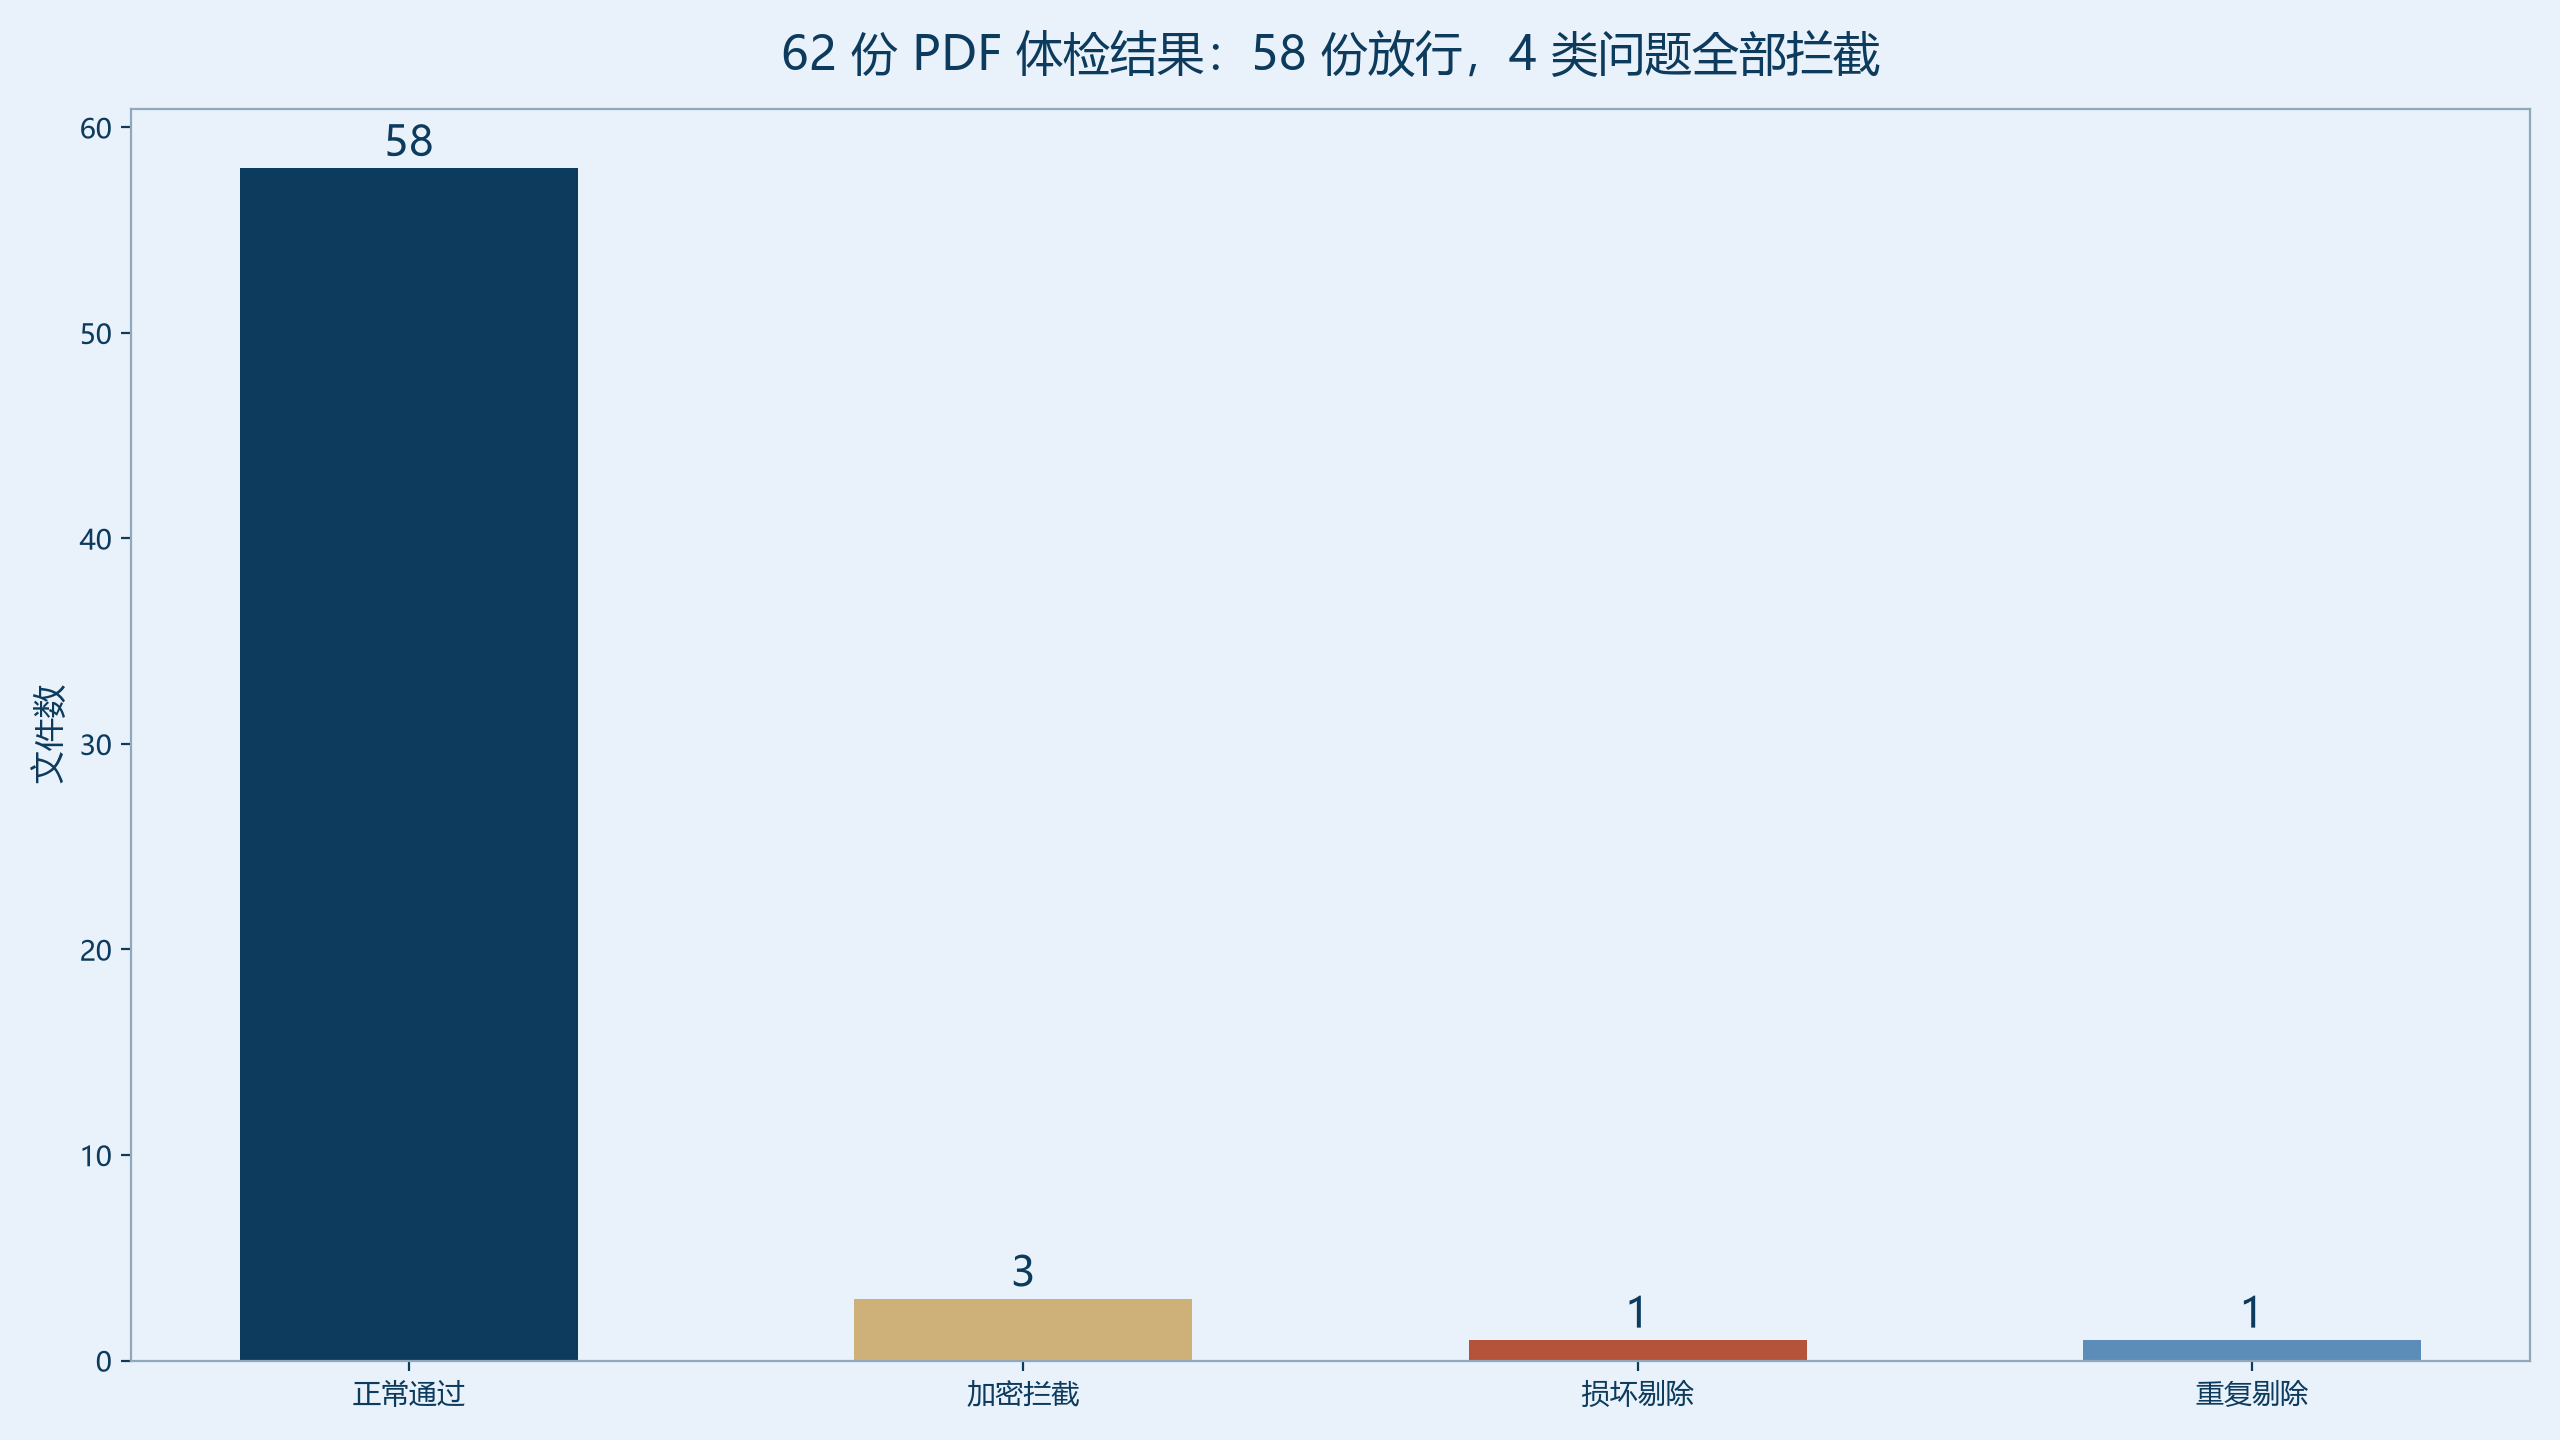
体检 62 份 | 正常 58 / 加密 3 / 损坏 1 / 重复 1 | 0.49 秒 |
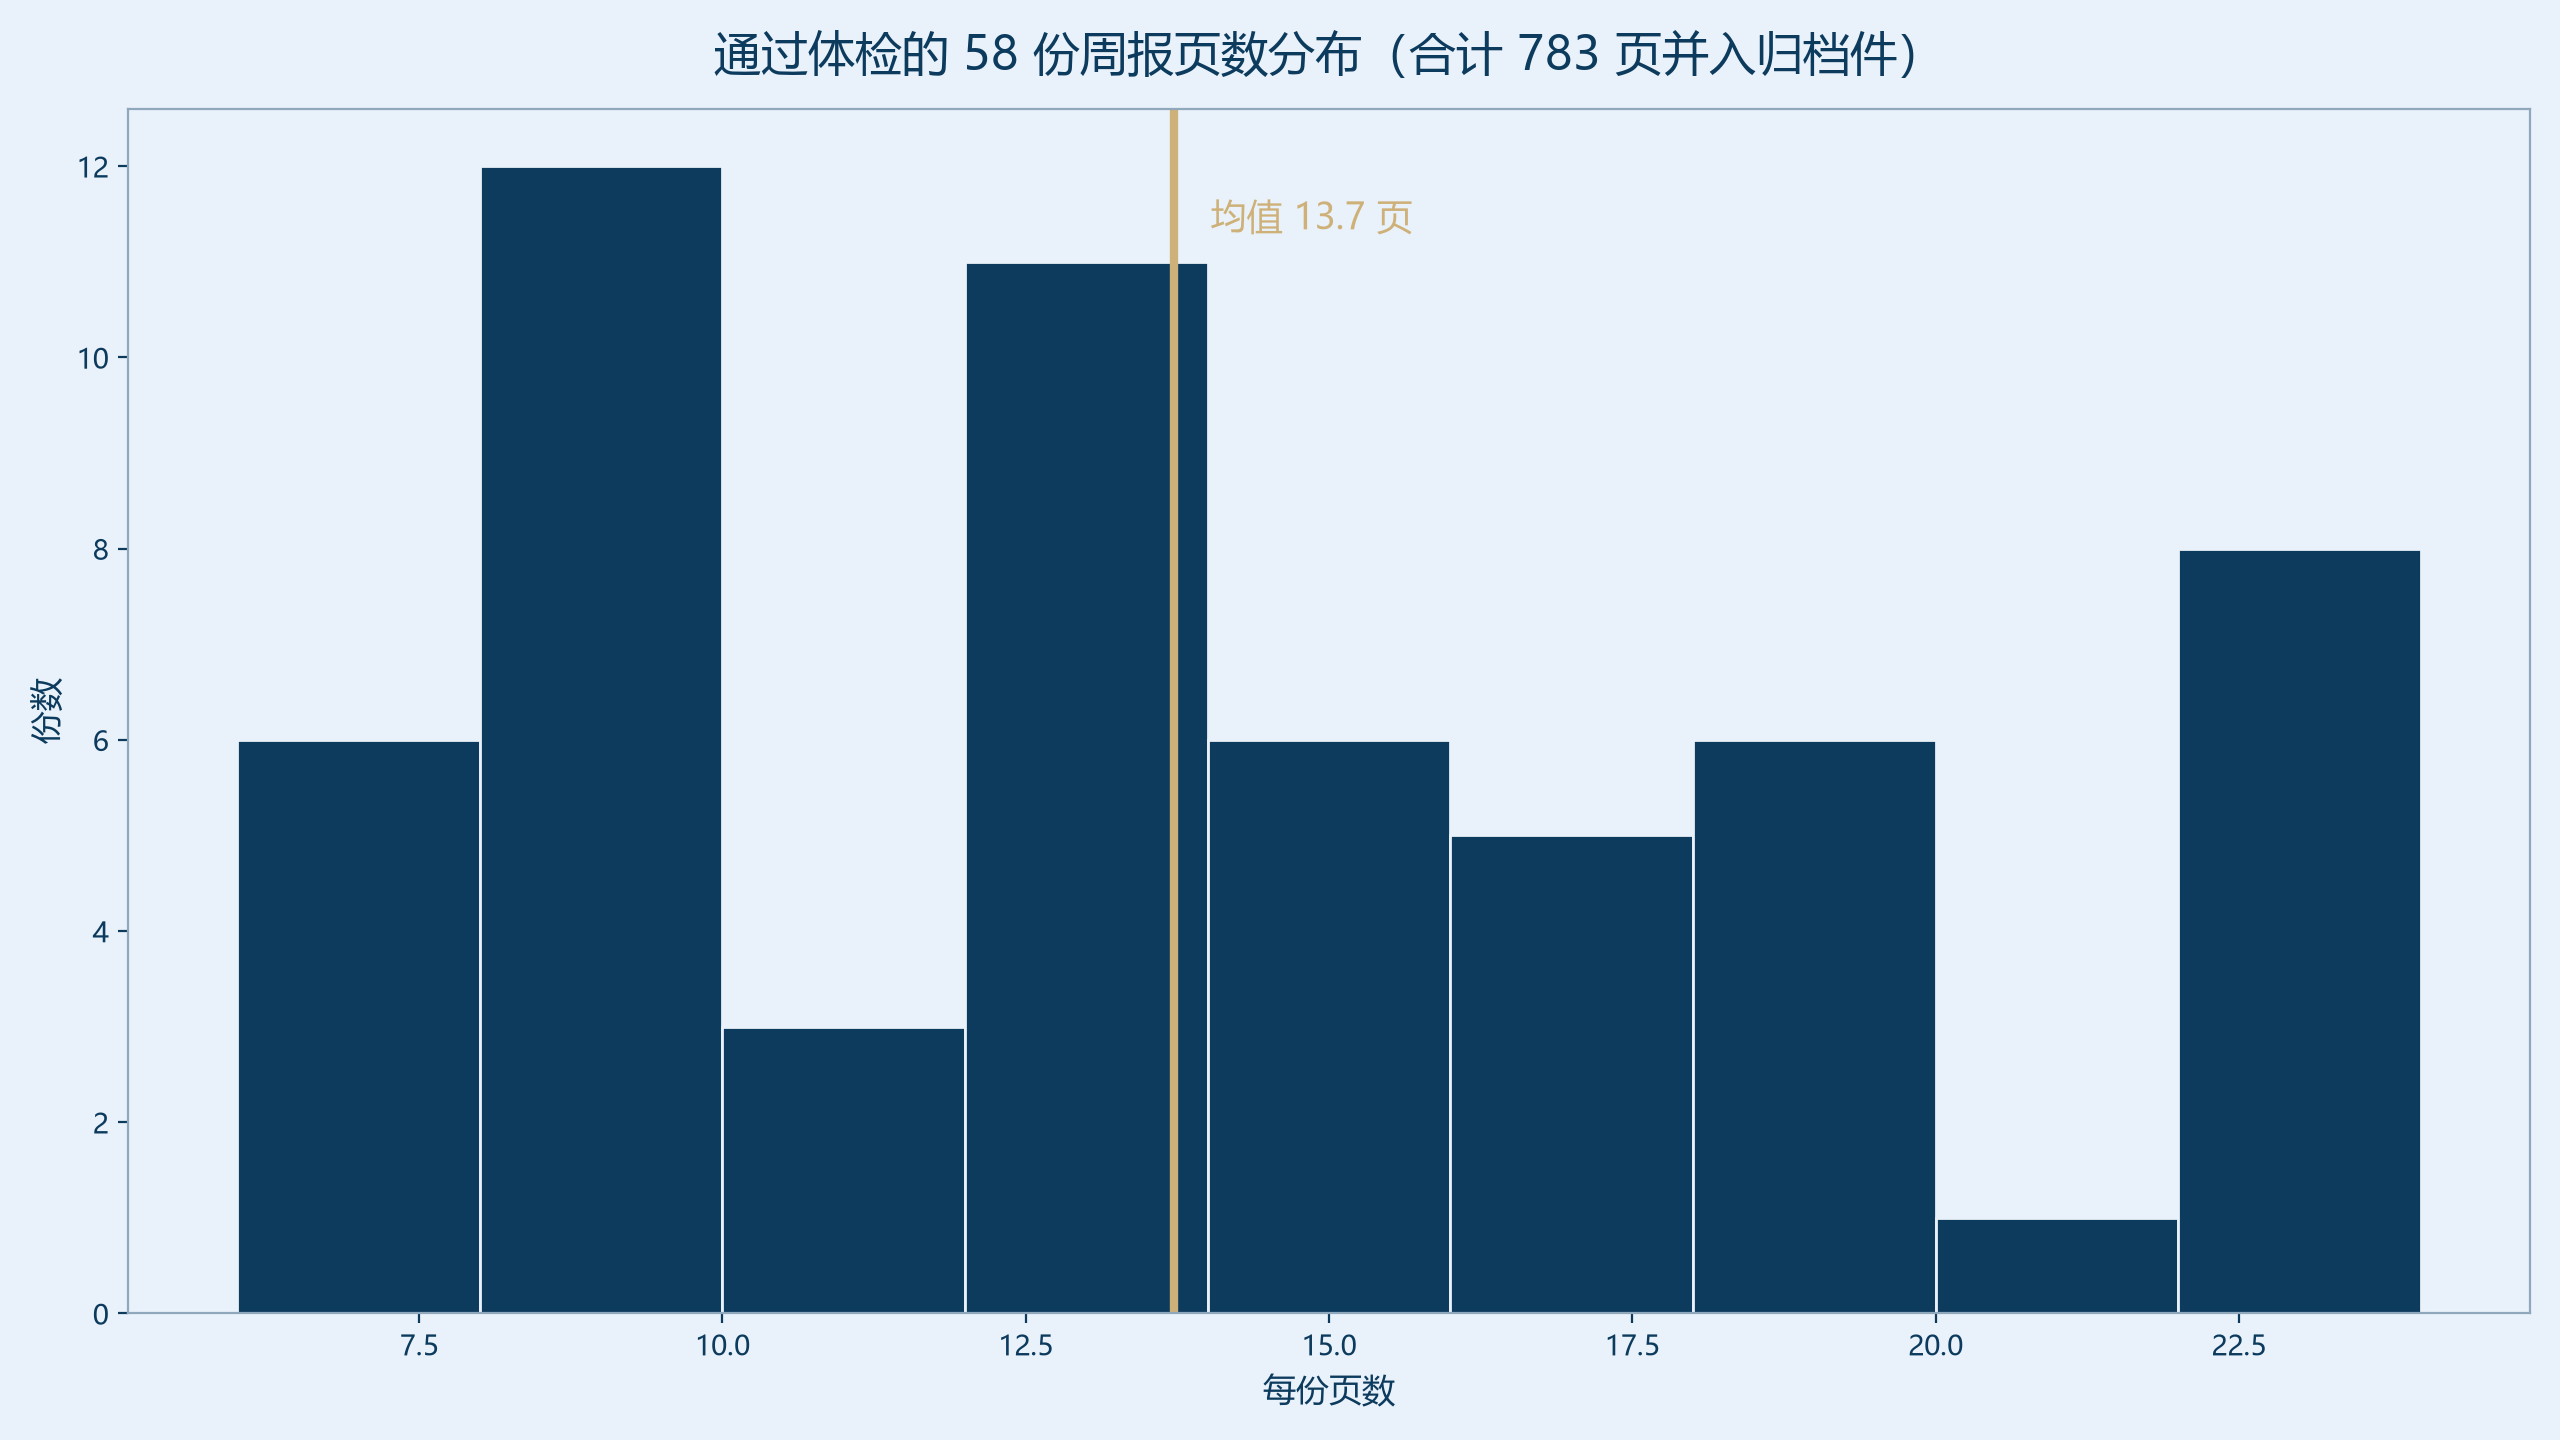
合并归档 | 放行 57 份、783 页 → 17.5 MB | 7.15 秒 |
体检阶段 0.49 秒里完成了 62 次读取、62 次 MD5 和全部页数统计——平均每份不到 8 毫秒。被拦截的 4 份里,加密件 3 份(weekly_report_08 / 24 / 42),损坏件 1 份(截断文件,报 EOF marker not found),重复件 1 份(与第 05 期内容逐字节相同)。
核心代码
完整脚本约 120 行,这里只放体检与去重的核心逻辑,其余(造样本、合并)思路相同。
import hashlib
from pypdf import PdfReader

md5_map, report = {}, {"broken": [], "encrypted": [], "dup": []}
for f in pdf_files:
    raw = open(f, "rb").read()
    h = hashlib.md5(raw).hexdigest()          # 指纹:内容相同即重复
    try:
        r = PdfReader(f)
        if r.is_encrypted:                    # 加密件拦截
            report["encrypted"].append(f); continue
        md5_map.setdefault(h, []).append(f)   # 正常件记指纹
    except Exception:                          # 打不开 = 损坏件
        report["broken"].append(f)

report["dup"] = [v[1] for v in md5_map.values() if len(v) > 1]
三个值得说的细节
第一,重复检测用文件字节指纹,而不是文件名。 文件名改一个字、加个"(1)",名字对不上但内容一模一样;反过来同名文件内容可能不同。MD5 只认内容,62 份里那手工改过名的副本照样被抓出来。
第二,损坏文件要单独捕获。 截断的 PDF 在 PdfReader 初始化时就会抛异常,必须用 try/except 把它和加密件分开记——两者后续处理完全不同:加密件可以找密码恢复,损坏件只能联系来源重传。
第三,合并前必须先剔除,而不是合并后删页。 先体检后合并,放行清单是确定的;如果先合并再事后删,页码会整体偏移,报告里引用的页码全部作废。
结果与复盘
62 份进、57 份出,4 份问题件全部拦截且零误杀;783 页合并成一份 17.5 MB 的归档件,附带一份"放行 + 拦截原因"的核对清单。整个体检加合并不到 8 秒,人工逐份打开核对至少半小时起。
作者所处行业与岗位:信息技术服务业 · 数据与效率工具工程师。
本文所有文件为脚本合成的测试数据,不含任何真实业务信息;数字均为本机实测,可复现。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号