让 WorkBuddy 当一次技术侦探:我如何把一个平台的积分机制彻底查清楚 #WorkBuddy#
原创
让 WorkBuddy 当一次技术侦探:我如何把一个平台的积分机制彻底查清楚 #WorkBuddy#
原创
用户12287393
发布于 2026-10-14 22:56:32
发布于 2026-10-14 22:56:32
一、起因:一个"说不清"的疑问
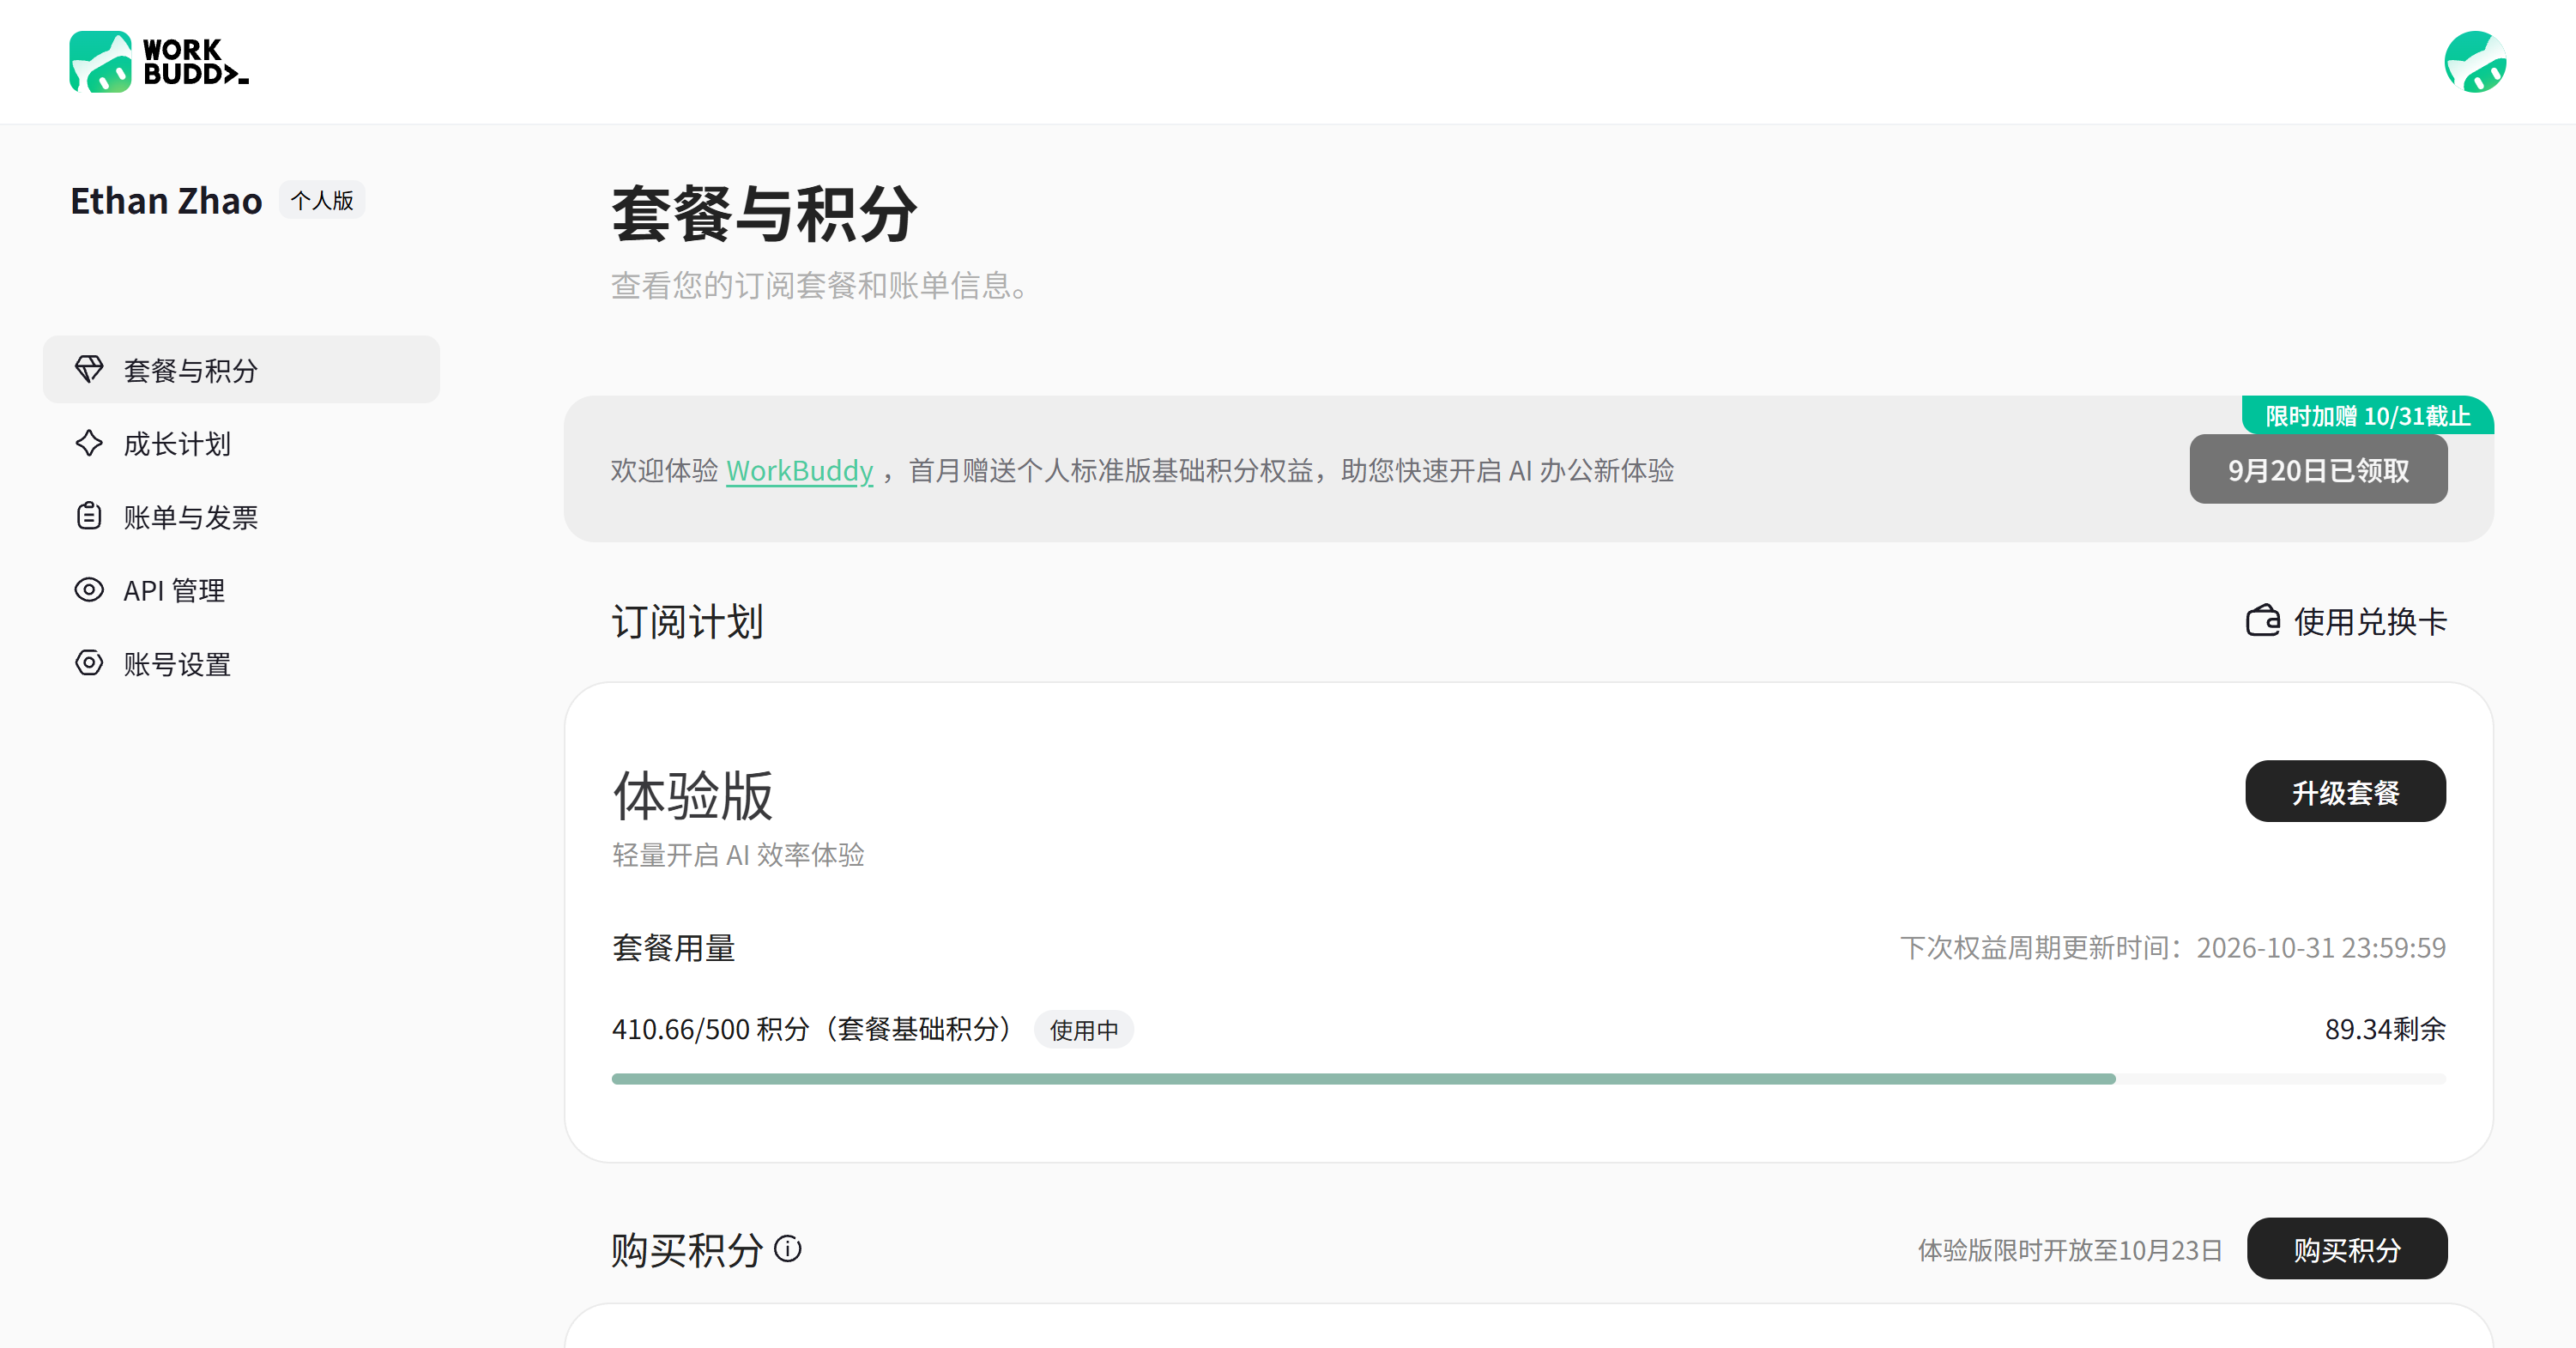
事情起因很小。我在 WorkBuddy 的成长计划里做任务,其中一项是「召唤 5 次专家」。
我让 Agent 去网页版工作台操作:打开专家中心、点「召唤」、发起对话。从结果看,这次操作完全成功——会话真实创建了,专家真实回复了,后台还能看到它耗时 2 分 22 秒,中途还调用了技能。
但回到成长计划页一看:进度纹丝不动,还是 0/5。
这时候通常有两种反应:一是"这功能有 bug",二是"我哪儿做错了"。但我更想知道第三种答案——它到底按什么规则判定的?
于是我让 Agent 接着查。这一查,就变成了这篇文章。
二、第一轮取证:看页面能告诉我们什么
最直观的做法是回页面确认。Agent 刷新成长计划页,把任务卡片的进度重新抓了一遍:0/5,确实没变。
页面本身只能给出"结果没变"这个事实,给不出原因。但它排除了一种可能:不是显示延迟,也不是缓存问题——反复刷新、另开标签页,进度都一致。
这一步的价值在于确认"问题真实存在",值得继续往下挖。很多排查半途而废,就是因为跳过了确认这一步,去追了一个根本不存在的现象。
三、第二轮取证:明细里藏着答案
真正的突破口在另一个页面:「套餐与积分 → 积分消耗明细」。
这个页面会列出每一条请求的来源和消耗。我让 Agent 把它拉出来看,关键的一行信息浮出水面——那次网页端对话的使用端标记是 web_agents。
答案就在这一个字段里。
成长计划的进度统计,只认桌面客户端的行为;网页端的请求被打上了 web_agents 的标记,压根不进入这套统计口径。所以不是"操作没生效",而是"操作生效了,但没被算进去"。
这个发现直接改写了我对整件事的判断:任务卡片上标注「PC」的,必须打开客户端做。之前在这一类任务上花的所有网页端尝试,都是无效功。
我让 Agent 把这条结论记进了复盘文档,后面所有同类任务都按"客户端优先"处理,没再走过弯路。
四、第三轮取证:能不能绕过这个限制
查到原因后,自然会冒出一个念头:能不能让 Agent 直接去操作桌面客户端?
如果客户端能像浏览器那样开放调试端口,理论上可行。于是让 Agent 去查本地进程:
- 先列出所有疑似客户端进程,拿到 PID
- 再扫本地监听端口,看有没有暴露调试服务
- 对可疑端口逐一探测,判断是不是标准的调试协议
结果是:客户端确实监听了本地端口(17246、18098),但 17246 返回的是内部 JSON 接口,不是调试协议。 也就是说,这条路走不通。
到这里,排查其实可以结束了。但有意思的是——这个"走不通"本身也是一个有价值的结论,它明确划出了能力的边界,避免后续在错误方向上反复投入。
顺带说一句我自己给自己定的红线:既然拿不到调试入口,那就绝不能退而求其次去调内部接口伪造"任务已完成"。活动条款明确写着禁止刷量、篡改数据,做了会被追回奖励甚至封号。Agent 的能力应该用在"替你真实操作"上,而不是"伪造你操作过"——这条线一旦跨过去,性质就完全变了。
五、第四轮取证:交叉验证,别只信一处
前几轮都是"看自己的环境"。但要确认一套机制的全貌,还得看外部信息。
我让 Agent 补了两类交叉验证:
- 官方文档与社区文章:确认积分的发放渠道、梯度规则、以及哪些是官方认可的合规方式
- 实际页面核对:把外部说法拿回自己的账号页面逐条比对,比如"奖励不自动发放""限时任务会过期"这些,都能在页面上直接验证
这一步筛掉了不少过时信息。比如网上流传的某些签到入口,在自己账号里已经找不到了——外部信息必须回到真实环境验证一遍才可信,这是这轮最大的收获。
六、结论:一张表说清"什么能交给 Agent"
整轮排查下来,结论其实可以压缩成一句话:能交给 Agent 的,是"有确定步骤、有可验证结果"的事;不能交的,是"需要真人身份"和"规则不允许"的事。
展开成表:
类型 | 例子 | 能否代做 |
|---|---|---|
页面抓取、状态确认 | 抓任务清单、查进度 | ✅ 适合 |
批量点击、批量领取 | 一键领完所有已达成奖励 | ✅ 适合 |
本地环境探测 | 查进程、扫端口、读接口 | ✅ 适合 |
需要真人身份的操作 | 扫码登录、实名授权 | ❌ 必须本人 |
规则明确禁止的 | 刷量、伪造完成记录 | ❌ 红线,不做 |
需客户端内操作 | 标注「PC」的任务 | ❌ 网页端无法代做 |
七、三条方法论:让 Agent 做调研,我学到的
最后总结三条,我觉得比结论本身更可复用:
1. 每一轮都要有"可验证的输出"。
不是让它"去查一下",而是让它拿回具体证据:页面上的进度数字、明细里的字段名、进程监听的端口号。没有可验证输出的排查,最后只能靠猜。
2. 先确认现象,再找原因。
很多人一上来就猜原因,结果追了一个不存在的问题。花 30 秒确认"这个现象是真的、可复现的",能省掉后面大量无用功。
3. "查不到"和"做不到"也是有效结论。
客户端没有调试端口——这个否定结论,直接终止了一个会持续消耗注意力的方向。明确知道某条路不通,比一直模糊地试下去要高效得多。
八、写在最后
这次排查的起点,只是"进度条为什么不动"这样一个很小的疑问。但顺着它往下挖,最后摸清的是一整套机制的运行口径,顺带划清了自动化能力的边界。
我觉得这恰恰是这类工具最容易被低估的用法——大家默认它是"帮你干活的",但其实它同样擅长"帮你搞清楚一件事"。干活有终点,搞清楚一件事带来的认知,是可以一直复用的。
而那个 web_agents 字段,我到现在还记得。一个小小的标记,解释了之前所有的困惑。
本文为个人真实排查记录,涉及的具体机制以产品当前实际规则为准。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号