#WorkBuddy# AI 起的后台进程凭什么"碰巧活着"?我做了一次存活对照实验
原创
#WorkBuddy# AI 起的后台进程凭什么"碰巧活着"?我做了一次存活对照实验
原创
用户12814938
发布于 2026-10-15 06:28:26
发布于 2026-10-15 06:28:26
#WorkBuddy# AI 起的后台进程凭什么"碰巧活着"?我做了一次存活对照实验
场景
我用 AI 助手在电脑上跑批处理,经常需要它起一个"活着干很久"的进程:GUI 工具窗口、采集脚本、监听服务。有一类事故反复出现:AI 在一次命令调用里把进程拉起来了,当场查还活得好好的,等下一次命令再去看——进程没了,跑了半小时的活原地蒸发。更气人的是,有时候它又没消失。同一套写法,有时活有时死,这比每次都死更危险,因为它诱使你把"碰巧活着"当成可靠。
过程
我干脆做了一组对照实验,把话说清楚。
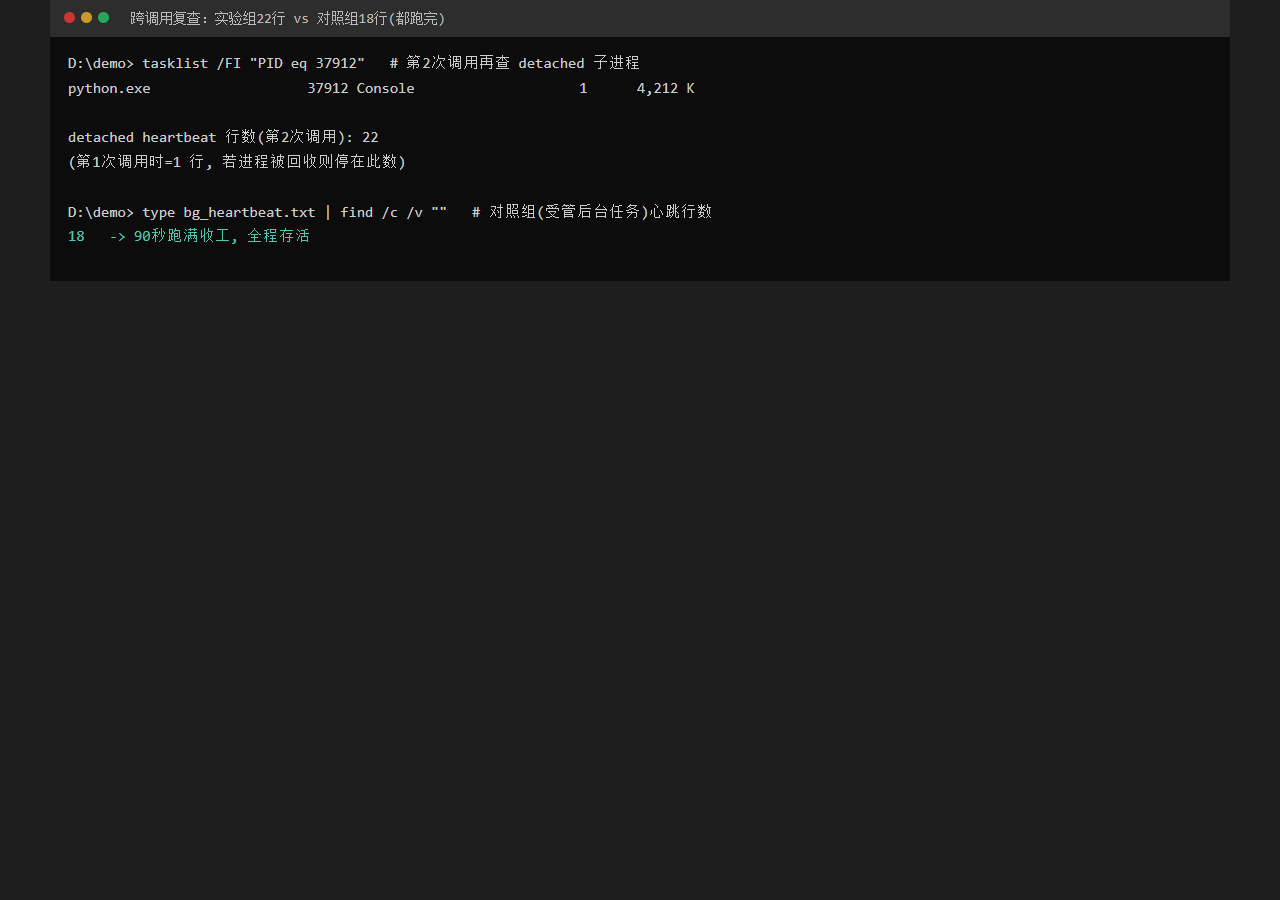
实验组:用脚本派生一个完全分离的子进程,任务很简单——每 5 秒往心跳文件追加一行,写满 24 行收工。在同一命令调用内检查:进程在,心跳已经写了 1 行。一切正常。
对照组:用 AI 工具链的受管后台任务方式跑同一个心跳脚本(每 5 秒一行,共 90 秒)。
然后是关键一步:跨过命令调用的边界,等下一次调用再回来查。
坑:实验结果跟"想当然"反着来
实测结果是——实验组的分离子进程这次活过了调用边界,回来查时心跳已经写到 22 行,进程自然跑完;对照组后台任务也正常跑满 18 行收工。也就是说,在我这次实验的环境里,两种方式都活着。
但这恰恰坐实了我的怀疑:前几次 GUI 窗口"跨调用即死"的事故,和这次"跨调用还活"的实验,说的是同一件事——宿主环境对调用边界外的进程没有存活承诺。可能回收、可能不回收,取决于宿主的实现版本、启动方式、进程类型,你控制不了,也赌不起。工程上,一个"有时生效有时不生效"的机制,就必须当成"不生效"来设计。
解法:只走有承诺的通道
从此我立了军规,落地成三句话:
- 凡是要跨调用存活的活,必须走受管后台任务通道。这类通道会给任务发一个可查询的标识,跑完有通知、输出有留档、状态可跟踪——这是宿主明确提供承诺的地方;
- 禁止用"命令结尾加个 &"或者分离式启动来蒙混。这种写法在有些环境里等于裸奔,任务死了连个报错都没有,更别提断点续跑;
- 长任务必须留心跳和落盘。进程把关键结果每完成一条就立刻写盘,就算宿主半夜把进程收走,重启续跑最多丢一条,而不是半小时。
总结
这次实验最大的收获不是"哪种写法能活",而是想通了一个道理:依赖隐性行为的方案,本质上是把可靠性外包给了运气。今天测着活着,明天换个环境就死了,而 you never know 是哪天。
三条军规再压缩一下就是:
- 有承诺的通道才用(后台任务机制);
- 没承诺的写法不用(裸起、分离进程赌运气);
- 心跳+落盘兜底,死了也能续。
附上本次实验的关键代码和检查命令,可直接复制:
:: 心跳脚本核心: 每5秒落盘一行, 进程死了也能看出死于第几拍
python -c "import time;f=open('hb.txt','a');[ (f.write('beat %d\n'%i), f.flush(), time.sleep(5)) for i in range(24)]"

:: 查进程是否还活着
tasklist /FI "PID eq <进程PID>"

:: 跨调用回来复查: 心跳行数停没停 = 进程死活的最直接证据
type hb.txt | find /c /v ""
别让半小时的成果死于一次"应该没事"。进程的命,要交给有承诺的机制保管。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号