pdf有些字显示不出来,先分清字体没嵌入还是扫描图片,5 步定位
原创
pdf有些字显示不出来,先分清字体没嵌入还是扫描图片,5 步定位
原创
软领
发布于 2026-10-15 09:34:11
发布于 2026-10-15 09:34:11
打开一份 PDF 时弹出「无法找到或创建字体 'SimSun'。某些字符可能无法正常显示或打印。」,翻到正文,一部分汉字显示成了空白方块,个别页面整页发白、一个字符都看不到。这类文件多数还有救,不必急着重做或送修。
缺字的根源通常只有两种:导出时字体没有嵌入,或者整页本来就是一张扫描图片。前者要靠重新导出、补全字体解决,后者只能重做文字识别,两条路线要走的步骤完全不一样,先分清再动手,能省掉反复换阅读器、重装软件的功夫。
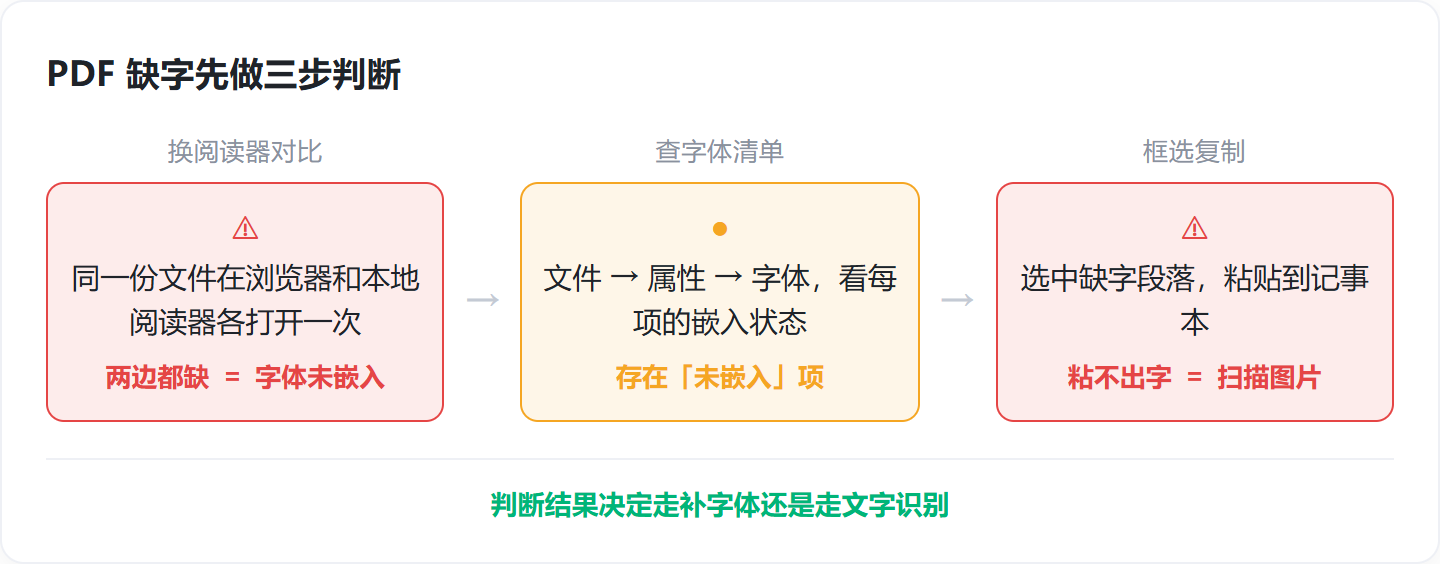
一个快速的判断顺序:在两个不同的阅读器里打开同一份 PDF 做对比,都缺同样的字,说明文件里字体没嵌入,换哪个阅读器都一样;再看字体清单里标着未嵌入的项;最后框选缺字的段落复制到记事本——粘不出字符的,就是扫描图片型文件。
适用系统:Windows 10/11;最后更新:2026-10-14。
先分清缺字属于哪一类
打开时就报「找不到字体」,不一定都要改文件。先看缺的是个别字符还是整页空白,再决定去查字体,还是直接做文字识别。
- 个别字符缺失、位置留着空白方块:文件里有文字层,属于字体问题,走方法一、方法二。
- 整页发白、内容全无:先怀疑那一页是图片渲染失败,走方法三判断,再决定是否做识别。
- 同一处字在 A 阅读器正常、在 B 阅读器缺失:多数是阅读器的字体替换行为,文件本身没问题,换回能正常显示的那个继续用即可。
处理办法
方法一 换浏览器和另一个阅读器对比打开
同一份文件换个打开方式还是缺同样的字,问题就在文件本身,换个阅读器版本也解决不了。
- 把这份 PDF 直接拖进 Edge 或 Chrome 窗口里打开。浏览器用的是自带 PDF 引擎,不依赖本机装了什么字体。
- 再用一个本地阅读器打开同一份文件。两边打开的方式完全不同,对照才有意义。
- 翻到同一页同一处,看缺的是不是同一批字。留意
0和O、1和l这类字形接近的字符,别把它们误判成缺字。 - 两处都缺,说明文件里字体没嵌入,不用再折腾阅读器;只有一处缺,换回能正常显示的那个继续用就行。
- 如果只有某一页整页发白、内容全无,先怀疑那一页是图片渲染失败,跳到方法三再判断。
重装阅读器、换版本、清缓存都解决不了字体缺失,两个阅读器对照一次就能分清问题出在哪:
常见的无效做法 | 对照之后得到的判断 |
|---|---|
重装阅读器、换新版本 | 两个阅读器都缺同一批字 → 文件里字体没嵌入 |
清理本机字体缓存 | 只有浏览器缺字 → 阅读器字体替换行为,文件没问题 |
把文件转成图片再看 | 整页发白 → 该页是图片渲染失败,走方法三 |
方法二 查字体清单里未嵌入的字体
字体清单里标着未嵌入的那几项,就是缺字的直接原因。把字体名记下来,就能让文件来源方重新导出一份。
- 在阅读器里点
文件→属性→字体,打开这份文件的字体清单。 - 逐项看字体名后面的嵌入状态,带「未嵌入」字样的就是嫌疑项。
- 注意子集嵌入:字体名前面带
ABCDEE+这类前缀的,说明只嵌了用到的字符,生僻字、繁体字照样会漏。 - 把未嵌入的字体名逐个记下来,比如
SimSun、Microsoft YaHei,方便让对方重新导出。 - 手机端阅读器一般在
更多→文档信息里看字体,条目名可能写作「字体」或「嵌入字体」。
把本机缺的字体装进
C:\Windows\Fonts能先救急,显示问题当场就没了,但文件发给别人照样缺字,根子还在导出时没嵌入。这一步只适合自己临时查看。
方法三 复制缺字段落判断是不是图片
能复制出文字就是字体渲染问题,一个字符都复制不出来就是扫描图片。这一步决定了后面走方法四还是方法五。
- 用鼠标框选缺字的那一整段,按
Ctrl+C复制。 - 切到记事本,按
Ctrl+V粘贴,看有没有字符出来。 - 能粘出文字,说明文件里有文字层,是字体未嵌入或渲染异常,走方法四。
- 粘不出任何字符,说明整页是扫描图片,文字本来就不存在,直接走方法五。
- 顺手在页面上点一下,看整页是不是一起被选中。图片型文件通常整页只有一个选中框。
框选复制只会分出两个结果:
粘贴结果 | 说明 | 下一步 |
|---|---|---|
粘出文字 | 文件有文字层,只是字体没跟上 | 方法四:补全字体后重新导出 |
粘贴为空 | 这页是图片,文字层根本不存在 | 方法五:重做文字识别 |
方法四 重新导出并嵌入所有字体
最彻底的办法是让制作方导出时勾选嵌入全部字体。拿不到源文件,就用打印为 PDF 另存一份应急。
- 先联系文件来源方,说明缺的是哪几个字体,把字体清单里的名字一起发过去。
- 让对方导出时勾选
嵌入所有字体,或者把文档另存为 PDF/A 格式。PDF/A 强制嵌入全部字体。 - 拿不到源文件时,用打印为 PDF 把当前文件另存一份:在阅读器里按
Ctrl+P打开打印窗口。 - 打印机一栏选
Microsoft Print to PDF,输出位置选桌面或 D 盘,确认后生成新的 PDF。 - 另存后重新打开,对照原来缺字的位置逐处验证,比如第 3 页的表头和页脚、合同里的签名栏。
打印为 PDF 只是按当前画面重新生成一份,原本就是空白的字符依然是空白,复制粘贴也可能失效。能拿到源文件,就别用这一招凑合。
方法五 图片型文件重做文字识别
图片型 PDF 里没有文字层,只能先识别成可编辑文字,再另存一份新的文件。
- 先确认是图片型:全选没有文字框,复制结果为空,页面上点哪里都是整页选中。
- 用带文字识别功能的工具打开这份文件,选择识别当前页或整份文档。
- 识别语言选中文(简体)。中英混排的页面把英文一起勾上,避免字母被认成方块。
- 识别完逐页对照原图,校对方块字、生僻字和数字,尤其是金额、日期、型号这类关键信息。
- 校对完另存为新的 PDF,原始文件留着做备份,方便对不上时重新识别。
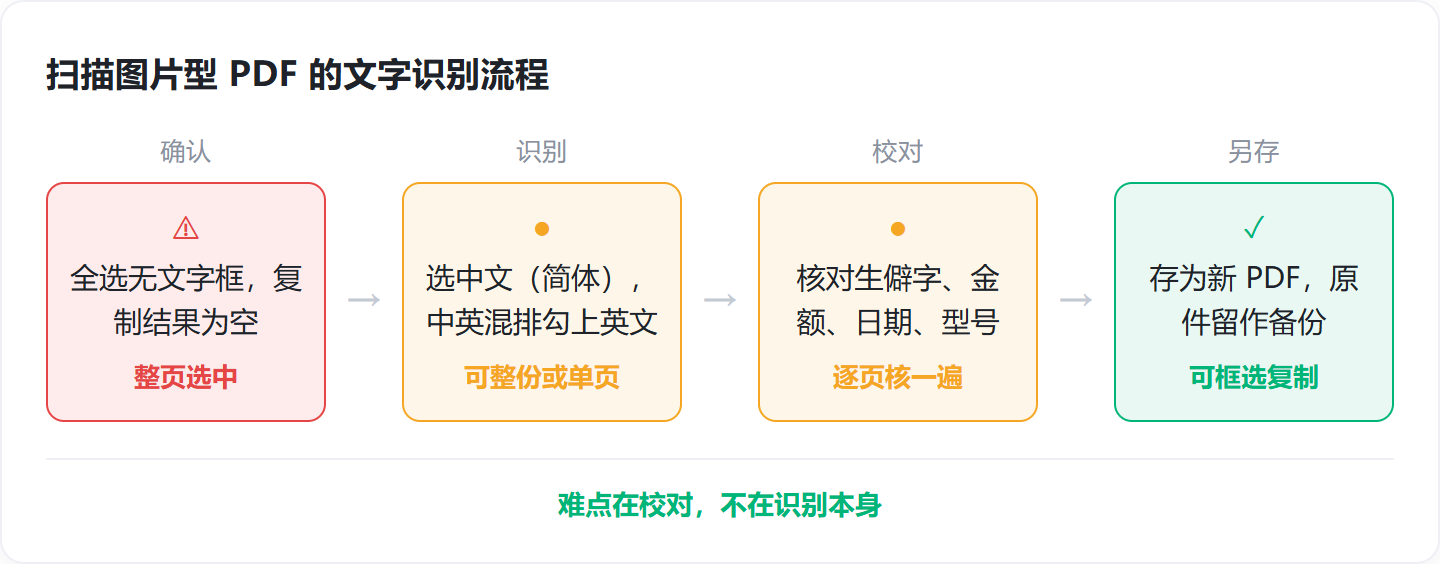
这条路线的关键在校对。识别工具对印刷体正文的准确率不错,遇到手写批注、印章压字、表格线穿插的地方容易出错,逐页核一遍再发出去。
常见问题
pdf 有些字显示不出来是字体没嵌入吗?
多数是。两个阅读器打开同一份文件都缺同样的字,字体清单里又能找到未嵌入项,基本可以确定。只有某一个阅读器缺字,先换阅读器看,别急着改文件。
pdf 在手机上字体显示不出来,电脑上却正常,怎么回事?
手机阅读器自带的字体少,也调不到电脑上的 C:\Windows\Fonts。用子集嵌入、只嵌了一部分字符的文件,手机上就会漏字。把文件在电脑上截图发过去最省事,或者让对方重新导出、嵌入全部字体。
pdf 打印出来有个别字变空白方块,屏幕上却是好的,为什么?
屏幕显示时阅读器会做字体替换,打印机用的是自己那套字体,对不上就打成空白。打印窗口里勾上「作为图像打印」,或者在阅读器里选「打印为图像」,能绕开字体替换。
扫描版 pdf 复制不了文字,能转成可编辑的文字吗?
能。用带文字识别功能的工具跑一遍,识别语言选中文(简体),生成的文字层会叠在图片上,另存为新 PDF 后就能框选复制。识别完生僻字和数字要逐页校对。
pdf 字体未嵌入,怎么让对方重新导出一份能正常显示的?
把字体清单里那些未嵌入的字体名发给对方,让他们导出时勾选「嵌入所有字体」,或者把文档另存为 PDF/A 格式。PDF/A 会强制嵌入全部字体。
哪些情况这套流程覆盖不到
- 受密码保护、禁止复制的 PDF:框选复制这一步做不了,得先拿到打开或编辑权限,再谈字体。
- 字体已嵌入、显示仍然异常:多半是阅读器的渲染问题,先用浏览器自带引擎验证一遍。
- 手写批注、印章压字、表格线穿插的扫描件:文字识别的错误率明显上升,需要人工逐页核对,不适合整批自动处理。
- 只有一两处缺字、文件本身不打算再编辑:直接按方法一换回能正常显示的阅读器就行,不必动文件。
最后一条判断很实际:先确认这份文件还要不要再编辑、要不要发出去。只在本地看,换阅读器最快;要发给别人、要打印,就得回到方法四或方法五,把文件本身修好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号