导弹制导控制半实物仿真系统中反射内存网集成实战
原创

一、引言:HIL闭环对确定性通信的刚性需求
导弹制导控制半实物仿真(Hardware-in-the-Loop,HIL)的核心目标,是在地面把弹机、舵机、导引头这些真实硬件接入闭环,复现从目标探测、制导律解算到舵面操纵的全回路动态,从而在不打实弹的前提下考核控制律、验证导引头与弹体的匹配性。与纯数字仿真不同,HIL回路里既有运行制导控制软件的弹载计算机,也有三轴转台、舵机负载模拟器、射频/红外目标模拟器这些强机电设备,它们分布在不同机柜、由不同实时操作系统驱动,彼此之间必须在每一个控制拍点上交换同一时刻的状态数据。
这种交换的难点不在带宽,而在确定性。一个典型的滚转/俯仰/偏航三通道制导回路控制周期在1kHz量级(1ms),导引头数据更新率常为500Hz~1kHz,舵机指令刷新要求与弹载计算机严格同步。如果用普通以太网做这件事,TCP/IP协议栈的排队、重传、操作系统调度抖动会把端到端延迟拉到毫秒级且不可预测,闭环相位裕度被吃掉,弹体甚至会出现发散振荡。反射内存网(Reflective Memory,RM)正是为这种场景而生:它把一块环形/星形串联的高速共享内存暴露给每个节点,某节点写入的数据在数微秒内被硬件广播到所有其他节点的映射内存里,中间没有协议栈、没有操作系统介入,读写等同于访问本地RAM。本文从工程实战角度,剖析反射内存网在某型导弹制导控制HIL系统中的集成要点。
二、导弹制导控制HIL系统的典型组成
一套完整的制导控制HIL系统通常由以下几类节点构成,它们通过反射内存环网互联,如图1所示。
(1)弹载仿真计算机:运行真实弹载制导控制软件(或其裁剪版),是闭环的核心解算节点。其上一般跑VxWorks实时操作系统,硬实时任务按1ms周期中断触发,完成姿态解算、导引头信息滤波、比例导引/最优制导律计算和三通道舵偏指令生成。
(2)三轴飞行转台:模拟导弹在空中的俯仰、偏航、滚转姿态,框架角带宽典型为几赫兹到上百赫兹量级(视被试弹的动压和频段而定),其角位置/角速度反馈通过反射内存回传弹载计算机,形成姿态内回路。转台控制器本身也是一个实时节点。
(3)舵机负载模拟器:在地面给真实(或铁鸟件)舵机施加空气动力铰链力矩负载,接收弹载计算机下发的舵偏指令,驱动舵面偏转,并把舵面实际偏角、作动杆力反馈回网。舵机响应频率通常在十几到几十赫兹,带宽直接决定制导回路中执行环节的相位滞后。
(4)射频/红外成像目标模拟器:根据弹道解算给出的弹目相对位置,在暗室里生成与弹载导引头视线角、距离、多普勒匹配的目标信号(射频暗室多轴转台+天线阵列,红外场景投射器),导引头看到“假目标”后输出视线角/角速率给弹载机。
(5)主控操作台与时间同步节点:负责任务想定装订、仿真启动/暂停/急停、数据记录与监控,通常跑在Windows或Linux工控机上,经反射内存网以较低周期(如10Hz~100Hz)参与数据交换,并向全网广播硬时钟同步脉冲。
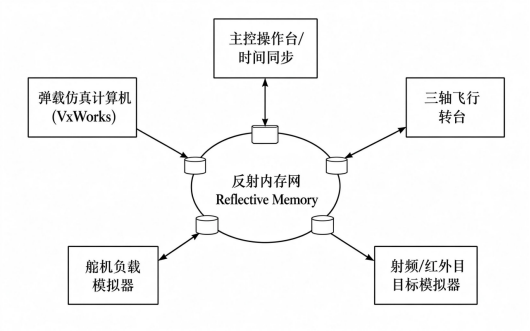
图1 导弹制导控制HIL系统组成与反射内存网拓扑
三、反射内存网承担的数据分发角色
在HIL系统里,反射内存网不是一根“网线”,而是全网节点共同维护的一块逻辑共享内存。每个节点上插一块反射内存卡(常见为PMC/PCI/PCIE形态,光纤或电口环接,典型速率2.125Gbps~5Gbps),卡上的一段地址被映射到本机内存。当节点A向自己映射区的某个偏移写入一个浮点数,RM卡的硬件逻辑会在环上广播该写事务,其余节点的RM卡在地址相同的位置直接更新本地RAM,全程延迟以微秒计、且抖动极小(典型传输延迟3~5μs/节点,全网广播一次在10μs量级)。
这种“写即广播、读即本地”的模型,把跨节点通信简化成了共享变量。工程上我们约定:每个节点只写自己拥有的数据区,只读别人发布的数据区;不允许两个节点写同一地址,从机制上避免冲突。数据分发完全由硬件完成,主机CPU只做一次本地内存写,不参与逐包封装、不触发中断(除非配置),这正是它能挤进1ms周期的根本原因。
四、关键数据流向:一条制导回路的完整闭环
以比例导引制导段为例,数据在环网上的走向为:目标模拟器根据当前弹目几何解算出目标视线角q、视线角速率qdot和距离R,按1kHz写入共享内存;弹载仿真计算机在每个1ms拍点读取这些量,结合惯组(IMU)送来的姿态角和过载,完成制导指令(法向过载指令)与三通道(俯仰/偏航/滚转)控制律解算,输出舵偏指令δz、δy、δx写回环网;舵机负载模拟器节点读到δ后驱动真实舵机,舵面实际偏角δ_act和铰链力矩经A/D采集后回写;与此同时三轴转台节点按弹体动力学积分得到的欧拉角和角速度驱动框架转动,再把真实框架角反馈给弹载机,闭合姿态内回路。图2给出了这条数据链路的流向与各段频率。
需要强调的是,导引头数据、舵偏指令走1kHz是硬要求,而转台姿态反馈可以按500Hz(隔拍更新)安排,主控监控走10Hz~100Hz。不同周期的数据在同一块共享内存里靠地址分区和数据有效标志位区分,而不是靠不同网络,这就是反射内存网“一网多速”的典型用法。
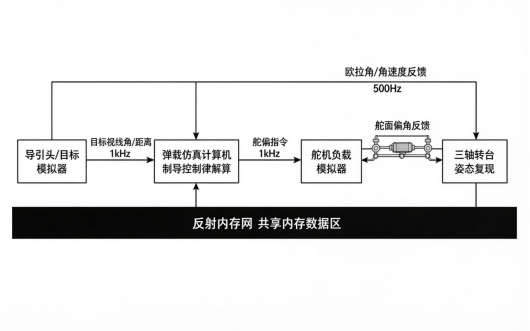
图2 制导控制回路反射内存网数据流向
五、1ms控制周期下的时间分配与延迟预算
控制周期一旦定为1ms(1000Hz),就要把这1毫秒像切蛋糕一样分给各个环节,且必须给最坏情况留出余量。我们在某项目中按表1做了延迟预算,时间轴见图3。
预算的核心思想是:环网传输本身只占极小份额(<20μs),大头留给弹载计算机的控制律解算和机电环节的物理响应;所有环节之和必须小于1ms,并预留10%~15%的抖动余量。工程上要用反射内存卡的硬件周期中断(或外部IRIG-B/PPS同步)把各节点的1ms时钟对齐,否则各节点各自计时会产生拍点漂移,累积起来等于人为引入相位滞后。
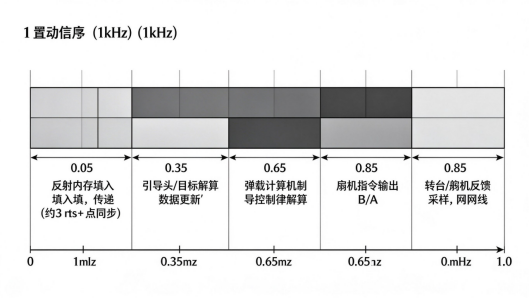
图3 1ms控制周期延迟预算时间轴
表1 1ms(1kHz)制导控制周期延迟预算表(典型值)
环节 | 耗时预算 | 说明 |
|---|---|---|
环网写传播+节点同步 | ≤20 μs | RM卡硬件广播,3~5μs/节点 |
导引头/目标模拟器数据更新 | 250~300 μs | 场景解算+A/D写入 |
弹载计算机制导控制律解算 | 250~300 μs | 含滤波、制导律、三通道控制分配 |
舵机指令输出与D/A | 100~150 μs | 数字量转模拟驱动舵机阀 |
舵机/转台响应与反馈采样 | 150~200 μs | 机电物理响应+A/D回采+网写入 |
抖动与余量 | 约100 μs | 约占周期10%,吸收调度抖动 |
合计 | ≤1000 μs | 一个完整1ms闭环周期 |
六、地址空间规划:按功能分区的实战做法
反射内存卡通常提供若干MB(常用128MB/256MB)共享地址空间。工程上必须一开始就做全局地址规划表,否则节点一多必然撞地址。我们按“节点写区+全局读区”的方式切分,每个发布节点独占一段连续地址,内部再按数据块对齐到64字节边界,便于DMA和缓存一致性处理。表2是一个6节点系统的地址规划实例。
规划时三条经验:一是每个数据块头放一个“块头”结构体,包含块ID、版本号、本周期计数(seq)、数据时间戳、有效标志,接收方靠seq判断是否更新、靠时间戳做同步校验;二是预留若干“保留段”给后期新增节点,避免加节点时整体搬迁;三是控制字(仿真运行/暂停/急停)单独放在最高优先级段,所有节点每个拍点都先读它,保证急停指令在一个周期内全网生效。
表2 反射内存网地址空间分区实例(单节点可见偏移)
地址偏移(Hex) | 大小 | 发布节点 | 内容 |
|---|---|---|---|
0x000000 | 4 KB | 主控操作台 | 全局控制字/时间同步/状态字 |
0x001000 | 8 KB | 目标模拟器 | 视线角q、qdot、距离R、弹目相对速度 |
0x003000 | 8 KB | 导引头/IMU | IMU欧拉角、角速度、过载、导引头输出 |
0x005000 | 8 KB | 弹载计算机 | 舵偏指令δz/δy/δx、制导过载指令 |
0x007000 | 8 KB | 舵机负载模拟器 | 舵面实际偏角、铰链力矩、作动杆力 |
0x009000 | 8 KB | 三轴转台 | 框架角、框架角速度、转台状态 |
0x00B000起 | ≥32 KB | 保留 | 新增节点扩展备用 |
七、与VxWorks实时操作系统的配合
弹载仿真计算机普遍运行VxWorks。反射内存卡在VxWorks下通过板级支持包(BSP)提供的驱动映射到系统虚拟地址,应用程序用mmap或直接访问映射指针即可读写。实战中要把握几点:其一,把控制任务挂在反射内存卡的周期中断(或板上定时中断)上,而不是靠软件延时循环,用中断相位保证拍点确定性;其二,关闭对共享内存段的CPU缓存(或做cache一致性维护),否则写入的数据停在本地cache、对端读到旧值,这是最隐蔽的“数据不更新”根因;其三,中断优先级要合理——RM接收中断、控制律任务、网络记录任务三者优先级拉开,避免日志打印这种非实时操作阻塞控制拍;其四,VxWorks下避免在1ms任务里做printf和文件写,数据记录放到低优先级任务或事后从环网镜像节点读取。
八、实战常见问题与排查方法
问题一:数据不同步,表现为弹载机读到的导引头数据总是“慢一拍”,转台反馈有相位差。根因往往是各节点1ms时钟没有对齐,各自从上电开始计时,拍点相差几百微秒。解决方法:用主控节点广播的硬同步脉冲(PPS/IRIG-B)作为各RM卡中断源,让全网节点在同一相位触发;同时在数据块头携带时间戳和seq计数,接收端若发现seq跳变或时间戳偏差超过半周期,判为失步并报警。
问题二:抖动累积,即长时间仿真后闭环出现慢变相位漂移甚至发散。原因一是调度抖动随时间累积,二是某节点偶发周期超时(如记录任务阻塞了控制任务)。排查时用RM卡自带的周期延迟测量或在每个拍点翻转一个GPIO、用示波器看脉宽分布,量化抖动;把控制任务与非实时任务严格隔离,给关键任务加CPU亲和性和内存锁(VxWorks下用锁内存避免页错误),把最坏周期抖动压到预算内。
问题三:新增节点时的地址冲突。后期加一个GPS/卫星信号模拟节点,若随便挑一段地址写入,极可能与已有节点重叠,表现为偶发数据被覆盖、某个量莫名跳变。解决方法:严格执行第六节的全局地址登记表,新节点从保留段分配,并在上电时先做一次“节点声明握手”——新节点把自己的节点号、基址写入控制区段,主控比对登记表,发现冲突立即拒绝入网;另外在调试期给每个写节点加地址范围校验,越界写入直接报错。
问题四:光纤环某一段脱落导致全网掉线。反射内存多为冗余双环,单点断线一般自动旁路;但调试时若只接了单环,一个节点掉电会造成其后所有节点失联。工程上要求上线前做冗余环切换测试,并在监控节点监测各链路口状态。
九、结语
反射内存网在导弹制导控制HIL中扮演的是“确定性神经总线”的角色:它把分布在不同机柜、跑在不同实时操作系统上的弹载机、转台、舵机、目标模拟器粘合在同一个1ms闭环里。集成的关键不在于把网卡插上,而在于前期把延迟预算、地址分区、同步机制规划清楚,在调试阶段用示波器和计数器把抖动、失步、地址冲突这些隐蔽问题量化暴露出来。一套规划良好、留有余量的反射内存集成方案,能让制导控制律的半实物考核结果可信、可复现,这正是HIL试验价值所在。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号