反射内存网与TSN时间敏感网络技术对比与选型
原创

一、引言:工业实时通信的两条技术路线
在半物理仿真(HIL)、分布式飞行仿真、航天测试与智能制造等系统中,“确定性”已经从一项性能指标演变为系统架构的核心约束。当仿真周期进入毫秒甚至亚毫秒量级,控制算法步长在1ms~10ms之间时,通信网络的端到端延迟与抖动直接决定仿真保真度与控制稳定性。在工业实时通信领域,长期存在两条典型技术路线:一条是以GE/VMIC RFM2G为代表的反射内存网(Reflective Memory,RFM),另一条是基于IEEE 802.1系列的时间敏感网络(TSN)。前者诞生于国防与航天仿真场景,以“纳秒级、确定性、协议极简”著称;后者则是标准以太网向OT领域的演进,以“开放性、生态化、与IT融合”为核心卖点。
对系统架构师而言,选型并非简单的性能排序,而是在延迟、抖动、节点规模、传输距离、成本、可运维性与全生命周期生态之间做出工程权衡。本文从技术本质出发,对二者进行多维度对比,并给出面向典型场景的选型决策矩阵,最后讨论二者混合架构的可行性与未来演进趋势。
二、反射内存网的技术本质
反射内存网的核心思想,是把一段物理上分散在各节点的SRAM内存,通过硬件总线“虚拟”成一块所有节点共享的连续地址空间。每个节点插入一块RFM板卡(PCI/PCIe/VME/cPCI/PXI),板卡上驻留一段双端口内存(DP RAM)。当任一节点向自己板卡的某地址执行一次普通内存写操作时,RFM硬件自动把该数据帧广播到光纤环上的所有其他节点,并写入它们对应的内存偏移。对上层软件而言,读本地内存等价于读全网最新数据,写本地内存等价于全网发布——应用层根本不需要感知协议栈,没有TCP/IP、没有套接字、没有内核拷贝,一次写操作在用户态即可完成。
介质访问采用TDM(Time Division Multiplexing)令牌环:节点按硬件编号顺序获得发送时隙,无冲突、无CSMA/CD退避、无输出队列阻塞。这是其确定性的根本来源。以GE RFM2G(2.12GB/s版本)为例,节点间数据传播延迟典型值为450~500ns(光纤环逐点转发),端到端抖动在10ns量级,远小于任何基于包交换的网络。RFM2G环上节点数理论可达256个,实际工程中常用规模在32~64节点;传输距离由光纤决定,多模约300m,单模可达10km以上;带宽由固定硬件时隙决定,不随流量大小变化,因此不会出现“网络拥塞导致延迟恶化”的问题。
代价同样明显:专用板卡与专用光纤构成封闭生态,单节点板卡成本高;拓扑以环为主,扩展需破环加节点;与标准以太网、Linux/Windows IT栈不能直接互通,必须通过网关做协议转换;不同厂商板卡(GE/Abaco、Astronomy、台湾研华等)驱动与协议互不兼容,存量系统被原厂锁定。这些短板决定了RFM更适合“节点少、延迟预算极紧、设备同处一个试验场地”的硬实时场景。
三、TSN时间敏感网络的技术本质
TSN并非单一协议,而是IEEE 802.1工作组下一组以太网增强标准的集合。其目标是在标准IEEE 802.3以太网上,通过统一的时间基与调度策略,为关键流量提供有界延迟与低抖动传输,同时与非关键尽力而为流量共存。核心子标准包括:802.1AS(时间同步,gPTP协议,端到端同步精度亚微秒级)、802.1Qbv(时间感知整形器TAS,在交换机上为每个端口维护一张“时间门”调度表,关键流量按预定时隙通过)、802.1Qav(信用值整形CBS,为AV类流量预留带宽)、802.1Qci(每流过滤与策略)、802.1CB(帧复制与消除FRER,通过双路径冗余实现无缝故障恢复)、802.1Qcc(用户网络需求配置模型)。
TSN的本质是“把确定性从应用层下沉到交换机硬件调度层”。在Qbv机制下,交换机每个端口在每个时间周期(通常125μs~几ms)内,为不同流量类别打开/关闭发送门。关键时间敏感流量(ST)被安排在专用时隙,即使同端口存在大流量背景BE(尽力而为)数据,也不会在该时隙内冲突。由此,TSN端到端延迟可以被数学证明为有界,工程实测值通常在几十到几百微秒量级(取决于跳数、周期与流量规划),抖动可控制在微秒级,精心设计下部分场景可逼近亚微秒。
TSN最大的优势是开放性与生态:物理介质就是标准以太网(铜缆、光纤、100M/1G/2.5G/5G/10G),节点规模理论上不受限,距离由以太网规范决定(铜缆100m,光纤可达数km至数十km),可与现有IT网络、OPC UA、MQTT、HTTP直接融合。近年来Intel、NXP、TI、Broadcom、瑞萨等芯片厂商已在以太网Switch/PHY中集成Qbv能力,西门子、贝加莱、华为、思科、摩莎等设备商推出TSN交换机,标准生态快速成熟。代价是:亚微秒级抖动仍难以稳定保证;全网统一调度需要精确配置与表项规划;早期TSN设备成本仍偏高;端到端延迟依赖跳数与时隙表设计,对系统工程师的网络规划能力提出更高要求。
四、关键维度对比
图1给出了两种网络在拓扑与机制上的直观对比:左侧RFM为共享内存环,右侧TSN为基于中心交换机的标准以太网。表1则系统地列出了10个关键选型维度的对比结果。
对比维度上,需要指出三个常见误解。其一,“TSN延迟比RFM低”——这是错误的。RFM节点间延迟在亚微秒,TSN即便精心规划也要几十μs起步,延迟差距约两个数量级。其二,“RFM节点数无限”——理论256,但每增加一跳,环上转发延迟线性增加,超过64节点后延迟与可维护性显著恶化。其三,“TSN是实时万能解”——TSN解决的是“有界延迟”,而非“零延迟”;在μs级硬实时场景下,RFM仍是性能上限。
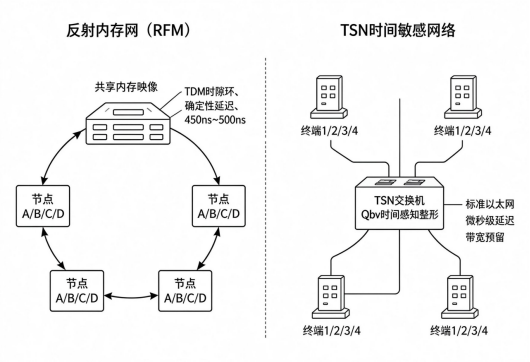
图1 反射内存网与TSN架构左右对比示意图
表1 反射内存网与TSN关键维度对比
对比维度 | 反射内存网(RFM) | TSN(IEEE 802.1) |
|---|---|---|
端到端延迟 | 节点间450~500ns,端到端μs级 | 几十~几百μs(取决于跳数与周期) |
抖动 | 10ns量级,确定性极强 | μs级(精心规划可逼近亚μs) |
最大节点数 | 理论256,工程常用32~64 | 不受限(按以太网规模扩展) |
传输距离 | 多模约300m,单模10km+ | 铜缆100m,光纤数km~数十km |
带宽 | 2.12GB/s(RFM2G),固定时隙 | 100M/1G/2.5G/5G/10G自适应 |
组网灵活性 | 环型为主,扩展需破环 | 星型/树型/线型,任意以太网拓扑 |
成本 | 专用板卡,单节点成本高 | 芯片集成度提升,成本快速下降 |
生态成熟度 | 封闭、厂商私有、几十年验证 | 开放标准,芯片/设备商生态快速成熟 |
故障恢复 | 环冗余,ns~μs级 | 802.1CB FRER,ms级无缝冗余 |
IT系统融合 | 差,必须经网关协议转换 | 好,原生兼容TCP/IP与OPC UA |
协议复杂度 | 极简(内存读写,无协议栈) | 较复杂(gPTP+Qbv+流量规划) |
五、典型应用场景选型分析
导弹/航天HIL硬件在环:这类系统仿真周期通常1ms~5ms,导引头、舵机、弹载计算机与仿真机之间要求硬实时闭环,抖动预算往往被分配到几十微秒以内,且节点数有限(10~30)、设备安装在同一试验大厅内。结论:首选反射内存网。RFM 450ns级节点间延迟为控制算法留出充足余量,TDM环无竞争,工程上经过几十年航天项目验证。TSN在此场景下并非不能用,但需要精心设计Qbv表,且延迟预算余量较小,风险偏高。
分布式飞行仿真(多座舱/多机空战):当仿真节点分散在不同房间、不同建筑甚至不同基地,节点数扩展到数十个,且需要接入视景计算机、仪表系统、指挥显控等大量非实时节点时,纯RFM环网距离与灵活性受限。结论:RFM承担核心飞行解算节点之间的实时骨干,TSN/标准以太网承担视景、HMI、数据记录等外围接入,即后文所述的混合架构。
智能制造(汽车焊装、3C组装、半导体产线):产线节点数动辄上百,PLC、机器人、视觉相机、AGV、MES系统并存,要求与IT网络直连、远程运维、大数据分析。结论:TSN是必然选择。RFM在此类场景成本高、规模难扩展、生态封闭,没有工程性价比;且工业现场对“亚微秒抖动”并无刚需,TSN的μs级有界延迟已足够。
车载以太网(智能驾驶域控):车内ECU数量从几十个到上百个,自动驾驶感知融合对时延有界性要求苛刻,同时要与诊断、OTA、娱乐域共存。结论:TSN(IEEE 802.1 + 100BASE-T1/1000BASE-T1)已经是车载统一网络的事实标准,RFM因成本、体积与功耗不可能上车。
六、选型决策矩阵与流程
综合上述分析,选型应按以下顺序追问。第一,端到端抖动预算是否要求≤1μs?若是,RFM几乎是唯一选择;若否,进入第二问。第二,节点数是否超过80个,或距离跨公里级?若是,TSN/标准以太网在规模与距离上占优;若否,进入第三问。第三,是否要求与IT系统深度融合、远程运维、或接入OPC UA/MES?若是,优选TSN;若否,RFM与TSN均可,按成本与团队熟悉度决策。图2给出了该决策流程的工程化表达,可直接用于项目前期的技术评审。
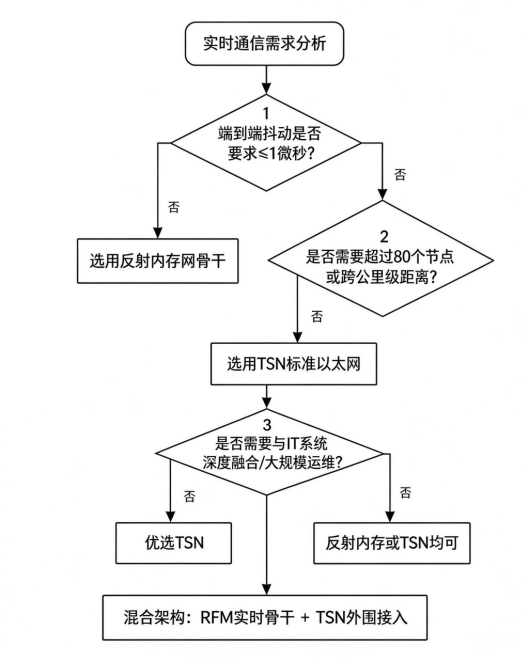
图2 反射内存网与TSN选型决策流程图
七、混合架构:RFM实时骨干+TSN外围接入
对大多数中大型仿真系统,单技术路线往往不够理想。工程上越来越多采用“RFM实时骨干+TSN外围接入”的混合架构,如图3所示:核心仿真计算机、实时I/O、导航解算节点之间通过RFM环网互连,保证纳秒~微秒级硬实时闭环;RFM环上设置一个网关节点,通过协议转换(RFM→TSN/标准以太网)将实时数据发布到TSN交换机,由其连接PLC、传感器、HMI、视景机、数据服务器乃至远程IT系统。
这种架构既保留了RFM在关键闭环上的性能优势,又利用TSN的开放性解决了外围设备接入与IT融合问题。需要注意的是,网关是数据穿越的必经点,所有跨网段的实时数据都会引入μs~ms级的转换延迟,因此架构师必须明确哪些流量必须留在RFM骨干内(如舵机指令、惯导数据)、哪些可以容忍网关延迟(如视景数据、HMI状态、日志上报)。工程实践中,建议通过“共享内存映像与TSN流标签”的一一映射,由网关做周期化批量转发,避免在网关侧引入额外的抖动。
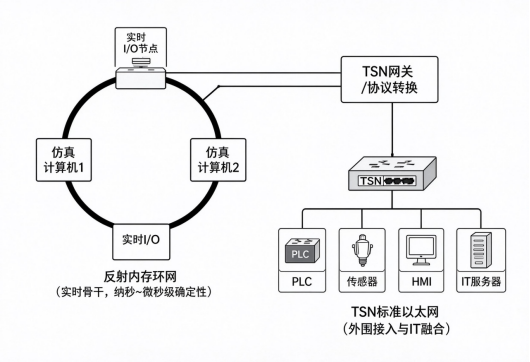
图3 RFM实时骨干+TSN外围接入混合架构示意图
八、未来趋势:TSN能否完全替代反射内存网
从技术路线看,TSN在“有界延迟”维度持续进步(新一代802.1Qbv调度周期已可做到几十μs,802.1CB实现无缝冗余,芯片成本快速下降),在智能制造、车载、楼宇等中大规模OT场景中,对RFM形成明确替代趋势。可以预期,未来3~5年,新建的工业产线与车载系统将基本以TSN为实时网络底座。
但在以下三类场景,RFM在可预见的未来仍不可替代:第一,亚微秒级(<1μs)抖动预算的硬实时闭环,如导弹/高超声速HIL、高精度伺服控制、高能物理数据采集;第二,节点数少(<32)、对协议栈零容忍的密闭弹载/箭载测试环境;第三,既有RFM基础设施的存量改造项目,替换成本与风险远大于收益。
总体判断:未来十年二者将长期共存。TSN成为OT网络的事实底座,RFM在最高性能层级的“硬实时骨干”位置上继续存在,混合架构将成为大型仿真与测试系统的主流形态。架构师不应把二者视为竞品,而应根据系统在确定性层级上的真实需求,分层选用。
九、结语
反射内存网与TSN并非互斥的竞品,而是不同确定性层级上的工具。架构师的任务不是追逐最新标准,而是依据抖动预算、节点规模、传输距离、IT融合需求与全生命周期成本,做出与场景匹配的技术决策。对硬实时闭环,RFM仍是性能上限;对开放互联与规模化,TSN代表未来;二者通过网关融合,则是当下最稳妥的工程折中。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号