星型反射内存交换机设计原理与端口转发机制
原创

1 引言:反射内存为什么需要星型交换
反射内存(Reflective Memory,RFM)是面向硬实时分布式系统的一类共享内存网络。以GE(现Abaco)VMIC-5565系列为代表,它用一条2.12 Gbaud的串行光纤链路,把分散在不同机箱、不同工位上的节点卡上的一段SDRAM映射为全网一致的地址空间:任一节点写入本地内存,网络硬件在极短的、确定的时间内把这份数据复制到所有其他节点的同名地址上,应用层无需关心协议栈、无需操作系统介入。这种“写即广播、读即本地”的模型,使半实物仿真、飞行控制、电力同步采样等场景能够获得亚微秒级的确定性数据交换。
早期反射内存以环型(Ring)组网为主:节点卡首尾相连,光线从节点1进、节点2出,依次串接成一个闭合环。环网结构简单、成本低,但当系统从十几个节点扩展到数十上百个节点,或者对可靠性、布线和单点故障提出要求时,环网的结构性短板就暴露出来。星型反射内存交换机(Managed Hub / Star Coupler)正是为弥补这些短板而设计的:它把“逐节点绕行”改为“中心汇聚、端口直达”,是反射内存网络从实验性环走向工程化组网的关键设备。本文从交换机内部架构出发,剖析其端口转发、时钟同步与故障隔离的工作机理。
2 环网模式的局限
第一,节点数扩展受限。环网中每个节点既是数据源又是中继器,数据帧必须经过每一个节点的收发通道才能绕环一周。节点越多,数据帧途经的串化器/解串器(SerDes)和转发级数越多,累积的转发延迟和抖动随之增大;为维持环的闭合,任意两个相邻节点之间都必须维护一条完整的光纤段,节点规模越大,链路管理越复杂。
第二,单点故障即全网中断。环是一条闭合路径,某一段光纤断开、某个节点卡掉电或某个光模块失锁,都会把环切成两段,闭合环无法闭合,全网反射内存随即失效。在环网中通常需要配置冗余环(redundant ring)来缓解,但这使链路数量和节点成本近乎翻倍,且故障切换仍需要检测与重构时间。
第三,距离与时延随节点位置发散。环网里第一个收到数据的节点与最后一个收到数据的节点之间存在“绕环一周”的时间差,这个差值随节点数线性增大;对要求所有节点近乎同时看到同一帧数据的协同仿真而言,这种位置相关的时延偏差是难以接受的。多模光纤虽然支持约300米、单模支持约10公里的链路距离,但环网把这些段首尾串接后,最远节点的端到端路径会被显著拉长。
星型交换机的价值,就是把上述三个问题从“结构内生”变成“结构可解”:节点不再串接,而是各自用一条独立光纤直连中心交换机;中心设备负责把一帧数据同时、等距地分发到所有相关端口。
3 星型交换机的整体内部架构
一台星型反射内存交换机在物理上通常是19英寸1U机架式设备,前面板为一排可插拔的SFP光收发模块(如Abaco ACC-5595提供8个SFP端口)。从内部逻辑看,它由四个核心子系统构成:多光口收发模块、内部交换矩阵、全局地址映射表,以及广播分发逻辑,并辅以一个中心时钟分发单元。
每个端口对应一个独立的收发通道:SFP光模块完成光—电转换,其后紧跟SerDes完成2.12 Gbaud串行码流的恢复与位对齐,再经过8b/10b或类似编码解码,把串行比特流还原为节点地址、帧类型和载荷。每个端口在内部是“收”“发”两条物理上独立的逻辑通道,这一点与普通以太网交换机的端口概念一致,但反射内存帧非常短(动态包长4到64字节),因此交换机的处理流水线必须以线速、按字节吞吐设计,不能引入缓存排队造成的不确定时延。
交换矩阵(Crossbar)是各端口之间的数据交叉连接枢纽。与存储海量MAC地址表的以太网交换机不同,反射内存交换机的“转发”在本质上是一次受控的复制:一帧从某端口进入后,矩阵并不把它送到唯一目的地,而是根据帧类型决定“复制到哪些端口”。全局地址映射表维护的是“节点地址(Node ID)→ 物理端口”的静态对应关系,表项在链路初始化阶段由各节点上报自己的Node ID后建立。广播分发逻辑则负责把需要全网可见的帧,按表项同时向其余所有端口的发送通道扇出。
图1给出了这种架构的框图:顶部一排SFP端口模块向下汇入交叉开关矩阵,矩阵侧挂全局地址映射表与广播分发逻辑,底部中心时钟单元向各端口分发同步时钟。
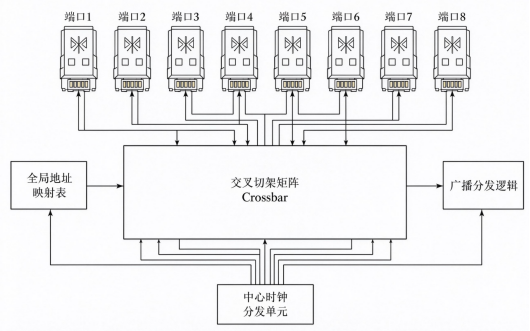
图1 星型反射内存交换机内部架构框图
4 端口转发机制
反射内存交换机的端口转发,介于以太网交换机的“存储转发”与“直通转发”之间,又有自己鲜明的特点。存储转发(Store-and-Forward)要求把整帧收进缓存、校验通过后再转发,优点是能丢弃校验错误帧,缺点是引入整帧延迟;直通转发(Cut-through)在读到目的地址后立即开始转发,延迟低,但会把错误帧也转发出去。由于反射内存帧极短、且链路本身带有CRC/ECC检错,工程上更接近一种“地址即转发、边收边发”的线速流水线:一旦从帧头解析出源/目的节点地址和帧类型,转发决策立刻成立,帧载荷在经过矩阵时被同步复制到目标端口,既不等整帧落地,又不把明显失步或校验错误的帧放行。
数据包过滤是星型交换机区别于“光分路器式无源集线器”的关键能力。无源星型耦合器只是把光信号平均分给所有端口,不做任何判断;而托管式交换机在每个入端口维护一条检查流水线:先判断该帧是否有效同步、是否属于本网;再解析目的Node ID,查全局地址映射表。对于明确发往某一目标节点的数据帧,交换机只把它转发到对应那一个目标端口,而不是无脑扇出到全部端口——这样既节省了其他节点的接收带宽,也避免无关节点被无效中断打扰。只有当帧是广播型(写共享内存、需要全网一致刷新)时,广播分发逻辑才把它复制到除源端口外的所有端口。
图2描述了这一转发流程:光口接收数据帧后,先提取源节点地址与目的节点地址,判断帧类型;广播帧走向“向所有其他端口复制转发”,单播数据帧则查询地址映射表、确认目的端口存在后“仅转发到目标端口”,目的端口不存在时丢弃并计数告警。
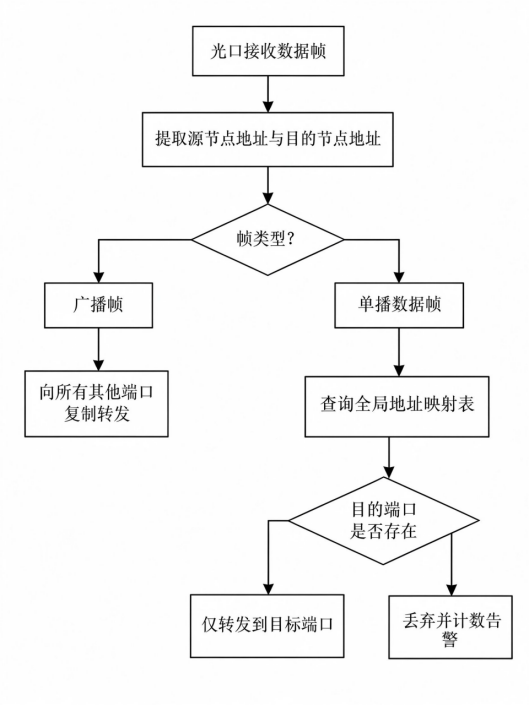
图2 端口转发与帧过滤流程图
5 星型与环网模式的对比
图3把两种拓扑并排画出:左侧环型拓扑中节点首尾串接成闭合环,右侧星型拓扑中所有节点经独立光纤汇聚到中心交换机。二者在延迟、容量、可靠性和布线复杂度上的差异,直接决定了它们适用的工程规模。
在延迟方面,环网中相邻节点间的转发延迟约为数百纳秒(VMIC-5565资料给出节点间约400~500纳秒量级),但这个延迟会沿环累积,最后一个节点看到数据的时间比第一个节点多绕环一周;星型拓扑下所有节点到中心交换机只有一跳,分发时延对全网各端口近乎一致,消除了“绕环一周”的位置相关偏差。在节点容量方面,环网受级数累积延迟约束,而星型交换机通过多机级联可把网络扩展到最多256个节点(ACC-5595类集线器即支持多台级联、全网上限256节点)。在可靠性方面,星型的单端口故障被隔离在本地,在布线方面则把“串行菊花链”改为“星形点对点”,任一条光纤只影响一个节点。
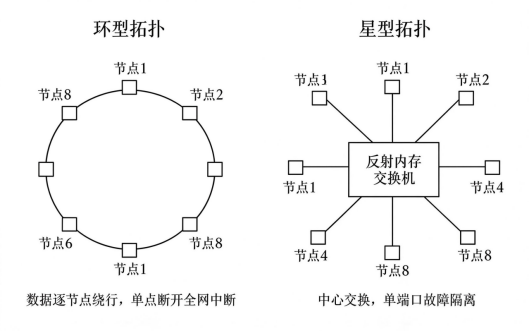
图3 环型拓扑与星型拓扑对比
表1 环型组网与星型组网特性对比
对比维度 | 环型(Ring) | 星型(Star + 交换机) |
|---|---|---|
数据路径 | 逐节点绕行,闭合环 | 中心汇聚,每端口一跳直达 |
端到端延迟 | 随节点数累积,首尾节点时差大 | 各端口近乎等距,确定性高 |
节点容量 | 受转发级数累积延迟约束 | 单机8口,级联可达256节点 |
单点故障 | 一处断开全网中断,常需冗余环 | 单端口故障自动旁路,不影响全网 |
布线 | 相邻节点串接,链路随节点数倍增 | 每节点一条独立光纤到交换机 |
带宽利用率 | 帧被所有节点中继,存在位置浪费 | 按帧类型过滤,单播只送目标端口 |
6 交换机内部时钟同步与相位对齐
反射内存网络对时序极其敏感,因为“所有节点同时看到同一帧”这一特性本身就建立在严格的收发相位关系上。环网时代,时钟是沿环逐级恢复、逐级转发的,节点卡从收到的码流中提取时钟并用于本端发送。引入中心交换机后,网络需要一个更稳定的时序基准:交换机内部设置中心时钟分发单元,由它产生统一的发送参考时钟,并通过各端口内部的时钟树分发到每一个SerDes发送通道。
对接收方向而言,每个端口仍需从本端口收到的串行码流中做时钟数据恢复(CDR),并利用帧中的同步码型(sync pattern)做相位锁定;交换机在内部对各发送通道做相位对齐补偿,使同一帧从不同端口发出时,到达各节点的时间偏差被压缩到设计指标内。工程上需要关注的是:光纤长度不一致会引入路径差,多模300米、单模10公里量级的光纤在光程上的差异,需要在交换机侧通过可配置的延迟补偿(elastic buffer / 相位调整)加以吸收,才能保证全网节点在同一时钟沿上采样到一致的数据。这也是为什么托管式交换机要专门检测“有效同步码型”是否存在——它既是判活依据,也是时钟锁定的依据。
7 故障隔离:单端口旁路与报警
星型交换机在可靠性上的核心设计,是把故障限制在单个端口内。以ACC-5595为例,交换机会持续监测每个端口的两个状态量:光信号是否丢失(loss of signal),以及码流中是否存在有效同步码型(loss of sync pattern)。一旦某端口出现信号丢失或同步码型丢失,判定为对端节点掉电、光纤断开或光模块失效,交换机会自动旁路(bypass)该端口:把它从活动转发列表中摘除,不再向其复制数据,也不让它的异常码流污染矩阵。
这种旁路是可配置的——既可以仅按信号丢失触发,也可以按同步码型丢失触发。被旁路的端口不会拖垮全网,其余节点的反射内存照常工作,这正是星型相对环网“一处断、全网瘫”的根本改善。同时,交换机会把事件计数并通过管理口(如前面板指示或监视接口)上报:哪一个端口、何时发生了信号丢失或同步丢失、旁路了多少次,供运维系统定位是某台仿真机掉电、某根光纤弯折还是某个SFP模块老化。对大规模仿真实验室而言,这种“单端口可观测、可隔离、可报警”的能力,比节省几个光模块重要得多。
8 典型产品参数
结合VMIC-5565反射内存家族与配套托管集线器的公开资料,可以归纳出星型交换机的典型参数量级:链路串行速率2.12 Gbaud;动态包长4~64字节;非冗余模式下持续传输率约43 MB/s(单次长字访问)到170 MB/s(64字节猝发);板载SDRAM为128/256 MB;多模光纤段约300米、单模光纤段可达10公里。端口配置上,单机常见为8口(如ACC-5595为8×SFP、19英寸1U机架),更大规模系统通过机箱扩展或多机堆叠形成16口、32口配置,并最终通过集线器级联把全网节点扩展到最多256个。需要强调的是,具体每节点可用带宽、缓存深度与延迟指标应以所选厂商数据手册为准,上述数值为5565家族公开规格给出的量级。
表2 星型反射内存交换机典型参数(5565家族量级)
参数项 | 典型取值 | 说明 |
|---|---|---|
串行链路速率 | 2.12 Gbaud | 每端口独立光纤通道 |
动态包长 | 4~64 字节 | 按访问粒度动态调整 |
持续传输率 | 约43~170 MB/s | 随包长与猝发模式变化 |
节点间延迟 | 约400~500 ns量级 | 环网相邻节点;星型为一跳等距分发 |
端口配置 | 8口单机;16/32口机箱或堆叠 | ACC-5595为8×SFP、1U机架 |
最大节点数 | 256 | 多台集线器级联后全网上限 |
光纤距离 | 多模约300 m / 单模约10 km | 取决于光模块类型 |
板载内存 | 128 / 256 MB SDRAM | 节点卡侧反射内存容量 |
9 工程应用:大型仿真实验室的星型组网
以一个半实物仿真实验室为例:系统包含操作员座舱、运动平台、舵面加载、实时动力学解算机、视景计算机等二十余个节点,分散在不同机柜甚至不同房间。若沿用环网,任意一台解算机掉电都会中断整个仿真试验,排障时还得顺着菊花链逐段排查;改用星型交换机后,每台节点机用一条独立多模光纤接入机房中心的托管交换机,交换机再用单模光纤跨房间连接远端工位。
这样带来三个直接工程收益:其一,某台操作员座舱机调试重启时,交换机自动旁路其端口,其余节点的实时解算不被打断;其二,新增一个仿真子系统只需在空余SFP端口插入一条光纤并分配Node ID,不必改动既有环的闭合关系;其三,所有节点在近乎相同的时延下刷新共享内存,视景、运动平台与动力学解算之间的数据相位一致性更好,有利于提高仿真逼真度。当节点规模超过单机端口数时,再用第二台、第三台交换机级联,平滑扩展到数十乃至上百节点。
综上,星型反射内存交换机并非简单地“把环拉直”,而是在内部用交叉矩阵、全局地址映射表、线速帧过滤、中心时钟分发与单端口自动旁路,系统性地解决了环网在节点扩展、单点故障、位置相关时延和布线运维上的结构性问题。对从事反射内存组网的系统工程师而言,理解其内部转发与时钟机理,是合理选型、正确配置故障旁路策略、以及在FPGA侧设计兼容节点卡的前提。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号