Docker 自建 108 个开发者工具的在线工具箱:架构设计、实现细节与踩坑记录
原创
Docker 自建 108 个开发者工具的在线工具箱:架构设计、实现细节与踩坑记录
原创
用户11922017
发布于 2026-10-15 17:11:25
发布于 2026-10-15 17:11:25
背景与动机
日常开发中有一类高频但琐碎的需求:格式化一段 JSON、解析一个 JWT、把 PDF 转成 Word、给图片去水印、生成一批条形码、批量识别图片里的文字。
这类需求的特点是——单个需求很简单,但散落在十几个不同的在线站点里。更麻烦的是三个现实问题:
- 隐私:把公司合同、身份证、内部日志贴到别人的网站上处理,本身就是风险;
- 可用性:常用工具站经常挂广告、限流、甚至某天直接 404;
- 不可扩展:想加一个「按我们业务定制的面单模板」或者「走内部大模型 API 的 AI 润色」,没有任何工具站能满足。
于是我用 Vue 3 + Vite 做前端、Docker + Nginx 做交付,自建了一套内部工具集,目前累计 108 个工具、11 个分类。这篇文章记录它的架构、几个有技术含量的实现,以及过程中真实踩过的坑。
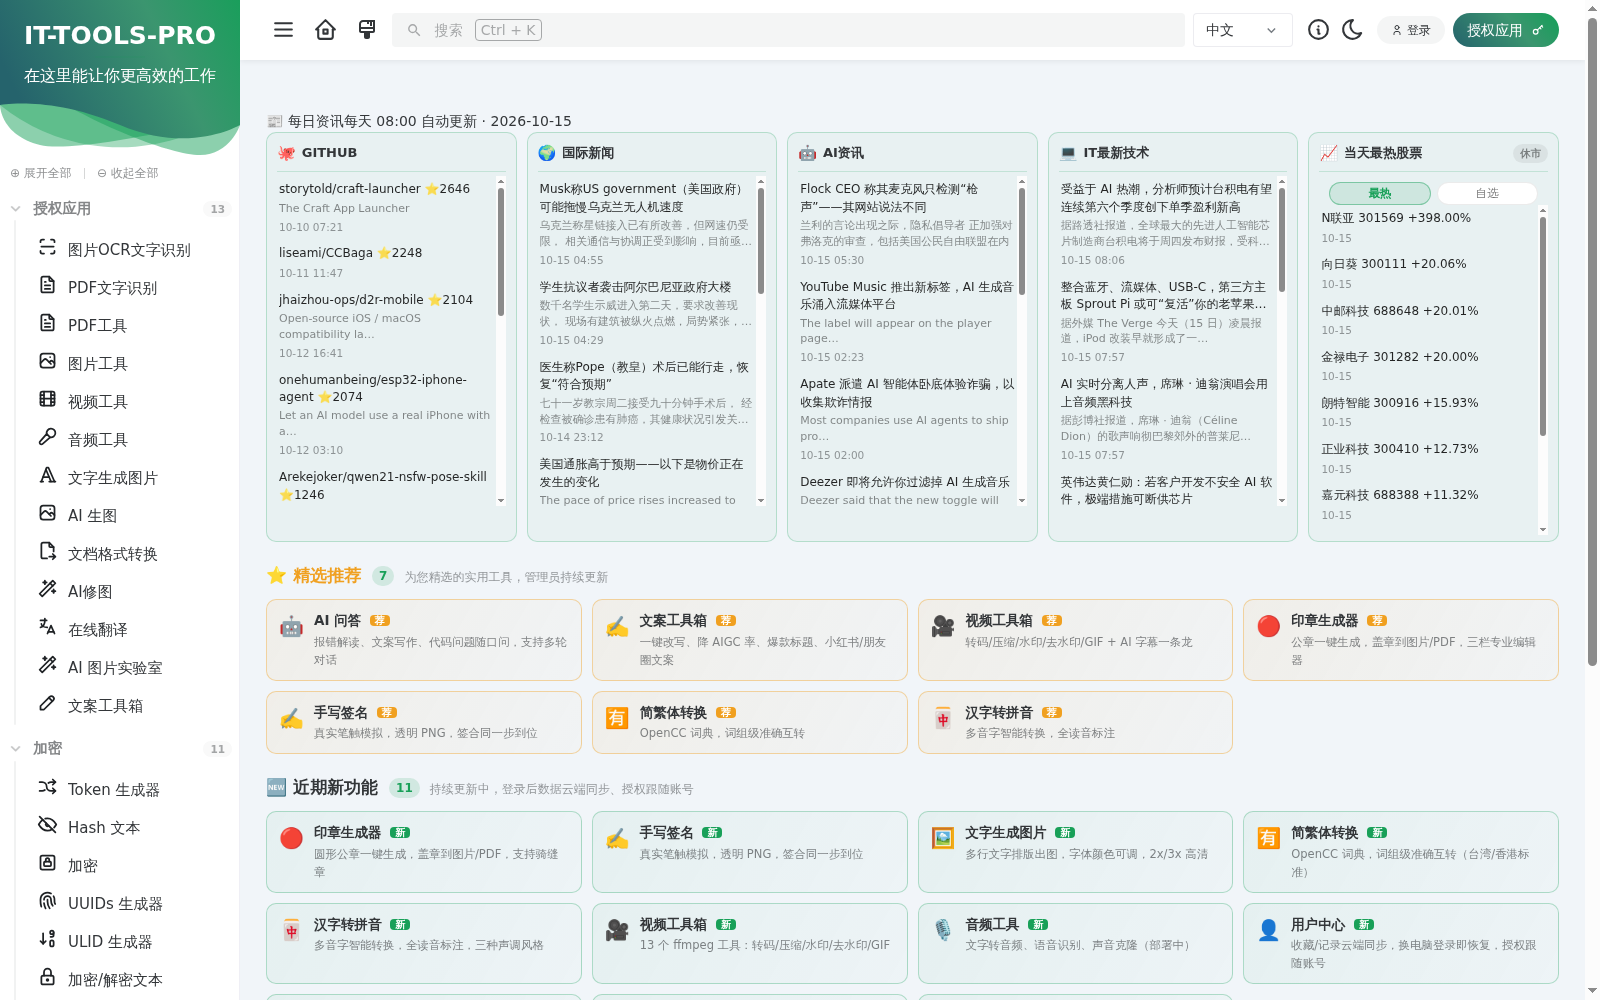
首页
一、整体架构
架构刻意做得简单,因为目标是「一台内网机器上跑起来,外网能访问」:
┌──────────────┐     ┌──────────────────┐     ┌─────────────────┐
│  浏览器       │────▶│ it-tools (8090)  │────▶│ relay (8091)    │
│              │     │ Vue3 + Nginx     │     │ FastAPI 授权+AI │
└──────────────┘     └──────────────────┘     └────────┬────────┘
                                                       │
                        ┌──────────────────────────────┼──────────────┐
                        ▼                              ▼              ▼
                  ┌───────────┐              ┌──────────────┐  ┌───────────┐
                  │ OCR 服务   │              │ NewAPI 网关   │  │ 授权中心   │
                  │ rapidocr  │              │ (LLM 代理)    │  │ CardAuth  │
                  └───────────┘              └──────────────┘  └───────────┘
关键设计决策:能放前端的绝不放服务端。
工具分两类:
类型 | 举例 | 实现位置 | 是否计费 |
|---|---|---|---|
纯计算型 | Base64 编解码、JSON 格式化、UUID 生成、哈希计算 | 浏览器内完成 | 免费 |
服务端算力型 | PDF OCR、图片 OCR、文档转换、AI 修图、文生图 | relay + 后端服务 | 需授权/试用 |
这条边界很重要——它让 108 个工具里的 95 个零服务端成本、零延迟,只有 13 个真正消耗算力的功能才纳入授权体系。
部署就一行命令:
docker run -d --name it-tools \
  --restart always \
  --network ittools-net \
  --add-host=host.docker.internal:host-gateway \
  -p 8090:80 \
  it-tools:custom
--add-host=host.docker.internal:host-gateway 是关键:容器内的 relay 需要访问宿主机上的 OCR 服务和 LLM 网关,用这个参数才能让容器通过 host.docker.internal 回连宿主机。
二、功能覆盖
按分类统计(数字来自运行中的实例):
分类 | 工具数 | 代表工具 |
|---|---|---|
转换器 | 20 | Base64 文件转换、YAML/JSON/TOML 互转、罗马数字、Color 选择器 |
Web | 16 | JWT 解析、OTP 生成器、URL 解析、HTML 实体转义、User-Agent 解析 |
开发 | 14 | JSON 美化/压缩、SQL 格式化、Crontab 生成、Docker Run → compose |
加密 | 11 | Hash、HMAC、RSA 密钥对、BIP39、密码强度分析、PDF 签名检查 |
图片和视频 | 10 | 二维码生成、条形码批量生成、印章生成、手写签名、面单设计 |
文本 | 10 | 文本统计、文本比较、简繁转换、汉字转拼音、Emoji 选择器 |
网络 | 6 | IPv4 子网计算、MAC 地址查找、IPv6 ULA 生成 |
数学 / 测量 | 6 | 数学计算、百分比、ETA、温度转换、计时器 |
数据 | 2 | 电话格式化、IBAN 校验 |
授权应用(算力型) | 13 | PDF/图片 OCR、PDF 工具、文档转换、AI 修图、文生图、AI 图片实验室 |
三、几个有技术含量的实现
1. 面单设计:20 套快递版式 + PDF 逆向提取
这是投入产出比最高的一个工具。电商场景下经常需要「改一下面单上的地址/单号重新打印」,而面单 PDF 通常是扁平化的——文字是曲线或图片,直接编辑不可能。
实现思路是逆向提取:上传 PDF 后,用服务端解析出每一页的元素(文字块、条码、二维码、图片),转换成可编辑的画布元素,同时擦除底图上的原始像素,让用户在原位置上重新填写。
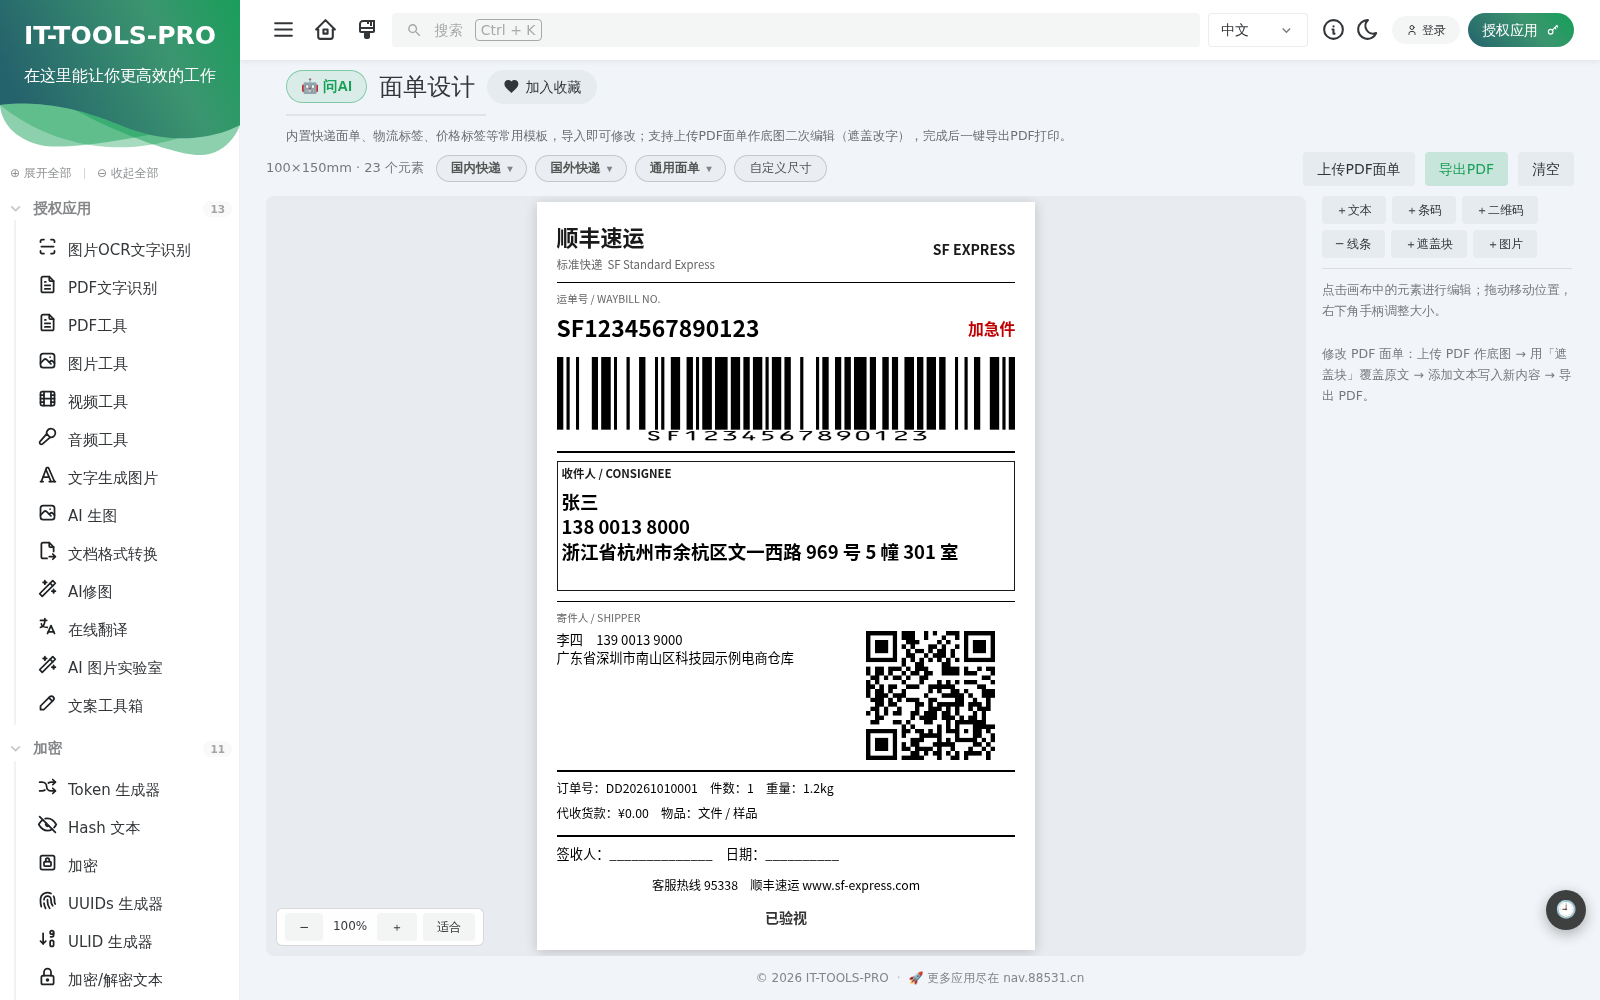
面单设计
同时内置 20 套快递面单模板,按 国内快递 / 国外快递 / 通用面单 三组归类。这里有个细节值得说:模板不是「同一版式换品牌名」,而是按各家真实电子面单的规格分别实现的——
- 尺寸差异:韵达二联单是 100×203mm(撕开线切点 152/51),中通/圆通/申通/EMS/极兔是 100×180mm(切点 110/70),顺丰/京东是 100×150mm;
- 结构差异:通达系顶部有「三段码 + 集包地」栏位,顺丰和京东没有;顺丰主条码在上联,通达系在下联;圆通有三段码描边框和 K 码,申通是三栏带竖线分隔,韵达带备注区;
- 专属字段:EMS 用邮件号(EA…CN)加收寄局,国际件有报关区(HS Code / 申报价值 / 原产国)。
全部模板采用白底黑字、不使用头部背景色带——因为面单最终要黑白热敏打印,色带在热敏纸上只会变成一团灰。
2. 条形码与二维码:混合渲染策略
条形码生成看着简单,实际有个坑:Code128 的条码宽度是数据依赖的,不同内容生成的条码密度不一样。如果按固定宽度拉伸,扫描枪读不出来。
处理方式是按元素框宽度反推模块宽度,保证每个窄条的像素宽度 ≥ 2px(低于这个值打印后会糊),高度不足时自动压缩人读字符区。
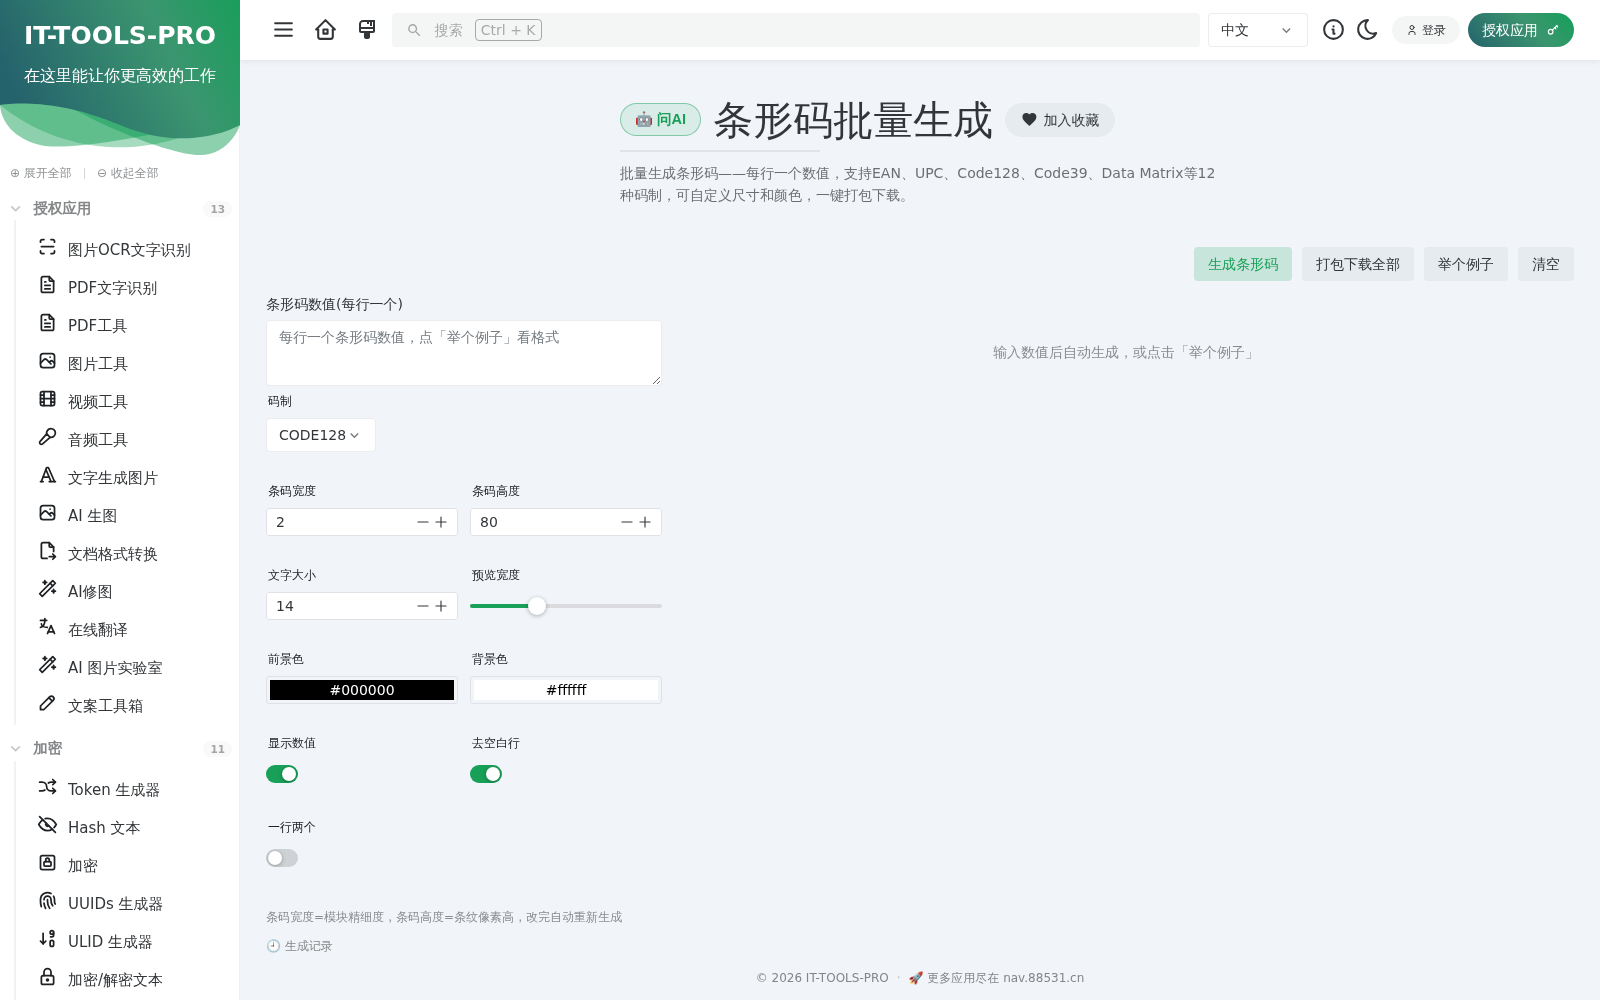
条形码批量生成
3. 试用体系:北京时间自然日重置
13 个算力型功能采用「每日免费试用 + 永久解锁」模式。这里有两个容易做错的点:
第一,日界必须锁定 UTC+8。 服务器可能跑在 UTC,如果直接用 new Date().setHours(0,0,0,0),日界会跟着服务器时区走,用户在晚上 8 点后会发现额度提前重置。正确做法是硬编码偏移:
const DAY_MS = 86400000;
const TZ_OFFSET_MS = 28800000; // UTC+8

function todayStartOf(now = Date.now()): number {
  return Math.floor((now + TZ_OFFSET_MS) / DAY_MS) * DAY_MS - TZ_OFFSET_MS;
}
第二,额度在用户当天首次使用时才起算。 如果按「0 点开始计时」,用户上午 10 点第一次打开工具,会发现 30 分钟的额度只剩 20 分钟。所以起算点是 max(当天0点, 首次使用时刻),前后端必须用同一套算法——否则会出现前端显示还有额度、后端已经拒绝的割裂。
4. AI 能力的接入方式
AI 相关功能(AI 客服、AI 修图、文案改写)不直连模型厂商,而是走自建网关(New API 代理):
浏览器 → relay (8091) → New API 网关 → 模型服务好处是模型可切换、可限额、可观测。AI 客服的提示词限定为「只回答本站功能相关问题」,避免被当成通用聊天机器人消耗额度。
四、踩坑记录
坑 1:Docker 构建时拉基础镜像失败
docker build 拉到 nginx:stable-alpine 时中断(unexpected EOF,400 秒只下了 1MB)。网络经代理不稳定时这是常态。
解决:改用离线构建——以本地已有的镜像作为基础层,只 COPY 构建产物:
FROM it-tools:custom
COPY dist /usr/share/nginx/html
COPY nginx.conf /etc/nginx/conf.d/default.conf
构建时间从 400 秒以上降到 10 秒。代价是必须核对镜像 ID,确认新版本真的生效了,别把旧镜像当新版本交付。
坑 2:嵌套滚动容器导致「回到顶部」按钮永不出现
页面用了嵌套的 n-layout,滚动监听写的是 el.closest('.n-layout-scroll-container')——命中的是外层容器,而外层 scrollHeight === clientHeight(它根本不滚),真正滚动的是内层容器。
解决:绑定所有滚动容器,任一层的 scrollTop > 300 就显示按钮:
const scrollEls = Array.from(document.querySelectorAll('.n-layout-scroll-container'));
scrollEls.forEach(el => el.addEventListener('scroll', onScroll));
坑 3:固定页脚给「刚好一屏」的页面凭空造出滚动条
底部栏改成 position: fixed 后,某些工具页出现了 44px 的滚动条。原因是页面高度恰好是 848px(视口 900px),而工具内部按 window.innerHeight - 12 计算高度得到 888px,加上 padding-bottom: 56px 就超出了视口。
解决:固定页脚改成独立底栏,滚动区高度改为 calc(100% - 44px),工具高度按滚动区底边计算而不是视口:
const bottom = el.closest('.n-layout-scroll-container')
                 .getBoundingClientRect().bottom;
const height = bottom - paddingBottom;
坑 4:删掉授权清单,功能整个坏掉
把某个功能从收费清单里移除时,只改了前端的清单文件——结果该功能整个不可用。原因是服务端对「不在受保护清单里的工具」一律返回 403,而该功能的处理器里还有一道授权检查。
教训:授权逻辑分散在「前端清单 + 服务端清单 + 处理器闸门」三处,改动必须同步。现在这条已经写进了项目的检查清单。
五、效果与总结
上线后有几个观察:
- 纯前端工具占了绝大多数使用场景——这也是当初把 95 个工具做成纯前端的原因,零成本、零延迟、数据不出浏览器;
- 面单设计是使用频率最高的工具,因为电商场景下它是刚需且没有免费替代品;
- 隐私是真实收益——合同、身份证、内部日志再也不用上传到第三方站点。
如果你也想自建一套,建议的顺序是:先把纯前端工具做起来(成本为零)→ 再接入一两个真正有痛点的算力型功能 → 最后才考虑授权体系。反过来做,很容易在基础设施上耗光精力,工具本身却没人用。
开源地址:https://github.com/personal82555/it-tools-pro
工具集基于开源项目 IT-Tools 二次开发,前端 Vue 3 + Vite,后端 FastAPI,Docker 交付。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号