Atera思想碰撞--细胞再分群采用空间亚型还是分子亚型?
原创
Atera思想碰撞--细胞再分群采用空间亚型还是分子亚型?
原创
追风少年i
修改于 2026-10-16 09:28:06
修改于 2026-10-16 09:28:06
作者,Evil Genius
又要被社会毒打了,没个大心脏,都不敢勇闯天涯。
今天我们进行一下思想碰撞,Atera分析亚群,应该是空间亚型还是分子亚型?
方法说起来都很容易,大家实际操作可能需要下一番功夫。
讨论这个问题之前,首先明确一个问题,希望识别的是“基因表达状态不同的细胞亚群”,还是“处于不同空间微环境中的细胞亚群”?
之前在课程培训中,都重点强调了空间分析细胞亚群采用邻域细胞组成差异的方式,学员可以复习一下,但是大家也要注意前提,王凌华教授提出的这个方法背景是用在分析Xenium 5k,CosMx 1k等panel数据上,本身分子特征不够多,所以采用了空间亚型的方法,那么当分子特征足够多,就像Atera,依据基因区分亚型,分析亚型的空间微环境差异,是不是更好呢?
来到这儿,我们再扩展一点,Atera是不是真的单细胞级别的空间数据?科研工作就是要详尽的分析做出判断,这里我提一点,检测的样本厚度为5um/10um,大家要自己判断一下了。
目前来看,空间亚型和分子亚型还不能相互替代
如果目标是利用高分辨率空间转录组数据,深入研究细胞类型、空间邻域(cellular neighborhood)和细胞生态位(cellular niche),最有价值的策略通常不是二选一,而是以基因表达定义细胞状态,以空间邻域刻画细胞所处的微环境,再分析两者之间的关联。
一、两种亚群划分方法的本质区别
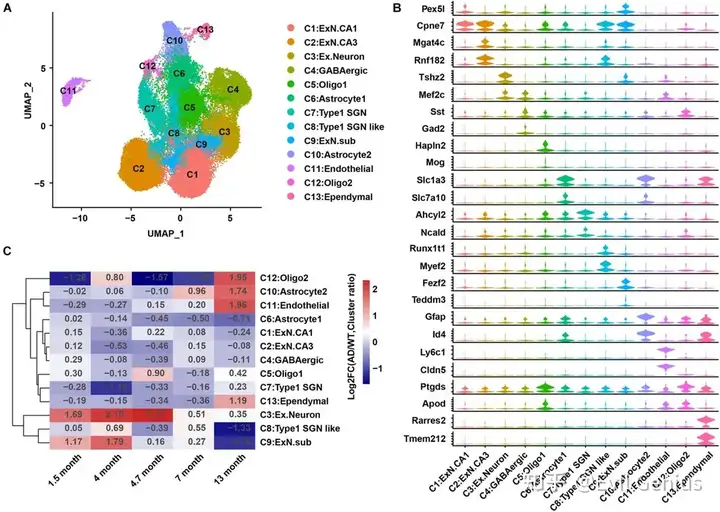
方法 A:基于基因表达差异划分亚群
根据单个细胞自身的转录组表达谱,识别细胞状态和分子特征不同的亚群。
例如:同一类巨噬细胞可以进一步分为炎症反应型、抗原呈递型和组织修复相关状态。
核心问题:这些细胞自身正在表达什么基因、执行什么功能?
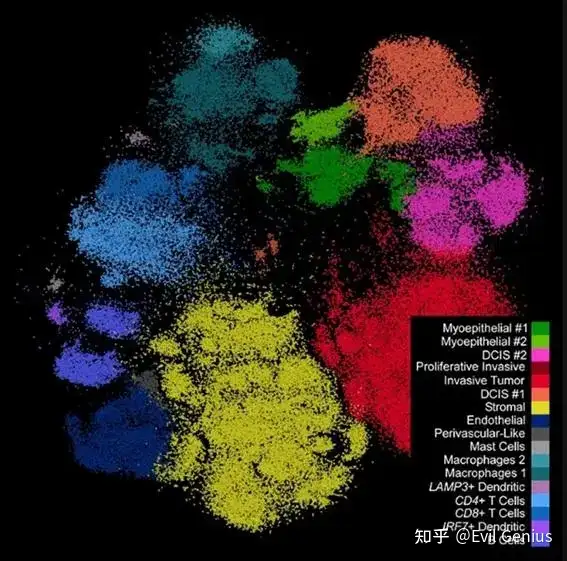
方法 B:基于空间邻近细胞类型划分亚群
根据目标细胞周围有哪些细胞、各类细胞的数量或比例、空间距离等,识别不同的空间微环境。
例如:同样是巨噬细胞,一部分邻近 T 细胞和树突状细胞,另一部分邻近中性粒细胞和血管相关细胞。
核心问题:这些细胞处于什么样的局部细胞生态环境中?
需要注意:第二种方法识别的首先是空间生态位或邻域类别,而不是天然成立的细胞内在亚型。只有当这些邻域与目标细胞的转录状态、功能或行为存在稳定关联时,才有依据进一步讨论其空间相关的细胞状态亚群。
二、两种方法的优劣势对比
比较维度 | 基因表达差异分群 | 空间邻近细胞类型分群 |
|---|---|---|
分群依据 | 目标细胞自身的基因表达矩阵 | 邻近细胞的类型、数量、比例及距离 |
主要发现 | 细胞状态、功能和转录程序 | 空间微环境、细胞生态位和邻域结构 |
生物学解释 | 哪些基因和通路发生改变 | 哪些细胞共同构成局部微环境 |
优点 | 便于寻找 marker、差异基因及富集通路 | 能识别空间组织结构和微环境相关差异 |
局限 | 可能忽略空间位置相同或相近细胞的微环境差异 | 可能把处于不同邻域、但自身表达相似的细胞分开 |
常见风险 | 批次效应、过度聚类、细胞周期等因素干扰 | 邻域半径、细胞密度和细胞注释误差影响结果 |
更适合的目标 | 细胞亚型和功能状态解析 | 空间 niche、细胞邻域和局部组织结构解析 |
空间转录组方法 BANKSY 的研究也说明,细胞自身的转录组与局部邻域信息可以共同用于聚类;通过调节两者的相对权重,可以偏向识别细胞类型,也可以偏向识别组织空间区域。
举一个具体例子:肿瘤中的巨噬细胞
同一种细胞,可以有两种不同的分类结果
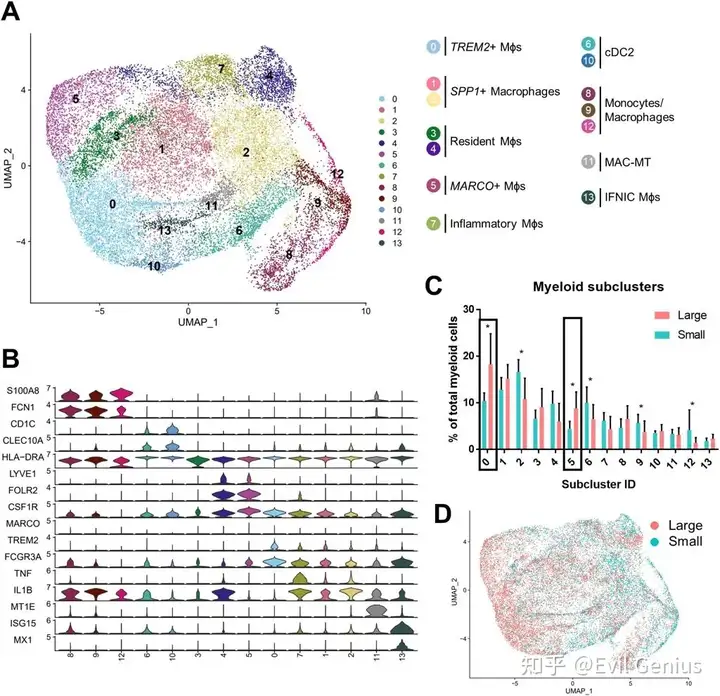
按基因表达分群
- 亚群 1:炎症反应相关
- 亚群 2:抗原呈递相关
- 亚群 3:脂质代谢相关
依据是巨噬细胞自身的表达程序。
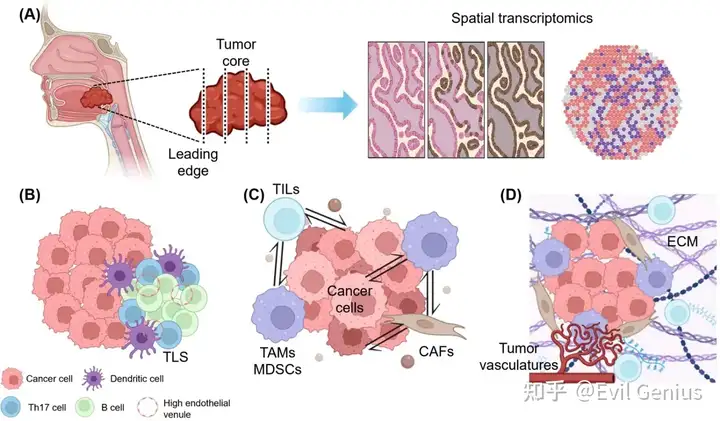
按空间邻域分群
- 邻域 1:巨噬细胞与 T 细胞共定位
- 邻域 2:巨噬细胞与成纤维细胞邻近
- 邻域 3:巨噬细胞与血管相关细胞邻近
依据是巨噬细胞所处的局部细胞组成。
关键点: 邻域 1 中的巨噬细胞不一定就是炎症型,邻域 2 中的巨噬细胞也不一定就是修复型。必须再检查它们自身的基因表达,才能判断空间环境是否与特定细胞状态有关。
三、Atera 本身能做什么?需要区分平台分析与后续分析
Atera 分析流程说明,其二次分析包括 PCA、UMAP、基于图的聚类和差异表达分析;人类样本还可能进行基于 Pan-human Azimuth 的自动细胞类型注释,具体取决于样本和基因面板条件。
但这里有一个重要区别:
- Atera 常规基因表达聚类:根据细胞表达特征形成 cluster,再通过 marker 和差异表达解释。
- 空间邻域分析:需要建立细胞之间的空间邻接关系,计算邻域组成或邻域特征,再进行分类、聚类或统计比较。
- 联合空间分析:将自身基因表达与邻域特征一起用于细胞状态识别。
因此,不能仅凭 Atera 具有空间数据分析功能,就认定其默认输出的所有细胞亚群都是按邻近细胞类型划分的。应当检查具体分析模块、参数及输出矩阵,确认聚类究竟使用了哪些特征。
四、针对 Atera 高分辨率空间数据,更推荐的分析策略
如果研究重点是 Atera在细胞邻域、空间亚群和微环境解析方面的优势,建议采用下面这条路线。
Step 1|细胞类型注释
基于经典 marker、参考图谱及细胞表达特征,确定主要细胞类型
Step 2A|细胞内在状态
对目标细胞单独进行表达降维、聚类、marker 鉴定和通路分析。
Step 2B|空间邻域分析
构建空间邻接图,计算邻域内细胞类型组成、空间距离及局部密度。
Step 3|关联两种分析结果
检验不同邻域中的同类细胞,是否存在稳定的基因表达、功能通路及细胞通讯差异
Step 4|定义空间相关细胞状态与 niche
结合差异表达、通路富集、邻域组成、空间定位和样本间重复性,提出可验证的生物学结论
为什么更推荐联合分析?
- 单纯表达分群的局限:可能无法区分自身表达较为相似、但所处空间环境不同的细胞。
- 单纯邻域分群的局限:可能把不同状态的细胞归入同一类空间环境,也可能把同一转录状态的细胞分散到不同邻域。
- 联合分析的价值:可以回答更深入的问题——空间环境是否与特定细胞状态相关,以及这种关联是否在不同样本中重复出现。
BANKSY 的研究已经展示了联合自身转录组和邻域特征来识别微环境相关细胞状态的可行性。
不过,关联并不等于因果。即使某个巨噬细胞亚群在特定邻域中高表达炎症相关基因,也不能仅凭空间共定位就认定邻近细胞诱导了这种状态。
实际操作时的几个建议
- 不要一开始就让邻域信息主导细胞类型注释。 先用基因表达确定主要细胞身份,再分析其内部状态和空间分布,可以降低邻域差异造成细胞类型误判的风险。
- 把空间邻域与细胞亚型分开命名。 例如,
Macrophage subtype 1应由转录特征支持;T-cell-enriched macrophage niche则表示邻域特征。若二者关联稳定,再定义空间相关的巨噬细胞状态。 - 进行参数敏感性分析。 尝试不同的邻域半径或 k 近邻数量,观察主要结论是否稳定。邻域尺度不同,可能对应不同的生物学问题。
- 统计时以样本为重要重复单位。 不应把同一组织中的数千个细胞直接当成数千个独立生物学重复。比较组间差异时,需要考虑样本、组织区域及细胞密度的影响。
- 补充可解释的验证结果。 展示空间分布图、邻域细胞组成热图、目标细胞的差异表达和通路富集,并检验不同样本中是否重现。这样才能证明分析发现不只是聚类算法的产物。
最后的建议
如果研究重点是常规细胞亚型鉴定,优先采用基因表达分群;如果重点是 Atera 的空间分辨能力,优先研究空间邻域与 niche;如果希望形成更有深度的研究,推荐采用基因表达分群 + 空间邻域分群 + 两者关联验证。
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号