锁等待排查思路:我的实操方法
原创
前几天遇到个问题,我觉得值得写下来分享一下。
做 DBA 的,谁没被业务喊过一句"数据库又卡了"。前两天我们一个订单库,下午高峰期突然就来了这么一出:前端下单开始转圈,开发群里开始刷屏,我这边监控一看,一批会话的状态齐刷刷变成了 waiting。
你要问我这时候第一反应是什么?不是慌,是先把等锁的场景还原出来。往下看,我把这次排查的完整思路和用到的命令都整理出来了,你照着走一遍,下次能少绕很多路。
一、先交代背景
环境不复杂:MySQL 8.0,InnoDB,订单库,读写分离,下午四点正是下单高峰。现象是:一批 UPDATE 订单状态的 SQL 卡住不动,连接数开始往上堆,业务反馈"下单转圈"。
这里先跟不太熟的朋友说一句:数据库里两个事务,一个先锁了一行,另一个想改同一行,就只能排队等。这个"等",就是锁等待。等不到怎么办?默认等 50 秒(innodb_lock_wait_timeout),超了就报 Lock wait timeout exceeded。
所以当时我看到的,就是几十个会话卡在这个"等"上面。
二、第一反应:我以为是慢 SQL
我一开始想的是:高峰期嘛,八成是慢 SQL 拖的。于是我先翻慢查询日志,结果干净得很,一条像样的慢 SQL 都没有。
这里我走了个弯路,大概耗了十来分钟。复盘的时候我特别记了一笔:会话卡住不动,跟 SQL 跑得慢是两码事。卡住是"等",慢是"跑",别拿查慢的思路查等锁。 这个区分,先记在心里,后面能救命。
三、关键一步:直接看谁在等谁
排掉慢 SQL,我开始正经查锁。最快的办法,不是去翻 SHOW ENGINE INNODB STATUS 那坨大文本,是先看等锁链:
-- 谁在等锁、谁在持锁,一条命令直接出
SELECT * FROM sys.innodb_lock_waits\G
这个视图(MySQL 5.7 以上自带,8.0 更全)会把等待关系给你列清楚:waiting_pid 是排队的,blocking_pid 是挡路的。我这一查,几十个 waiting 会话,全都指向同一个 blocking 会话。
有这条链,事情就简单了。顺着 blocking_trx_id 反查一下:
-- blocking_trx_id 从上面 sys.innodb_lock_waits 的结果里拿
SELECT trx_id, trx_state, trx_started,
       TIMESTAMPDIFF(SECOND, trx_started, NOW()) AS trx_seconds,
       trx_mysql_thread_id, trx_query
FROM information_schema.innodb_trx
WHERE trx_id = <blocking_trx_id>;真相出来了:一个事务先 SELECT ... FOR UPDATE 锁住了一行订单,然后去调用一个外部风控接口,接口那边卡着没返回,事务就这么挂着不提交。 它锁的那一行,正好是后面几十个更新都要碰的热点行。于是它一个人不提交,后面排了一长队。
四、处理:找到人,快刀斩乱麻
源头找到了,处理就两句话的事。跟开发确认那个事务能不能回滚,对方点头,我直接:
-- kill 掉挡路的事务,排队的会话立刻往下走
KILL <trx_mysql_thread_id>;
kill 完,堆积的会话几秒内全部放行,下单恢复正常。前前后后,真正用来定位的时间也就几分钟,前面走弯路那十来分钟才是大头。
五、如果重来一次,我会这么排
复盘这件事,我给自己总结了一条顺序,直接照着抄:
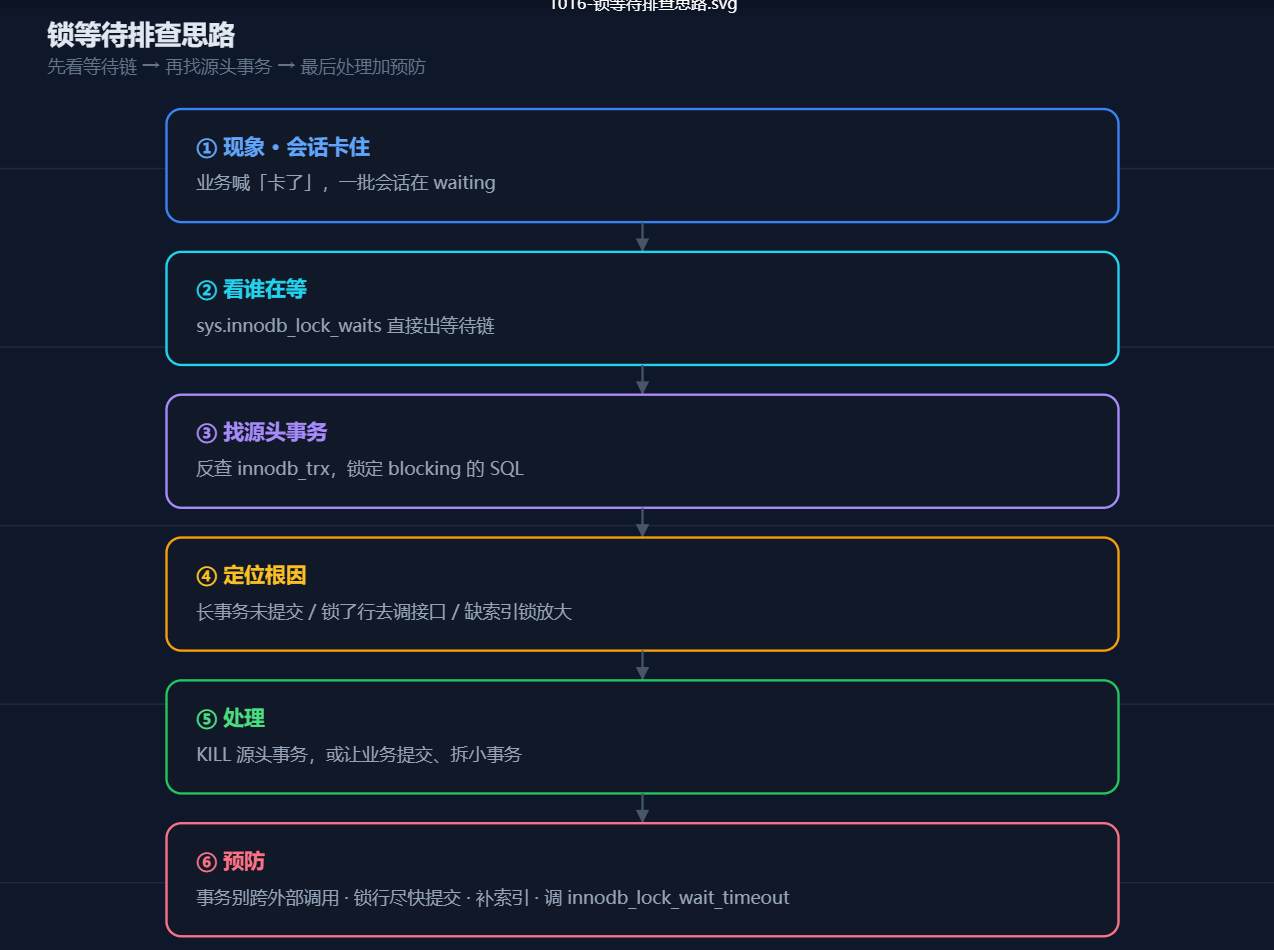
一句话版本:先看等锁链(sys.innodb_lock_waits),再顺着 innodb_trx 找源头,找到就处理,处理完再想预防。
六、顺带说清一个容易混的点:锁等待不是死锁
很多开发,甚至一些刚入行的 DBA,会把锁等待和死锁混着说。这俩不一样。
锁等待是"一个等一个":你锁了行,我排队等,等不到就超时报错。死锁是"两个互相等":你锁 A 等 B,我锁 B 等 A,谁也动不了,MySQL 会自动回滚其中一方,报 Deadlock found。
所以死锁你一般会看到明确的 Deadlock found 报错,锁等待看到的是 Lock wait timeout。查的时候,死锁看 SHOW ENGINE INNODB STATUS 里的 LATEST DETECTED DEADLOCK 段,锁等待看 sys.innodb_lock_waits。别拿错工具。
七、怎么让这种问题少发生
预防比排查更重要,我平时就盯三件事:
- 事务里别跨外部调用。像这次"锁了行去调接口",是最经典的翻车姿势。锁了行就赶紧提交;要调接口、要等人确认,先别占着锁。
- 该加的索引加上。很多锁等待是 SQL 没走索引,一把锁住了大范围的行,甚至是间隙锁,把不相干的更新也堵了。
innodb_lock_wait_timeout别设太大。默认 50 秒看着不长,真要出了问题,几十个会话每个都等 50 秒,连接很快就打满。适当调小,让卡住的快速失败、快速暴露,反而更健康。
最后,吐个槽
那天处理完,开发又私聊我:"小马哥,数据库是不是扛不住了,要不要加机器?"
我回了句:"不用加机器。是你们那个事务锁着行,跑去调了个不返回的接口。"
——好了,今天的复盘就到这。希望你的生产环境用不上这篇,但如果用得上,记得回来点个赞。
我是DBA小马哥,十年一线数据库运维。写的东西都是生产环境里趟出来的,关注我,少踩坑。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号