GraphRAG详解:基于图检索增强生成,打通大模型关联推理,落地复杂知识图谱问答25.6
原创
GraphRAG详解:基于图检索增强生成,打通大模型关联推理,落地复杂知识图谱问答25.6
原创
未闻花名
发布于 2026-10-16 17:03:12
发布于 2026-10-16 17:03:12
一、前言
现在大家做RAG落地时,经常会碰到一类棘手问题:普通向量RAG擅长匹配语义相似的文本,但面对多实体之间层层嵌套的关联问题就容易断片。比如查询某产业链上下游企业关系、人物事件的因果脉络、复杂设备组件依赖,向量检索只能零散召回独立文本,大模型很难自动梳理清楚实体间的逻辑链路,很容易出现事实错乱、推理断层。
GraphRAG就是为解决这个痛点诞生的方案。它不再只把文档切成碎片化文本向量,而是先从原始资料里提取实体、关系、属性,构建知识图谱,检索阶段依托图结构做关联游走,再结合大模型生成答案。简单来说,传统RAG是找相似文字,GraphRAG是理清事物关系再回答。今天我们仔细的拆解GraphRAG核心架构、关键模块以及和普通RAG的差异,了解透GraphRAG底层逻辑,搭建基础的GraphRAG应用,把它接入到大模型业务系统中。
二、GraphRAG基础认知
1. 什么是GraphRAG
GraphRAG全称是Graph Retrieval-Augmented Generation,即图检索增强生成,属于RAG技术的进阶分支,核心是融合知识图谱的结构化关联能力与大模型的自然语言生成能力。
传统向量RAG的流程可以概括为:文档切片→向量化存储→query向量化→相似度召回→上下文拼接→LLM生成。整个过程的缺陷很明显:

- 文本切片是独立的片段,实体之间的关联信息被割裂;
- 向量相似度只衡量语义近似,不理解逻辑、因果、从属这类关系;
- 遇到需要多跳推理的问题,召回的信息零散,模型极易编造错误关联。
GraphRAG在原有RAG链路中新增了知识图谱构建+图检索环节。它先从非结构化文本中抽取实体与关系,形成图数据;用户提问时,不再只做向量匹配,而是解析问题里的实体,在图中遍历关联节点与路径,把结构化关系信息+原始文本片段一起送入大模型,支撑多跳推理。
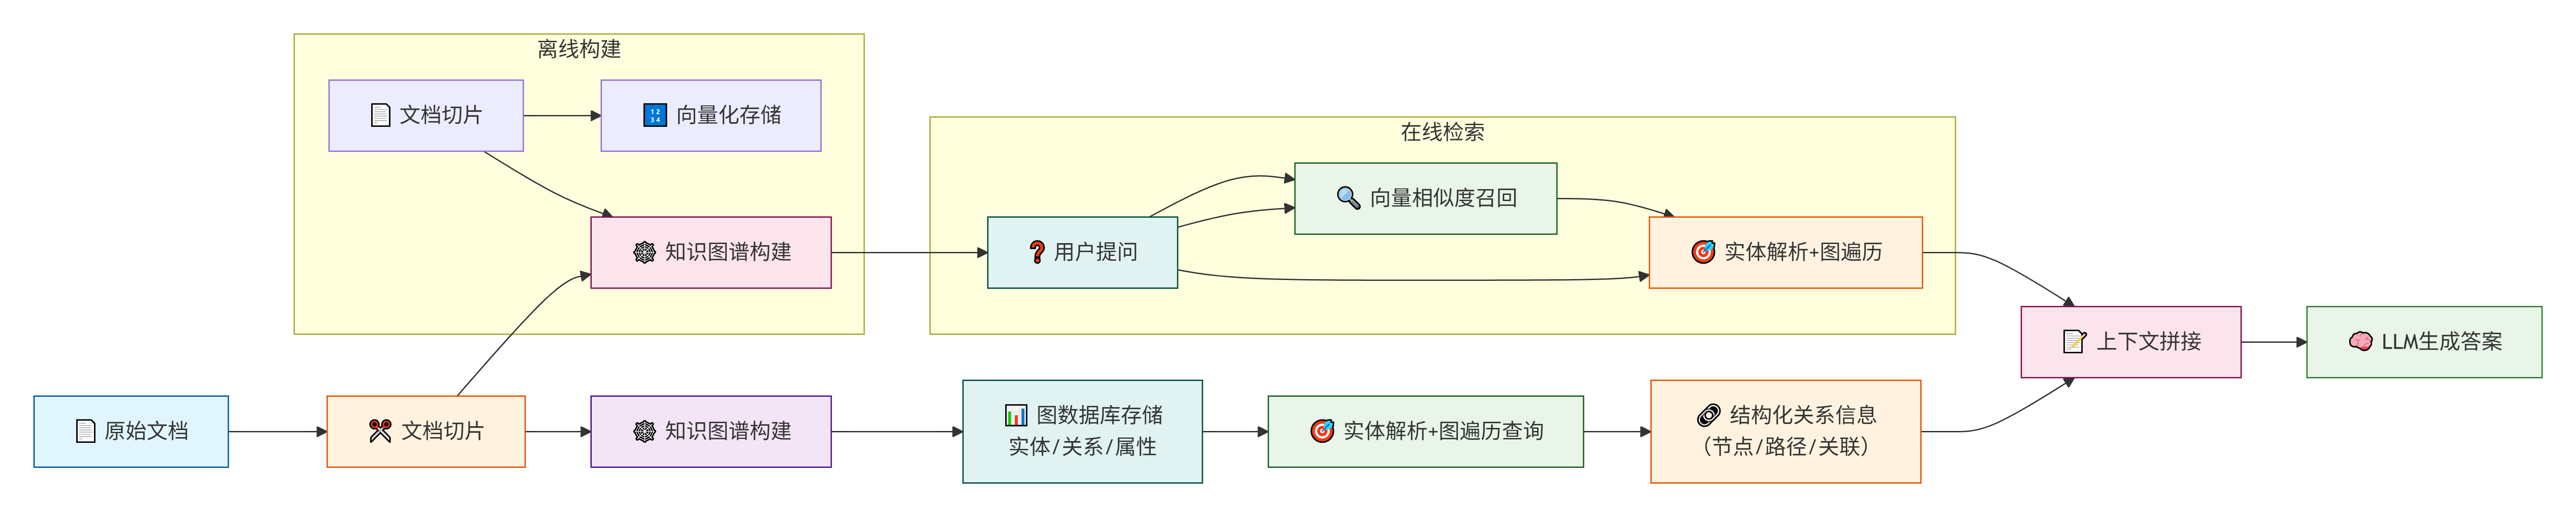
核心步骤说明:
- 1. 文档切片:将原始文档切分为合适的文本块
- 2. 向量化存储:将文本块通过嵌入模型转为向量,存入向量库
- 3. 知识图谱构建:从同一批文档中抽取实体与关系,构建图数据库(结构化知识)
- 4. 向量相似度召回:用户提问时,通过向量相似度匹配,召回相关文本片段
- 5. 实体解析+图遍历:解析问题中的实体,在图数据库中遍历关联节点与路径,获取结构化关系信息
- 6. 上下文拼接:将原始文本片段与图遍历得到的结构化关系信息共同拼接为上下文
- 7. LLM生成:送入大模型,支撑多跳推理,生成最终答案
GraphRAG并不是要完全替代向量RAG,二者更多是互补关系。对于简单的知识点查询,普通向量RAG足够高效;对于复杂关联推理、溯源类场景,GraphRAG优势会被充分放大。
2. GraphRAG核心价值
GraphRAG的核心价值集中在三个方面:
- 支持多跳逻辑推理:能够顺着实体之间的关联路径逐层推导,比如“A的合作方的供应商是谁”这类多层问题;
- 减少事实幻觉:图结构固化了实体与关系的事实约束,限制大模型随意编造不存在的关联;
- 知识可溯源可解释:最终答案对应的实体、关系、原始文档来源可以清晰追溯,方便业务校验。
3. GraphRAG与传统RAG对比
我们可以直观区分二者的适用边界:
- 传统向量RAG:优势是实现简单、构建成本低;适合事实单点查询、文本摘要、通用知识库检索;短板是弱关联推理、多轮问题容易出错。
- GraphRAG:优势是强关系挖掘、多跳推理、结果可解释;适合金融风控、医疗病历、政企档案、工业设备拓扑、人物事件梳理等场景;短板是图谱构建成本更高,实体抽取质量直接决定最终效果。
GraphRAG vs 基础RAG:
步骤 | 基础RAG | GraphRAG |
|---|---|---|
离线处理 | 切片 + 向量化 | 切片 + 向量化 + 知识图谱构建 |
在线召回 | 向量相似度召回 | 向量相似度召回 + 图遍历查询 |
上下文 | 仅文本片段 | 文本片段 + 结构化关系信息 |
推理能力 | 单跳语义匹配 | 多跳关系推理 |
三、GraphRAG整体架构
1. 整体流程总览
一套标准GraphRAG全链路分为两大阶段:离线图谱构建阶段、在线推理问答阶段。
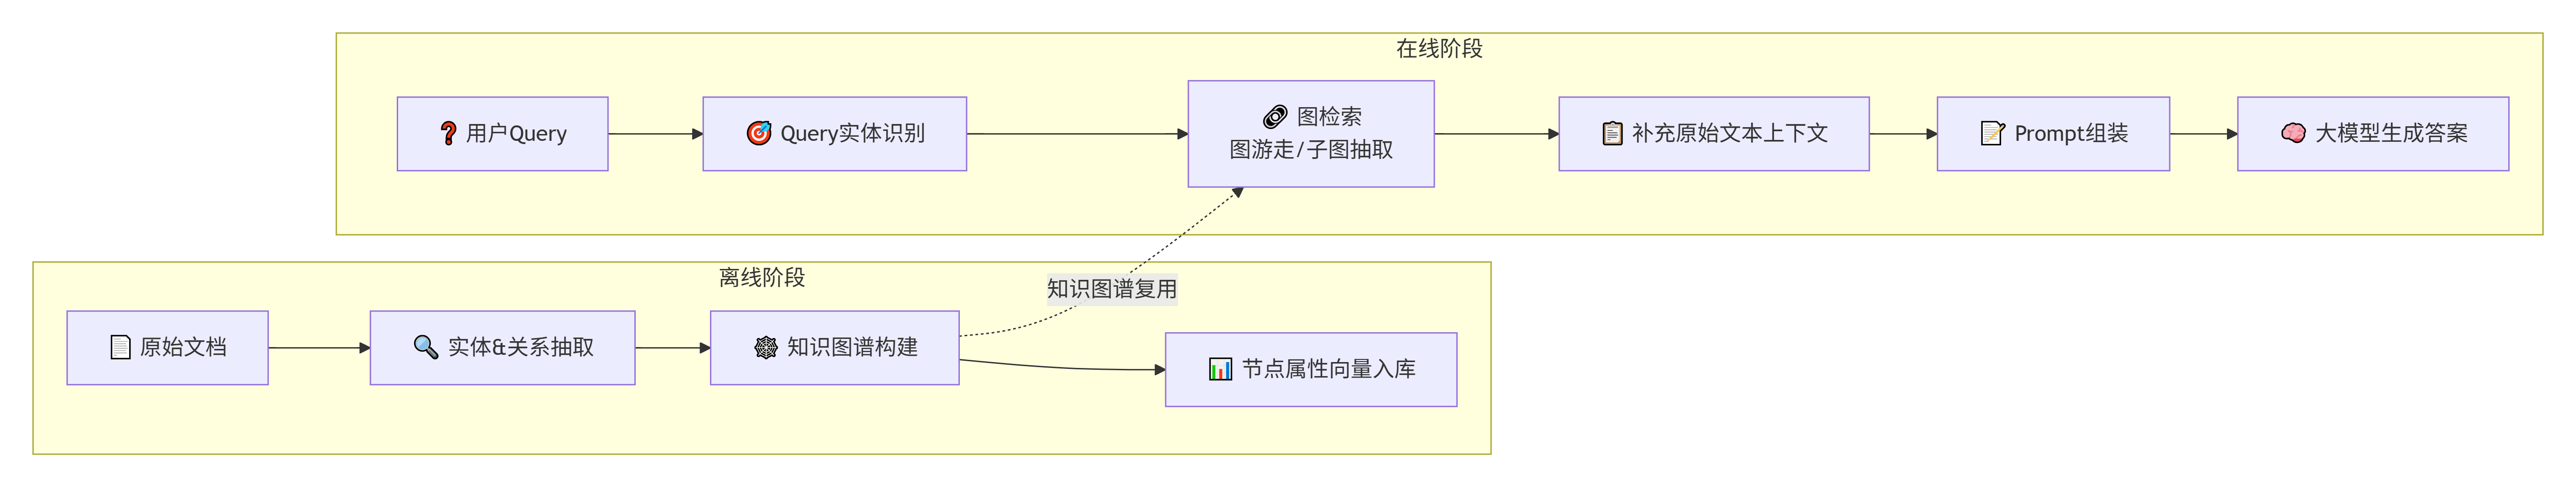
- 1. 离线阶段:原始文档输入→实体&关系抽取→知识图谱构建→节点属性向量入库;
- 2. 在线阶段:用户Query输入→Query实体识别→图检索(图游走/子图抽取)→补充原始文本上下文→Prompt组装→大模型生成答案。
整个链路里,实体关系抽取、图检索策略是决定效果最核心的两个模块,也是工程落地中投入最多精力优化的部分。
2. 离线构建模块
离线模块的目标,就是把杂乱无章的非结构化文档,转化为规范可检索的图数据,包含4个核心步骤:
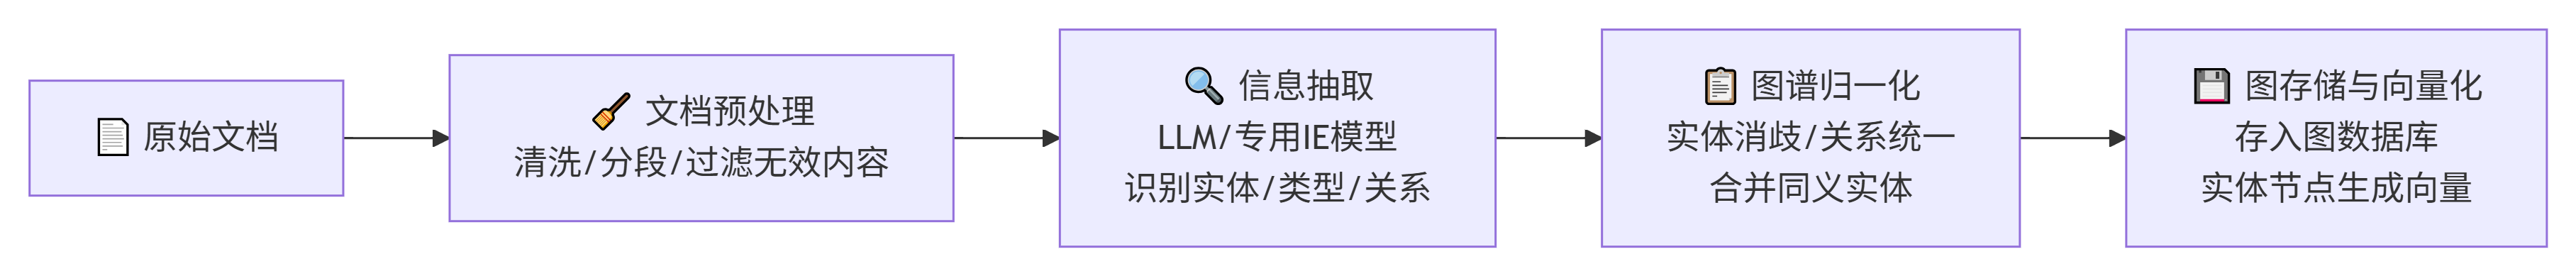
- 1. 文档预处理:文档清洗、分段、过滤无效内容;
- 2. 信息抽取:调用LLM或者专用信息抽取模型,识别文本里的实体、实体类型、实体之间的关系;
- 3. 图谱归一化:实体消歧、关系统一,比如“阿里巴巴”和“阿里”合并为同一个实体,统一关系谓词;
- 4. 图存储与向量化:将实体、关系存入图数据库(Neo4j等),同时给实体节点生成向量,方便后续混合检索。
实体消歧是很容易忽略的关键点。同名实体在不同上下文可能指代完全不同的事物,如果不做归一化,图中会出现大量重复节点,检索时会出现混乱,直接导致回答错误。
3. 在线检索生成模块
在线模块负责接收用户问题,基于已构建的图谱检索信息并生成回答,步骤如下:
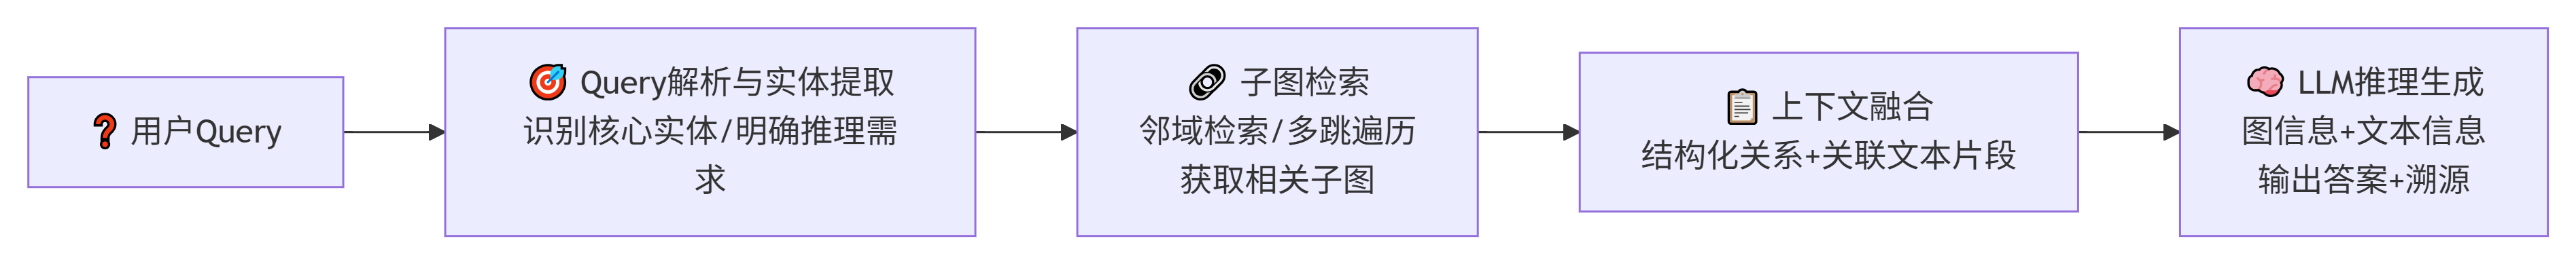
- 1. Query解析与实体提取:从用户问题中识别核心实体,明确推理需求;
- 2. 子图检索:以识别出的实体为起点,在图谱中进行邻域检索、多跳遍历,拿到相关子图;
- 3. 上下文融合:把子图的结构化关系信息,搭配关联的原始文本片段整合;
- 4. LLM推理生成:将整理好的图信息、文本信息一起输入大模型,输出答案,同时可以附带溯源信息。
检索策略不是固定的,可以根据业务灵活选择:固定跳数遍历、基于向量相似度的节点筛选、社区聚类检索等。微软开源的GraphRAG方案里,还引入了全局社区摘要,用来处理大范围知识归纳类问题。
四、GraphRAG关键核心技术
1. 实体与关系抽取
实体和关系抽取是GraphRAG的地基,地基质量差,后续所有环节都没有意义。目前主流有两种实现路线。
基于大模型Prompt抽取:
- 是最通用、落地最快的方案。不需要标注训练数据,直接通过指令让大模型输出标准化的实体、关系三元组,适合中小体量项目快速验证。
- 缺点是大批量文档抽取成本高,稳定性会随文本复杂度波动。
专用信息抽取模型:
- 比如BERT、UIE等预训练抽取模型。
- 适合大规模标准化场景,速度快、成本可控,但需要准备标注数据微调,前期投入更大。
抽取输出的标准结构一般是三元组:(头实体,关系,尾实体),例如(华为,研发,鸿蒙系统)。除三元组外,还可以额外抽取实体属性,丰富节点信息。
2. 实体消歧与归一化
同一实体经常存在多种别名,不同实体也可能重名,消歧就是解决这个问题。常用手段:
- 基于实体描述向量做聚类,语义高度近似的实体进行合并;
- 人工维护实体词典,强制统一标准名称;
- 利用图谱上下文信息辅助判断同名实体的真实指代。
关系归一化同样重要,大模型抽取出来的关系描述五花八门,比如“开发了”“自研”“打造”本质是同一种关系,需要统一成标准谓词,避免图谱关系过于零散杂乱。
3. 图检索策略
图检索区别于向量检索,核心是路径遍历,主流策略分为三类:
- 固定多跳检索:以目标实体为起点,遍历N跳内的所有邻接节点与关系,适合链路清晰、跳数可控的场景;
- 加权游走检索:给不同关系设置权重,优先检索高重要度的关联节点,过滤弱关联噪声;
- 社区检索:微软GraphRAG核心,提前把图谱划分为不同社区,生成社区摘要,遇到宏观归纳类问题,直接调用社区摘要,避免检索范围过大、信息过载。
应用实践很多时候会采用图检索+向量检索混合模式:先用图拿到关联实体,再对实体关联的原始文本做向量二次筛选,兼顾关系推理和文本细节召回。
4. 图数据库选型
存储GraphRAG图谱数据,优先选用原生图数据库,常用选型:
- Neo4j:生态成熟,Cypher查询语法简单,资料丰富,适合绝大多数业务原型和中小生产项目;
- JanusGraph:分布式,支持海量数据,适合超大规模知识图谱;
- NebulaGraph:国产分布式图数据库,高吞吐,适合工业级大规模场景。
如果只是本地Demo验证,数据量极小的情况下,也可以直接用NetworkX内存图,不需要部署独立图数据库,快速验证逻辑。
五、GraphRAG应用实践
GraphRAG应用实践示例:以腾讯混元模型(hy3-preview)为核心,先对原始文档抽取实体关系三元组构建知识图谱,再基于用户问题识别核心实体,通过BFS多跳检索子图,最后结合图关系上下文与原始文本生成答案,完整演示"文档→三元组→图谱→子图检索→图问答"的推演链路,展示知识图谱增强检索在事实性问答中的落地方式。
GraphRAG完整推演过程共6步:
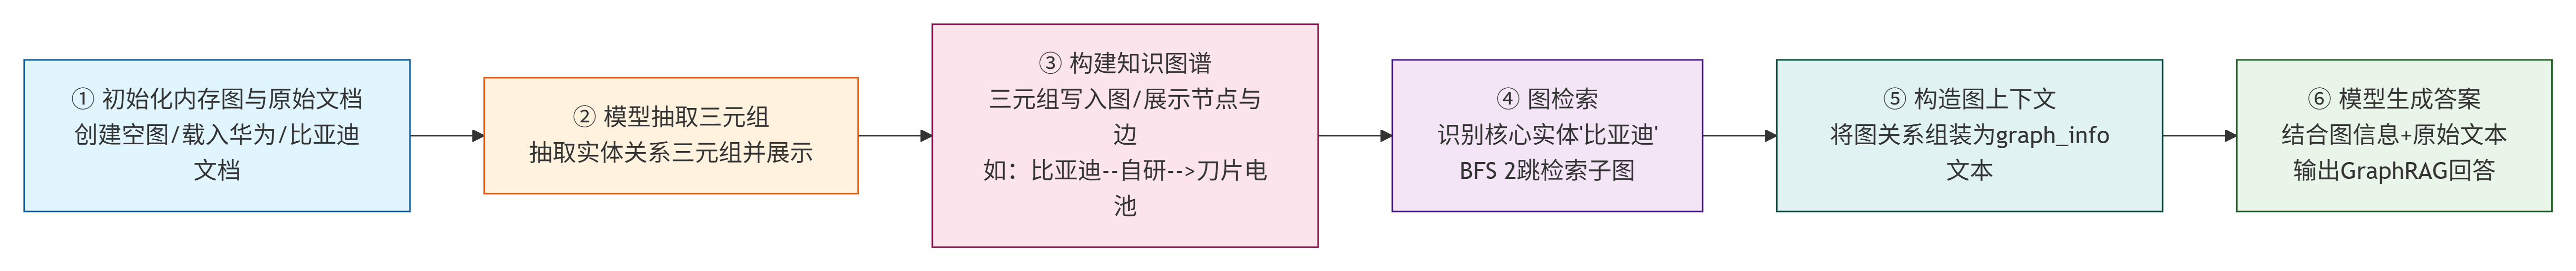
- 1. 初始化内存图与原始文档:创建networkx.DiGraph空图,载入华为/比亚迪原始文档。
- 2. 混元模型抽取三元组:调用hy3-preview抽取实体关系三元组并逐条展示。
- 3. 构建知识图谱:三元组写入图,展示节点数、关系边数及全部边(如“比亚迪 --[自研]--> 刀片电池”)。
- 4. 图检索:识别核心实体"比亚迪",BFS 2跳检索子图并展示关联链路。
- 5. 构造图上下文:将检索到的图关系组装为graph_info文本。
- 6. 混元模型生成答案:结合图信息 + 原始文本回答问题,最终输出GraphRAG回答。
from langchain_openai import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import JsonOutputParser
import networkx as nx
from typing import List, Dict
import os

# 1. 初始化大模型(接入腾讯混元大模型,TokenHub平台)
API_KEY = os.environ.get('TENCENT_API_KEY')
llm = ChatOpenAI(
    model="hy3-preview",
    api_key=API_KEY,
    base_url="https://tokenhub.tencentmaas.com/v1",
    temperature=0
)

# 2. 定义三元组抽取Prompt
triple_prompt = ChatPromptTemplate.from_template("""
你是知识抽取专家,请从下面文本中提取实体、关系三元组,输出严格JSON格式,key为triples,值为列表,每个元素包含head, relation, tail。
只输出JSON,不要额外解释。
文本内容:{content}
""")
triple_chain = triple_prompt | llm | JsonOutputParser()

# 3. 定义问答Prompt,结合图关系信息生成答案
qa_prompt = ChatPromptTemplate.from_template("""
已知实体关系信息:{graph_info}
原始参考文本:{raw_text}
用户问题:{query}
请基于上面信息准确回答问题,禁止编造不存在的事实,如果信息不足直接说明缺少相关信息。
""")
qa_chain = qa_prompt | llm

# 4. 图检索函数:根据实体N跳检索子图
def graph_search(graph: nx.DiGraph, entity: str, hop: int = 2) -> List[Dict]:
    res = []
    if entity not in graph.nodes:
        return res
    # BFS多跳遍历
    visited = set()
    queue = [(entity, 0)]
    visited.add(entity)
    while queue:
        node, depth = queue.pop(0)
        if depth >= hop:
            continue
        for neighbor in graph.neighbors(node):
            rel = graph.get_edge_data(node, neighbor)["relation"]
            res.append({"head": node, "relation": rel, "tail": neighbor})
            if neighbor not in visited:
                visited.add(neighbor)
                queue.append((neighbor, depth + 1))
    return res

# 5. 执行GraphRAG完整推演
if __name__ == "__main__":
    print("=" * 50)
    print("  GraphRAG 完整推演过程")
    print("=" * 50)

    # 步骤1:初始化内存图与原始文档
    print("\n" + "-" * 50)
    print("[步骤1] 初始化内存图与原始文档")
    G = nx.DiGraph()
    raw_doc = """
华为自主研发鸿蒙操作系统,鸿蒙系统搭载于华为手机、平板设备;
华为和比亚迪开展车载技术合作,比亚迪在新能源汽车搭载鸿蒙车机系统;
比亚迪自研刀片电池,刀片电池供应给多家车企。
"""
    print("  ✓ 空图已创建 (networkx.DiGraph)")
    print(f"  ✓ 原始文档:{len(raw_doc)} 字")

    # 步骤2:混元模型抽取三元组
    print("\n" + "-" * 50)
    print("[步骤2] 混元模型抽取实体关系三元组...")
    triple_result = triple_chain.invoke({"content": raw_doc})
    triples = triple_result["triples"]
    print("  ✓ 抽取到的三元组:")
    for i, item in enumerate(triples):
        print(f"    {i+1}. ({item['head']}, {item['relation']}, {item['tail']})")

    # 步骤3:构建知识图谱
    print("\n" + "-" * 50)
    print("[步骤3] 构建知识图谱")
    for item in triples:
        h, r, t = item["head"], item["relation"], item["tail"]
        G.add_edge(h, t, relation=r)
    print(f"  ✓ 节点数:{G.number_of_nodes()}")
    print(f"  ✓ 关系边数:{G.number_of_edges()}")
    for h, t, data in G.edges(data=True):
        print(f"    {h} --[{data['relation']}]--> {t}")

    # 步骤4:图检索(BFS多跳子图)
    print("\n" + "-" * 50)
    print("[步骤4] 图检索:核心实体N跳子图")
    user_query = "比亚迪的电池相关合作和技术关联有哪些?"
    search_entity = "比亚迪"
    print(f"  ✓ 用户问题:{user_query}")
    print(f"  ✓ 核心实体识别:{search_entity}(生产环境可替换专用NER模型)")
    sub_graph = graph_search(G, search_entity, hop=2)
    print(f"  ✓ BFS 2跳检索到 {len(sub_graph)} 条关联:")
    for i, item in enumerate(sub_graph):
        print(f"    {i+1}. {item['head']} -> {item['relation']} -> {item['tail']}")

    # 步骤5:构造图上下文
    print("\n" + "-" * 50)
    print("[步骤5] 构造图关系上下文")
    graph_text = "\n".join([f"{i['head']} -> {i['relation']} -> {i['tail']}" for i in sub_graph])
    print(f"  ✓ 图上下文:\n{graph_text}")

    # 步骤6:混元模型结合图信息生成答案
    print("\n" + "-" * 50)
    print("[步骤6] 混元模型结合图信息生成答案...")
    answer = qa_chain.invoke({
        "graph_info": graph_text,
        "raw_text": raw_doc,
        "query": user_query
    })

    # 最终输出
    print("\n" + "-" * 50)
    print("==== GraphRAG 回答 ====")
    print(answer.content)
输出结果:
================================================== GraphRAG 完整推演过程 ================================================== -------------------------------------------------- [步骤1] 初始化内存图与原始文档 ✓ 空图已创建 (networkx.DiGraph) ✓ 原始文档:89 字 -------------------------------------------------- [步骤2] 混元模型抽取实体关系三元组... ✓ 抽取到的三元组: 1. (华为, 自主研发, 鸿蒙操作系统) 2. (鸿蒙操作系统, 搭载于, 华为手机) 3. (鸿蒙操作系统, 搭载于, 平板设备) 4. (华为, 开展合作, 比亚迪) 5. (华为, 合作领域, 车载技术) 6. (比亚迪, 搭载于, 新能源汽车) 7. (新能源汽车, 搭载, 鸿蒙车机系统) 8. (比亚迪, 自研, 刀片电池) 9. (刀片电池, 供应给, 多家车企) -------------------------------------------------- [步骤3] 构建知识图谱 ✓ 节点数:10 ✓ 关系边数:9 华为 --[自主研发]--> 鸿蒙操作系统 华为 --[开展合作]--> 比亚迪 华为 --[合作领域]--> 车载技术 鸿蒙操作系统 --[搭载于]--> 华为手机 鸿蒙操作系统 --[搭载于]--> 平板设备 比亚迪 --[搭载于]--> 新能源汽车 比亚迪 --[自研]--> 刀片电池 新能源汽车 --[搭载]--> 鸿蒙车机系统 刀片电池 --[供应给]--> 多家车企 -------------------------------------------------- [步骤4] 图检索:核心实体N跳子图 ✓ 用户问题:比亚迪的电池相关合作和技术关联有哪些? ✓ 核心实体识别:比亚迪(生产环境可替换专用NER模型) ✓ BFS 2跳检索到 4 条关联: 1. 比亚迪 -> 搭载于 -> 新能源汽车 2. 比亚迪 -> 自研 -> 刀片电池 3. 新能源汽车 -> 搭载 -> 鸿蒙车机系统 4. 刀片电池 -> 供应给 -> 多家车企 -------------------------------------------------- [步骤5] 构造图关系上下文 ✓ 图上下文: 比亚迪 -> 搭载于 -> 新能源汽车 比亚迪 -> 自研 -> 刀片电池 新能源汽车 -> 搭载 -> 鸿蒙车机系统 刀片电池 -> 供应给 -> 多家车企 -------------------------------------------------- [步骤6] 混元模型结合图信息生成答案... -------------------------------------------------- ==== GraphRAG 回答 ==== 根据已知信息,比亚迪的电池相关合作和技术关联如下: 1. 技术关联:比亚迪自研刀片电池。 2. 合作相关:刀片电池供应给多家车企。 目前信息中未提及比亚迪电池相关的其他合作或技术关联内容,缺少相关信息。
Neo4j拓展适配说明:
如果需要上生产环境,把NetworkX替换为Neo4j,使用Cypher语句完成实体匹配、多跳查询,只需要修改graph_search函数,通过pyneo4j驱动执行Cypher,将查询到的三元组返回即可,整体上层业务逻辑不需要改动。
六、GraphRAG实践与优化
1. 核心落地痛点
GraphRAG在构建应用落地时,绝大多数问题都集中在4个地方:
- 实体抽取不稳定:长文本、专业领域文本中,大模型容易漏抽、错抽三元组;
- 实体消歧成本高:业务领域别名繁多,自动归一化准确率不足;
- 图检索噪声多:图谱规模变大后,多跳检索会带出大量无关实体,上下文冗余;
- 整体链路成本高:文档抽取、图存储、查询资源开销高于传统向量RAG。
2. 针对性优化方案
针对上面的痛点,行业里成熟的优化手段如下:
- 抽取优化:领域内可以少量标注数据微调UIE等抽取模型,搭配校验Prompt,过滤明显异常三元组;分批次抽取长文档,不要一次性传入超长文本;
- 消歧优化:构建领域实体词典,结合实体描述向量聚类,人工定期审核高频歧义实体;
- 检索优化:增加关系权重过滤,对不重要的关系限制遍历;结合向量检索二次过滤召回节点;大规模图谱采用社区摘要策略;
- 成本优化:区分冷热数据,低频文档不需要实时更新图谱;简单查询直接走向量RAG,只有复杂推理类问题才触发GraphRAG链路。
3. 适用与场景说明
适合落地GraphRAG的场景:
- 知识存在大量实体关联、多跳推理需求;
- 业务要求答案可溯源、可解释,对幻觉容忍度低;
- 知识体系相对稳定,实体和关系不会高频大规模变更。
不建议优先使用GraphRAG的场景:
- 仅需要简单文本检索、单点事实问答;
- 知识实时高频变更,图谱维护成本极高;
- 预算和资源有限,快速验证原型,没有人力维护图谱。
七、GraphRAG拓展方向
1. 微软开源GraphRAG方案
- 微软开源的GraphRAG是目前主流工业实现,它除了基础三元组图谱,额外加入了全局社区聚类、社区摘要、局部检索+全局检索两套模式。
- 局部检索处理细粒度实体问题,全局检索适合宏观总结类问题,解决大图下信息过载的难题,也是很多企业落地的参考范本。
2. 混合检索架构
- 现在主流生产方案大多是GraphRAG + 向量RAG混合架构,做路由分发: 路由模块先判断用户query类型,简单语义检索直接走向量库;
- 识别到需要多跳、关联推理的问题,自动进入GraphRAG链路,兼顾性能、成本和效果。
3. 动态图谱更新
- 静态图谱只能适配不变的知识库,业务数据持续新增时,需要增量更新机制:新增文档自动抽取三元组、增量入库、增量消歧,不需要全量重建图谱,这也是生产环境必备能力。
八、总结
GraphRAG不是对传统RAG的全面替代,而是在复杂关联推理场景下的强力补充。它的核心思路,就是用图结构去固化实体之间的逻辑关系,弥补向量只能匹配语义、无法理解关联的短板,让大模型具备多跳推理、可溯源的回答能力。GraphRAG体系分为离线图谱构建和在线检索生成两大环节,实体关系抽取、消歧、图检索是效果核心。
在衡量上线GraphRAG之前,一定要权衡成本收益。简单知识库优先向量RAG,只有面对大量实体关联、多链路推理、高可解释要求的业务,投入GraphRAG的研发维护成本才具备价值。随着Agent应用不断发展,GraphRAG也会越来越多地作为Agent的底层知识能力,支撑智能体完成复杂的规划与推理任务。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号