别再跟 AI 说"帮我画个手绘风"了:331 个风格编号,把出图这件事彻底变成了填空题
原创
别再跟 AI 说"帮我画个手绘风"了:331 个风格编号,把出图这件事彻底变成了填空题
原创
大盘鸡拌面
发布于 2026-10-16 17:16:00
发布于 2026-10-16 17:16:00
一句话结论:你缺的不是更好的模型,是一套能复述的"风格坐标系"。
一、先说说那个把所有人都折磨过的场景
你有没有过这种经历。
辛辛苦苦想了个选题,打开生图工具,敲下一行字:"帮我画一张治愈系手绘插画,秋天的第一杯奶茶,要有生活气息。"
出来第一张,还行。你想微调一下,于是加了个"更有故事感"。第二张风格变了。再补一句"线条再松弛一点",第三张直接变成了日系动画。
你开始往回改提示词,改到最后发现——你已经回不去第一张了。
这不是你提示词写得不好,这是文字描述本身的问题。"治愈""松弛""有故事感"这些词,在模型的语义空间里根本没有一个稳定落点。你以为你在说一个具体的画风,模型听到的是十几个模糊方向上的随机游走。同一句话,今天跑和明天跑,结果都能差出十万八千里。
更别提团队协作了。你把提示词丢给同事,同事出的图和你出的完全不是一套东西,最后只能靠"你看着调吧"收场。
说白了,风格漂移是"描述性语言"和"生成式模型"之间的先天不兼容。
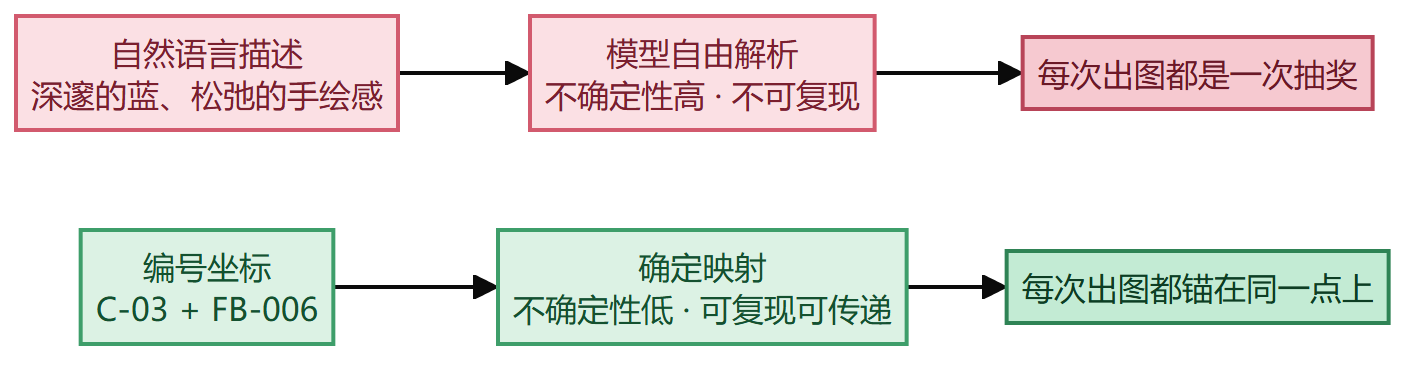
有个叫 handraw-style 的开源项目,干的事情就是把这个不兼容给拆了。它的思路朴素到有点反直觉:
别描述了,报编号。
二、它到底是什么:把形容词换成编号
先纠正一个容易误会的点:它不是 App,不是插件,也不是模型。它是一个 Skill(技能包)——一套喂给 AI Agent 的结构化提示词库加匹配规则。
仓库地址:https://github.com/yang0/handraw-style
作者 yang0,当前版本 v1.9.0,上过 HelloGitHub 推荐。它把所有能想到的手绘风格、排版结构、色彩体系,全部拆成带编号的条目,整理成了三本"图鉴":
图鉴 | 内容 | 数量 | 编号规则 |
|---|---|---|---|
STYLES.md | 手绘风格 | 331 种 | FA-001 ~ FH-044,括号内附全局序号 |
LAYOUTS.md | 排版图型 | 166 种 | SC- / IG- / SB- / IP- / EC- |
COLORS.md | 经典单色主题色 | 36 种 | C-01 ~ C-36 |
风格库按气质分了八个大类,不是随便堆的:
分组 | 主题 | 数量 | 你能想到的代表 |
|---|---|---|---|
FA | 国际社论幽默 | 40 | Gemma Correll、Saul Steinberg |
FB | 经典绘本叙事 | 66 | Quentin Blake、几米、蔡皋 |
FC | 现代平面艺术 | 32 | Malika Favre、穆夏 |
FD | 日本当代插画 | 42 | 奈良美智、日系 Q 版 |
FE | 新国风与传统工艺 | 67 | 水墨、工笔、年画 |
FF | 3D 黏土毛毡与纸雕 | 17 | 黏土、毛毡、纸雕 |
FG | 动漫和赛璐璐 | 23 | 赛璐璐上色、动画分镜 |
FH | 先锋实验与综合媒介 | 44 | 拼贴、混合媒介、印象派油画 |
排版图型那边更有意思,SB-(漫画分镜)一个类别就占了 71 种,是整个图型库里最大的家族——从"四格起承转合"到"对角切割"到"上下两格生活漫画",基本把漫画叙事的常见结构铺完了。社媒卡 SC- 23 种、信息图 IG- 35 种、IP 设计 IP- 13 种、电商 EC- 24 种。
色彩库 36 个,六个色系各 6 个:经典蓝、清新绿、古典红绿、浪漫粉紫、暖阳大地、中性色。都是叫得出名字的经典色——克莱因蓝、鼠尾草绿、爱马仕橙、柿子橙、佩恩灰、象牙白。
于是你的"描述"变成了三个坐标:风格编号 × 图型编号 × 色彩编号。
这就是它能复现的根本原因。编号是离散的、确定的、可传递的。 你把 FB-006 + SC-001 + C-26 丢给任何人、任何模型,出来的东西都在同一个风格锚点上。不用再解释什么叫"松弛感"了。
整条链路其实不长,但每一步都在解决一个具体问题:
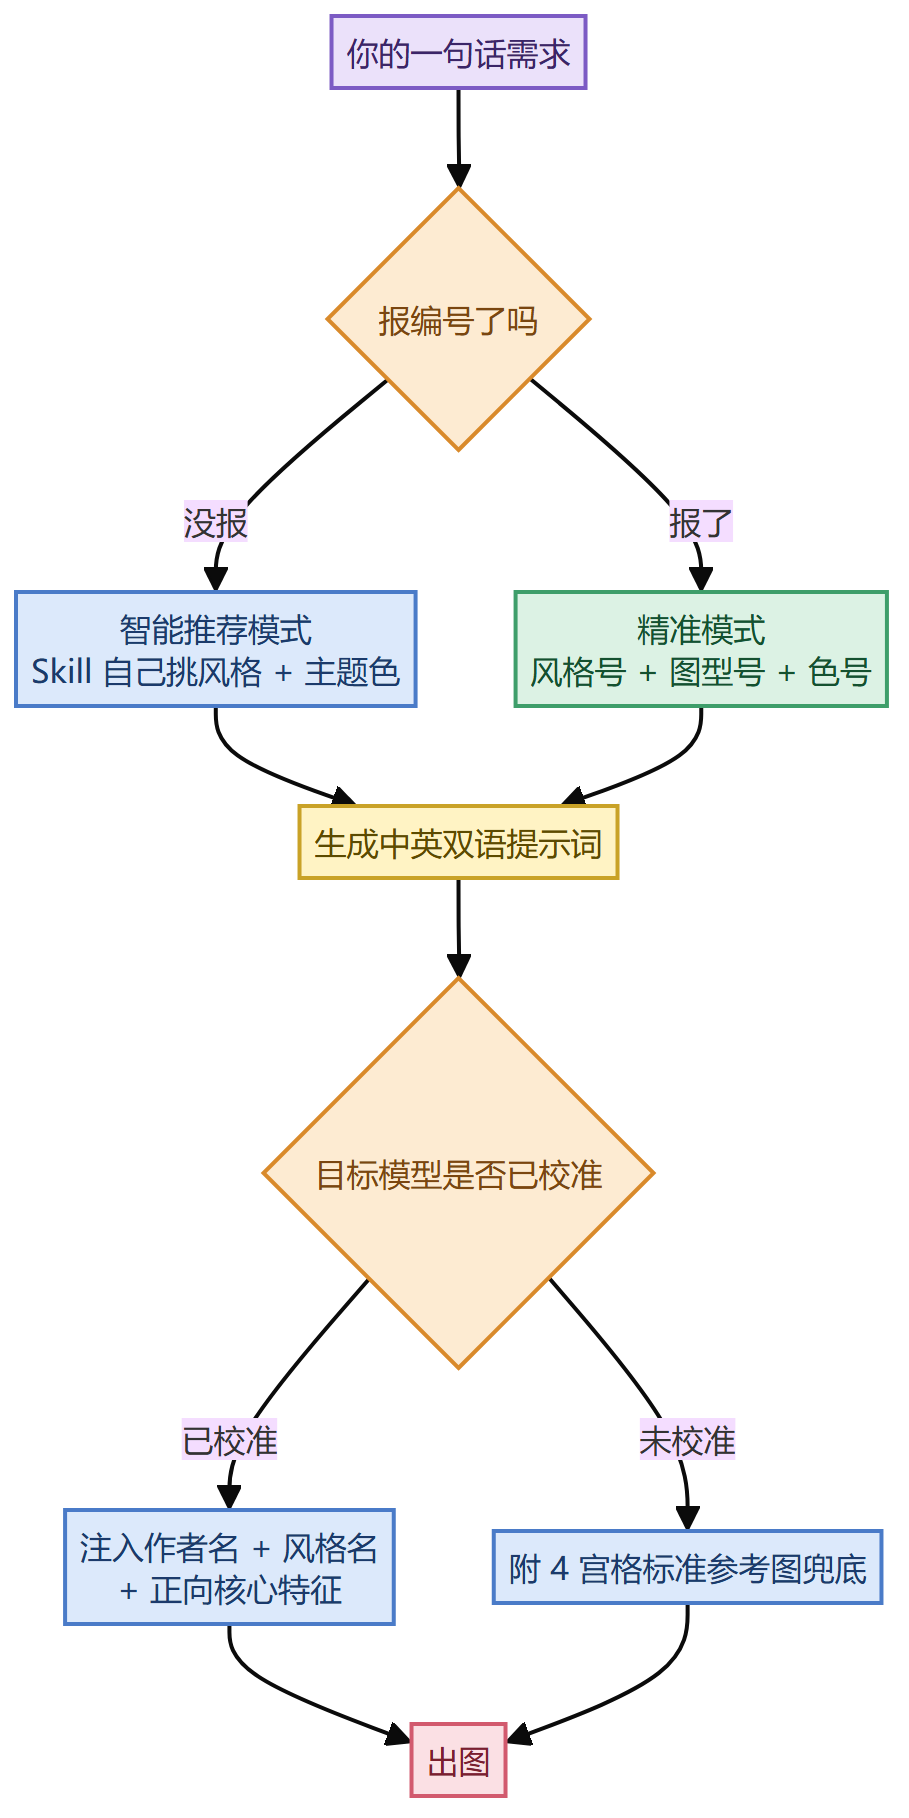
这里有个我觉得很聪明的设计:模型能力分层加兜底策略。
gpt-image-2 是第一个被深度适配的模型。对它,Skill 走"作者名 + 风格名"的直接激活路径,再补充这个风格的核心视觉特征作为正向提示;只有特征描述还不够的时候,才把参考图发过去。
而 Midjourney、Flux、Stable Diffusion、Imagen、Gemini 这些没被校准的模型,直接走 "参考图兜底"——给你一张 4 宫格标准参考图或单图引导,把风格还原度强行拉到接近 100%。
为什么要分两套?因为不同模型对"风格名"的敏感度天差地别。有的模型听"Quentin Blake"就懂,有的听到人名只会一脸懵。硬用一套提示词打天下,就是风格漂移的根源。这套适配矩阵放在 skills/handraw-style-prompter/references/model_capabilities.json 里,作者明确说了欢迎社区提 PR 补充。
三、装它、玩它、切换它
装它真的只要一句话。把仓库地址发给 Codex:
帮我安装这个 Skill:https://github.com/yang0/handraw-style它会自己拉仓库、读配置、把风格库和排版库挂上。几点提前知道:安装过程不下载任何演示视频或私有素材;分镜画廊自带 7 张截图,卡片和弹窗里不放视频;要走视频生成那条路,本机得有 Python、FFmpeg、浏览器或 Node.js;提交前跑一下 python scripts/audit_release.py,它会扫本地路径、凭据泄漏和视频文件。
另外它在 skills/handraw-style-prompter/gallery/tutorials.html 放了个本地交互式拼装器,浏览器直接打开:120 种图型、278 种风格、30 种色彩,按图直选,支持纯图/图文/海报三种模式切换,还有一键随机抽卡。这个页面比翻 markdown 图鉴舒服多了,建议先玩它。
玩法一:智能抽卡(懒人模式)
连编号都不用查,直接把需求丢过去,让它替你选:
帮我生成猫咪在窗台晒太阳的治愈插画提示词,你帮我选风格和主题色(可组合)它会自动匹配风格和色彩,然后吐给你一份中英双语提示词。作者管这叫"抽卡",很贴切——组合是随机的,但结果一定自洽,不会出现风格打架。适合日常出图、找灵感、试风格。
玩法二:精准组装(正式干活用)
这是主力用法。三个坐标一填,剩下交给它:
图型:SC-001,风格:041,主题色:C-01,主题:秋天的第一杯奶茶。SC-001 是"上文下图社媒卡",041 号风格,C-01 克莱因蓝。出来的就是一张结构确定、色调确定的社媒图。简写照样认:
FB-006号风格(或 041号),主题:秋天的第一杯奶茶连风格都不指定,让它兜也行:
图型:SC-001,风格:041,主题色:C-01,主题:秋天的第一杯奶茶。其他你帮我选择。玩法三:海报设计模式(八字段结构化)
这是最有工业味的部分。你说"请帮我出海报提示词,主题:秋分",它不是随便糊一段话,而是输出八个核心设计字段:
主题:秋分·昼夜均而寒暑平
业务场景:二十四节气传统文化海报、文创书店/茶饮节日宣发主视觉、社媒节气签
受众:传统文化爱好者、文艺青年、生活美学追求者、大众社媒读者
内容密度:低
情感基调:松弛闲适、温润拙朴、平衡从容、金秋诗意
主题色:主色为柿子橙(Persimmon Orange),点缀色为普鲁士蓝(Prussian Blue)
editorial风格:Contemporary Literati Ink Cartoon Editorial 风格
画风:风格名称:#FE-053 (#268) · Contemporary Literati Ink Cartoon...八个字段是:主题、场景、受众、密度、情感、主题色、editorial 风格、画风。注意"受众"和"内容密度"——这是专业设计流程里才会显式写下来的东西。很多人出图难看,不是画风不对,是信息密度和受众没对齐。给文艺青年看的海报塞 20 个卖点,怎么排都是灾难。
玩法四:万能海报思维(信息图不够用时的解法)
信息图模板不够用怎么办?作者的思路是:把信息图当高密度海报来设计。 你只要说清楚要呈现什么信息、用在哪:
做一张《山系露营轻量化装包》海报,把装备按睡眠系统(帐篷/睡袋)、烹饪系统(炉头/钛杯)、照明系统(马灯)分类,标注总重量控制在 8kg 内,户外手绘工装风。同样套路可以套到各种"结构化信息"上:
做一张《清迈 5 日慢游 DAY 1 导览》海报,按上午/午后/傍晚三个时段排,标注交通方式和人均花费。做一张《新手手冲咖啡指南》海报,从磨豆到注水拆成 5 步,标注水温和粉水比。行程、装备清单、操作步骤、对比评测——只要信息有结构,它就能给你排成图。
最后:两个模式别搞混
这是个很容易踩的坑。同一句主题,在两个模式下出来的东西完全不同。
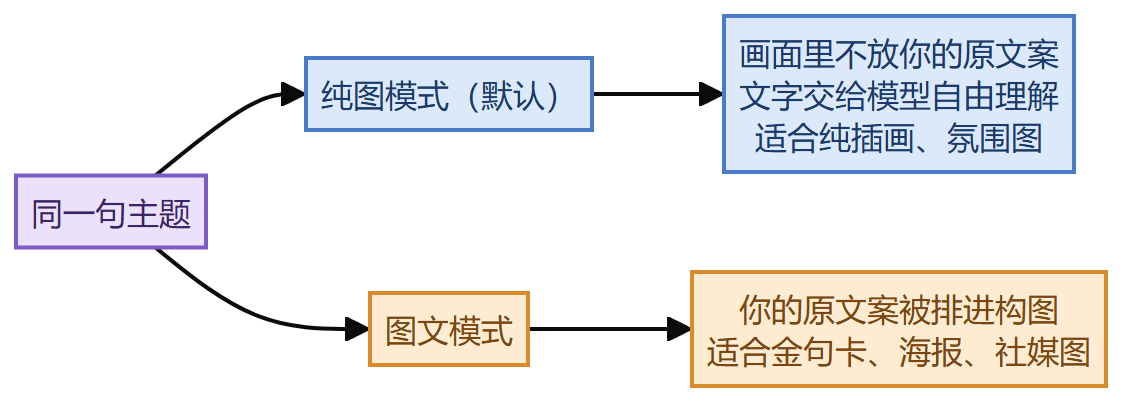
纯图模式是默认的,主题决定画什么内容,但不要求把文字画进画面里:
纯图模式,FB-006 (041)号风格,主题:秋天的第一杯奶茶图文模式会保留你的主题文字,并把它整合进画面构图:
图文模式,FE-052 (267)号风格,主题:有很多事你当时想不通,别着急,过段时间你可能就忘了。看出区别了吗?第一句你要的是一杯奶茶的画面,第二句你要的是这句话本身出现在图上。随时说"切换为纯图模式"或"切换为图文模式"就行。选错模式的后果很直接:想要金句卡结果出来一张没字的插画,想要氛围图结果画面里杵着一行字。每次开工前先想清楚——这张图是给人看的,还是给人读的。
四、完整实战:一篇长文的封面与配图
前面都是零件,现在装一台整机。假设手里有一篇公众号长文,需求是:一张封面加正文配图,风格统一。
第 1 步:出封面
请根据这篇文章帮我设计封面:[粘贴全文,或直接给文件路径 d:\articles\article.md]拿到文章后,它的处理链路是这样的:
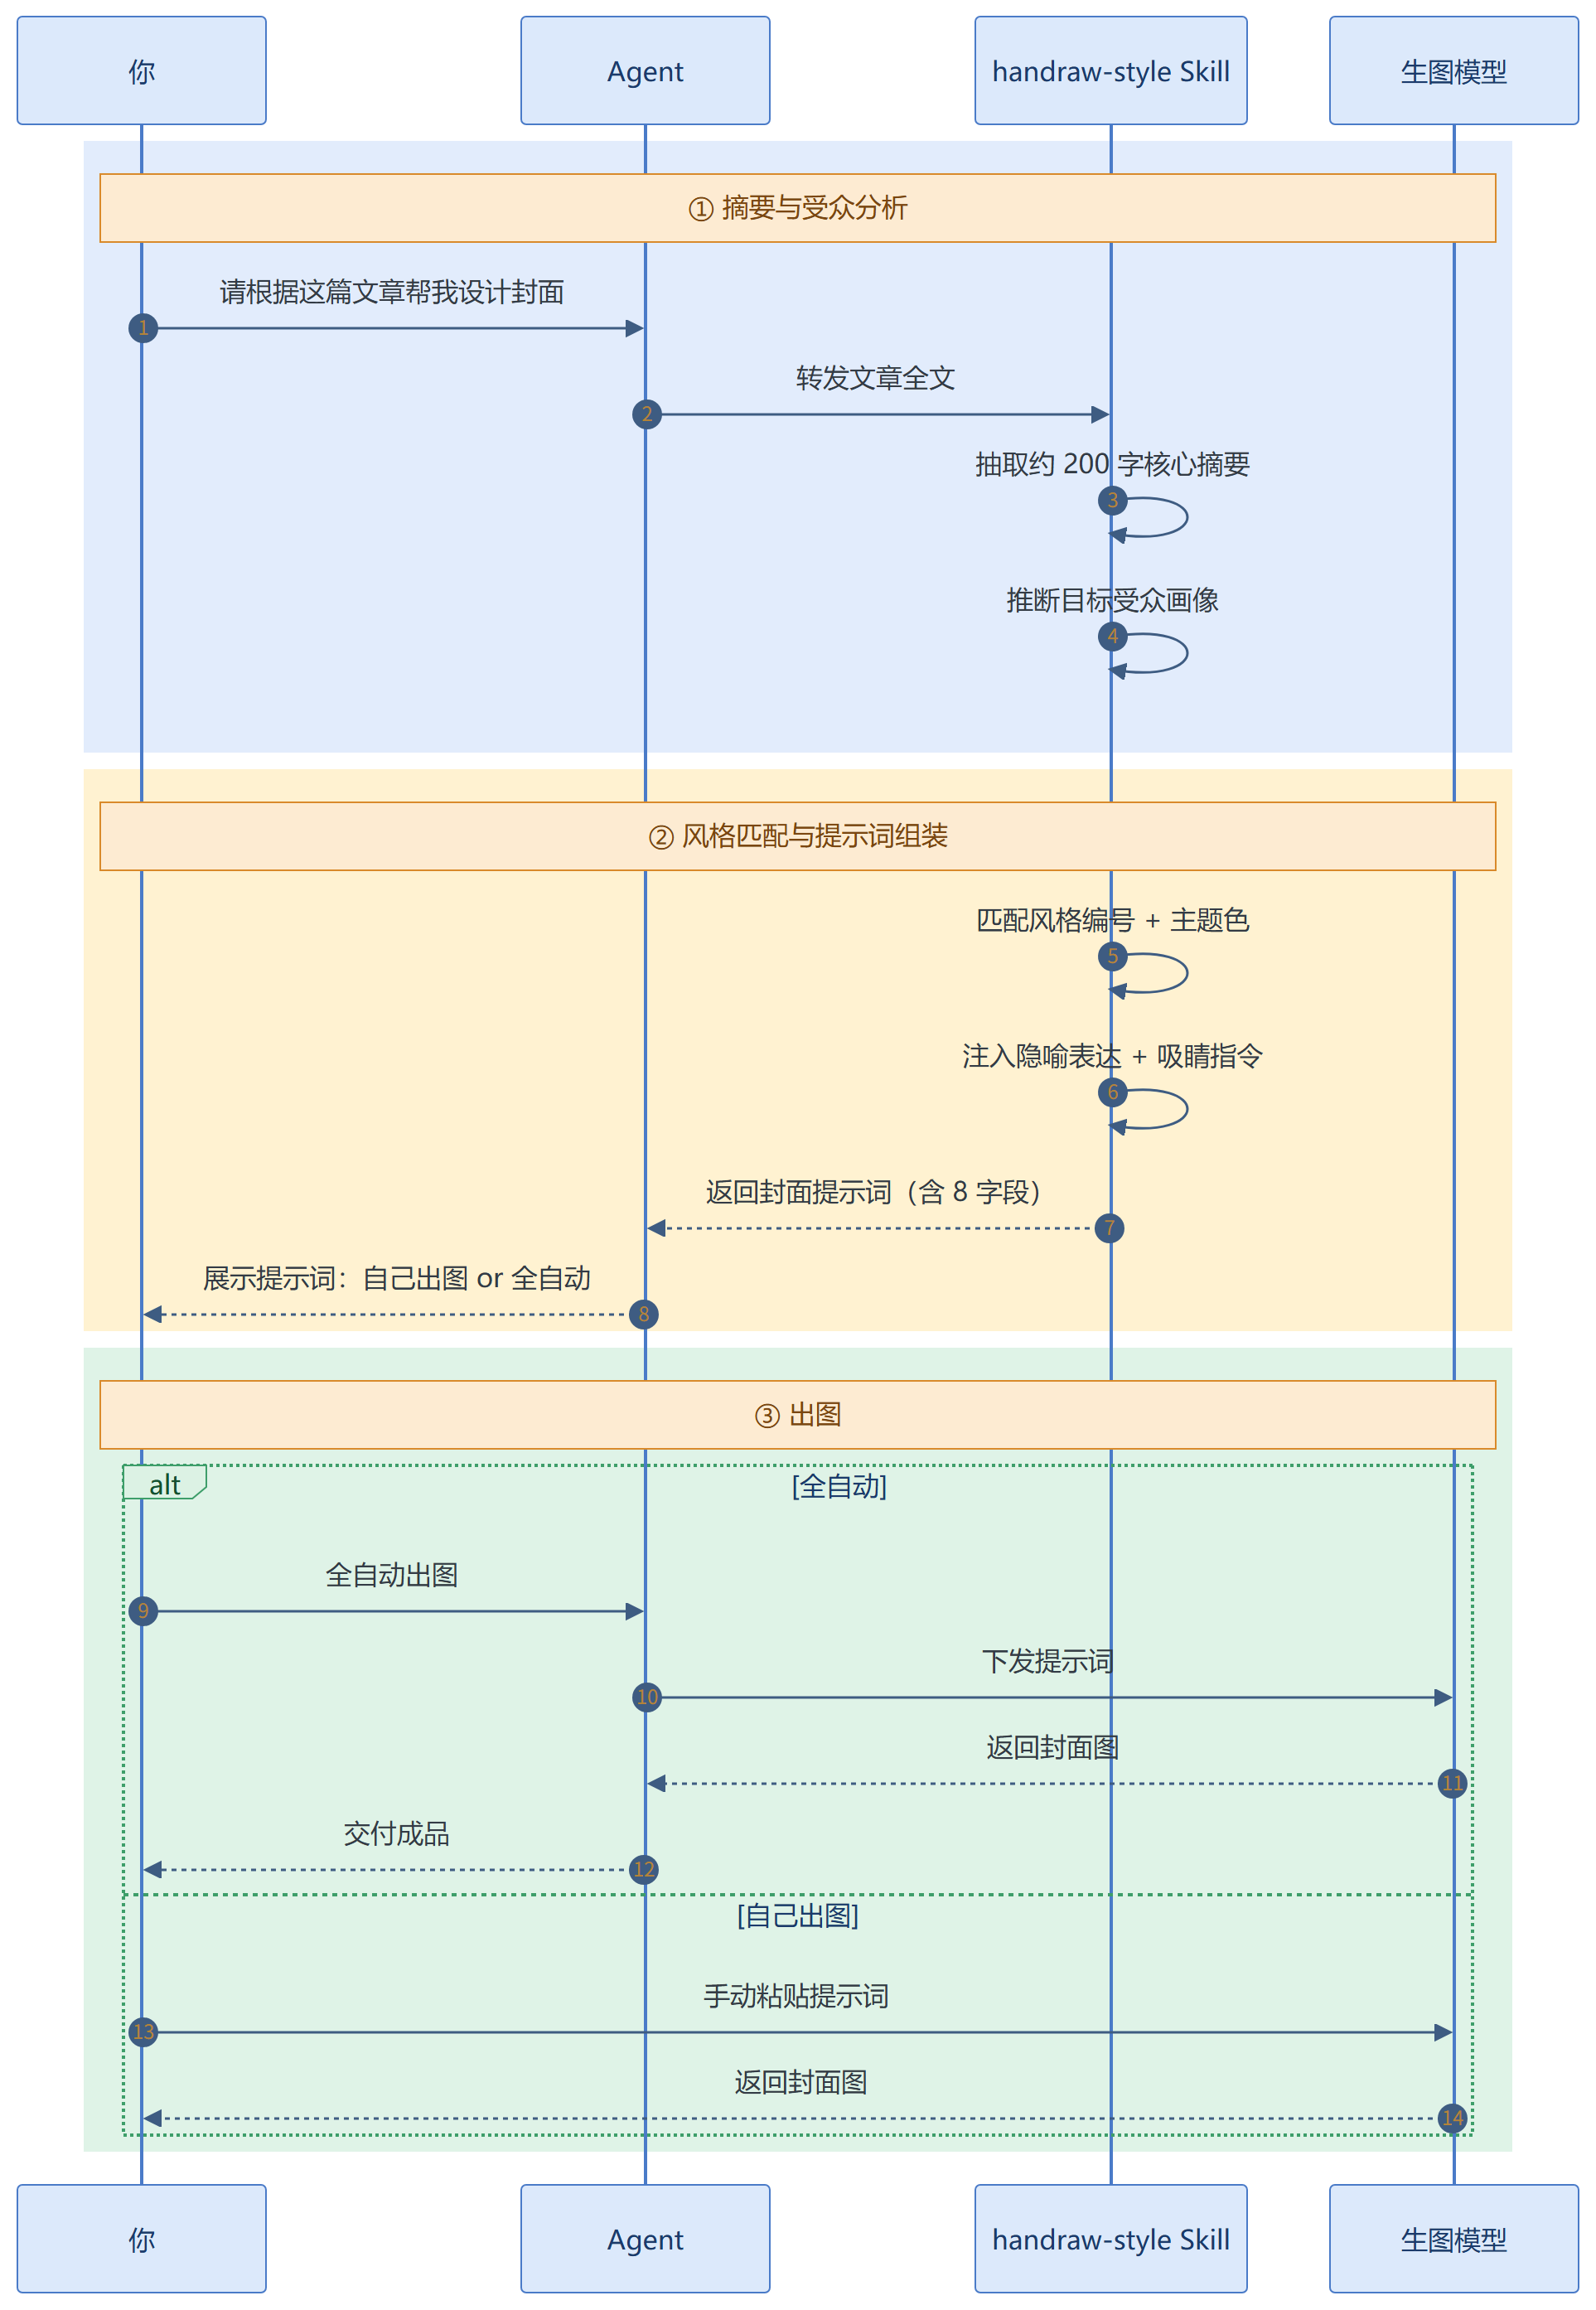
关键动作是先抽 200 字摘要,再推受众。这一步决定了风格往哪个方向匹配——同一篇文章,给行业从业者看和给大众读者看,封面该用的风格完全不同。视频封面同理,.srt / .vtt 字幕文件直接丢进去就行。
第 2 步:批量配图加自动回填
这才是真正省事的地方。一句话:
请帮我为这篇文章规划插图并完成配图:[粘贴全文或文件路径]它做的事情分三层:第一层,从全文里挑出 2 到 5 个真正值得配图的关键节点——是"值得配图"的节点,不是随便找几个段落。第二层,锁定全局统一风格和色调,整篇文章只用一套风格加一个主题色。这是长文配图最容易翻车的地方:每张图单独看都好看,放一起像拼盘。第三层,输出结构化插图方案,先给你看,确认了再动手。
然后你回一句"全自动生图",它就把图一张张生成好,并且回填进 Markdown,最终交付一个 article_illustrated.md。
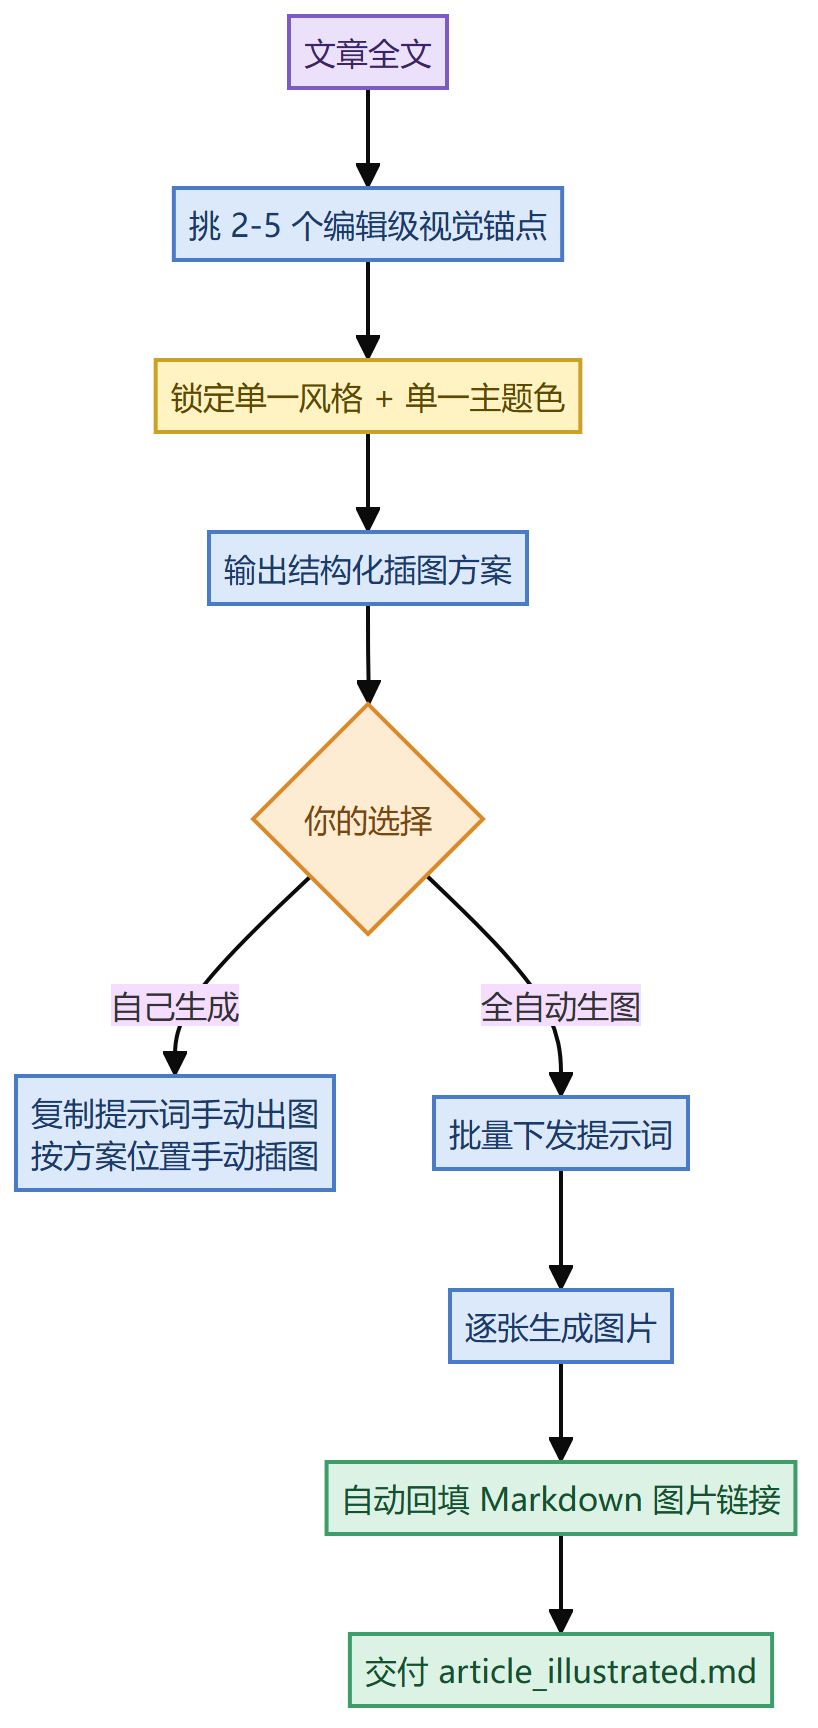
我实测下来,这个流程最大的价值不是"省了配图时间",而是解决了长文视觉一致性。以前给一篇 5000 字长文配 5 张图,要么风格打架,要么得反复微调提示词调到吐。现在风格和色号在第一张图生成前就锁死了,后面四张只是换个内容。
第 3 步(可选):摄影写真规划
这个模块和插画是两套逻辑,针对真人写真场景:
摄影写真模式,请先出3个方案供我挑选,拍摄类型:情侣它会给你三个候选方案——两个真实地标加一个穿越/虚构场景,每个方案包含每个人的造型、服装、发型妆容的确定方案,独立的代码块,末尾统一带一句 出8宫格图片。 你可以直接复制提示词,或者回 A / B / C 让它直接出 8 宫格。覆盖 10 种以上拍摄类型,情侣、婚纱、家庭写真都在里面。
五、几个真实的坑,提前告诉你
坑一:分镜画廊没视频。 自带 7 张截图,卡片和弹窗里都只有静态图,别指望能看到动态效果。想评估分镜的实际观感,得自己跑一遍。
坑二:视频路线有环境依赖。 出图是纯提示词,没依赖。但想走视频生成那条路,本机得有 Python、FFmpeg、浏览器或者 Node.js,具体看选哪条链路。这不是 Skill 能替你解决的。
坑三:模型没校准就吃参考图。 用 gpt-image-2 之外的模型时,它会走参考图兜底。这时候提示词里会多出参考图相关的内容,你得确认工具链支持传图,不然风格还原度会打折。
坑四:别拿纯图模式要金句卡。 前面说过,但真的有人踩。默认是纯图模式,想要画面里有字,必须显式说"图文模式"。
坑五:授权要求。 这个项目很宽松,免费用、随便改、可以商用。唯一的要求是:如果它帮到你了,或者你在它基础上做了东西,保留作者 yang0 和原仓库地址 https://github.com/yang0/handraw-style。就这么一条,别装没看见。
六、为什么这个思路值得学
抛开这个具体项目,它背后的方法论其实更值钱。
现在的 AI 工具圈有个普遍焦虑:模型越强,提示词越玄学。 大家都在追求"更好的描述",写越来越长的 prompt,堆越来越多的形容词。但形容词本身是熵增的——你加得越多,模型的不确定性越大。
handraw-style 反着来:把连续的风格空间,切成了离散的编号格子。
这个思路在别的地方早就验证过了。色彩有 Pantone 色号,字体有字体家族名,音乐有 MIDI 音色编号——专业领域的协作之所以能跑通,靠的就是一套共享的离散坐标系。你说"Pantone 19-4052",全球的设计师都知道那是经典蓝,不需要任何人解释。
AI 出图缺的就是这个东西。大家还在用"深邃的蓝"这种自然语言沟通,而自然语言的解析权在模型手里,不在你手里。用编号,解析权就回到了你手里。
顺带说一句,v1.9.0 刚加了 #331 / FH-044 莫奈印象派油画风格。作者还在持续往里补,社区也能提 PR 补模型适配矩阵。这种"图鉴式"的项目,越多人用越有价值——因为编号体系一旦被广泛接受,就变成了事实标准。
如果你也受够了"改了半天提示词,结果还不如第一张",上手顺序我推荐这样:
- 先把仓库地址丢给 Codex 装上
- 打开本地的
tutorials.html 交互拼装器,按图选一遍风格,找到对眼的几个 - 用"智能抽卡"跑几张,感受一下风格库的覆盖面
- 定下来之后转"精准组装",把风格号和色号记下来
- 最后接上"批量配图",把长文配图这条流水线跑通
从"抽卡"到"组装",其实就是从随机到确定的过程。而确定,才是一切能规模化的前提。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号