从生产会话到根因定位:Agent 上线后的质量闭环
原创
从生产会话到根因定位:Agent 上线后的质量闭环
原创
七牛开发者
发布于 2026-10-16 18:18:57
发布于 2026-10-16 18:18:57
HTTP返回 200、正常延迟和无报错的工具调用,并不代表 Agent 已完成用户任务。例如,旅行规划 Agent 可能在未检查座位可用性的情况下记录用户指定的座位;用户的素食偏好也可能在子 Agent 交接过程中丢失。
上线前的评测集无法覆盖上线后的用户行为和系统变更。为了发现这类静默故障,生产环境需要一条位于请求路径之外的质量循环:从真实会话中识别重复故障,关联对应的部署版本,再将失败样本送回开发阶段修复和复测。Google 团队公开的 Ambient Quality Agent(AQuA)展示了这套流程的参考实现。
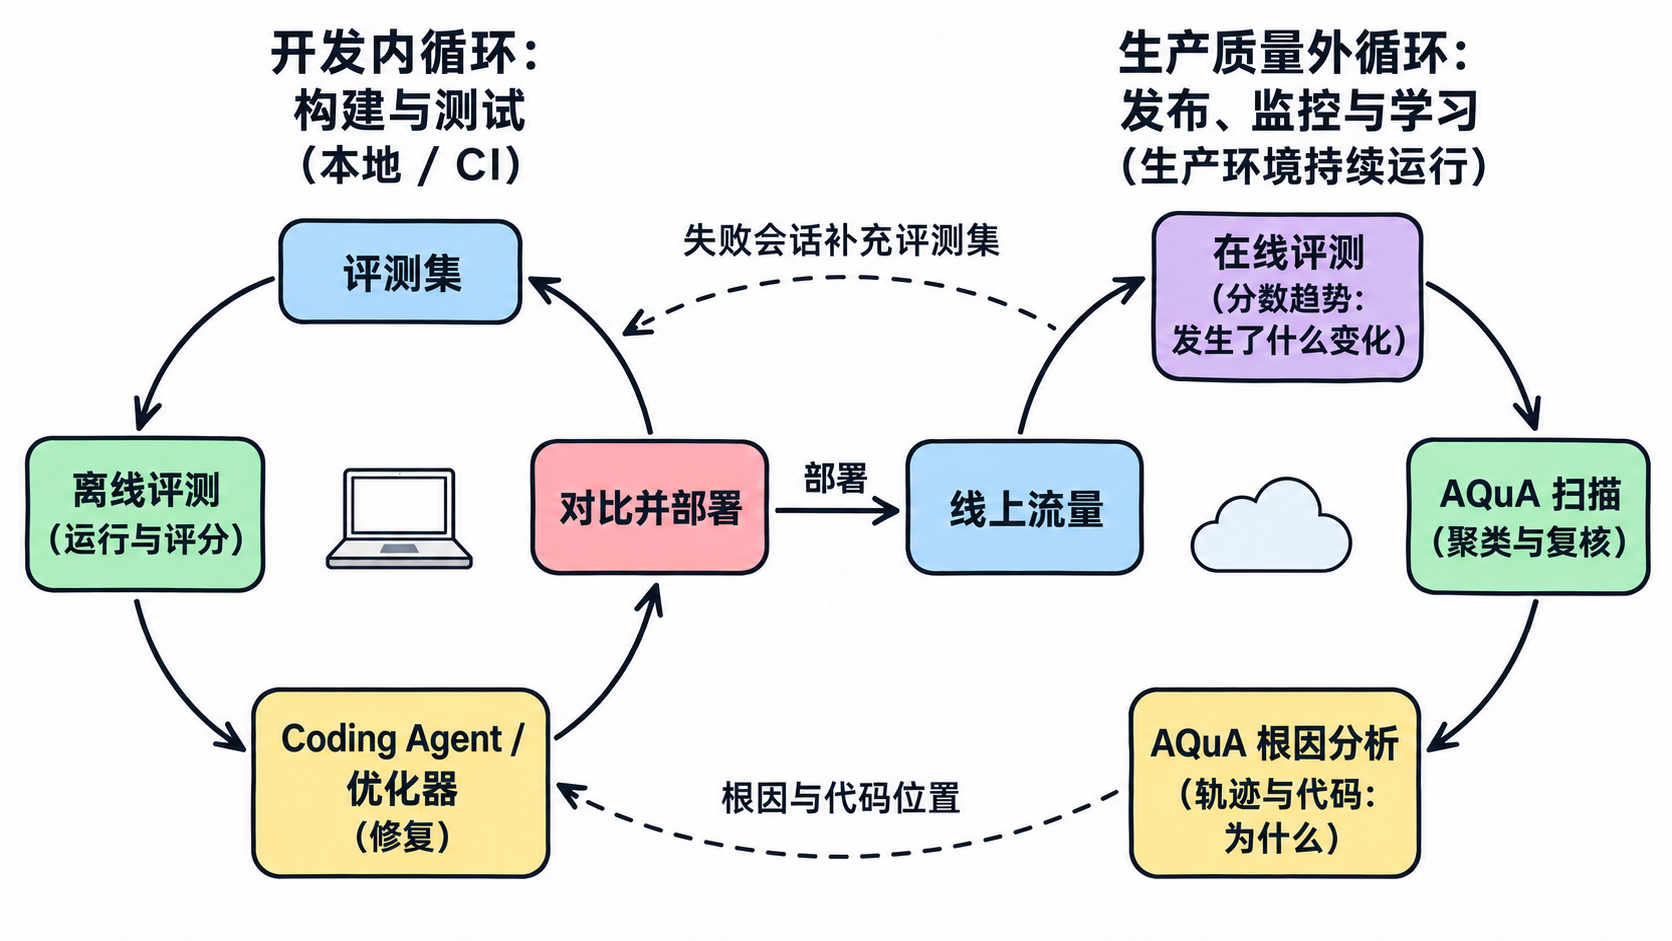
图 1:开发内循环与生产质量外循环
评测对象在上线后持续变化
开发阶段的内循环通常从一组已知测试开始:运行 Agent、评分、修改提示词或代码,再比较前后结果。上线后,用户行为、底层模型、编排逻辑和工具都在持续变化,初始测试集无法覆盖这些变化。即使服务正常运行,Agent 仍可能在部分会话中出现任务级退化。
这类故障可能来自不同层面:模型遗漏前文约束,编排框架将任务路由到错误的子 Agent,状态在交接中丢失,工具 Schema 没有声明合法取值,或者提示词要求调用某项工具而实际配置为 tools=[]。调用链可以还原执行过程,在线指标可以反映分数变化,但二者都不能直接说明某类故障是否反复出现、影响多少会话,以及对应哪个部署版本和实现位置。质量外循环需要补充这些关联。
部署先保存快照再定义业务目标
AQuA 与被观察的 Agent 并行运行,从 Cloud Trace、Cloud Logging 或 BigQuery 读取会话,不参与线上请求,也不会直接修改目标仓库。部署过程包括安装扩展、配置基础设施和部署服务:
agents-cli extension add "${AQUA_CHECKOUT}"
agents-cli infra single-project --project="${PROJECT_ID}" --apply
agents-cli deploy --project="${PROJECT_ID}" --region us-east1
部署不只启动服务,还会将目标 Agent 的源码树保存为按部署版本索引的不可变快照。这样,后续分析一段旧会话时,读取的是当时实际运行的提示词、工具声明和代码,而不是已经发生变化的主分支。
源码快照用于确定被分析会话对应的实现版本,goal.md 则用于定义这个业务中什么算任务失败。旅行助手的检查目标如下:
目标:所有已确认的航班、酒店、座位和推荐,
都必须以工具结果和旅行者档案为依据。

重点检查:
- 用户中途修改目的地、日期或选项后,状态是否同步
- 子 Agent 交接时,是否丢失饮食偏好和既有选择

忽略:
- 语气和问候问题
- 只浏览但没有预订的会话通用评审模型不会天然理解团队的业务约束。如果缺少领域目标,它可能将语气问题列为缺陷,却漏掉“未经工具确认就写入预订状态”。goal.md 用于调整审阅重点,但每条发现仍需要关联具体的会话证据。需要执行确定性检查时,还可以并行运行 Python 自定义指标。
将会话级发现聚合为可追踪问题
定义业务目标后,外循环才能按照一致标准处理生产轨迹。一次扫描包括五个阶段:随机抽样最多 1000 个近期会话,逐会话审阅,将具有相同失败机制的发现聚类,用独立模型读取完整轨迹复核,最后与历史问题记录匹配,并标记为 NEW、RECURRING 或 RESOLVED。
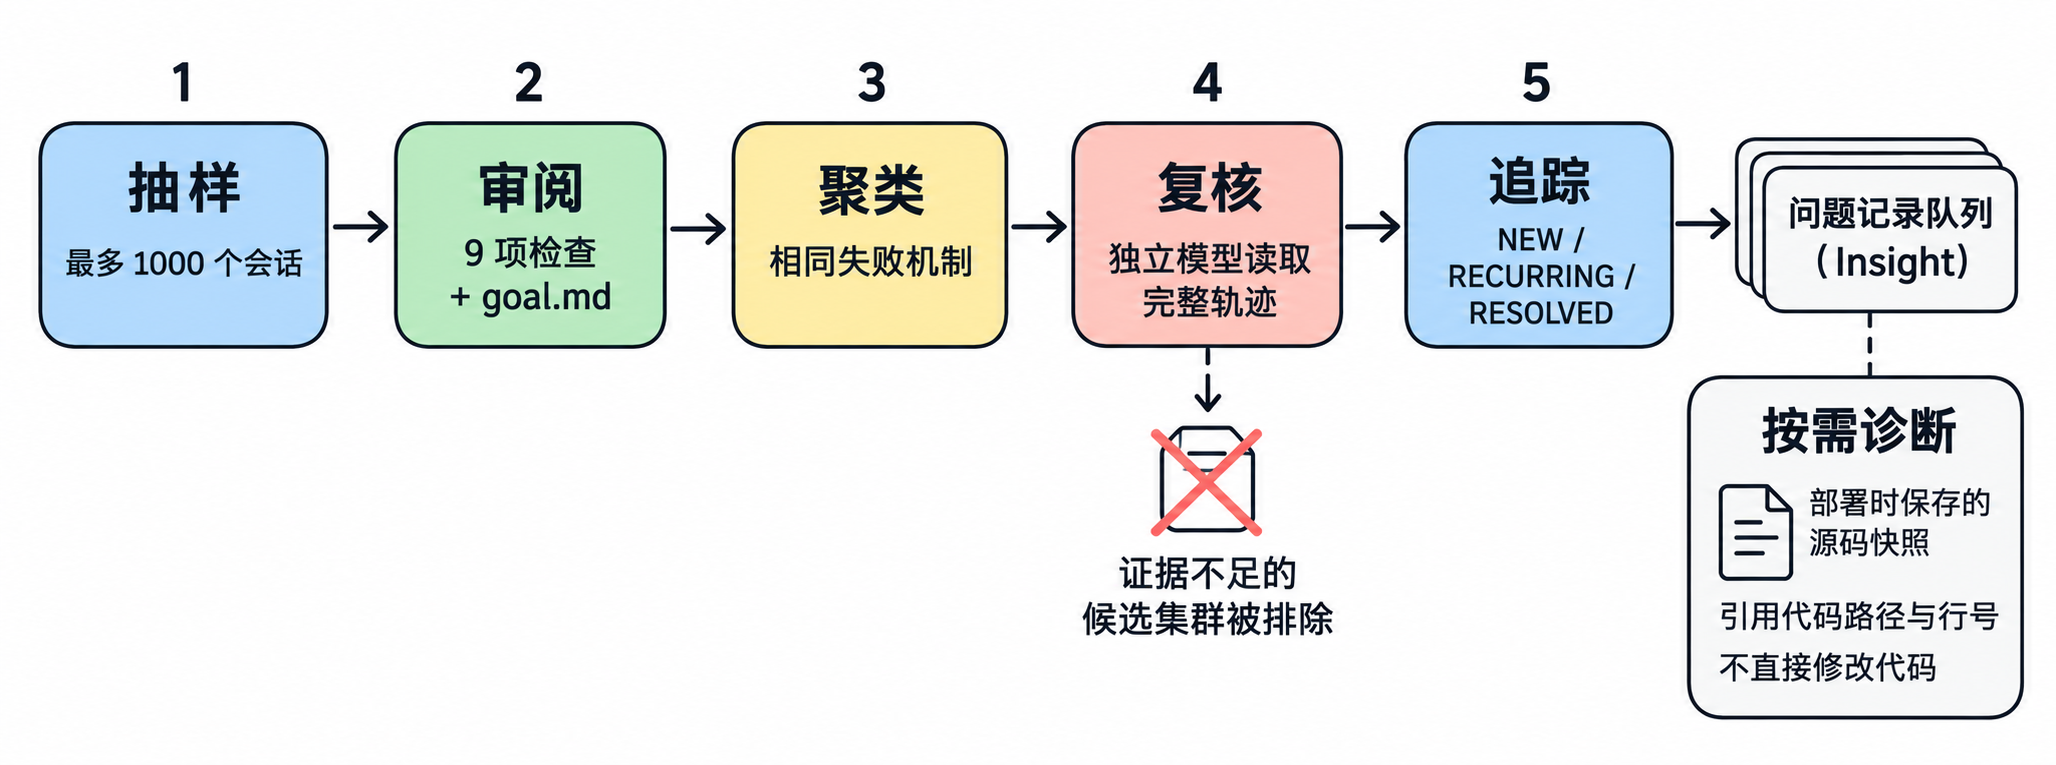
图 2:抽样、审阅、聚类、复核和追踪五阶段流程,以及按需执行的根因诊断
审阅模型看到的不只有对话,还包括对应 Agent 的指令和工具声明。为了控制定时扫描成本,默认的 session_review 对每个会话只调用一次模型,并在一次调用中完成九项检查;团队也可以启用 task_success、tool_use_quality、trajectory_quality 等托管自动评审器,分别执行专项评估。
审阅结果不会只给出一个抽象分数,而是生成可核查的实际行为和预期行为:
实际行为:
用户同时选择 UA204 和座位 3A、3B 时,
planning_agent 直接将座位写入会话状态。

预期行为:
写入前应调用 flight_seat_selection_agent,
确认座位是否存在、是否可用以及对应价格。
在 travel-concierge 中重复运行四条旅行流程,共得到 32 个会话和 1,583 个 OpenTelemetry Span。5 个会话直接通过,其余会话产生了 42 条结构化发现。聚类阶段得到 9 个候选问题,复核模型再读取每个集群中最多三条完整轨迹,排除 3 个误报集群,最终保留 6 个问题。
被排除的候选问题中,有两个集群的样本显示,用户明确要求直接预订或选择首班返程;另一个集群则错误合并了 flight_search_agent 与 inspiration_agent 两个互不相关的提示词与工具配置问题。
其中三个问题位于不同的工程边界:
planning_agent在 15 个会话中跳过座位可用性检查,原因是指令没有覆盖“用户直接给出座位号”的路径。inspiration_agent委派任务时没有将素食偏好传给隔离运行的place_agent,影响了 7 个会话。poi_agent的提示词要求返回经过地图工具验证的内容,实际却配置为tools=[],导致 5 个会话生成占位链接。
聚类没有为 42 条局部发现分别创建问题记录,而是将不同表象归并为少数重复出现的失败机制。独立复核则用于避免由同一个模型提出问题并复核自己的判断。
这里需要保留一个实现边界:AQuA v0.1.0 默认执行复核,但 AQA_INSIGHTS_VERIFICATION_ENFORCED 默认关闭。负面复核结果通常会附在候选问题上供后续分诊;只有显式开启强制复核,证据不足的候选才会被阻止进入问题记录。每轮复核最多处理 50 个集群,每个集群最多读取三条轨迹,因此“已复核”也不代表确定性结论。
问题记录的数据结构没有设置由模型自报的 confidence 字段。每条记录都需要关联可回查的会话 ID;如果根因位于仓库内,引用的文件路径和行号还需通过对应部署版本的源码快照校验。问题记录的可信度来自这些可验证的证据,而不是模型对自身判断的评分。
RESOLVED 状态也有明确边界,问题连续 14 天没有再次出现,只表示它在抽样窗口中没有重现,不等于已经证明修复。低频故障仍然需要人工判断或定向回归测试。
按部署版本定位根因
影响 15 个会话的座位问题随后进入根因分析。分析 Agent 对照 Revision 1 的 33 个源码文件,将问题定位到 travel_concierge/sub_agents/planning/prompt.py:93:原指令只要求在“展示座位图供用户选择”时调用座位 Agent,没有覆盖用户直接给出座位号的情况。
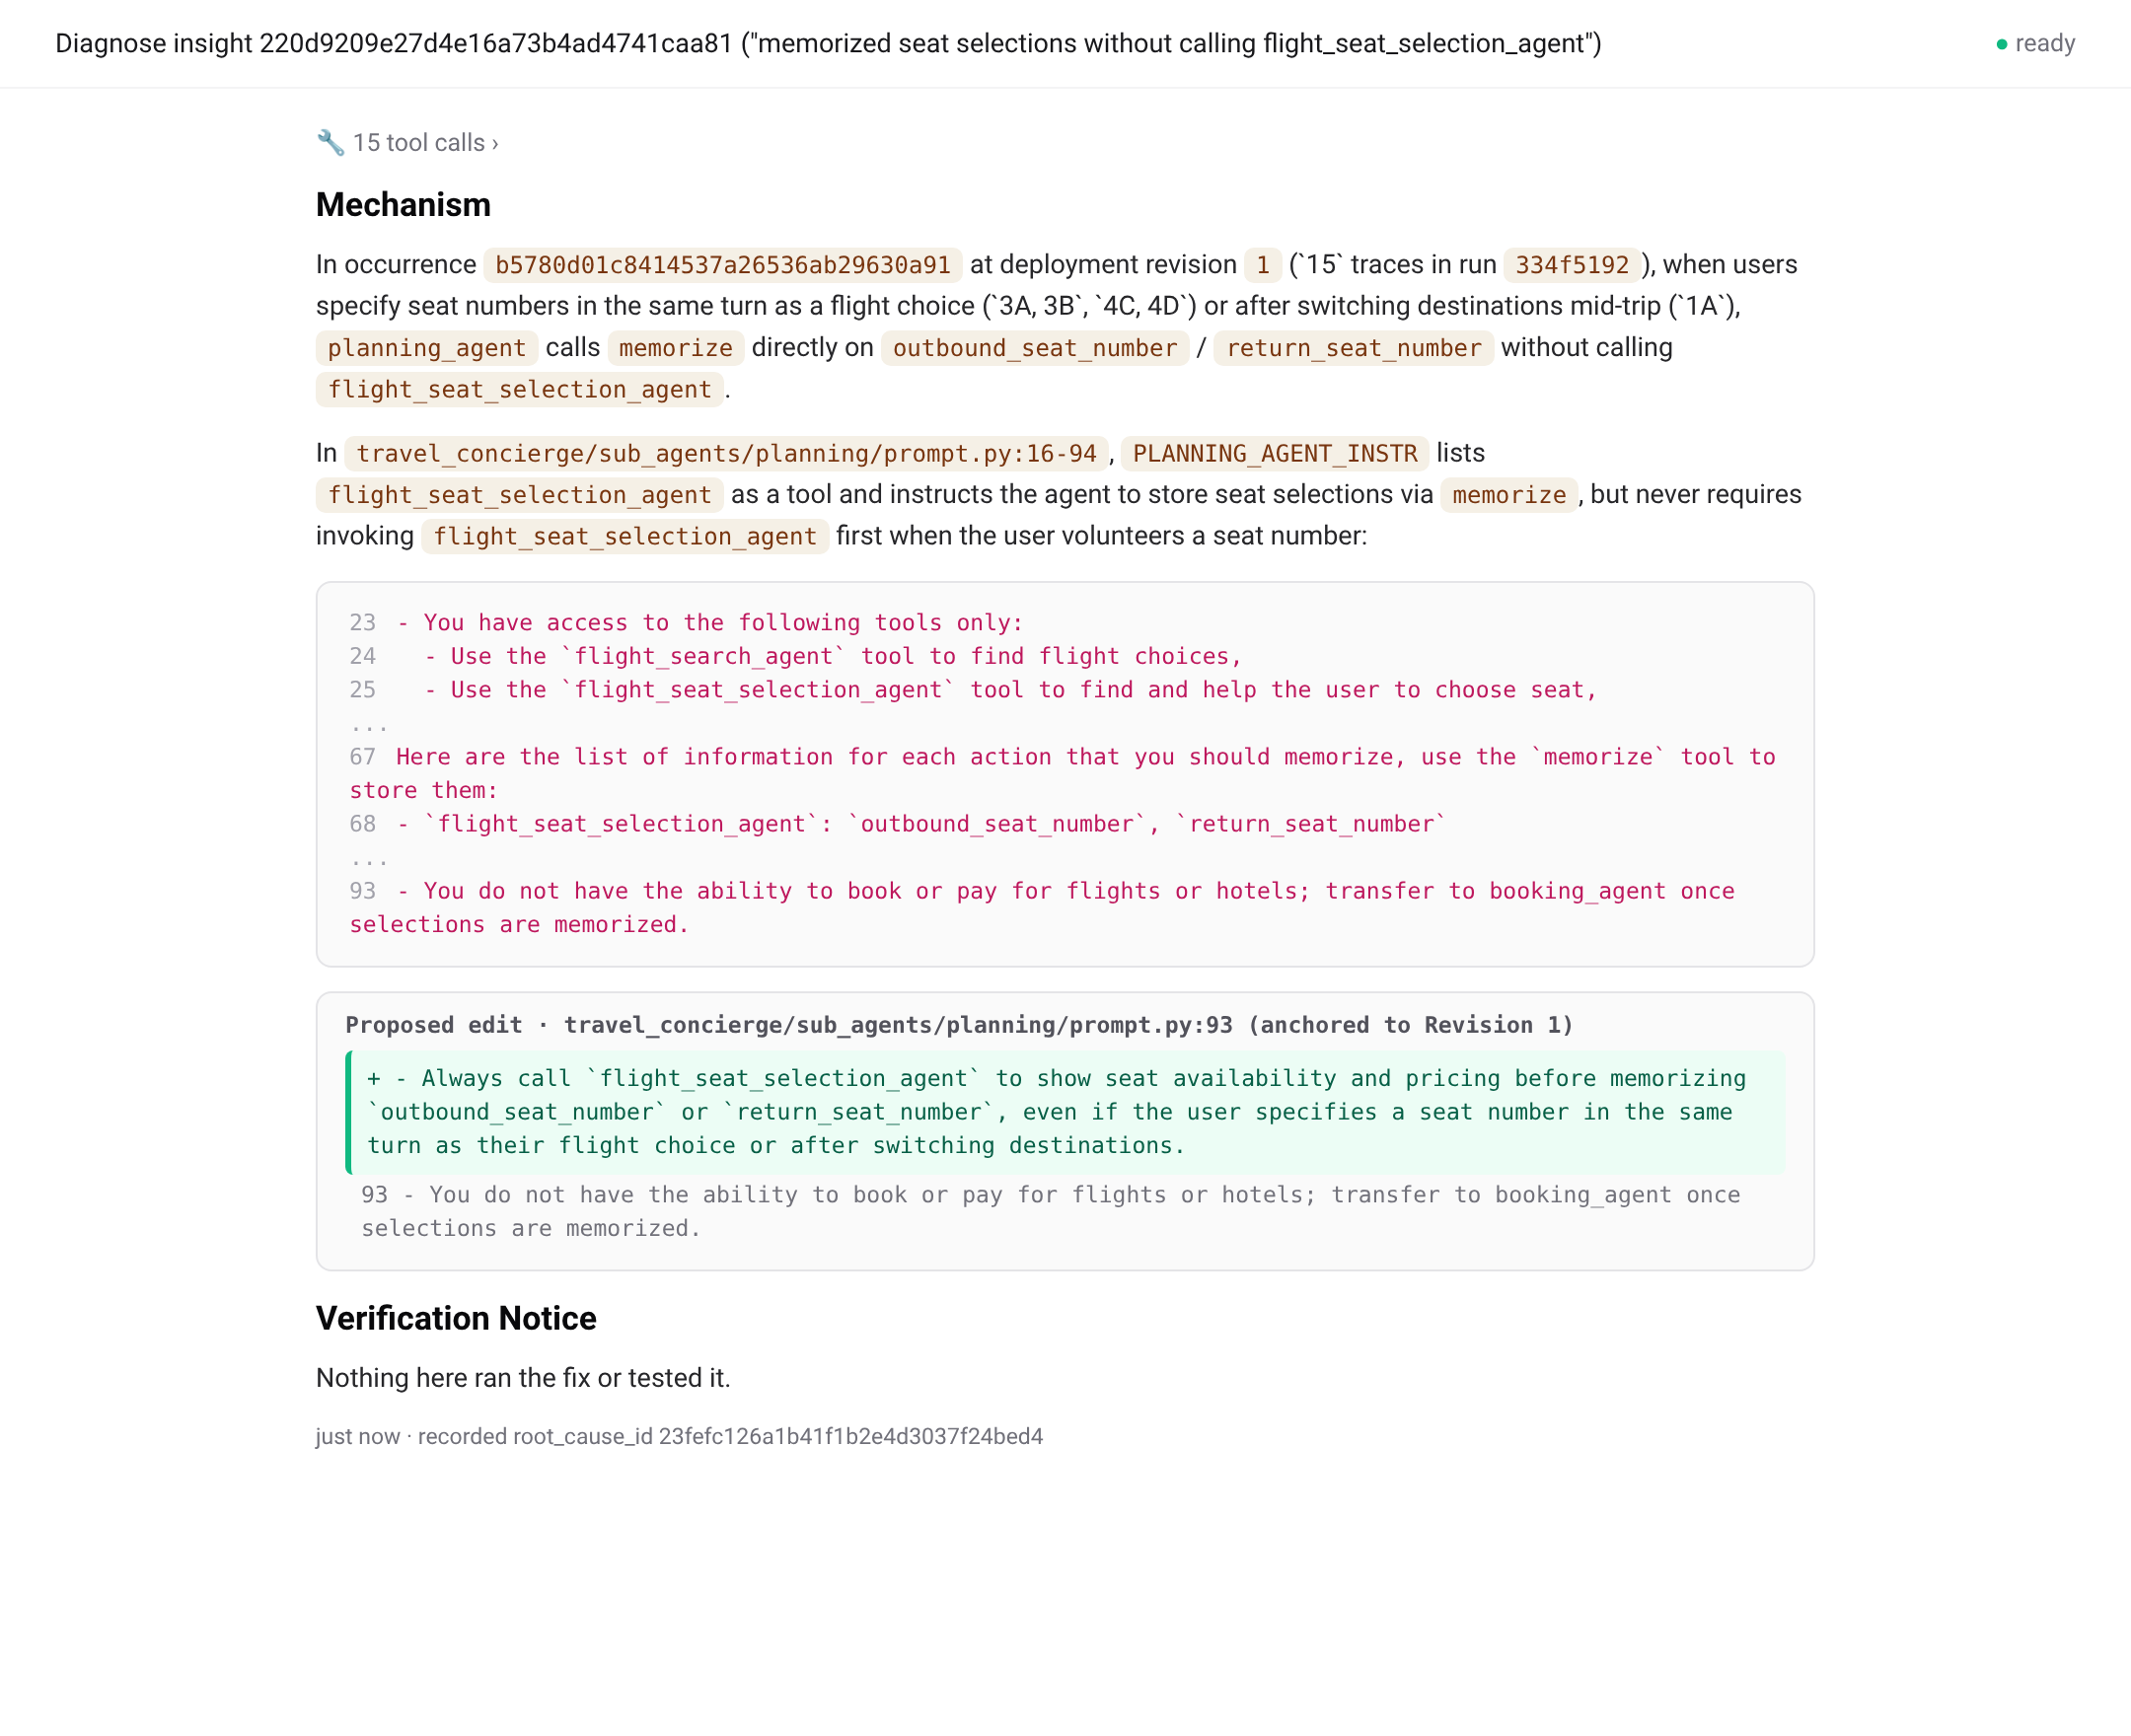
图 3:根因分析将问题定位到部署源码快照中的文件和行号
根因分析并不假设所有故障都能在当前仓库中修复,如果缺陷位于仓库内,分析结果会引用 <path>:<start>-<end> 格式的文件位置,并提出候选修改;如果问题来自上游依赖、Agent 交接或外部检索返回的数据,分析只会将失败归因到轨迹中的具体步骤,不会强行生成代码差异。
缺陷位于仓库内时,候选修改引用的文件路径和行号会针对对应部署版本的源码快照重新校验。不存在的文件、越界的行号范围和相互重叠的编辑都会被拒绝。
这种校验只能证明引用位置真实存在,不能证明模型判断一定正确。因此,根因分析保持只读:它可以提出带行号的候选修改,但不会写入工作树,也不会自动创建拉取请求。
问题记录、失败轨迹和候选修改可以继续交给开发者或 Coding Agent:
# 找出影响范围较大的新问题
agents-cli aqua list-insights --status NEW --root-cause false

# 运行根因分析,取得证据和候选修改
agents-cli aqua run "Diagnose insight <INSIGHT_ID>"
agents-cli aqua get-insight <INSIGHT_ID> > insight.json

# 从证据轨迹中提取用户轮次,在本地重放
jq '{state: {}, queries: [.occurrences[0].rubrics[0].trace[]
  | select(.role == "user") | .content]}' insight.json > inputs.json

adk run --replay inputs.json travel_concierge
以上是两个循环的连接方式,质量 Agent 负责缩小搜索范围并准备证据,开发者或 Coding Agent 在独立分支中实施修改,原来的失败输入再回到开发内循环验证。
部署新版本并重放相同会话
团队修改了座位检查和素食偏好传递对应的两处提示词,部署 Revision 2,并在相同的 goal.md 下重放此前的 32 个会话:
- 座位检查绕过从 15 个会话降至 2 个,下降 87%。
- 素食偏好遗漏从 7 个会话降至 0。
- 完整通过的会话从 5/32 增至 13/32。
- 未修改的
poi_agent tools=[]问题仍然影响 5 个会话。
未修改的 poi_agent 问题在两个版本中均影响 5 个会话,提供了未修改项的参照。两处修改也没有消除其他类型的失败。这组实验能够支持的结论是:流程识别出了两种重复出现的失败机制;修改对应提示词后,相同脚本下的相关症状明显减少。
这些数字来自 Google 团队自己的脚本化重放,不是独立的生产环境基准测试。这组 32 个多 Agent 会话平均包含约 50 个 Span,审阅、聚类和复核共花费 3.76 美元,约为每个会话 0.12 美元。
作为参照,另一组 96 个单 Agent 会话平均只有 5~6 个 Span,总成本为 0.70 美元,约为每个会话 0.007 美元。两个样本的单会话成本相差约 17 倍。由于会话内容、任务复杂度和样本规模并不相同,这不能作为严格的单 Agent 与多 Agent 成本基准,但可以看出,诊断成本可能对轨迹深度较为敏感。针对单个问题记录执行按需根因分析,成本还需约 0.33~2.47 美元。
重放本身也不等于回归测试,adk run --replay 会重新发送记录下来的用户输入,却不会恢复已经变化的数据库和外部 API 状态;多轮对话还可能因为模型输出不同而进入另一条执行路径。要得到可复现的测试,仍需固定工具响应、保存必要状态,并为失败定义可以检查的判断标准。
实现边界与可迁移设计
AQuA v0.1.0 仍是 Alpha 阶段的参考实现。当前方案依赖 ADK、Google Cloud 遥测、BigQuery 和 Gemini 平台,并采用一个 AQuA 对应一个被观察 Agent 的一对一形态。团队将覆盖一组 Agent 的一对多(1:N)接入列为后续方向。因此,它展示的是一种工程方法,而不是可以直接套用到所有系统中的成品。
当前方案还有两个尚未解决的规模问题。
第一是采样盲区。随机抽样可以限制成本,却可能长期错过只影响 1% 核心流程的静默退化;只按高延迟、重试或用户点踩进行廉价预过滤,又可能反复抽到同一种显性故障,无法覆盖指标正常但任务已经失败的会话。
第二是超长轨迹。将完整会话轨迹直接交给评审模型,适用于十轮左右的交互;面对运行数百轮、产生数 MB 工具输出的 Coding Agent 或 Research Agent,则需要先进行语义级轨迹压缩,同时保留任务里程碑、关键状态变化和偏离位置。
剥离 AQuA 的具体产品和基础设施依赖后,这套流程包含四项可以独立实现的设计原则:
- 质量分析运行在请求路径之外,诊断失败不能扩大为用户请求失败。
- 保存轨迹时,同时保存 Agent 指令、工具声明和部署版本。
- 区分单次发现、候选集群、有限复核和人工确认,不将模型判断包装成确定事实。
- 让诊断过程保持只读,将修改和验证交回独立的开发内循环。
生产 Agent 的外循环是将不确定性转化为可以检查的记录:哪些会话被抽到,哪些失败重复出现,证据来自哪个部署版本,根因引用了哪段实现,修改后同一症状是否减少。
HTTP 200 只能说明请求在协议层成功返回。只有将生产轨迹、领域规则、源码版本和开发验证重新连接起来,团队才可能判断用户任务是否真正完成。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号