面向 API 开放平台的字段级动态脱敏网关:按调用方身份做差异化数据管控
原创
面向 API 开放平台的字段级动态脱敏网关:按调用方身份做差异化数据管控
原创
安当加密 3
发布于 2026-10-18 13:27:35
发布于 2026-10-18 13:27:35
摘要:在数据中台与开放平台建设过程中,企业越来越多地把内部数据通过 API 对外共享给合作伙伴、渠道商与第三方开发者。这种模式放大了内部数据泄露风险——同一个接口在面向不同调用方时,应当返回不同粒度的字段内容。本文从 API 开放场景的实际痛点出发,剖析静态脱敏与后端改造两类思路的缺陷,提出以字段级动态脱敏网关作为透明代理、按调用方身份执行差异化脱敏的落地架构,并结合部署形态、性能损耗、策略模型与审计能力,给出一套可实施的技术方案。 正在上传图片...
关键词:数据库加密网关、字段级加密、动态脱敏、数据库防泄露、运维管控、应用零改造加密、内部数据泄露、脱敏方案、API 开放、数据共享
一、API 开放让数据共享常态化,也让泄露面成倍扩大
过去十年,企业数据中心里跑着大量核心业务库:会员库里躺着手机号、身份证号和银行卡尾号,订单库里记录着收货地址和支付信息,风控库里沉淀着设备指纹和行为轨迹。这些库过去只对内部系统开放,访问链路短、人员可控,但随着业务中台化和生态合作加深,企业开始把数据以 API 形式对外提供——给渠道商查库存与物流,给合作方做联合营销,给第三方开发者做增值应用,给监管报送做数据回流。
数据共享一旦走出内网边界,泄露面就不再是"谁能登录数据库"这一个维度,而是"谁能调我的接口"。同一个查询接口,对自家 App 应该返回完整手机号,对物流合作方应该只返回脱敏后的手机尾号,对第三方营销应用则连姓名都要做掩码。换句话说,脱敏的粒度不应该写在后端代码里写死,而应该跟着"谁来调"走。
这正是内部数据泄露防范里最容易被忽视的环节。绝大多数企业的注意力放在"防外部黑客"上,却忽略了数据通过授权 API 流出之后,调用方拿到的是不是一份"刚好够用"的数据。一条完整的明文手机号,经由一个合规的合作方,再辗转流入黑产链条,溯源和责任划分都极其困难。
二、既有脱敏思路在 API 共享场景的短板
在落地字段级动态脱敏网关之前,先把常见的三类既有方案摆出来,看看它们在"按调用方身份差异化脱敏"这件事上为什么难以胜任。
2.1 后端代码硬编码脱敏
最直观的做法,是在每个对外接口的业务代码里加上脱敏逻辑,判断调用方角色再对敏感字段做掩码。这种方法初期见效快,但有三个结构性问题。第一,脱敏逻辑散落在几十上百个接口里,规则一变就要全量回归。第二,脱敏与业务耦合,安全策略无法独立审计,安全团队只能翻代码。第三,也是最致命的,它假设后端工程师永远记得脱敏;任何新接口漏写一行脱敏,就是一条明文泄露通道,这种靠自觉的机制在接口数量膨胀后会迅速失效。
2.2 静态脱敏导出
另一种思路是静态脱敏——把生产库的数据抽出、脱敏后落到一张供外部使用的镜像表里,这在报表、测试数据等离线场景很成熟,但对实时 API 共享几乎不可用。实时 API 要求"调一次、查一次、脱敏一次",数据是活的;静态脱敏导出是"定时批处理",数据有滞后,镜像表本身又是一份需被保护的数据副本,反而扩大存储面,更无法表达"同一字段对不同调用方不同处理"的语义。
2.3 统一网关只做鉴权不做字段级脱敏
很多企业的 API 网关把鉴权、限流、路由做得很好,但它只决定"你有没有资格调这个接口",不决定"返回给你的字段该脱敏到什么程度"。把字段级脱敏塞进 API 网关,又会让网关变得臃肿,并且网关离数据库远,只能做响应层的字符串替换,容易误伤、也容易被绕过。
三、字段级动态脱敏网关的架构定位
字段级动态脱敏网关的核心定位,是做"应用与数据库之间的透明代理"。它不碰业务代码,也不碰 API 网关的路由职责,而是安静地坐在数据库前面,拦截所有进出数据库的 SQL,在结果返回给应用的瞬间,根据策略对敏感字段做脱敏或保留格式加密后再放行。
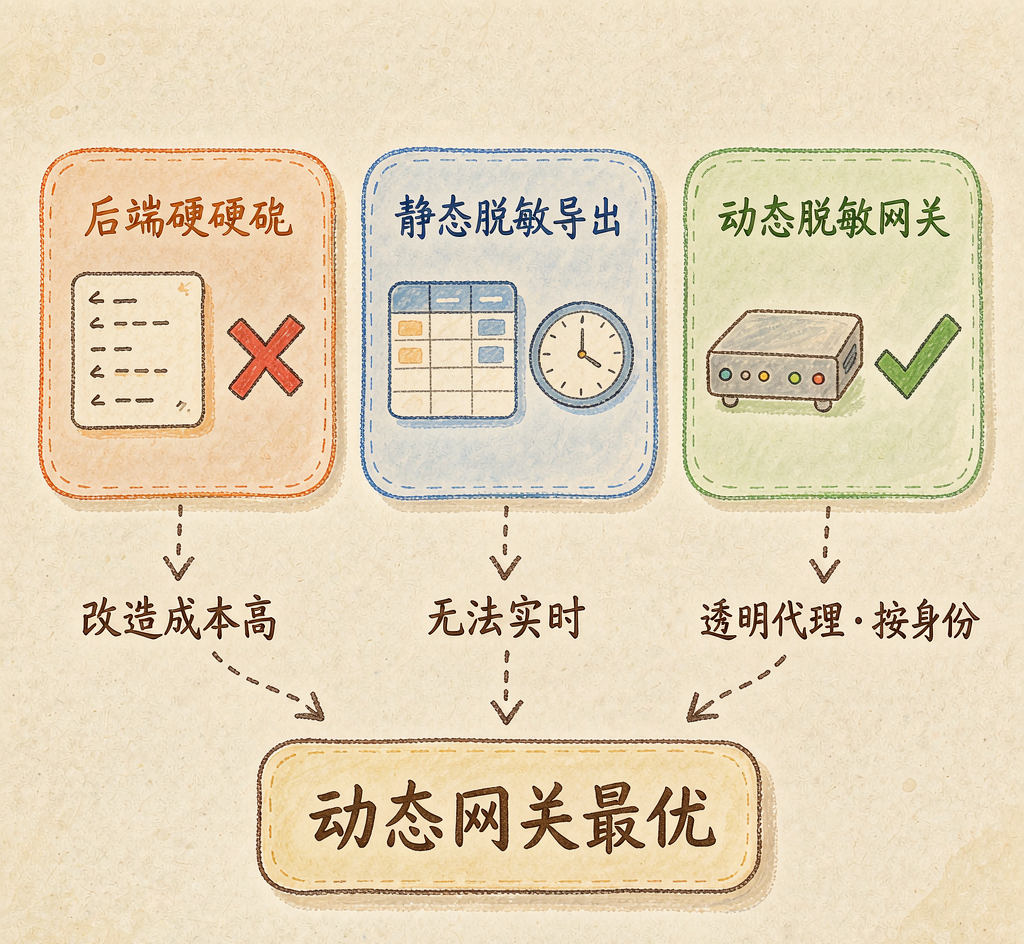
字段级动态脱敏网关作为透明代理的架构定位
它的几个关键特征,正好对应前面三类方案的短板:
- 应用零改造:后端代码完全不用改,脱敏发生在数据库访问层,对应用透明。新增接口自动纳入管控,不会漏。
- 字段级、动态:脱敏粒度到列,且每次请求都可能不同——取决于这次请求"是谁、用什么身份发出来的"。
- 策略集中:所有脱敏规则在一个地方定义和审计,安全团队看得清、改得动。
- 可审计:每一条被拦截或脱敏的 SQL 都有迹可循,能按调用方维度回溯。
在这种架构下,一个典型的对外 API 调用链变成了这样:调用方带着身份凭证请求 API;网关鉴权后把请求交给后端;后端照常拼 SQL 去查库;SQL 经过脱敏网关时,网关识别调用方身份、匹配脱敏策略,对结果集里的敏感字段做处理,再把"降级后"的数据还给后端,最终经 API 返回。后端全程无感知,调用方拿到的就是"刚好够用"的那份数据。
四、按调用方身份做动态脱敏的核心机制
要做到"同一个接口、不同调用方看到不同数据",网关必须解决三个问题:身份从哪来、策略怎么匹配、脱敏动作怎么做。
4.1 调用方身份从哪儿来
在 API 共享场景里,调用方身份通常不会直接出现在 SQL 里。它由上游的 API 网关或后端在建立数据库连接时,通过一个"应用标识"带下来。常见承载方式有:后端使用不同数据库账号对接不同合作方;后端在连接里带上一个应用标签;多租户架构下连接携带租户 ID。关键是网关必须能稳定、可靠地拿到这个身份上下文,而不是依赖调用方"自觉"声明。一旦身份确定,后续该连接上的 SQL 都绑定这个身份,做到"一次识别、全程有效"。
4.2 策略匹配与字段级动作
身份识别之后,网关拿它去匹配一张脱敏策略表。策略表的核心维度是"身份 + 表 + 字段 + 动作"。动作通常有四类:
动作类型 | 含义 | 适用场景 |
|---|---|---|
明文放行 | 原样返回 | 调用方被授权查看完整字段 |
掩码 | 部分字符替换为固定符号 | 手机号、姓名、地址 |
保留格式加密(FPE) | 加密后仍是同格式字符串 | 需要回查、关联的字段 |
置空/拒绝 | 返回空或拦截该列 | 完全无权的调用方 |
举一个具体例子:用户表有手机号、身份证号、真实姓名三个敏感字段,策略可能是——自家 App 全部明文放行;物流合作方手机号掩码、身份证号掩码、真实姓名明文;第三方营销应用手机号保留格式加密、身份证号置空、真实姓名掩码。同一条查询语句,三个身份拿到三份完全不同的结果,而后端代码一行没改。
4.3 保留格式加密支撑关联查询
掩码适合"看了就完"的展示场景,但 API 共享里经常有"我脱敏了,但后端还要拿它做关联比对"的需求。比如风控合作方要拿手机号去撞库校验,又不能拿到明文,这时就需要保留格式加密(FPE)。FPE 的妙处在于加密后的字符串和原文长度、字符集一致(11 位手机号加密后还是 11 位数字),脱敏后的字段依然可以参与前缀匹配、等值比较,调用方拿密文去比对,既完成了校验,又始终接触不到明文。
五、落地:把脱敏网关挂到 API 链路里
理论讲完,落到工程上最关心三件事:怎么部署、怎么和现有开放平台衔接、性能扛不扛得住。
5.1 部署形态
脱敏网关作为数据库前面的代理,常见两种挂法。一种是透明代理模式:把数据库的连接地址换成网关地址,应用侧只改连接串,不改任何代码,上线成本最低。另一种是旁路监听模式:网关镜像数据库流量做审计与记录,对生产侵入小,但实时性和强制力不如透明代理,更适合先做观测、再逐步接管。对于 API 开放这种"强管控、强合规"的场景,一般推荐透明代理模式。
5.2 与开放平台衔接
开放平台通常已经有了应用管理、密钥管理、权限审批这套体系。脱敏网关不需要重造轮子,它的身份识别直接复用开放平台下发的应用标识即可:开放平台为每个合作应用签发身份凭证 → 后端用该凭证对应的数据库连接去访问数据 → 网关读连接上的身份 → 匹配脱敏策略。这里有个实践要点:身份粒度要和开放平台的"应用/权限包"对齐,而不是和"自然人"对齐。
5.3 性能与损耗
对外 API 通常有明确的 SLA,网关不能成为瓶颈。以实际落地数据看,这类字段级脱敏网关在单节点上可支撑 3 万以上的每秒查询数(QPS),对业务整体的性能损耗约 5% 到 10%。这个量级对绝大多数企业的 API 吞吐够用——脱敏动作主要是字符串处理和格式变换,计算开销有限,瓶颈更多在数据库本身。损耗和脱敏字段数量、动作复杂度正相关:掩码最轻,FPE 因涉及加解密略重。设计策略应遵循"最小必要"原则,只对真正敏感的字段、只对真正无权的调用方施加重动作。
六、调用方身份策略如何设计
策略设计是整个方案里最体现"安全治理水平"的部分。下面给一套可落地的设计范式,以及一个配置样例。
策略设计遵循三条原则:
- 默认拒绝:任何未在策略表中明示放行的字段,对外部调用方一律脱敏或置空。
- 按权限包分级:开放平台给合作方发的权限包,直接映射成脱敏等级。
- 字段分类先行:先把库里的字段做敏感等级分类(PII、SPI、普通),再对每一类字段定义各等级身份的动作。
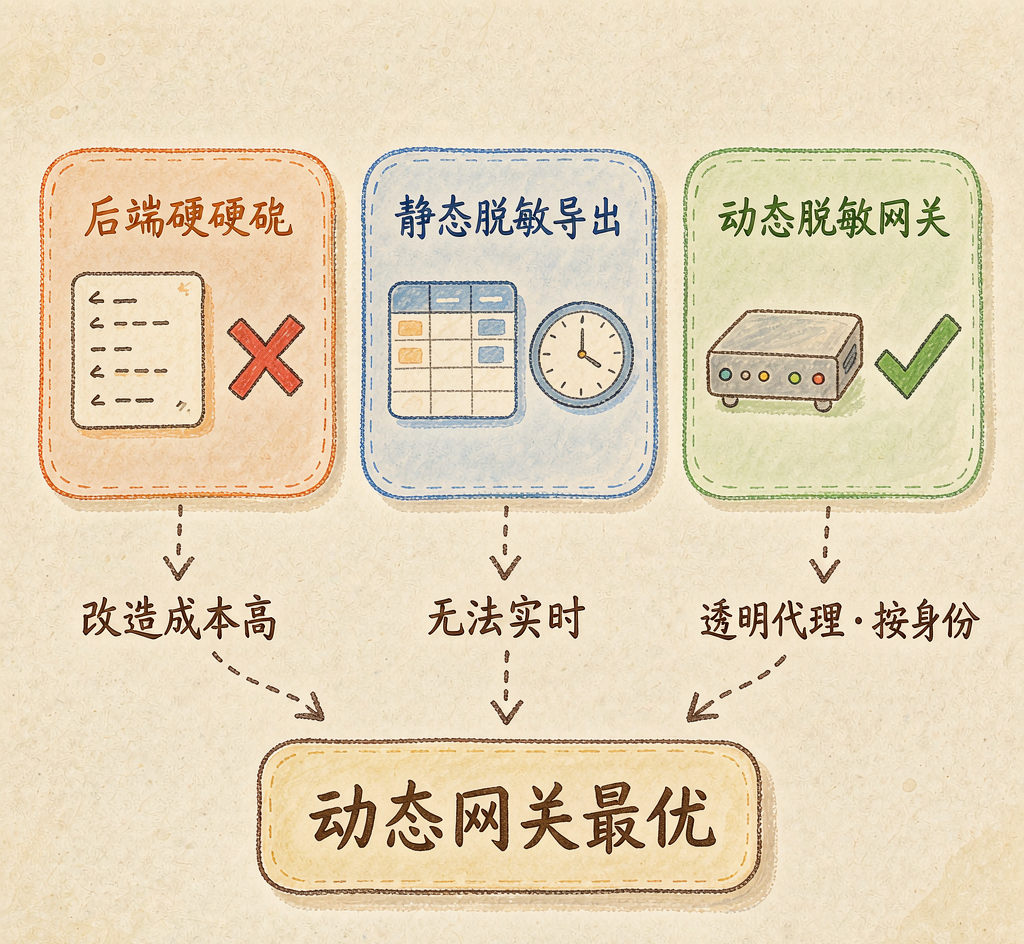
以调用方身份为维度的脱敏策略配置示意
下面是一个脱敏策略的 YAML 配置示例,表达"不同应用对用户表字段的不同处理":
# 脱敏策略:以调用方身份(application)为维度
applications:
  - id: self_app            # 自家 App,完全可信
    table_rules:
      - table: user
        columns:
          phone: clear        # 明文放行
          id_card: clear
          real_name: clear

  - id: logistics_partner   # 物流合作方
    table_rules:
      - table: user
        columns:
          phone: mask_tail4   # 保留后四位,其余掩码
          id_card: mask_mid   # 中间掩码
          real_name: clear

  - id: marketing_app       # 第三方营销应用
    table_rules:
      - table: user
        columns:
          phone: fpe          # 保留格式加密
          id_card: drop        # 置空
          real_name: mask_mid
这段配置落到网关后,网关在解析 SQL 结果集时,会按当前连接的应用标识,自动对相应列施加对应动作。后端完全不知道这些规则的存在。
七、审计:SQL 级到调用方维度的全量留痕
脱敏网关另一个不可替代的价值,是审计。它天然处在所有数据库访问的必经之路上,因此能做到 SQL 级拦截与全量审计。审计要回答的问题是:"哪个调用方、在什么时间、用什么身份、查了哪张表的哪个字段、最终拿到脱敏后的还是明文的数据"。这条记录一旦完整留存,至少有三重用途:
- 合规举证:监管或审计方来查时,能证明"对外提供的数据都做了恰当脱敏",而非口头说明。
- 异常发现:某个低权限应用突然高频查询高敏字段,即便拿到的都是脱敏数据,这种行为本身也值得风控关注。
- 策略复盘:哪些字段被哪些应用长期访问、访问量如何,是后续收紧或放开策略的依据。
审计日志的关键字段应当包含:时间戳、调用方身份、源 IP、数据库账号、原始 SQL、命中的脱敏策略、实际返回动作、受影响行数。把这些落到一个独立、防篡改的存储里,才能成为真正的凭证。
八、密钥与双层存储的配合
字段级脱敏和加密离不开密钥管理。在涉及保留格式加密(FPE)的场景,加密密钥必须由独立的密钥管理模块统一托管,而非硬编码在网关配置里,密钥的轮换、分发、销毁都应当走专门的密钥生命周期流程。
另外,脱敏网关和数据库自身的透明数据加密(TDE)是互补而非替代的关系:TDE 解决"磁盘落库文件被拷走也读不出"的静态存储加密问题,脱敏网关解决"运行态查询时按身份给出不同视图"的动态访问控制问题。两者叠加构成"存储加密 + 动态脱敏"的双层防护——即便绕过应用直接拿到数据库文件,有 TDE 兜底;即便通过应用查询,有网关按身份脱敏。
方案参考
面向 API 开放与对外数据共享场景,构建字段级动态脱敏网关的通用落地路径可归纳为五步:第一步做数据源字段分类分级,明确哪些字段属于 PII/SPI 并标注敏感等级;第二步定义以调用方身份(应用/权限包)为维度的脱敏策略,遵循默认拒绝与最小必要原则;第三步将网关以透明代理方式部署在应用与数据库之间,复用开放平台已有的身份凭证实现零改造接入;第四步对涉及关联比对的字段采用保留格式加密,兼顾脱敏与可用性;第五步开启 SQL 级拦截与按调用方维度的全量审计,并把加密密钥交由独立密钥管理模块托管,同时与数据库透明数据加密形成存储与访问的双层防护。实施顺序上,建议先以观测模式验证策略完整性,再切换为强制脱敏,并对含加解密与范围查询的真实混合流量做性能压测,确保损耗落在业务可接受区间。通过安当 DBG 这类数据库加密网关,企业能够在不改动后端代码的前提下,把"按调用方身份差异化脱敏"真正落到每一次对外 API 调用的返回结果里。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号