#WorkBuddy# 82,793 个公式里藏着 1,680 个循环引用:我用“引用解析 + Tarjan 建图”做到环召回 100%
原创
#WorkBuddy# 82,793 个公式里藏着 1,680 个循环引用:我用“引用解析 + Tarjan 建图”做到环召回 100%
原创
用户12784192
发布于 2026-10-19 08:04:03
发布于 2026-10-19 08:04:03
#WorkBuddy# 82,793 个公式里藏着 1,680 个循环引用:我用“引用解析 + Tarjan 建图”做到环召回 100%
一、痛点开场:你敢说清一本工作簿里“谁依赖谁”吗
接手别人留下的一堆 Excel,最怕的不是数据脏,而是公式乱:一个单元格的值可能来自本表上一行、隔壁工作表、某个叫“单价”的命名区域,甚至另一份工作簿。更糟的是总有人手滑写出循环引用——Excel 只在状态栏给你一句“循环引用: 某某!某单元格”,其余一概不提。
我常见到三种翻车姿势:
- 正则一把梭:
[A-Z]+\d+扫一遍公式字符串就当解析完了。结果$A$1匹配不到,'明细 1'!A1的表名被扔掉,SUM(A1:A10)里的坐标被当成“本表坐标”。 - 只查自环:写个脚本判断“单元格引用了自己”。真正的循环引用往往是 A 依赖 B、B 又依赖 A,甚至五六个单元格隔着几张表转一圈。
- 按表顺序重算:想用脚本离线重算一遍数,结果发现主表引用了排在后面的“汇总”表,算出来一半是空值。
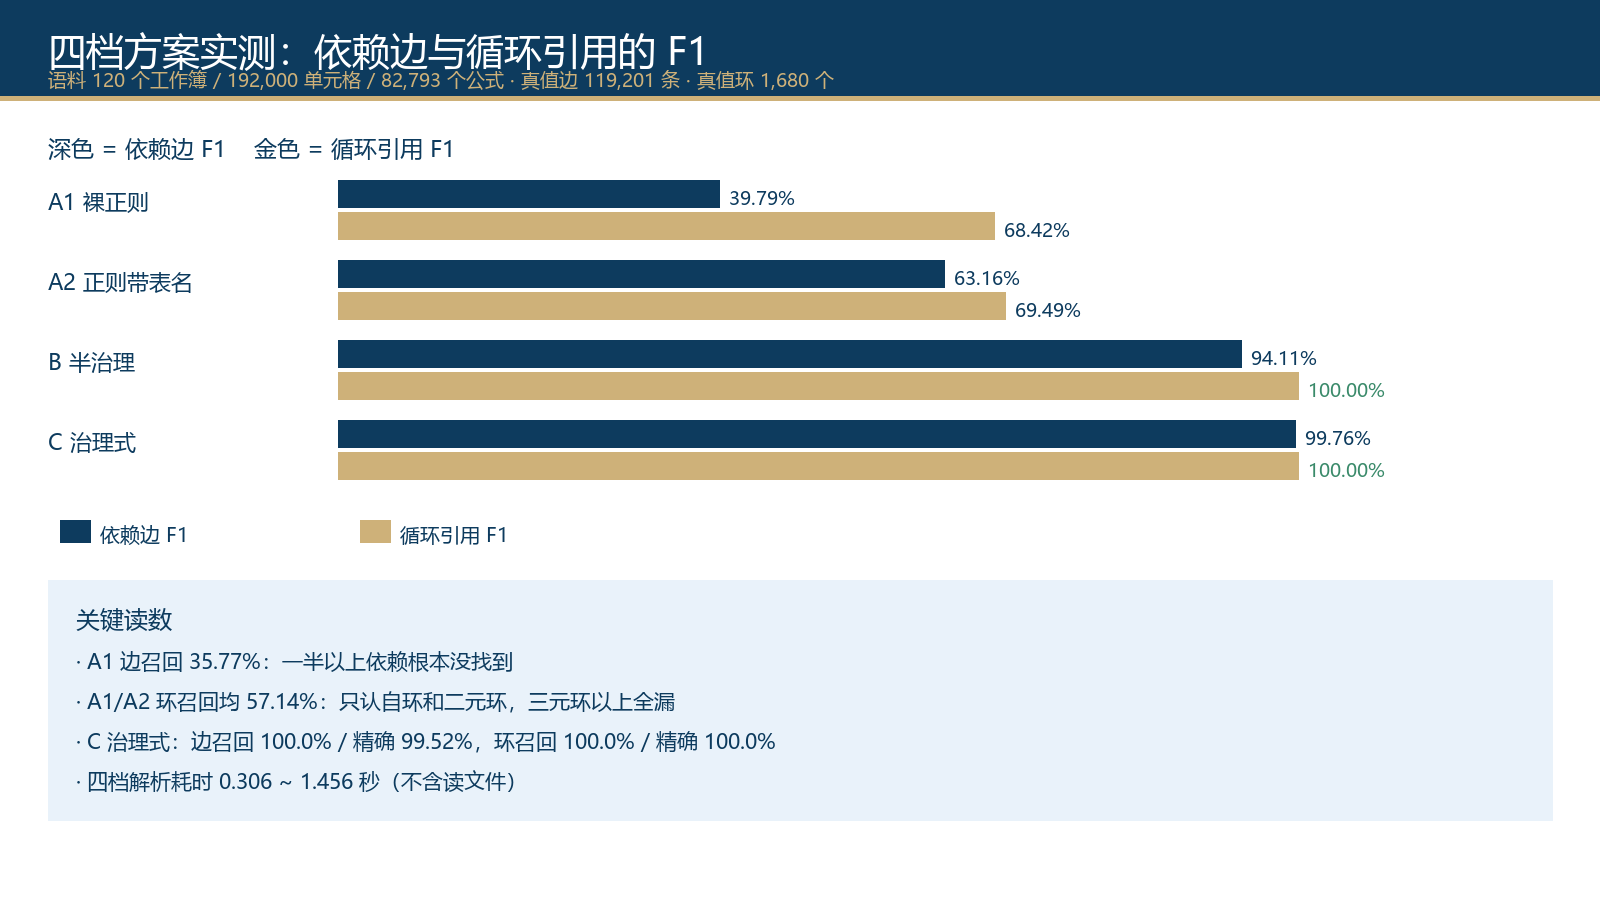
这些问题的根子是同一个:没有把公式翻译成依赖图。有了图,循环引用就是强连通分量(SCC),重算顺序就是拓扑排序,风险清单就是图的属性统计。这次我把四种做法放在同一份语料上跑了对比,用真值说话。
二、根因分析:公式引用远不止 A1 这一种形态
手工解析 Excel 公式,至少要处理六类引用,任何一类漏掉都会让依赖图失真:
引用形态 | 例 | 常见坑 |
|---|---|---|
同表相对引用 |
| 基本都能抓到 |
绝对引用 |
| 正则里没考虑 |
跨表引用 |
| 表名含空格必须带单引号;正则常把表名丢掉 |
区域引用 |
| 只抓到起点,或把两个端点判成本表 |
命名区域 |
| 没有坐标,正则完全失效,必须查 defined_names |
外部链接 |
| 中括号语法,绝大多数脚本当普通文本 |
再加上三类“动态引用”(INDIRECT、OFFSET、NOW/RAND 等易失函数),引用边在语法层面根本写死不出来,只能标记为风险项单独报。
而循环引用在图论里的正确定义是强连通分量:大小大于 1 的 SCC,或带自环的单节点 SCC。所以正确路线是三步:
- 解析:逐单元格读公式字符串,解析出全部引用目标(带表名、绝对符号、区域端点、命名区域);
- 建图:
源单元格 → 被引用单元格作为有向边; - 判定:Tarjan 求 SCC 找环;剔除环后 Kahn 拓扑排序给出重算顺序;顺带把外部链接、易失函数、失效引用、空引用归入风险清单。
三、真实数据对比:四档方案的差距有多大
为了让每个数字可核对,我用程序合成了 120 个工作簿(与任何真实业务无关):480 张工作表、192,000 个单元格、82,793 个公式,其中按规则埋入六类引用共 119,201 条依赖边(去重后真值),以及1,680 个循环引用——自环、二元环、三元环各 480 个,另有 480 个跨 3 张表、长度 4~6 的长环;再埋入外部链接、易失函数、失效引用、空引用各 480 处。每个注入点都登记进真值清单,评测时逐条比对。
四档方案:
- A1 裸正则:
\b[A-Z]{1,3}\d{1,7}\b抓坐标,全部当作本表引用,只查自环和互相引用对; - A2 正则带表名:支持
表名!坐标,但不支持带引号的表名、命名区域、外部链接; - B 半治理:完整解析(引号表名、绝对引用、区域端点),但不处理命名区域/外部链接/动态引用;
- C 治理式:完整解析 + 命名区域解析 + 外部链接/动态引用标记 + Tarjan + 拓扑重算。
实测结果(解析耗时不含读文件;120 个工作簿加载 1.89 秒):
方案 | 依赖边 P / R / F1 | 循环引用 P / R / F1 | 耗时 |
|---|---|---|---|
A1 裸正则 | 44.82% / 35.77% / 39.79% | 85.26% / 57.14% / 68.42% | 0.31 s |
A2 正则带表名 | 66.45% / 60.18% / 63.16% | 88.64% / 57.14% / 69.49% | 0.41 s |
B 半治理 | 99.46% / 89.30% / 94.11% | 100.0% / 100.0% / 100.0% | 0.88 s |
C 治理式 | 99.52% / 100.0% / 99.76% | 100.0% / 100.0% / 100.0% | 1.46 s |
分形态召回率更能说明问题:
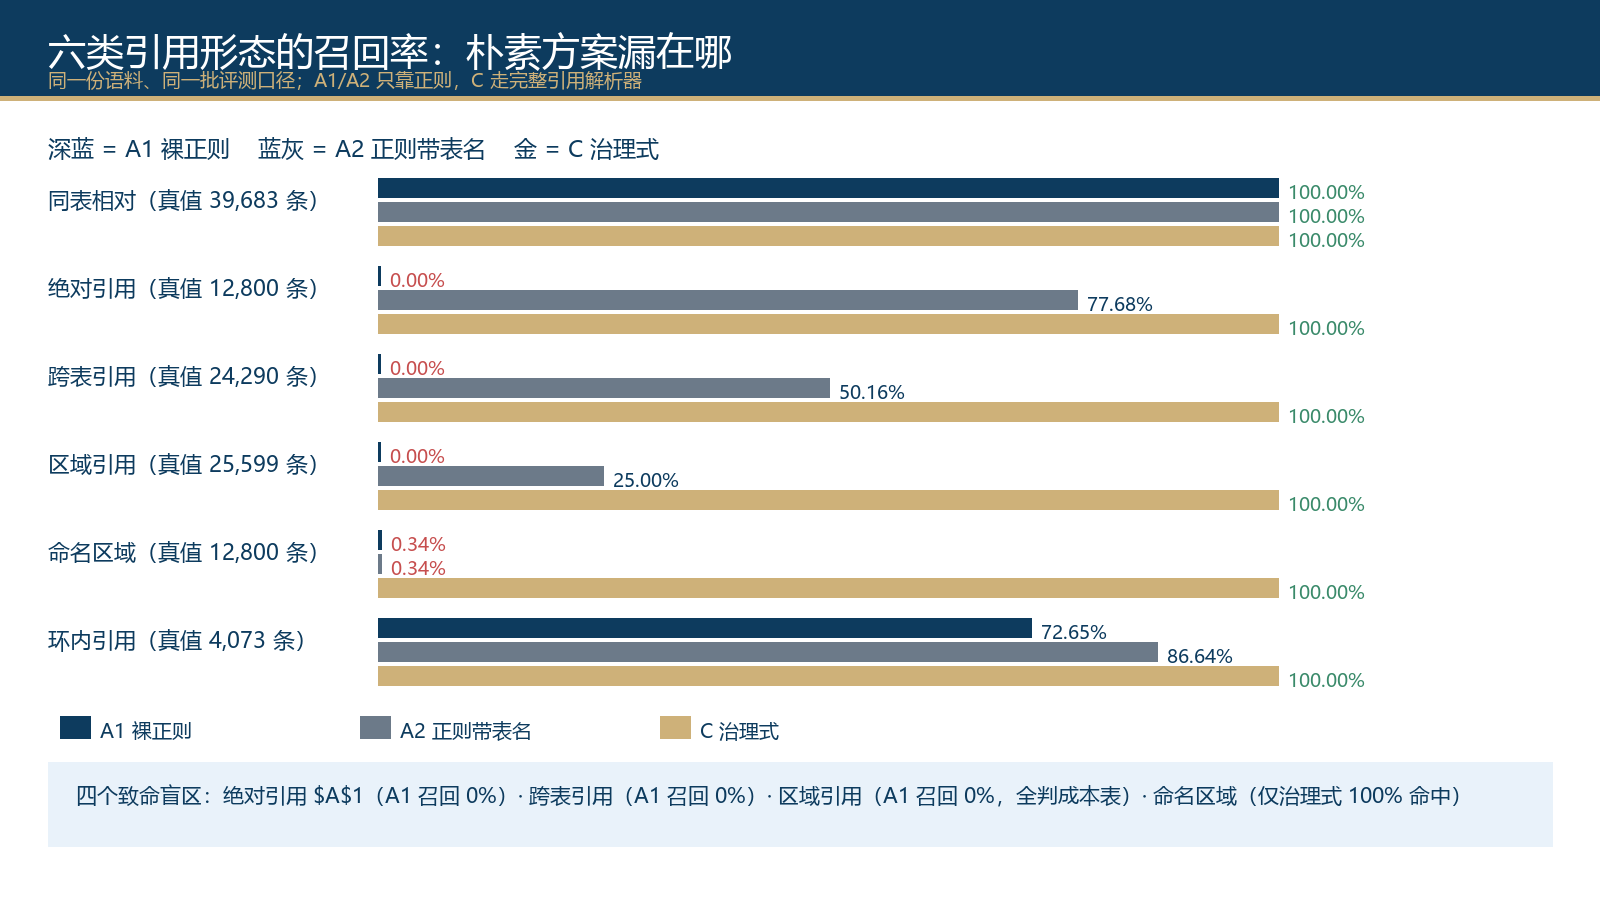
引用形态 | 真值条数 | A1 | A2 | C |
|---|---|---|---|---|
同表相对 | 39,683 | 100% | 100% | 100% |
绝对引用 | 12,800 | 0% | 77.68% | 100% |
跨表引用 | 24,290 | 0% | 50.16% | 100% |
区域引用 | 25,599 | 0% | 25.00% | 100% |
命名区域 | 12,800 | 0.34% | 0.34% | 100% |
环内引用 | 4,073 | 72.65% | 86.64% | 100% |
注意 A1 的三列 0% 不是“没找到”,而是找错了:它把跨表引用、区域端点、外部链接里的坐标一律当成“本表同坐标”,产生的是有方向的错边,后续无论是查环还是重算都会被带偏。
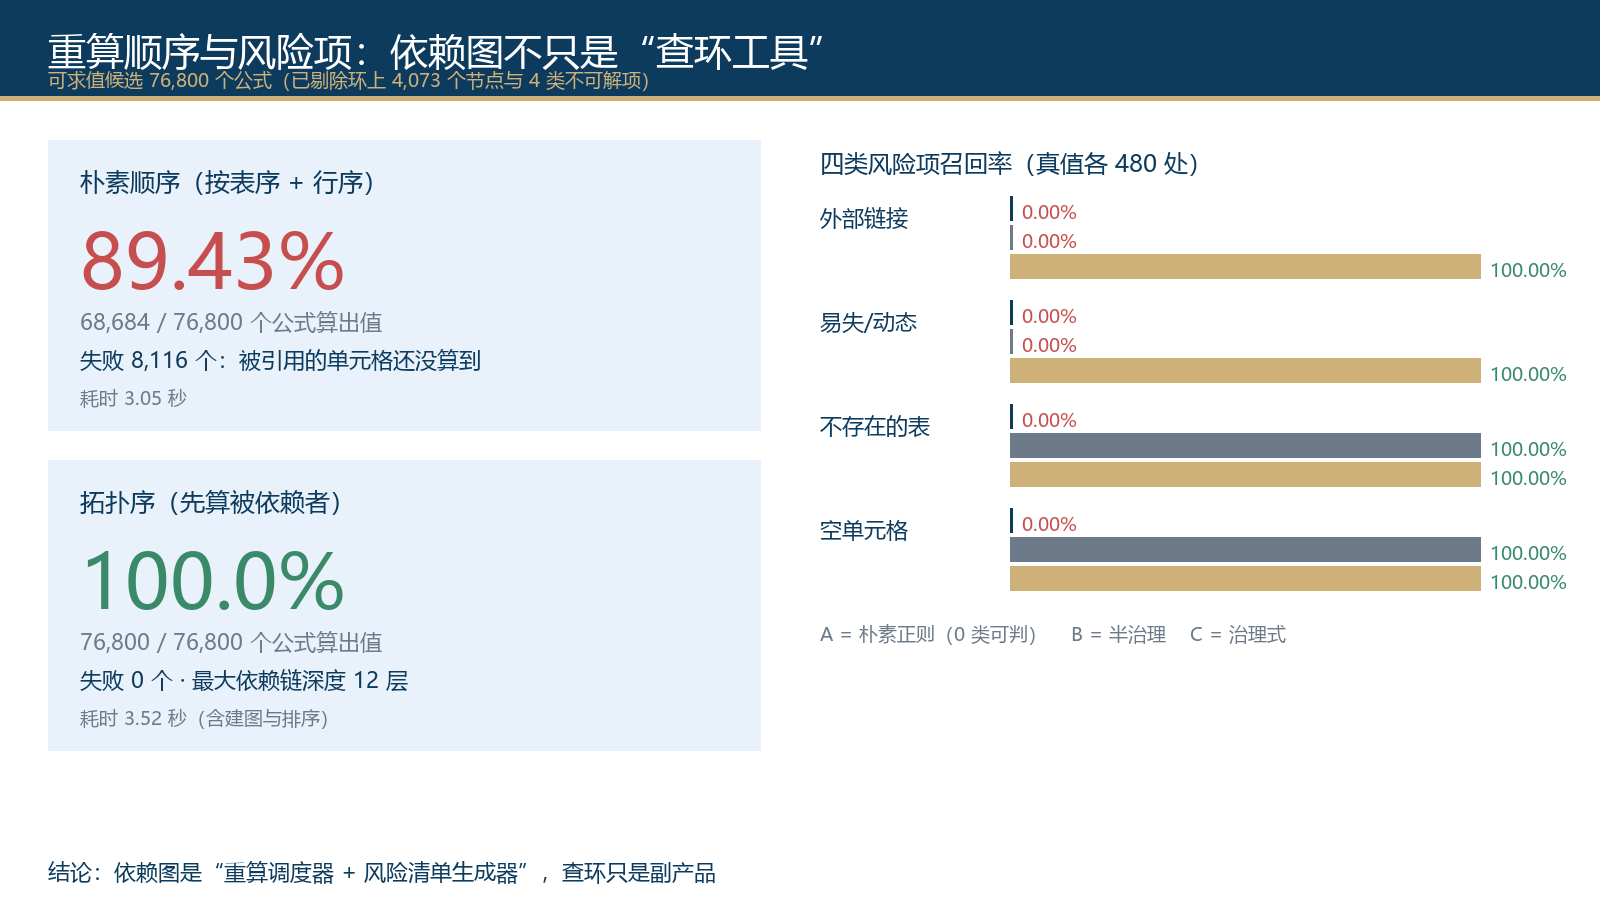
四类风险项(真值各 480 处)的召回:外部链接和易失/动态引用,A1、A2、B 全是 0%,只有 C 到 100%;失效引用和空引用,B 和 C 都能 100%,因为它们在解析阶段就能通过“表名是否存在、目标单元格是否为空”判出来。
四、重算顺序:依赖图真正的杀手级用法
查到环只是及格线。我给每份工作簿做了一次离线重算实验:把环上的 4,073 个节点剔除后,剩余 76,800 个可求值公式,用同一个迷你求值器(支持四则运算、SUM/AVERAGE/MAX/MIN/COUNT、跨表、区域、命名区域)跑两种顺序:
重算顺序 | 成功求值 | 失败 | 耗时 |
|---|---|---|---|
朴素顺序(按工作表顺序 + 行序) | 68,684(89.43%) | 8,116 | 3.05 s |
拓扑序(先算被依赖者) | 76,800(100.00%) | 0 | 3.52 s |
朴素顺序失败的 8,116 个公式,全部是“被引用的单元格还没轮到算”——跨表引用指向排在后面的工作表时必挂。拓扑序多花的 0.47 秒,换来的是零失败和一条清晰的“第 1 层算什么、第 2 层算什么”的调度计划(本次语料最大依赖链深度 12 层)。
五、可复制的核心代码
完整解析器 + Tarjan + 拓扑排序的骨架如下(openpyxl 3.1 实测):
import re
from collections import defaultdict, deque

STR = re.compile(r'"[^"]*"')   # 先挖掉字符串字面量,防止干扰
REF = re.compile(
    r"(?:(?:'(?P<qs>(?:\[[^\]]+\])?[^']+)'|(?P<us>[^\s!(),;+\-*/=<>&\"']+))!)?"
    r"(?P<c1>\$?[A-Z]{1,3}\$?\d{1,7})(?::(?P<c2>\$?[A-Z]{1,3}\$?\d{1,7}))?")

def parse_formula(f, cur_sheet, sheet_names, dn_map):
    """返回 (边集合, 风险集合)。edge: (源, 目标);risk: 外部/动态/坏表/空引用"""
    edges, risk, body = set(), set(), STR.sub('""', f)
    for m in REF.finditer(body):
        sh = m.group("qs") or m.group("us") or cur_sheet
        if sh.startswith("["):
            risk.add("ext"); continue                     # 外部链接
        if sh not in sheet_names:
            risk.add("bad"); continue                     # 引用不存在的表
        for ck in ("c1", "c2"):
            raw = m.group(ck)
            if raw:
                co = raw.replace("$", "")
                edges.add((cur_sheet, f"{sh}!{co}"))
                if sheet_names[sh].get(co) is None:
                    risk.add("empty")                     # 引用空单元格
    for dn in dn_map:                                     # 命名区域
        if re.search(r"(?<![A-Za-z0-9_])" + re.escape(dn) + r"(?![A-Za-z0-9_])", body):
            sh, co = dn_map[dn]
            edges.add((cur_sheet, f"{sh}!{co}"))
    if re.search(r"\b(INDIRECT|OFFSET|NOW|RAND|TODAY)\b", body, re.I):
        risk.add("dyn")                                   # 动态/易失引用
    return edges, risk

def tarjan_scc(edges):
    """迭代式 Tarjan:返回 size>1 或带自环的强连通分量"""
    adj, nodes = defaultdict(set), set()
    for u, v in edges:
        adj[u].add(v); nodes |= {u, v}
    idx, low, on, stk, out, cnt = {}, {}, {}, [], [], [0]
    for s in nodes:
        if s in idx:
            continue
        idx[s] = low[s] = cnt[0]; cnt[0] += 1
        stk.append(s); on[s] = True
        work = [(s, iter(adj[s]))]
        while work:
            n, it = work[-1]
            pushed = False
            for w in it:
                if w not in idx:
                    idx[w] = low[w] = cnt[0]; cnt[0] += 1
                    stk.append(w); on[w] = True
                    work.append((w, iter(adj[w]))); pushed = True; break
                elif on.get(w):
                    low[n] = min(low[n], idx[w])
            if pushed:
                continue
            work.pop()
            if work:
                low[work[-1][0]] = min(low[work[-1][0]], low[n])
            if low[n] == idx[n]:
                comp = set()
                while True:
                    w = stk.pop(); on[w] = False; comp.add(w)
                    if w == n:
                        break
                if len(comp) > 1 or n in adj[n]:
                    out.append(comp)
    return out

def topo_order(edges, nodes):
    """Kahn:依赖者优先(先算被依赖者)"""
    adj, indeg = defaultdict(set), defaultdict(int)
    for u, v in edges:
        if v not in adj[u]:
            adj[u].add(v); indeg[v] += 1
    rev = defaultdict(set)
    for u in adj:
        for v in adj[u]:
            rev[v].add(u)
    depend = {n: len(adj[n]) for n in nodes}
    q = deque(sorted(n for n in nodes if depend[n] == 0))
    order = []
    while q:
        n = q.popleft(); order.append(n)
        for u in sorted(rev.get(n, ())):
            depend[u] -= 1
            if depend[u] == 0:
                q.append(u)
    return order
三个实现要点:
- 先挖字符串字面量再匹配。公式里的
"A"&1会被正则误伤,先替换成空串。 - Tarjan 必须用迭代版。Python 默认递归深度 1000,依赖链一长就爆栈,本次语料最深 12 层还没事,但真实工作簿见过 40 层的。
- Kahn 方向别搞反。边是“源 → 被引用者”,所以要先算出度为 0 的节点(没有依赖的),再逐层解锁依赖它们的节点。方向搞反会得到一条几乎全部逆序的“伪拓扑序”,重算失败率反而更高——这个坑我自己踩过。
六、踩坑清单
- 表名含空格必须带单引号:
'明细 1'!A1是合法语法,明细 1!A1不是。解析器要同时支持带引号和不带引号两种写法。 - 字符串字面量先挖后匹配:
INDIRECT("A"&1)里的"A"会干扰坐标正则。 - 区域引用是两条边:
SUM(A1:A5)至少连 A1 和 A5 两个端点(中间格按需展开),只连起点会让重算漏算。 - 命名区域要查
defined_names:它没有坐标形态,必须在公式文本里按词边界匹配名字,再解析attr_text里的真实指向。 - 外部链接和坏表是两回事:
[外部.xlsx]Sheet1是跨工作簿引用(风险),'不存在表'!A1是失效引用(错误),要分开报。 - 防环检查的坐标别偷懒:我在合成语料时一度用“表名+行号”当节点 ID,漏了列号,可达性检查形同虚设,跑出 2 个假环。节点 ID 必须是完整的
工作簿|表|坐标。 - 评测口径要带真值:没有逐条登记的边清单和环清单,"99% 还是 36%" 全凭一张嘴。
七、给 WorkBuddy 的提示词模板
把下面这段直接发给 WorkBuddy,就能对指定目录里的全部工作簿跑一遍体检(路径替换成你自己的):
# 任务:Excel 公式依赖与循环引用体检
# 语料目录:<你的目录>,输出目录:<你的输出>
# 步骤:
# 1. 用 openpyxl(data_only=False) 遍历目录下全部 .xlsx,
#    抽出所有以 = 开头的字符串单元格作为公式清单;
# 2. 按"引用解析 + Tarjan SCC"方案建依赖图,节点 ID 用 工作簿|表名|坐标;
# 3. 输出四份产物:
#    a) 循环引用清单:每个 SCC 一行,含节点数、涉及工作表、单元格坐标;
#    b) 风险清单:外部链接 / INDIRECT·OFFSET·易失函数 / 引用不存在的表 / 引用空单元格;
#    c) 重算顺序:剔除环后 Kahn 拓扑序,按层输出(第 1 层 = 无依赖公式);
#    d) 汇总统计:公式总数、依赖边数、环数、最大依赖深度、各风险项计数;
# 4. 先跑一遍"朴素表序"和"拓扑序"的离线重算对比,把两个成功率和耗时写进汇总;
# 5. 全部结果落成 CSV + 一份 Markdown 报告,报告里每个数字都要能追溯到明细行。
# 硬性要求:不得改动原文件;解析失败的公式单独列出来,不许静默跳过。
八、收尾
回到开头那三个翻车姿势,现在都有了确定性的答案:
- 依赖关系不全 → 六类引用形态 + 命名区域 + 外部链接全覆盖解析,本次 119,201 条真值边召回 100%;
- 循环引用查不干净 → 环不是“自引用”,是强连通分量,1,680 个真值环(含 480 个跨表长环)全数命中,零误报;
- 重算顺序靠猜 → 拓扑序 76,800 个公式零失败,比朴素顺序多救回 8,116 个算不出的单元格。
0.31 秒的正则和 1.46 秒的完整解析,差的那 1 秒买回来的是:每一个数字都知道自己从哪来、坏了会波及谁、按什么顺序算才不会白算。这才是“体检”两个字在公式世界里应有的分量。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号