WorkBuddy 三档模式的积分消耗比较与选型参考
原创
WorkBuddy 三档模式的积分消耗比较与选型参考
原创
用户12771112
发布于 2026-10-19 11:11:38
发布于 2026-10-19 11:11:38
——基于 2026 年 10 月客户端实际配置的量化分析
数据口径:三档系数与各模型倍率取自 WorkBuddy 客户端 2026 年 10 月 19 日实际下发的产品配置文件;三档定义见官方文档《模型配置》,套餐额度见《定价详情》。文中“单次积分”按“1 倍率 ≈ 1 积分/千 token”折算,为便于横向比较的估算值,不等同于账单原值,但各选项之间的比例关系与官方系数一致。
一、先弄清计费结构:档位与模型是并列的两层,不叠加
WorkBuddy 的积分按 token 用量与所调模型的单价计算,不按次数包干。模型选择器提供两套并列入口:顶部是三档通用模式——快速、均衡、极致,由系统在底层模型池中自动调度;下方是可手动指定的内置模型。两者是“选一个”的关系,不存在档位系数再乘模型倍率的叠加:选中项自带的系数就是最终扣费系数。本机配置显示,三档系数分别为 0.21、0.65、1.20;内置模型倍率自 0.00(Hy3、Step-5-Preview 两款免费模型)至 1.62(Kimi-K3)不等,首尾相差约 27 倍。
为使比较可度量,本文设定“标准任务”作为计量单位:单次请求输入约 3 万 token(含历史上下文与检索材料)、输出约 2 千 token,合计 3.2 万 token,单次积分 ≈ 倍率 × 32。另需强调:账单波动最大的变量往往不是档位,而是上下文长度——默认 200K 窗口、开启 Max 模式、在同一窗口反复追问,都会让每轮输入成倍放大,其影响足以抵消任何一次“省档”操作。
二、三档模式:0.21 / 0.65 / 1.20
模式 | 系数 | 相对快速 | 单次积分(估算) | 4000 积分可跑次数 | 官方定位 |
|---|---|---|---|---|---|
快速 | ×0.21 | 1.00 | 6.7 | 约 595 次 | 简单明确的小任务,响应最快 |
均衡 | ×0.65 | 3.10 | 20.8 | 约 192 次 | 绝大多数日常任务,速度与质量兼顾 |
极致 | ×1.20 | 5.71 | 38.4 | 约 104 次 | 复杂任务,结果更稳定深入 |
表 1 三档模式积分总览(按标准任务 3.2 万 token 折算;“4000 积分”为标准版每月实得额度)
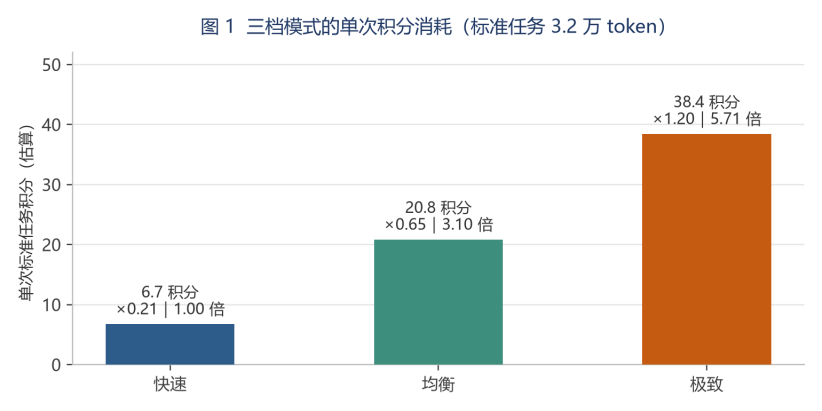
图 1 三档模式单次积分消耗对比
三档的间距并不均匀:均衡相对快速为 3.10 倍,极致相对均衡仅 1.85 倍。这意味着从快速升到均衡的代价最大,而从均衡升到极致的边际成本反而较低。选择策略因此明确:快速档只留给真正轻的任务;任务一旦需要完整结构、多步推理或跨文件操作,直接用均衡;需要反复核对、一次成型的高要求产出时,均衡升极致的 1.85 倍通常物有所值。按加量包 1000 积分 50 元折算,三档单次标准任务成本约 0.34 元、1.03 元、1.92 元。
三、内置模型:三条价格带,首尾相差 27 倍
模型 | 倍率 | 单次积分(估算) | 定位与代表用途 |
|---|---|---|---|
GLM-5.3-Flash | ×0.06 | 1.9 | 旗舰快速版,短问答与摘要 |
Space-Bunny | ×0.08 | 2.6 | 匿名快模型,编码与多模态输入 |
DeepSeek-V4.1-Flash | ×0.11 | 3.5 | 1M 上下文,长文档速读 |
DeepSeek-V4-Flash | ×0.17 | 5.4 | 1M 上下文,长文档处理 |
MiniMax-M2.5 | ×0.18 | 5.8 | 轻量均衡,日常改写 |
GLM-4.6 | ×0.23 | 7.4 | 方案撰写、报告梳理、多步任务 |
MiniMax-M3 | ×0.25 | 8.0 | 代码与智能体任务 |
Hy4 preview | ×0.29 | 9.3 | 混元旗舰,长文档与复杂工程 |
Kimi-K2.5 | ×0.45 | 14.4 | 长文档精读、多文件对比 |
DeepSeek-V4-Pro | ×0.51 | 16.3 | 代码、数理与技术推理 |
GLM-5.3 | ×0.79 | 25.3 | 旗舰,复杂软件工程与长程任务 |
Kimi-K3 | ×1.62 | 51.8 | 长程自主任务、科研推理 |
表 2 内置模型倍率节选(完整清单另含 GLM-5.1/5.2 与 5.3 并列 ×0.79、GLM-5.0-Turbo ×0.95、GLM-5v-Turbo ×0.71、Kimi-K2.6 ×0.52、Kimi-K2.7-Code ×0.57、Kimi-K2.8-Preview ×0.77 等;Hy3 与 Step-5-Preview 为 ×0.00 免费模型)
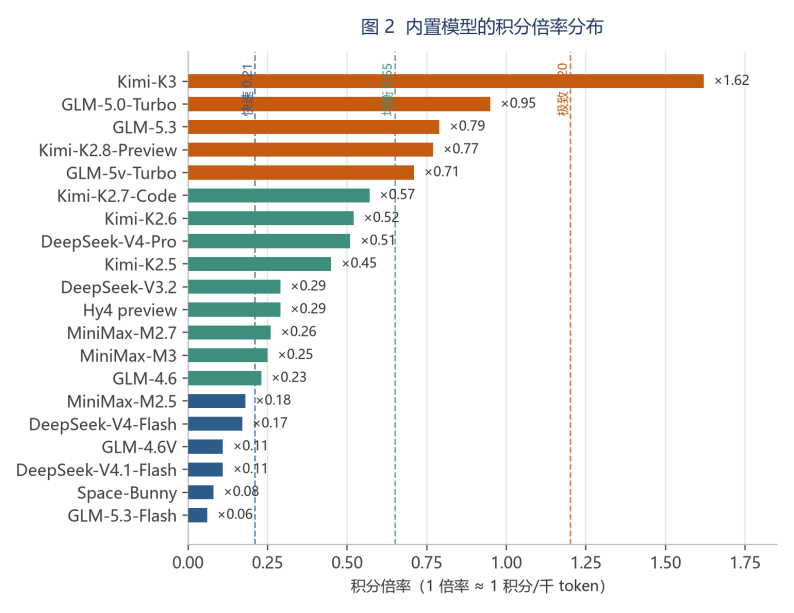
图 2 内置模型积分倍率分布(虚线为三档系数参照)
内置付费模型大致分三条带。轻量带(0.20 及以下):GLM-5.3-Flash、Space-Bunny、GLM-4.6V、DeepSeek-V4.1-Flash、DeepSeek-V4-Flash、MiniMax-M2.5,比“快速”档更便宜或相当,适合格式转换、摘要、短文改写与截图识别。主力带(0.23—0.60):GLM-4.6、MiniMax-M3、MiniMax-M2.7、Hy4 preview、DeepSeek-V3.2、Kimi-K2.5、DeepSeek-V4-Pro、Kimi-K2.6、Kimi-K2.7-Code,是日常文档、数据分析与代码修改的实际主力。重载带(0.70 以上):GLM-5v-Turbo、Kimi-K2.8-Preview、GLM-5.1/5.2/5.3、GLM-5.0-Turbo、Kimi-K3,服务长程任务与高难度推理。
两点细节值得记录。其一,GLM-5.1、5.2、5.3 并列 0.79,同代产品按能力定位而非版本号递增定价,升级不必然多花钱。其二,Kimi-K3 的 1.62 已高于“极致”档的 1.20——这正是档位的制度价值:以固定价格换取调度自由度,系统在档位内调用高价底层模型时,扣费仍按档位系数执行(此为依据配置结构作出的判断,官方未逐条公示)。另有 Hy3、Step-5-Preview 两款免费模型不耗积分,但有排队与额度限制,适合非紧急试跑。
四、矩阵分类对比
(一)任务复杂度 × 三档模式
任务层级 | 典型任务 | 快速(6.7) | 均衡(20.8) | 极致(38.4) |
|---|---|---|---|---|
L1 单点 | 问答、改错字、格式转换 | ★ 首选 | ○ 可用(浪费) | ✕ 明显浪费 |
L2 常规 | 总结、纪要、常规分析 | △ 勉强 | ★ 首选 | ○ 可用 |
L3 复杂 | 多文件代码、方案策划、数据建模 | ✕ 能力不足 | ★ 首选 | ○ 按需升级 |
L4 长程 | 重构、交叉核对、深度研究 | ✕ | △ 可用 | ★ 首选 |
表 3 任务复杂度与三档模式匹配矩阵(★ 首选;○ 可用;△ 勉强;✕ 不建议;括号内为单次积分估算)
(二)任务类型 × 推荐模型
任务类型 | 首选 | 单次积分 | 备选与说明 |
|---|---|---|---|
公文与理论文稿 | 均衡档 | 20.8 | GLM-4.6 起草(7.4),极致档终校(38.4) |
长文档精读 | DeepSeek-V4.1-Flash | 3.5 | Kimi-K2.5 深读(14.4);先速读后精读最省 |
数据分析与表格 | DeepSeek-V4-Pro | 16.3 | MiniMax-M3 亦可(8.0);公式统计更稳 |
代码修改与调试 | 均衡档 | 20.8 | Kimi-K2.7-Code(18.2);跨模块重构用极致 |
截图与图表识别 | GLM-4.6V | 3.5 | Space-Bunny(2.6);多模态轻量即可 |
批量改写与格式转换 | 快速档 | 6.7 | 量大时直选 GLM-5.3-Flash(1.9)更省 |
表 4 任务类型与模型选型矩阵(单次积分为标准任务估算值)
五、场景化选择参考
工作场景 | 推荐选择 | 单次积分 | 要点与风险提示 |
|---|---|---|---|
日常零碎问答与查证 | 快速档 | 6.7 | 占日常调用最大头,积少成多 |
会议纪要、周报整理 | 均衡档 | 20.8 | 结构固定、重复性强,重点控制上下文 |
理论文章起草(千字级) | 均衡档 | 20.8 | 结构化写作均衡档可担 |
重要文稿终校与逻辑核对 | 极致档 | 38.4 | 以 1.85 倍边际成本换质量,值得 |
语料库与文献批量处理 | 直选 Kimi-K2.5 | 14.4 | 长文档一次读入,避免分批;注意 300K 上限 |
课程课件与代码示例 | DeepSeek-V4-Pro | 16.3 | 代码与数理优先;讲义用 GLM-4.6(7.4) |
网络靶场代码审查 | 极致档 | 38.4 | 安全类代码慎用低档,漏判成本高于积分 |
多方案比选与深度研究 | 极致档 | 38.4 | 重要汇报前使用;平时留在均衡 |
表 5 高频工作场景速查(按每月数千至数万 token 的常规任务量估计)
六、结论
把上述数据压缩成三条操作规则:其一,默认停在均衡,让快速与极致按需升降;其二,倍率 0.20 以下的模型直接指定,比快速档更省,倍率 0.79 以上的重载模型交给极致档调度、享受 1.20 封顶;其三,省钱的优先级依次是新任务开新窗口、保持 Max 模式关闭、及时压缩冗余上下文,最后才是降档位——上下文治理的收益大于任何一次档位切换。
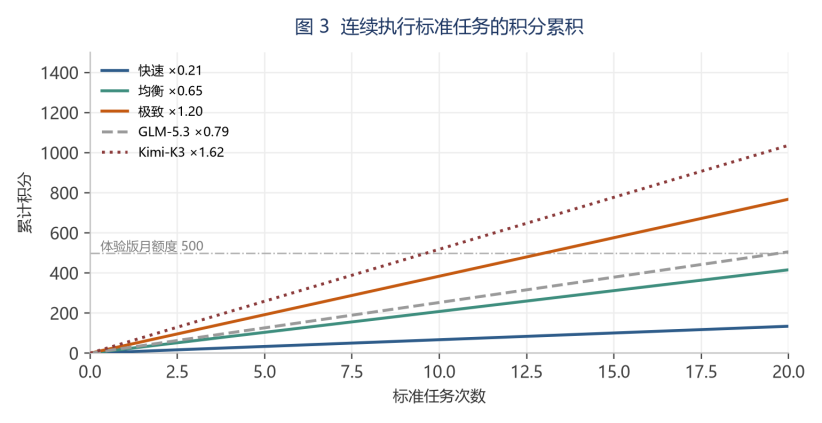
图 3 连续执行标准任务的积分累积(虚线为体验版月额度)
从累积曲线看,二十次标准任务在快速、均衡、极致三档下的累计消耗约为 134、416、768 积分,差距随使用量线性放大。对写作与备课任务量较大的用户,“均衡档为主、轻量模型直选为辅、极致档留给关键产出”的组合,能够在质量基本不减的前提下,把积分消耗控制在全极致档用量的一半以下。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号