Milvus 3.0 刚写入搜不到:数据没丢,是你的查询只看到 5 秒前
原创
Milvus 3.0 刚写入搜不到:数据没丢,是你的查询只看到 5 秒前
原创
术哥
发布于 2026-10-19 20:17:48
发布于 2026-10-19 20:17:48
🚩 2026 年「术哥无界」系列实战文档 X 篇原创计划 第 209 篇,Milvus 最佳实战「2026」系列第 34 篇
大家好,欢迎来到 术哥无界 | ShugeX | 运维有术。
我是术哥,一名专注于 AI 编程、AI 智能体、Agent Skills、MCP、云原生、AIOps、Milvus 向量数据库的技术实践者与开源布道者!
Talk is cheap, let's explore。无界探索,有术而行。
封面
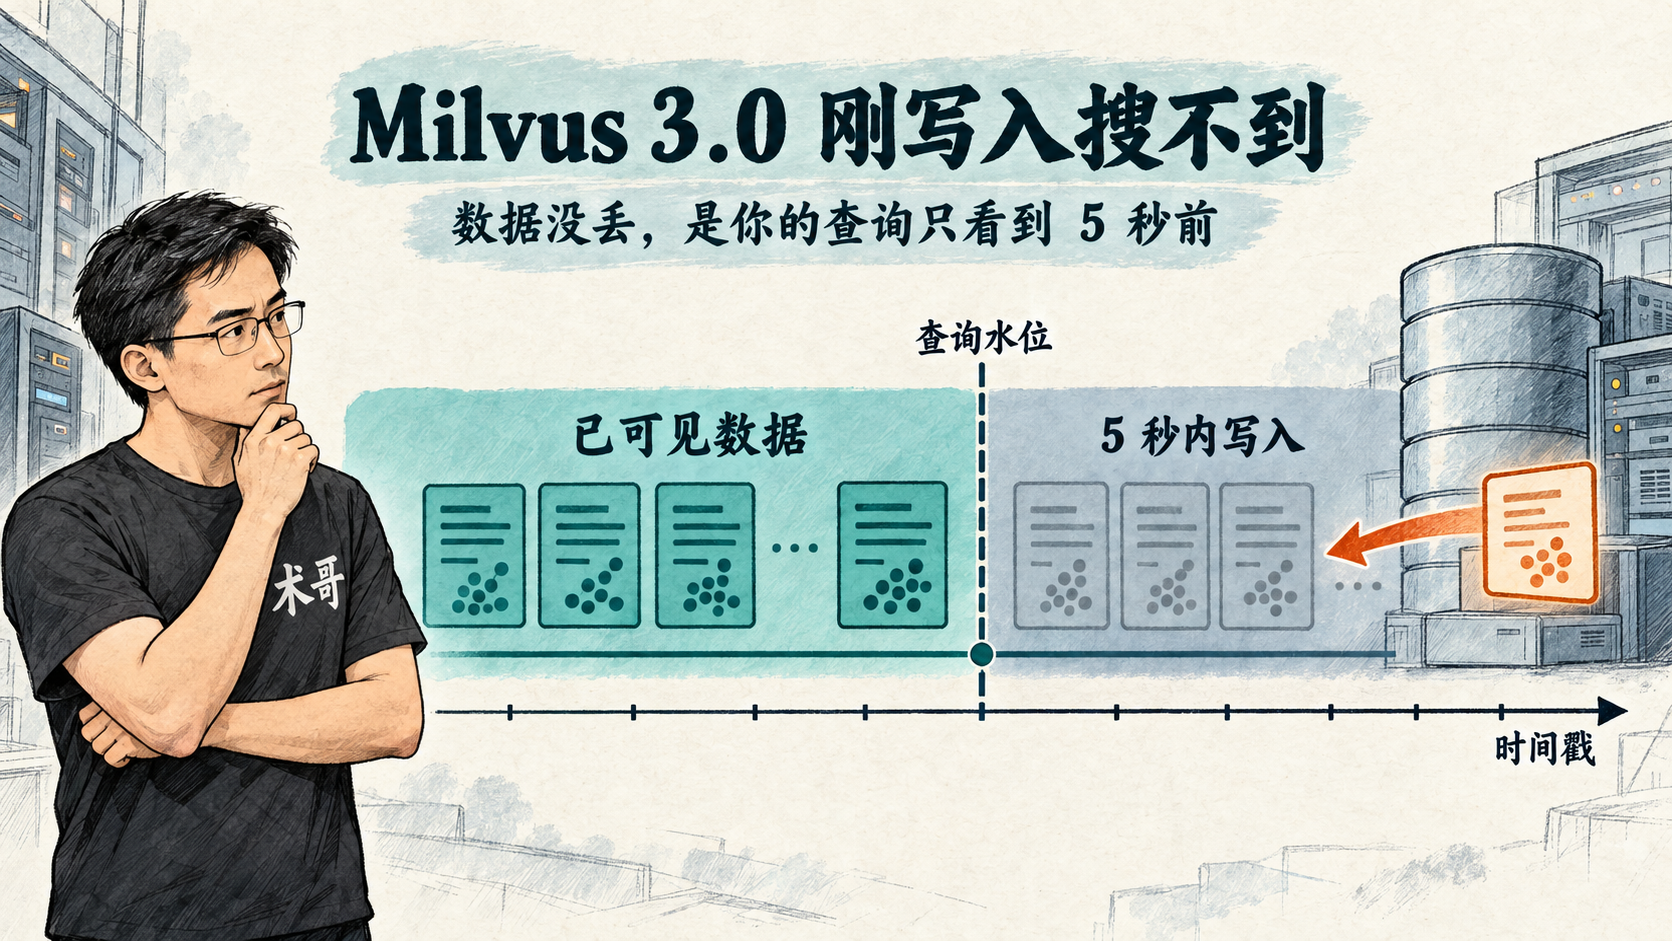
最近在折腾 Milvus 的实时检索,撞上一个怪问题:一批数据刚灌完库,insert 全部返回 success,紧接着 search,刚写进去的那条就是搜不到。
手动再查一次,数据明明在。前后就差几秒。
第一反应是怀疑自己代码写错了,日志翻了一圈没毛病;放到 CI 里更邪门,断言时绿时红:昨天绿,今天红,重跑又绿。
写入没报错,查询也没报错,那这几秒里到底发生了什么?我把查询链路的源码翻了一遍(commit 1306ae0816),对照 v3.0.x 的官方文档。答案是一个具体的数字:5 秒。
5 秒不是延迟,也不是性能问题。它藏在每次搜索请求自己携带的一个参数里。
01 水位:查询请求里的隐形参数
水位门
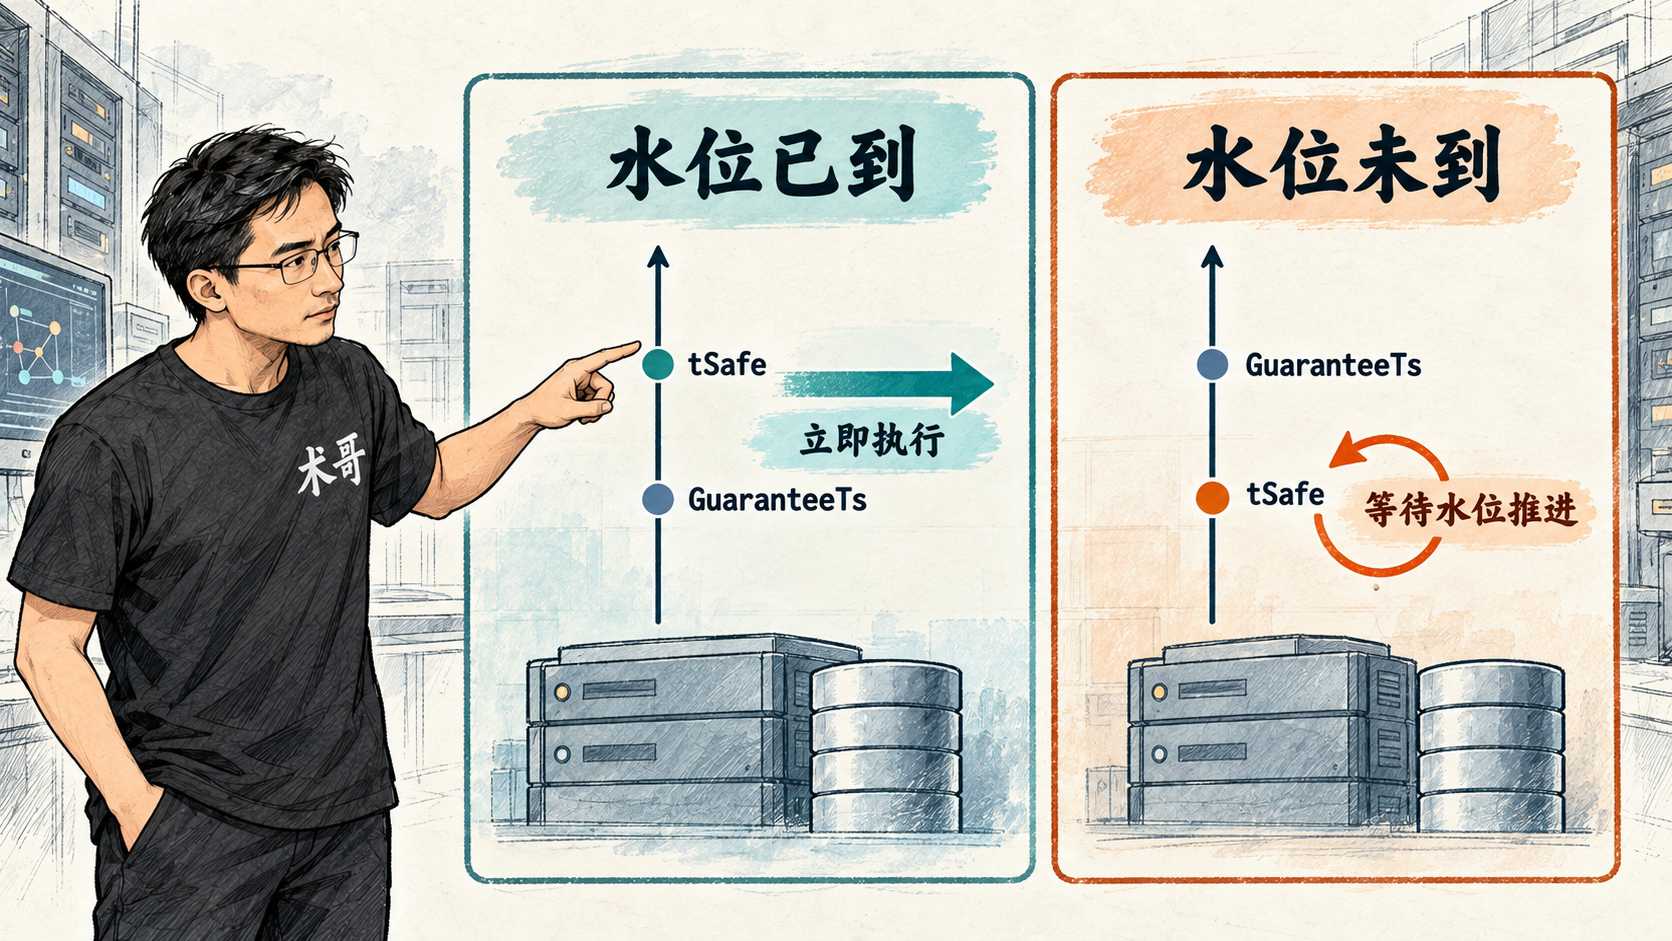
文档对它的说法很直白:GuaranteeTs 的作用是"通知查询节点,在查询节点能看到 GuaranteeTs 之前的所有数据之前,不会执行搜索或查询请求"。
白话版:你发起搜索时,等于在说"我只要看见某个时刻之前写入的数据就够了"。这个"某个时刻"就是 GuaranteeTs。查询节点拿它和自己的服务水位(tSafe)比较:服务水位更高,立刻执行;服务水位更低,等水位追上来再执行。
用户文档里写得更狠:"当 GuaranteeTs 大于 ServiceTime 时,查询节点必须等到 ServiceTime 超过 GuaranteeTs 后才能执行搜索操作"。
所以"刚写入搜不到"的第一种解释根本不是数据丢了,而是:这条数据的时间戳,落在你这次查询的水位之外。查询没丢数据,它只是没承诺看见。"能不能搜到",是这次查询的属性,不是那条数据的属性。
02 水位从哪来:TSO 与 timetick
timetick 流水线
要理解为什么需要这么个水位,得先看写入侧。Milvus 是分布式系统,不同节点的本地时钟不可信,所以每个插入操作的时间戳都来自 TSO(时间戳甲骨文,一个全局发号器),uint64,高 46 位是毫秒级 UTC,低 18 位是逻辑序号。
有了全局时间戳还不够:数据要经过消息队列流到查询节点,不同 proxy 写入的消息互相之间没有顺序保证。
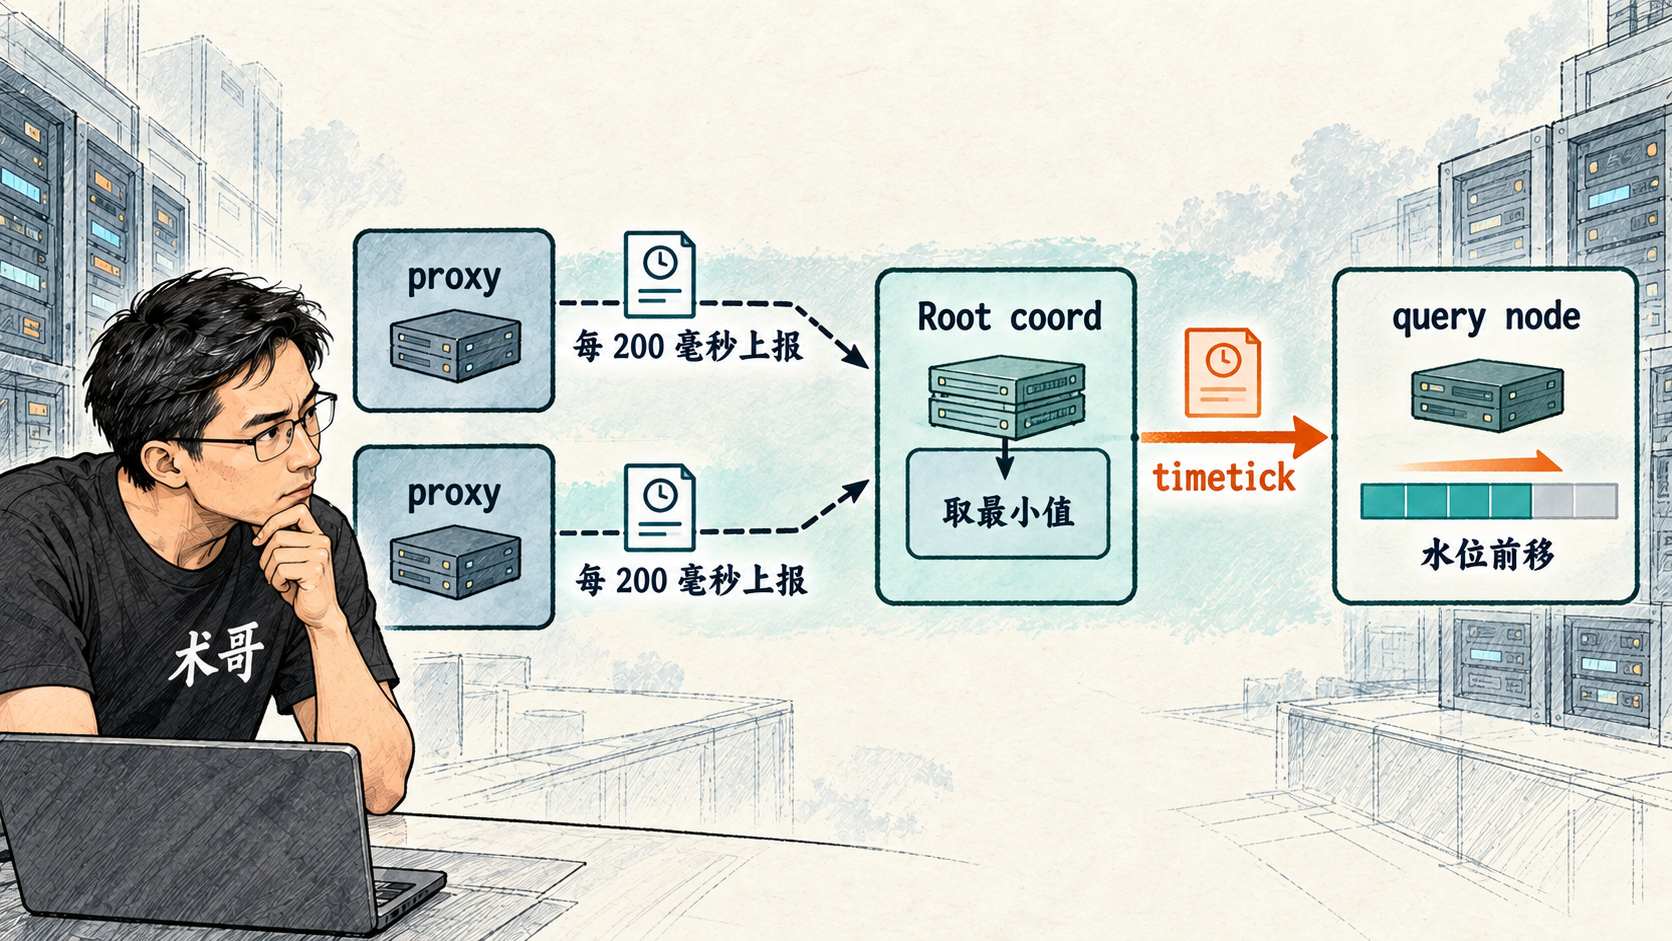
Milvus 的解法是 timetick:每个 proxy 默认每 200 毫秒向 Root coord 上报自己最新消息的时间戳,Root coord 取所有上报值里的最小值广播出去。下游消费者读到这个 timetick,就知道所有时间戳更小的消息都已经到齐了。查询节点的服务水位 tSafe,就是这样每 200 毫秒向前推一格。
03 你的一致性级别,就是水位的旋钮
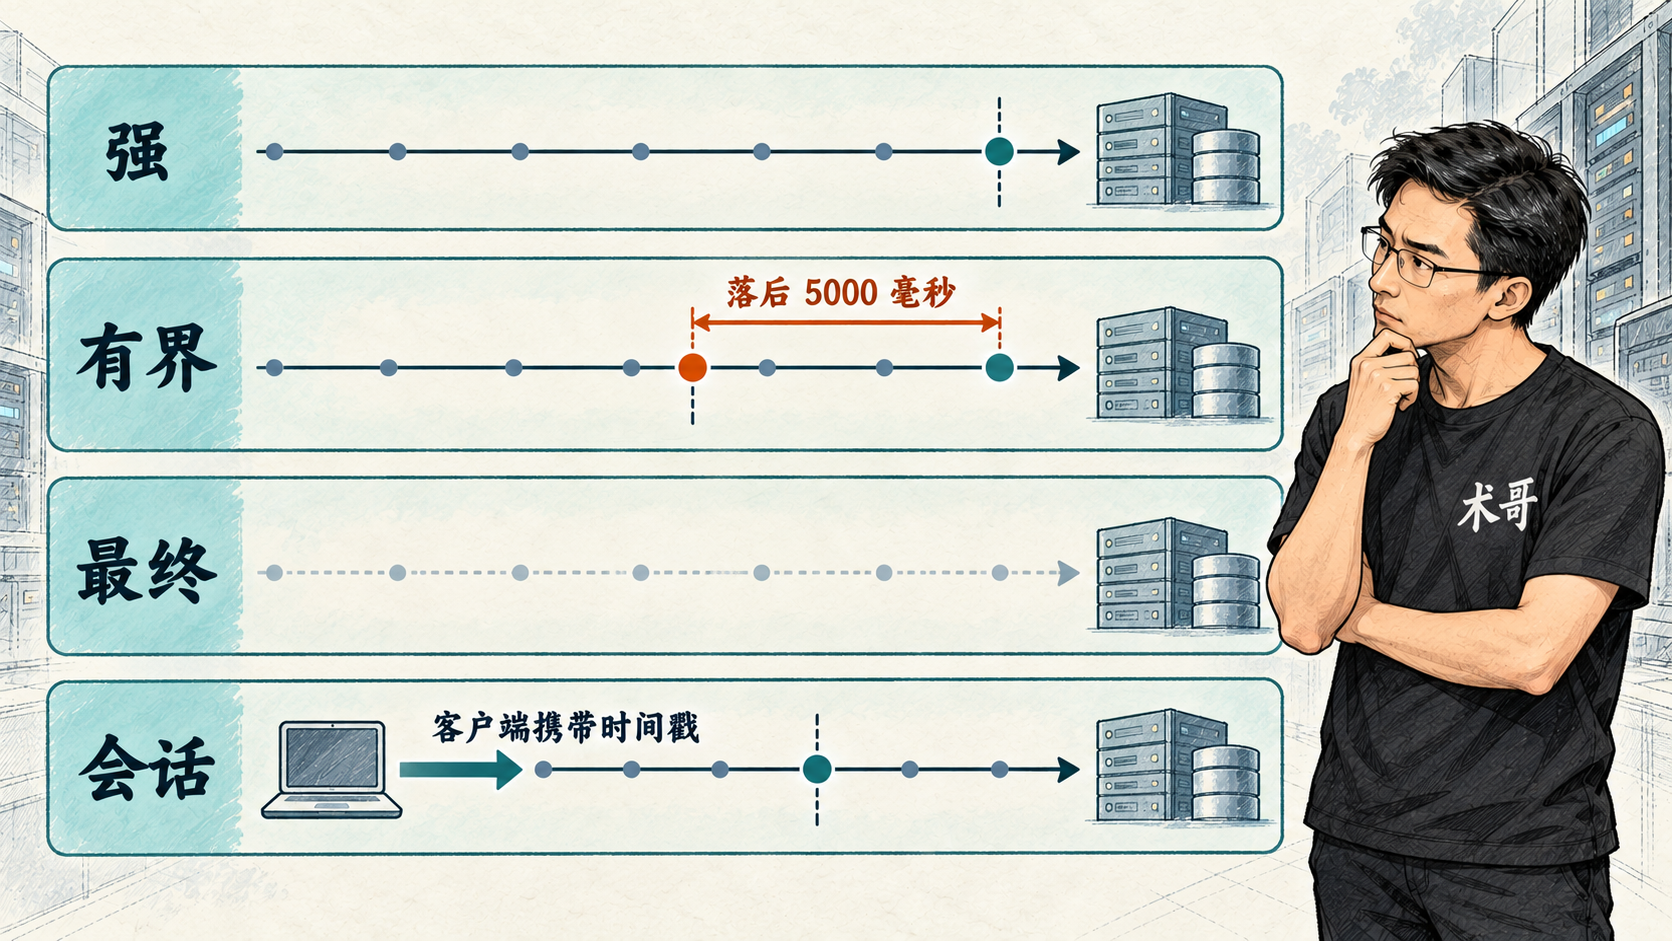
一致性旋钮
那 GuaranteeTs 具体取什么值?你不需要自己算:你在请求里带的一致性级别,就是 proxy 帮你换算水位的旋钮。换算发生在 internal/proxy/dql/task_search.go 的 PreExecute 里:请求指明用 collection 默认一致性,就用 collection 的级别;否则用请求级别;旧 SDK 只带 GuaranteeTimestamp 的走一条魔数兼容路径(strongTS=0、boundedTS=2,util_dql.go 里的哨兵常量)。
算完还有一步:和 collection schema 的更新时间戳取较大值,源码注释写明,这是让 schema 变更的视图先于新读请求生效。
四个级别的换算逻辑(ParseGuaranteeTsFromConsistency)值得逐个看:
- 强(Strong):
ts = tMax,即请求刚分配到的最新时间戳。查询节点必须等水位推到这里。你看见的是最新世界,代价是等。 - 有界滞后(Bounded,默认):
ts = tMax − GracefulTime。GracefulTime 默认 5000 毫秒(component_param.go的DefaultGracefulTime = 5000 // ms,milvus.yaml同值)。默认配置下,你这次查询的水位比"现在"慢 5 秒。5 秒内写入的数据,不在保证视野内。这是设计,不是故障。 - 最终(Eventually):
ts = 1。一个哨兵值,水位低到等于说"我不检查了",查询节点立即在现有视图上执行。 - 会话(Session):Session 的情况不一样,
switch里没有它的分支,传入什么时间戳就原样返回,Proxy 对会话级别不做任何换算。读自己写的这个保证,靠的是客户端把最近一次写操作的时间戳放进请求。文档口径一致:"客户端使用最新写操作的时间戳作为 GuaranteeTs"。
这个"一致性级别"的机制重心在 SDK,不在你查的这个服务端。客户端没正确携带时间戳,会话保证悄悄失效,服务端日志甚至看不出异常。
04 查询节点:等,或者报错
水位到了查询节点手里,处置逻辑在 internal/querynodev2/delegator/delegator.go 的 waitTSafe。
快路径一行:当前 tSafe 已经高于水位,直接执行。慢路径是标准的条件变量等待:水位没到,就挂着等 timetick 推进。
它不无限等,而且两种退出方式都不会"默默给你旧数据":等待前先算 lag(水位要求与当前服务时间的差),超过 maxTimestampLag(默认 86400 秒)直接报错(TsLagTooLarge);tSafe 在 waitTsafeStallTimeout(默认 3 秒,一个未导出的内部参数)内不推进,判定失速,快失败让 proxy 换副本重试。
所以强一致场景下的"搜不到",正常形态是变慢或报错。真遇到强一致读到旧数据,反而要查更深的问题。
文档只描述了"强 = 等到最新",源码里强一致的等还有一条官方加速路径:speedupGuranteeTS 在非迭代器等条件下,可以用 WAL 本地最新的 MVCC 时间戳替代 guaranteeTs,代码注释明说这是"make fast strong consistency search",TODO 里写着未来打算让两个时间戳合一。拿文档口径做强一致的延迟规划,可能算错。
05 遇到"搜不到",先分诊再排查
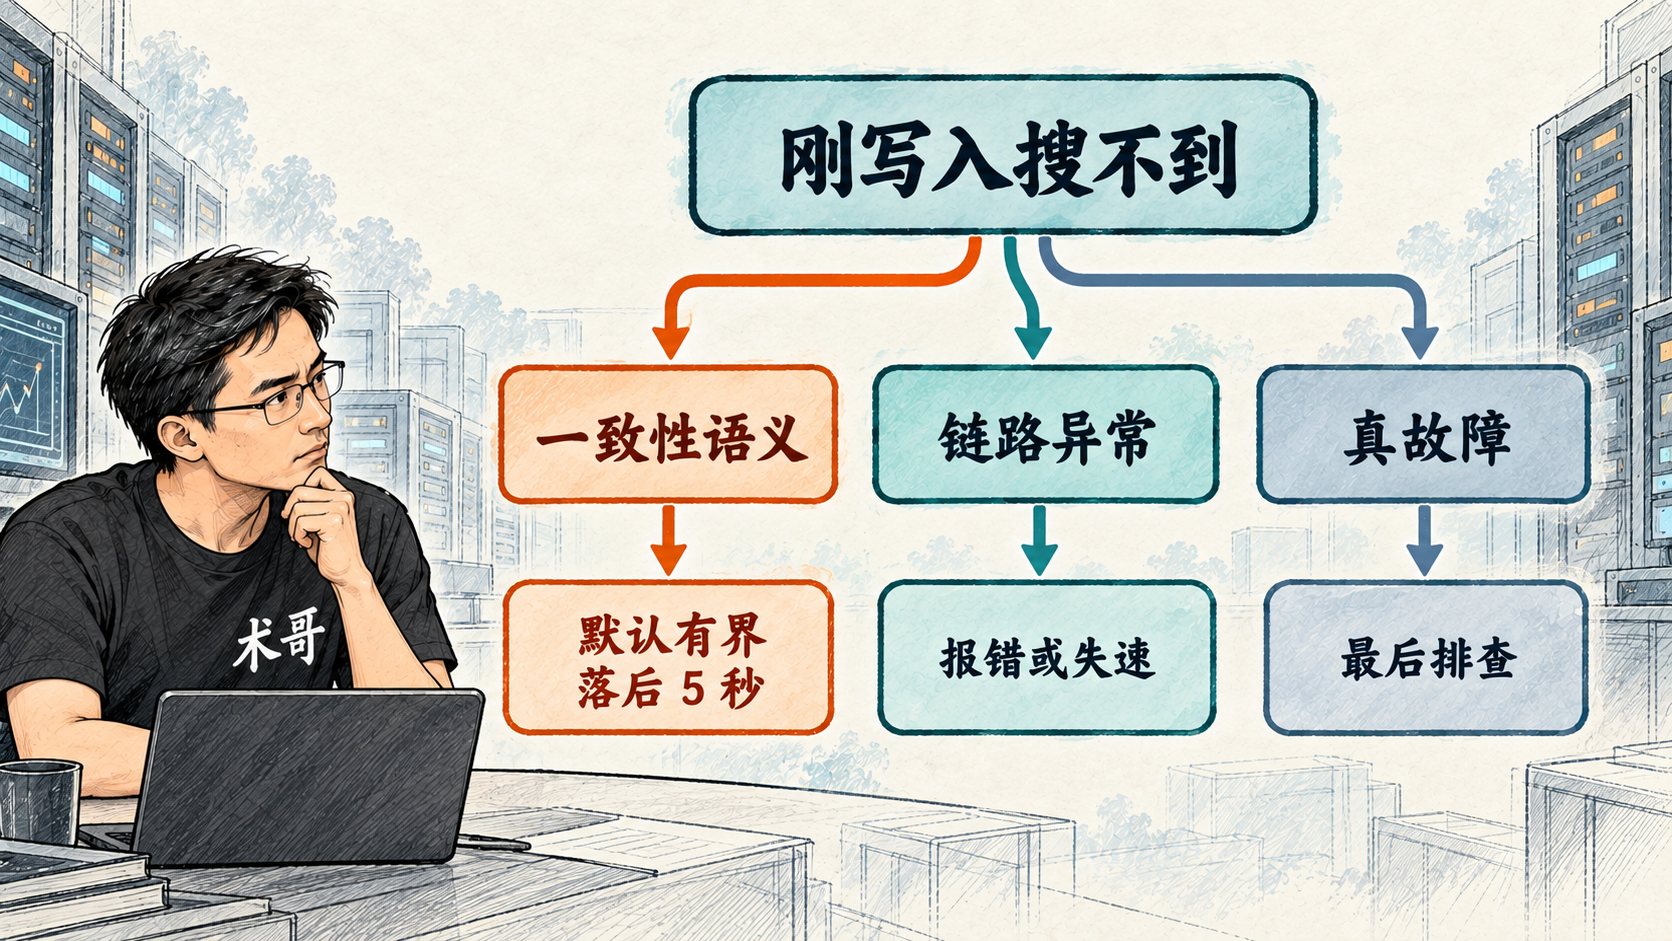
分诊树
把上面的机制收拢成一套判据。遇到"insert 成功但立刻查不到",按顺序过三类:
一致性语义(最常见):查一下这次请求实际用的一致性级别。默认的有界滞后意味着水位落后最多 5 秒,刚写入的数据不在视野内是正常行为。
链路异常(强一致场景):如果用的是 Strong,关注点是报错和延迟:TsLagTooLarge、请求超时、tSafe 失速。方向是查 timetick 链路的健康状况,而不是怀疑数据视图。社区里真实触发过这条路径:milvus-io/milvus 的 issue #49435(47 条评论)就是 Strong 加 upsert 并发下 Timestamp lag too large 的报错。
真故障(最后才怀疑):排除了前两类,再查写入链路、副本状态。另外两个直觉嫌疑人可以先撤了:可见性由 timetick 水位决定,查询节点同时服务已落盘的批量数据和未落盘的流式数据,"要等 flush/建好索引才能查"不是搜不到的第一解释。
选型可以按三个场景挑判据:
- 写入后立刻回读的校验逻辑和测试断言,用 Session(并确认你的客户端确实在携带时间戳)或 Strong;
- 线上高频召回按业务对滞后的容忍度选有界;
- 最终一致性别用在删除敏感和写入校验的场景:它的水位是字面意义的 1,连"删除已生效"都不承诺。读到已删除的数据,很容易误判成"删除失败",再沿写入链路排查一整圈,这才是这套语义下最贵的误会。
06 边界
这篇的判据来自源码(commit 1306ae0816)和 v3.0.x 文档,数字锚点(5000ms 的默认容忍窗、86400 秒的 lag 上限、3 秒的失速判定)都是默认值,改过配置的实例不算。
有两处我没写成结论:各语言 SDK 在 Session 级别下如何携带时间戳,客户端代码未核验;timetick 节奏与端到端可见延迟的定量关系,未实测,所以本文没有任何"几秒内必然可见"的承诺。外部场景还有一个实现特例:外部表的 waitTSafe 直接返回最大时间戳,避免低水位占位符遮掉已加载的删除。这些边界在实现层仍随版本演进,同一份判据换个大版本值得重对一遍源码。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号