别让 AI 画框图了,让它给你造一台机器
原创
别让 AI 画框图了,让它给你造一台机器
原创
大盘鸡拌面
发布于 2026-10-21 14:04:53
发布于 2026-10-21 14:04:53
一、我受够了那种「方框加箭头」的图
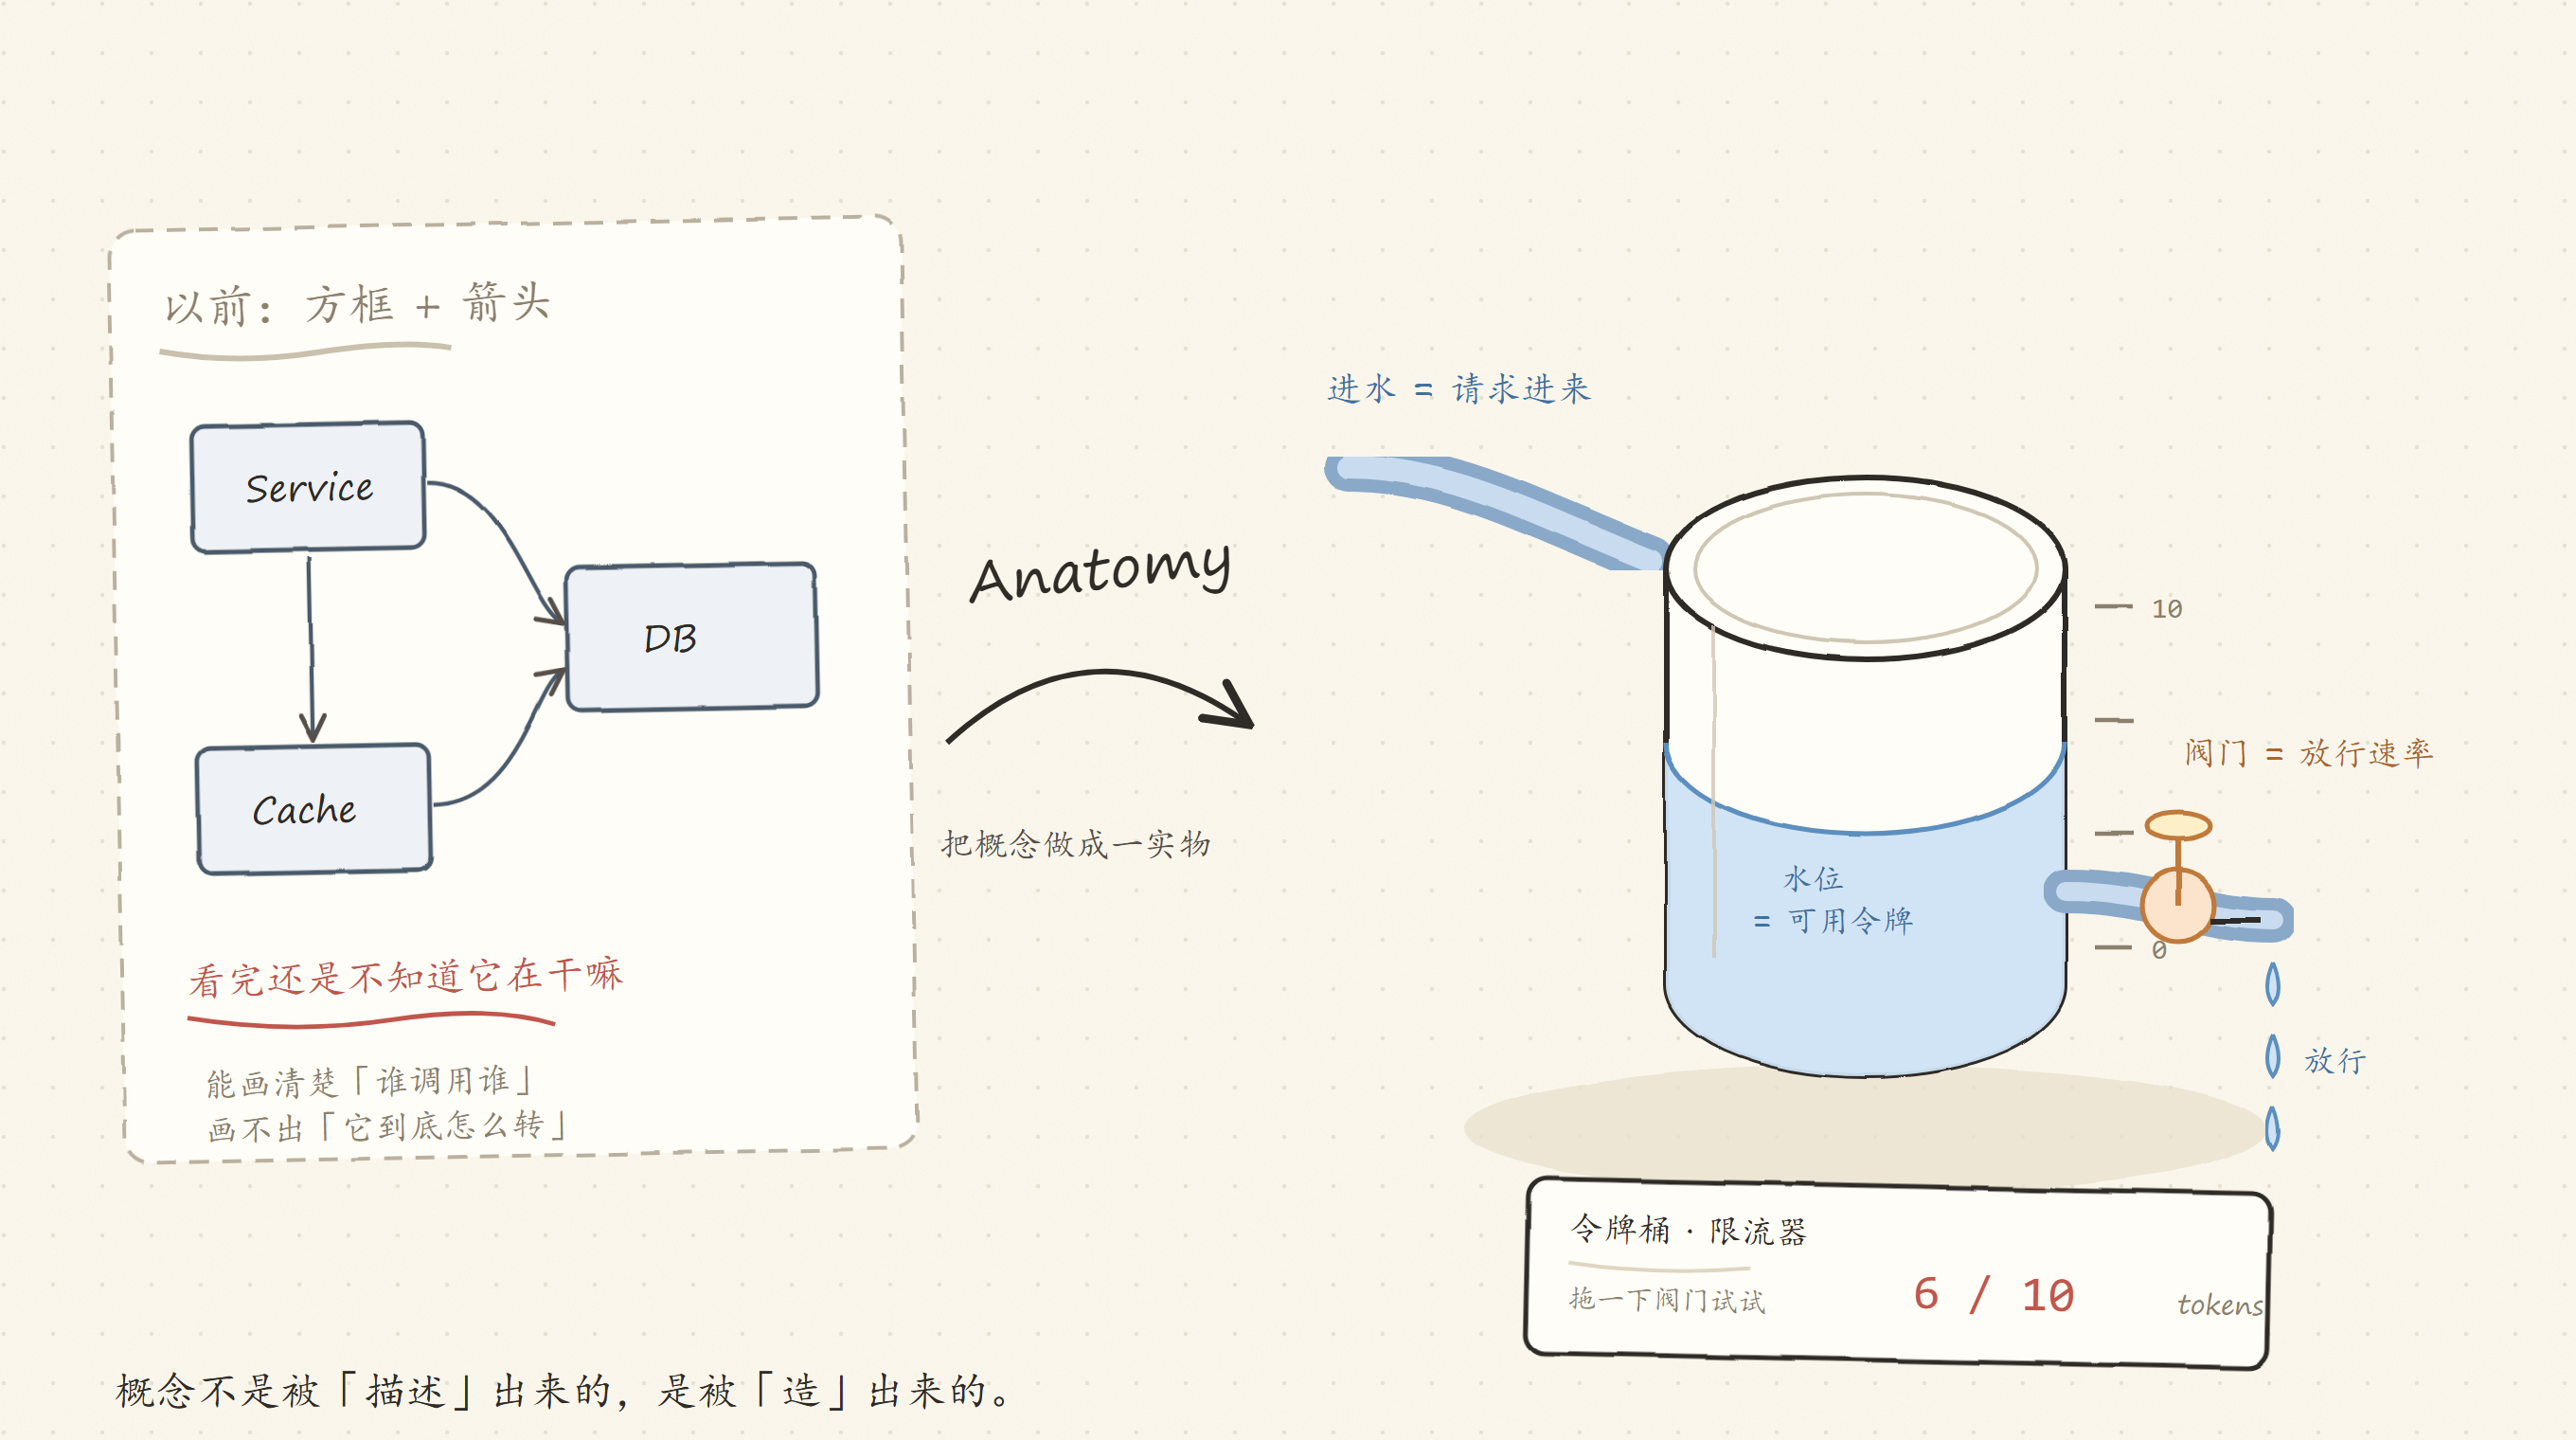
上个月给团队讲限流。我打开画图工具,拖了三个框:Gateway、Token Bucket、Backend,中间拉两根箭头,写上「请求进入」和「放行」。
讲完我问了一句:还有问题吗?
安静了三秒,一个后端同学说:所以令牌到底是怎么没的?
我当时愣了一下。因为那张图里根本没有「令牌怎么没的」这件事。它只表达了「谁调用谁」,而所有人真正想问的是「为什么会突然被限流」。这两件事完全不是一个层次的东西。
后来我又画过几版。加了颜色、加了图例、加了虚线表示异步。图画得越来越好看,问题一点没解决。 因为框图这种东西,天生只能表达「连接关系」,表达不了「运作过程」。你想让人看懂一个东西怎么转起来,就得把那个东西造出来。
这就是 Anatomy 干的事。
二、Anatomy 是个什么东西
先说清楚它不是什么:它不是一个画图库,也不是一个图表工具。你在里面找不到坐标轴、找不到折线、找不到柱状图。
它是一份 SKILL.md,一个 Agent Skill。MIT 协议,装完在 Claude Code、Codex 这类工具里直接 /anatomy 就能用。
它的核心设计理念只有一句话,写在仓库最显眼的位置:
The object is the explanation. 物体本身,就是解释。
翻成人话:你要我解释一个概念,我不写解释,我造一台机器,机器的运转过程就是解释。
比如你问它「缓存键为什么能跳过计算」,它不会画一个「Cache Hit / Miss」的判断框。它会给你造一把弹子锁:只有所有弹子都对上,锁芯才能转。钥匙不匹配,转不动。这一下你就懂了「键不匹配 = 走不进那条捷径」。
再比如「一个 GPU 上下文服务多个画布」,它会造一台龙门绘图仪,一个笔头在 16 个格子之间来回跑。你看着笔头跑,就明白了什么叫「上下文切换是有成本的」。
这种映射关系,是它最值钱的地方。它不是把概念画成图,是把概念翻译成一个物理隐喻,再把隐喻做成能动的零件。
装一下
npx skills add wheresryan22/anatomy -g装完在 Claude Code 里:
/anatomy 解释一下令牌桶限流,要能交互,深色主题它会花几分钟到十几分钟,给你一个 HTML 或者 SVG。打开以后能拖、能按、能看读数跟着零件变。
我第一次跑的时候以为它坏了,因为进度条半天不动。后来才知道这玩意儿是故意慢的:一张复杂的图,光几何审计和截图回看就要跑十几分钟。
三、Machine-Skill:我更在意的其实不是图
说实话,Anatomy 画出来的图好看归好看,但我一开始没打算写它。画图这事儿,需求太窄了。
真正让我坐直的是它组织技能的方式。我把它叫做 Machine-Skill:把一份技能文档,当成一台机器的图纸来写。
这个说法不是官方术语,是我自己总结的。但你只要对照着看两份 SKILL.md,就明白我在说什么。
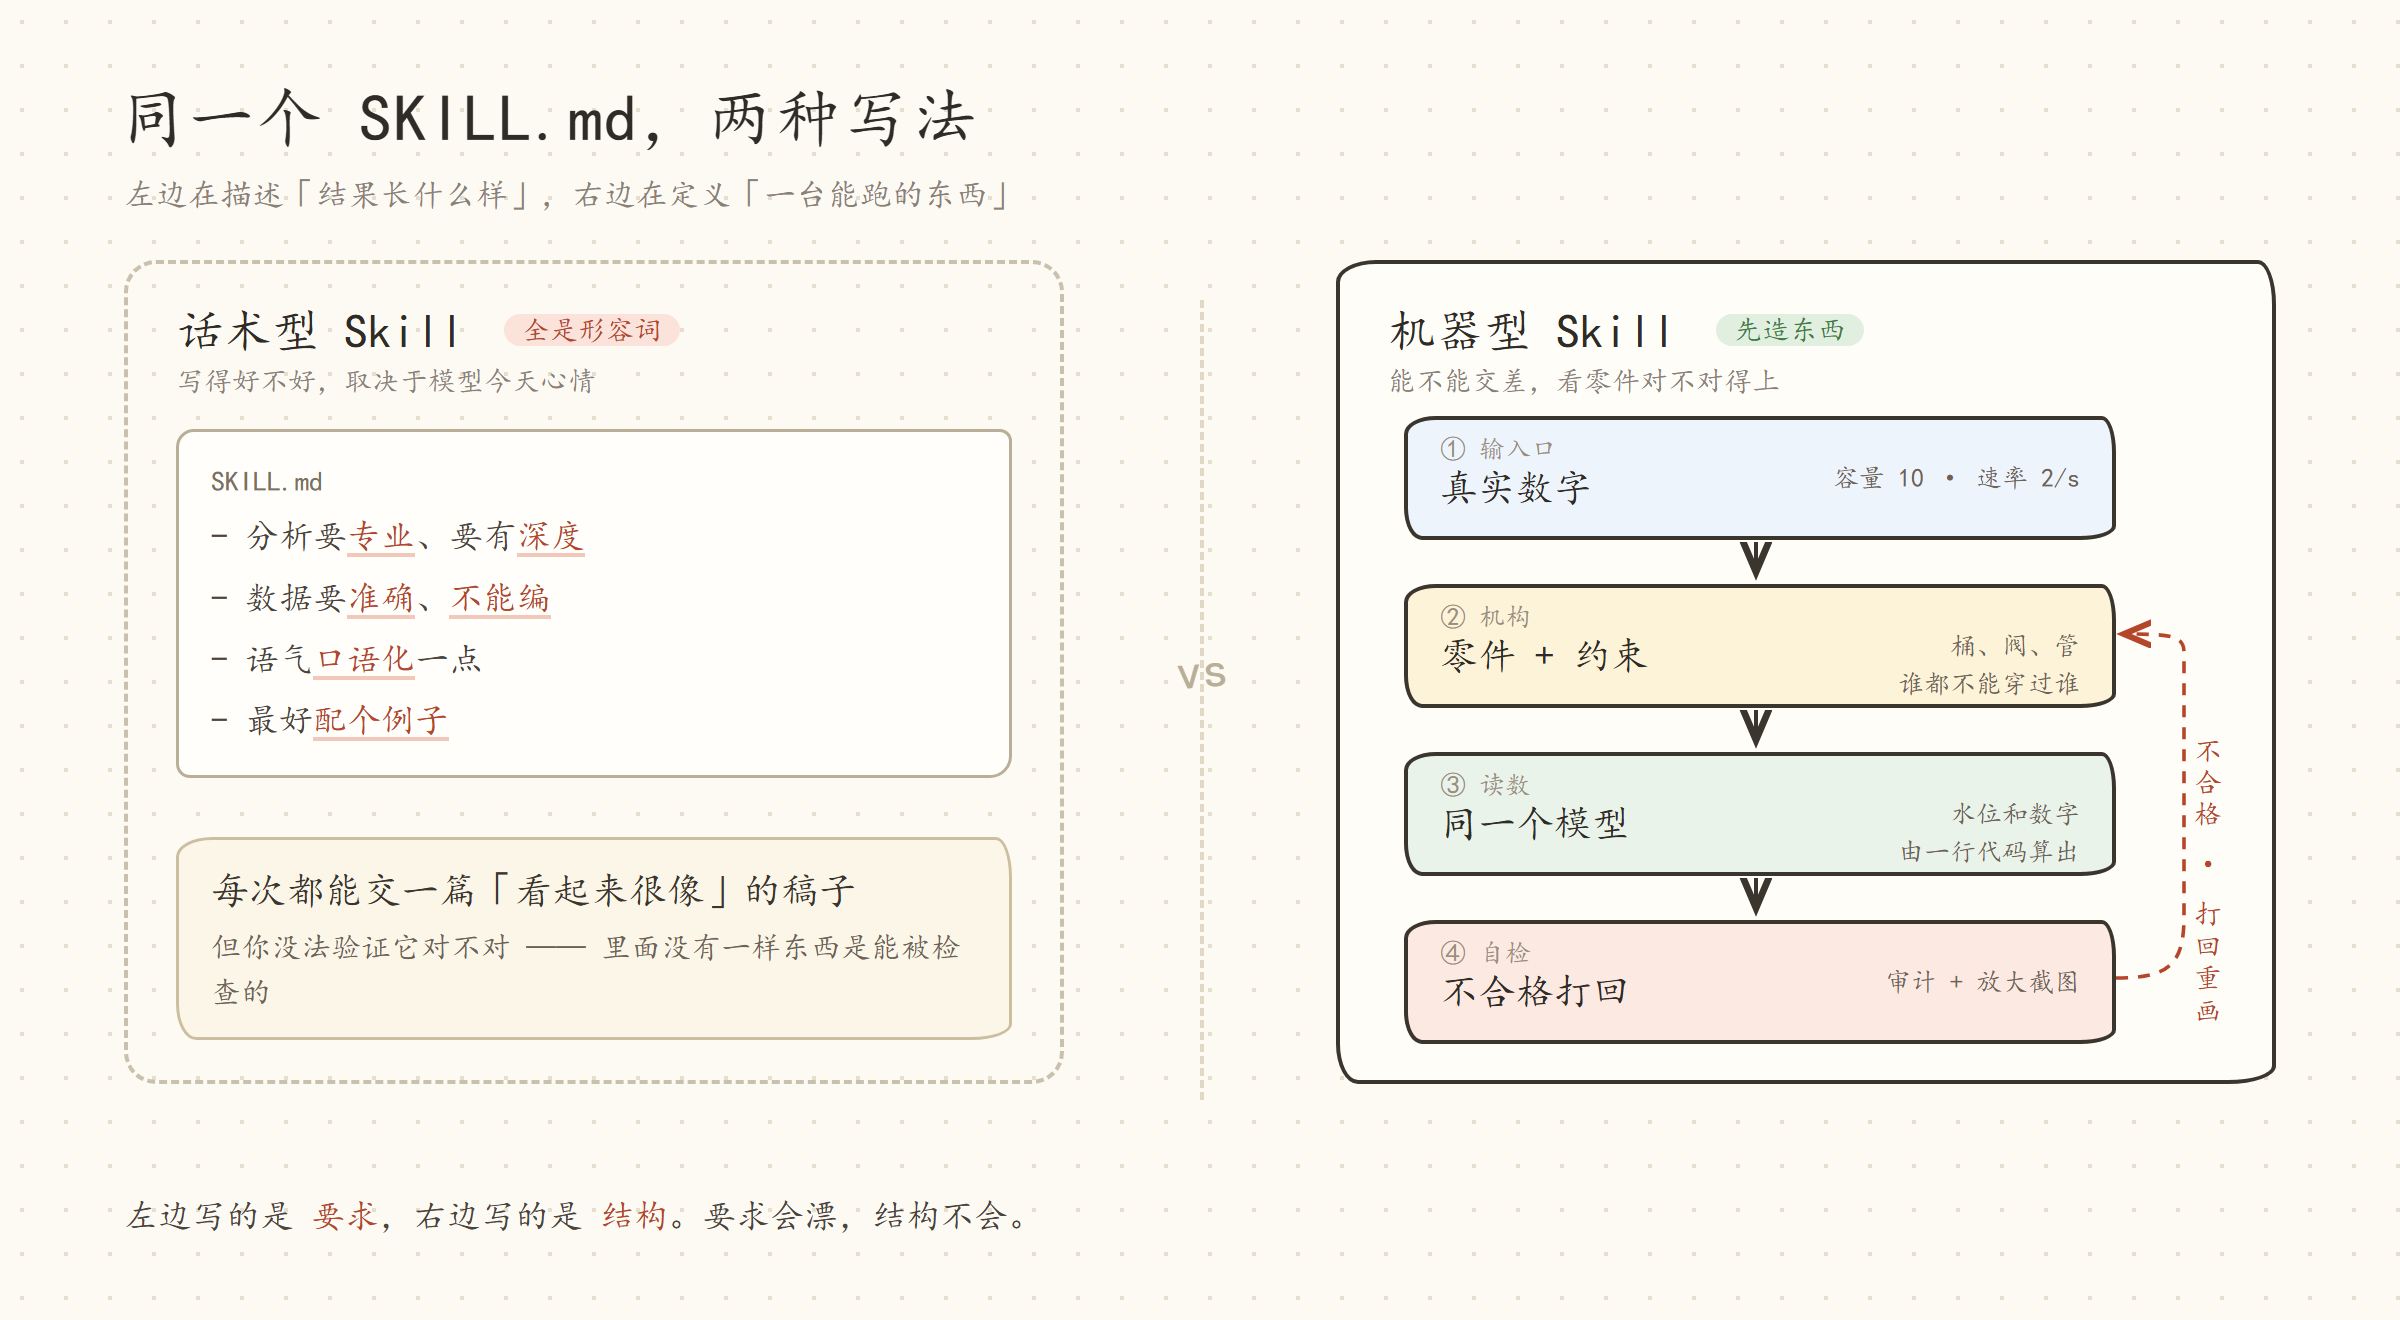
左边是话术型:
---
name: competitor-analysis
description: 分析竞品,输出一份专业的分析报告
---

# 竞品分析

- 分析要专业、要有深度
- 数据要准确,不能编
- 语气口语化一点
- 最好配个例子
右边是机器型:
---
name: token-bucket-figure
description: 把限流策略画成一台能动的机器
---

# 限流器图纸

## 1. 输入口(只认这几个数)
- capacity = 10(桶的容量,令牌)
- rate = 2(每秒补几个)
- burst = 12(压测时的并发数)

## 2. 机构(零件 + 约束)
| 零件 | 约束 |
|---|---|
| 桶体 | 半径 2.0,高 5.0,坐在底座上 |
| 进水管 | 从左上进入,末端在桶口上方 0.6 |
| 阀门 | 装在桶右侧,只控制放行速率 |
| 水滴 | 只从阀门出口落下,不许凭空出现 |

## 3. 读数(必须和零件同源)
- 水位 = tokens / capacity
- 卡片数字 = tokens.toFixed(1)
- 禁止在图上手写任何数字

## 4. 自检(不合格就打回)
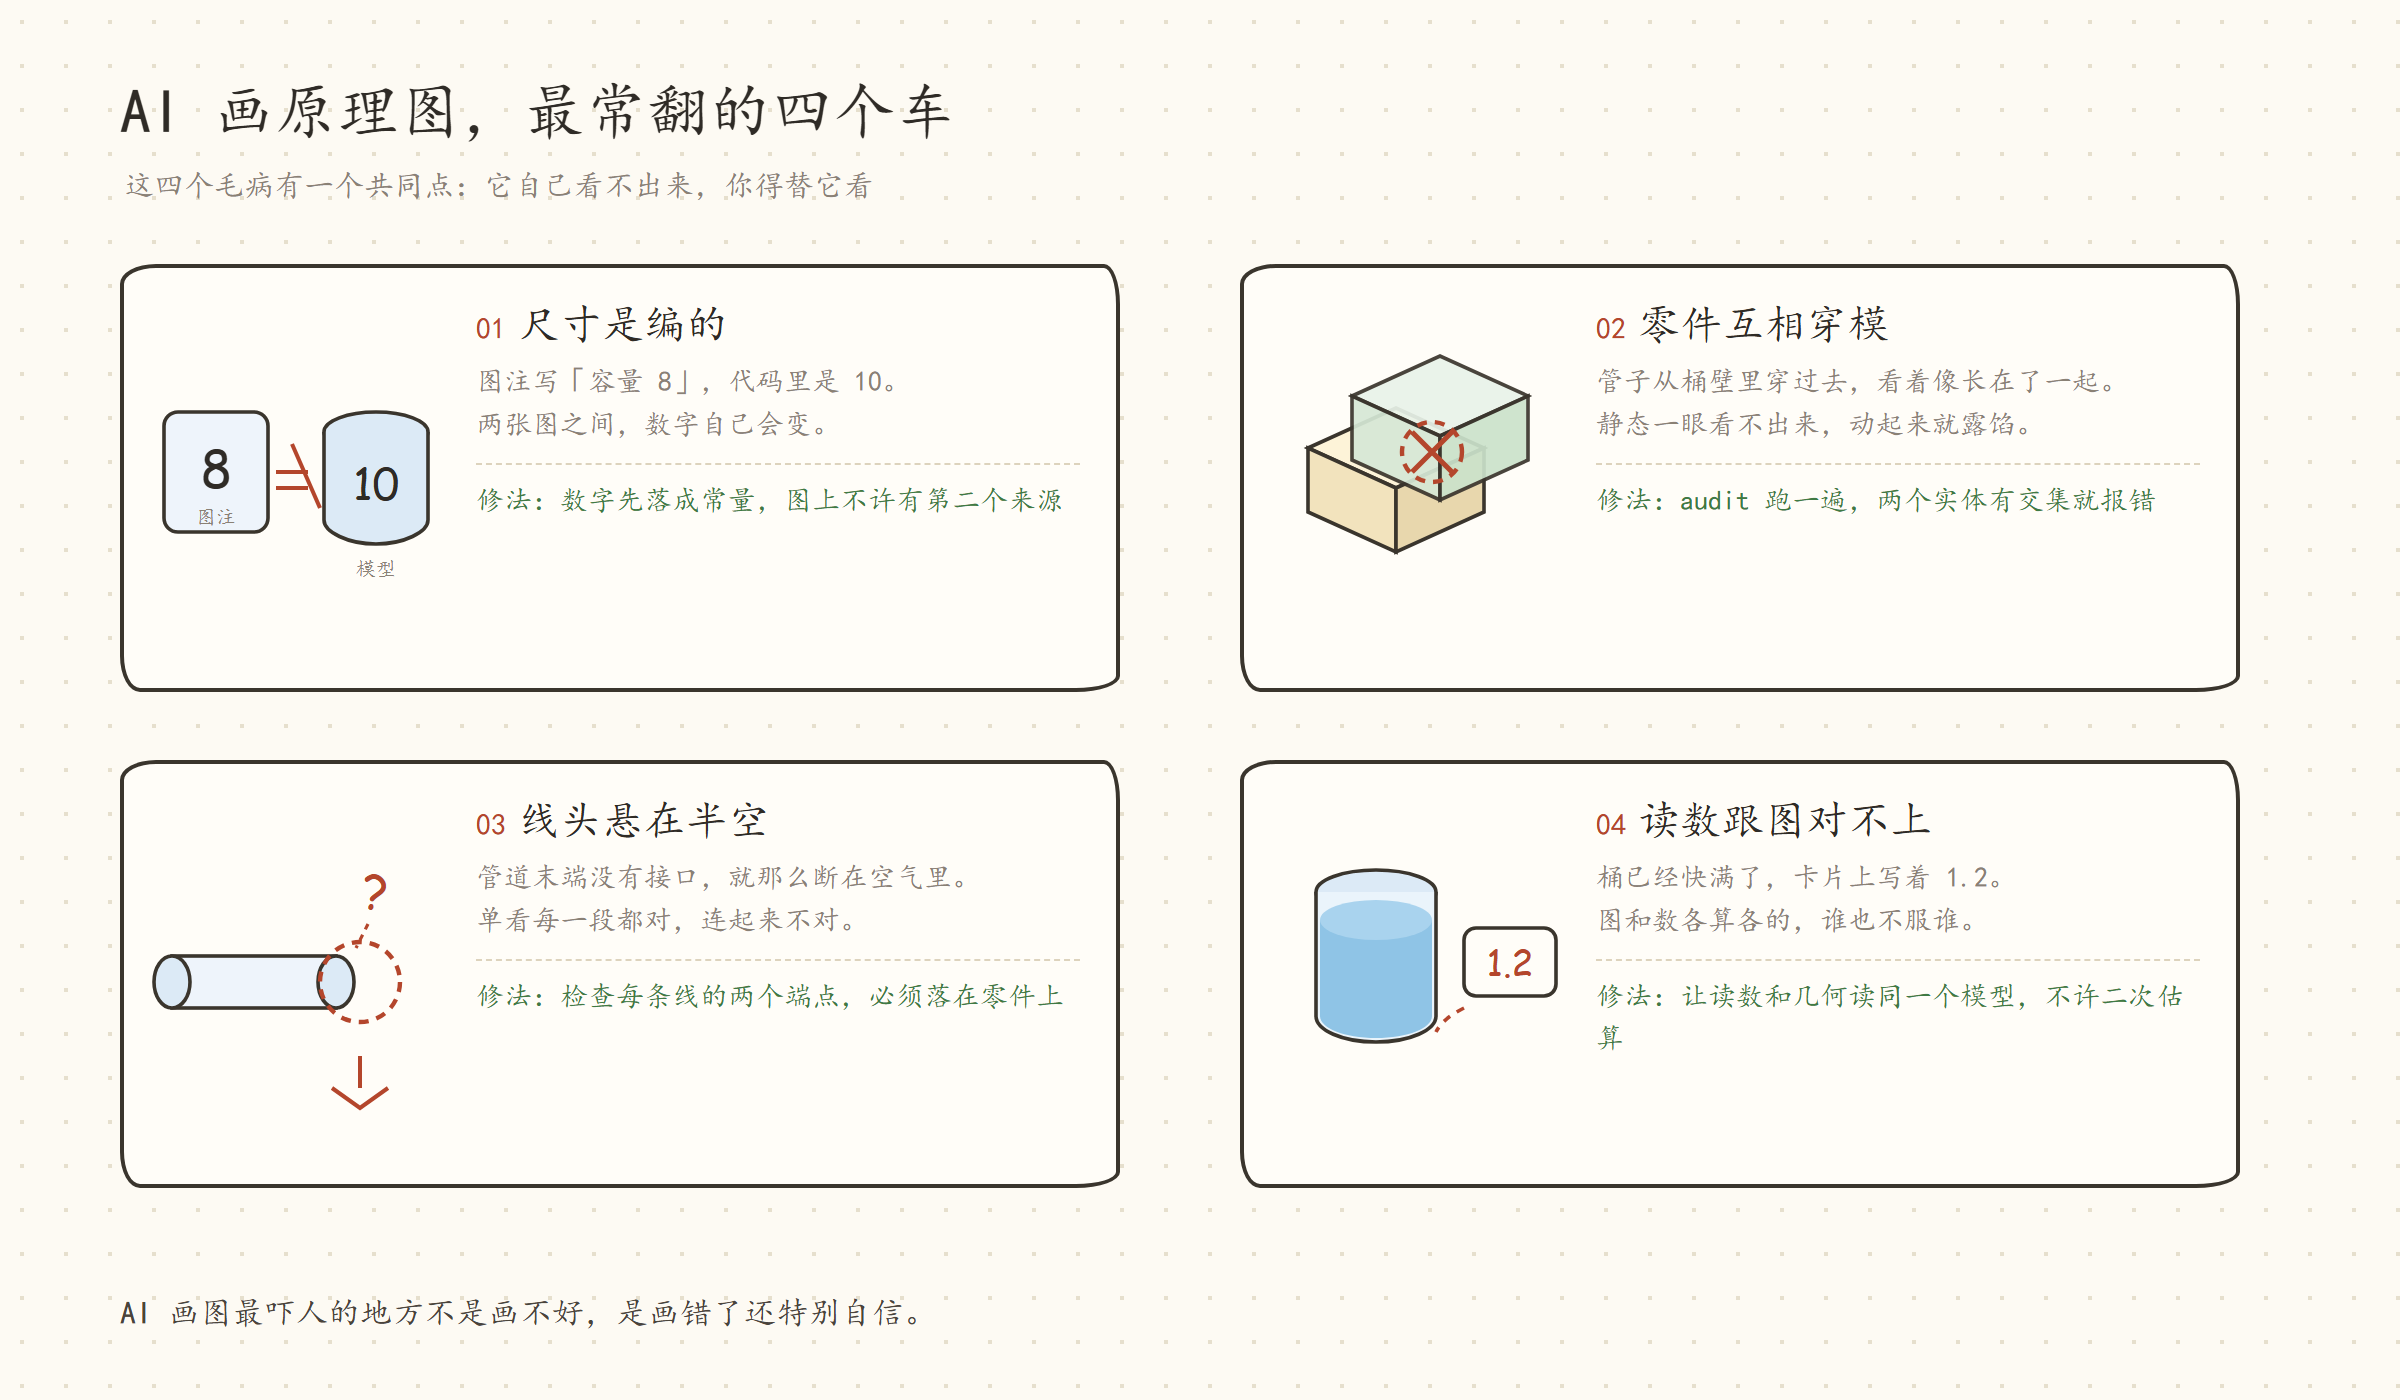
- 没有任何零件穿过另一个零件
- 每条管的两个端点都落在零件上
- 截图放大后,读数和几何能对上
看出区别了吗。
左边那份,你没法验证它交付得对不对。它交一篇「看起来很专业」的稿子,你只能说「感觉还行」或者「感觉不行」,然后重跑一次,赌运气。
右边那份,每一条都能被检查。桶是不是坐在地上?能查。管子末端有没有悬空?能查。卡片上的 4.2 和桶里的水位对不对得上?能查。
这就是 Machine-Skill 和 Prompt-Skill 的分水岭:前者定义了结构,后者描述了期望。
期望会漂。你今天说「专业」,明天说「有深度」,模型每次理解都不一样。结构不会漂,因为结构是可以跑一遍看结果的。
四、拆开看:Anatomy 的八步
SKILL.md 里把工作流写成了固定的八步。我一开始觉得啰嗦,跑到第三张图才明白,这八步是在防八种不同的翻车。
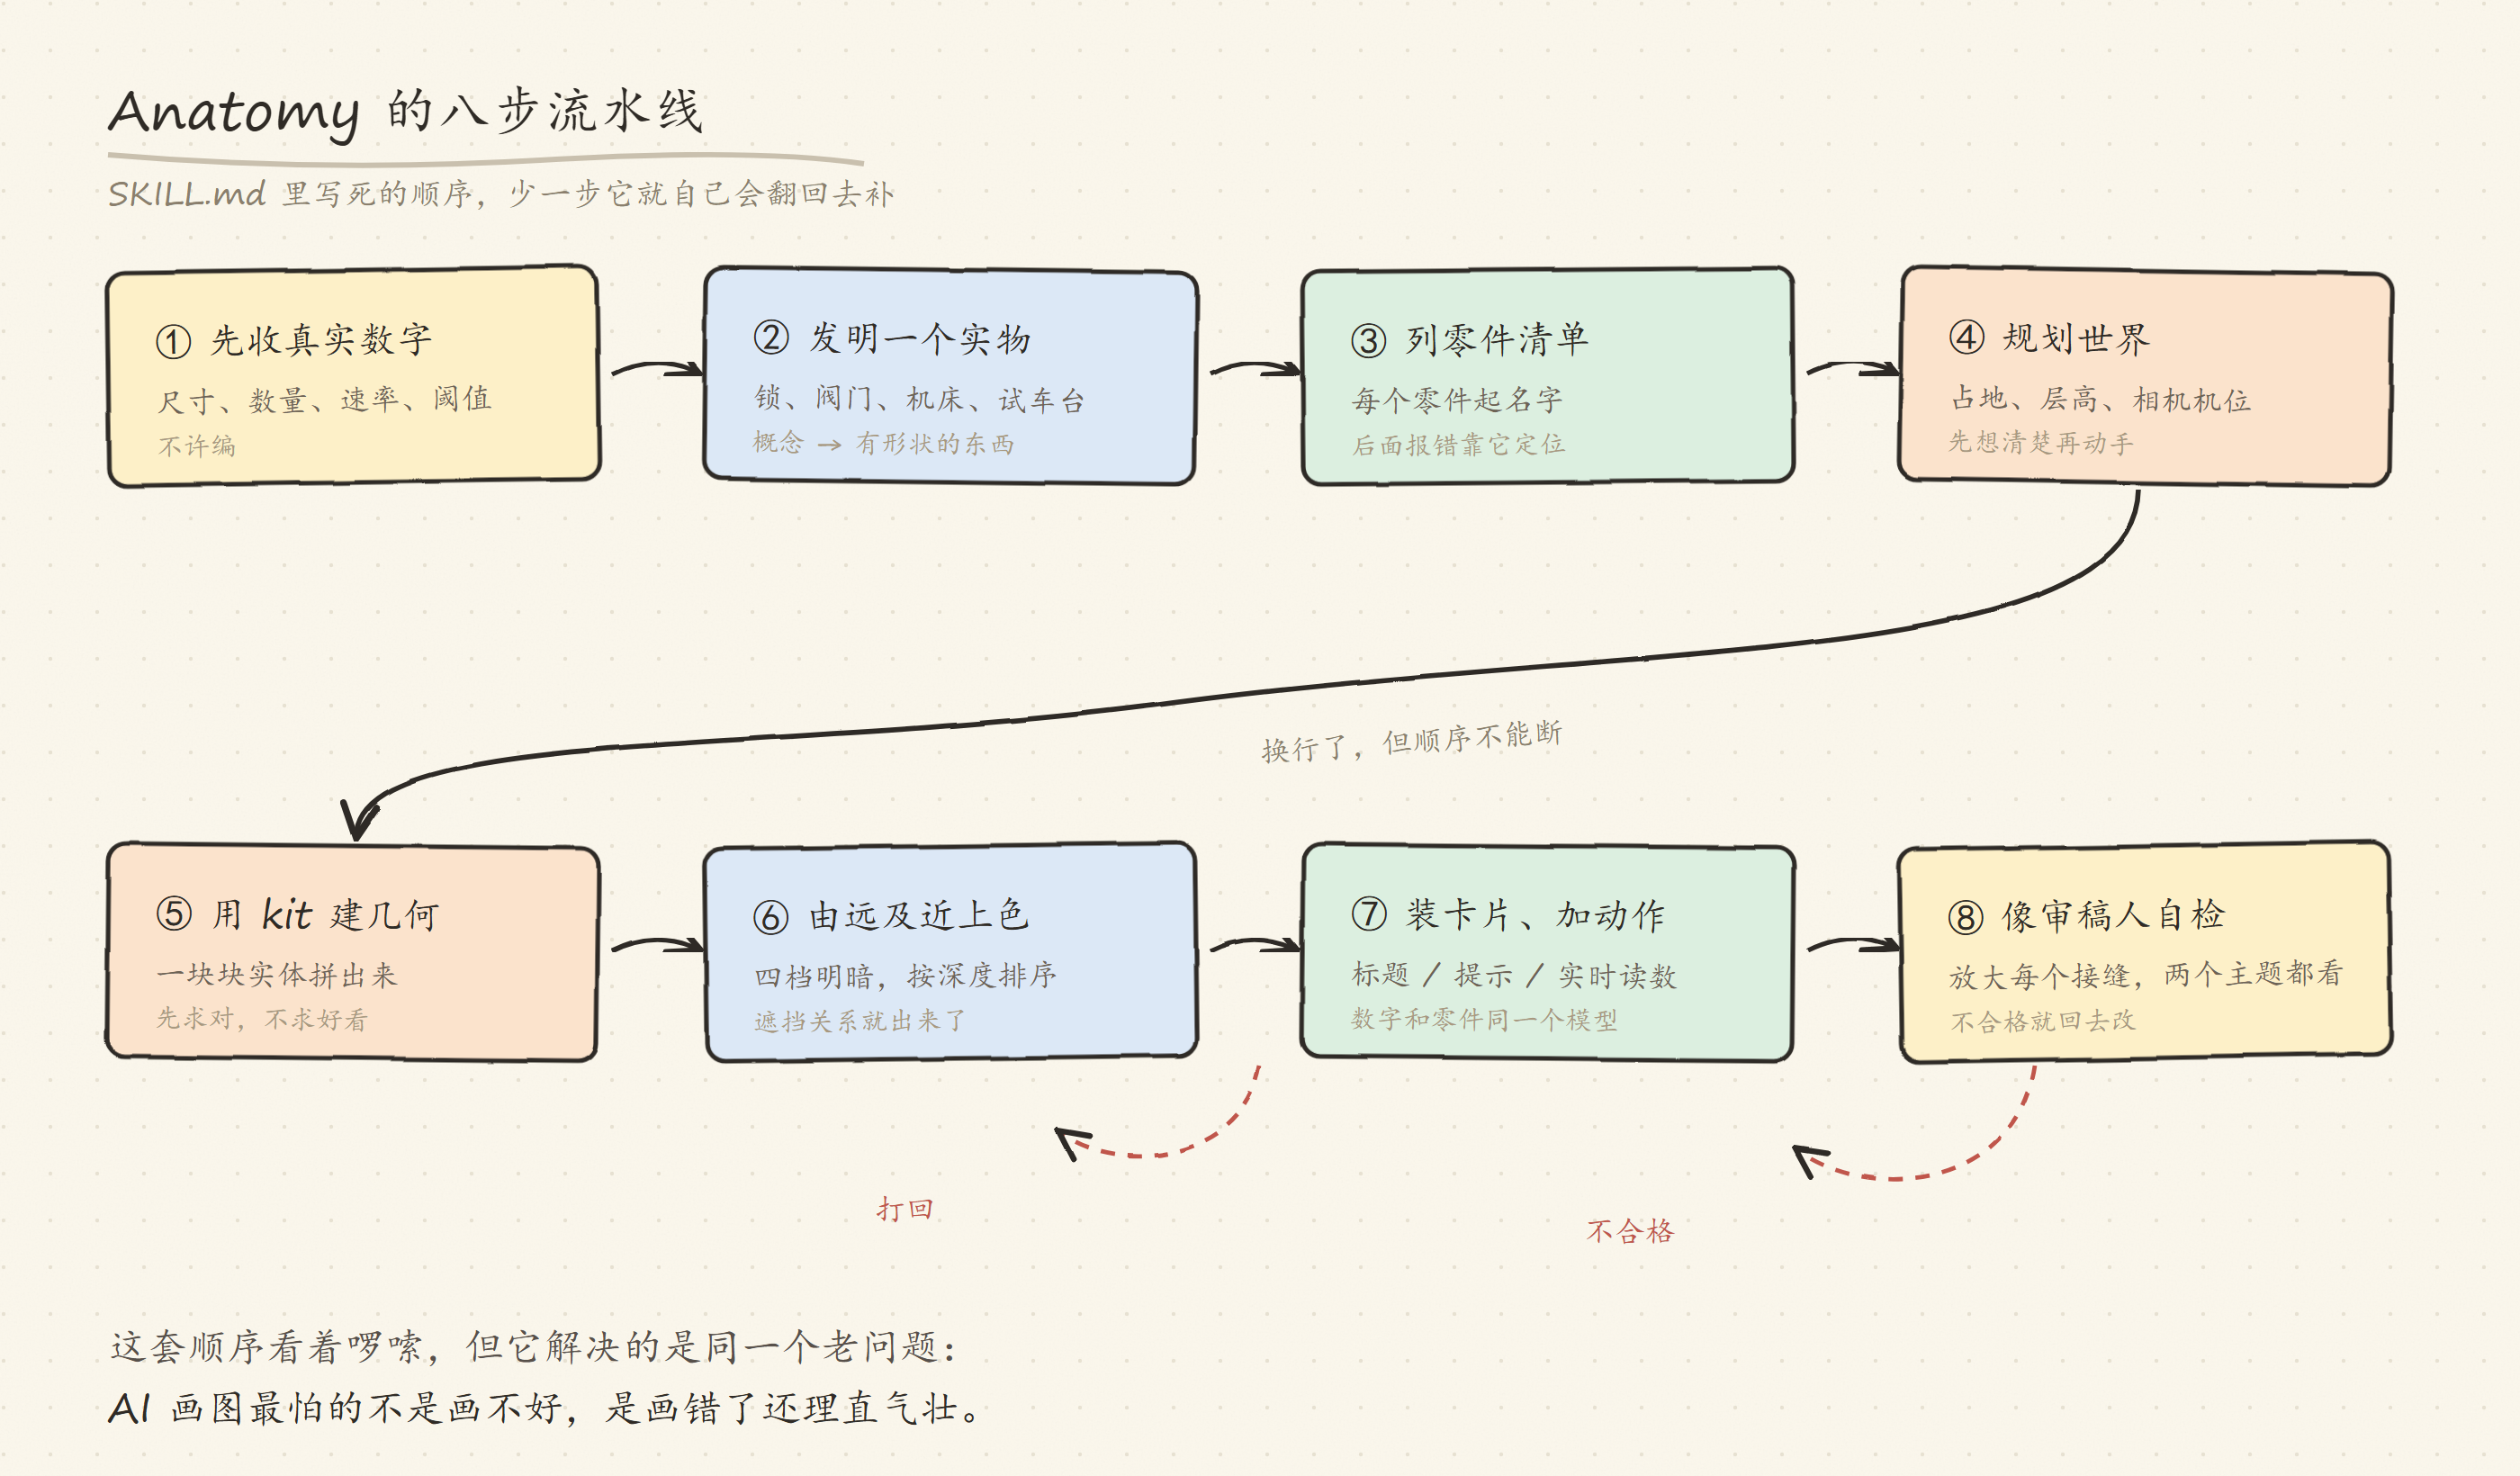
八个步骤里,我觉得最反直觉的是第①步和第⑧步。
第①步:先取数字,再想画什么。
大部分人生成图的顺序是:先有个大致想法,画出来,再往上填数字。Anatomy 是反的:先把真实数字钉死,再让图形去适配数字。
这个顺序差别巨大。先画后填,图是主体,数字是装饰,数字错了图也看不出来。先定数后画,数字是主体,图必须迁就数字,画错了一眼就能发现。
第⑧步:像审稿人一样自检。
不是「生成完了看一眼」,是「生成完了,把每个接缝放大,读一遍,不合格就回去改」。这一步是整份技能里最不像 AI 的部分,因为它承认了一件事:第一遍大概率是错的。
五、kit 是怎么把零件画出来的
kit/ 是这个仓库的绘图库。零第三方依赖,Node 内置模块就能跑,这点我很喜欢。
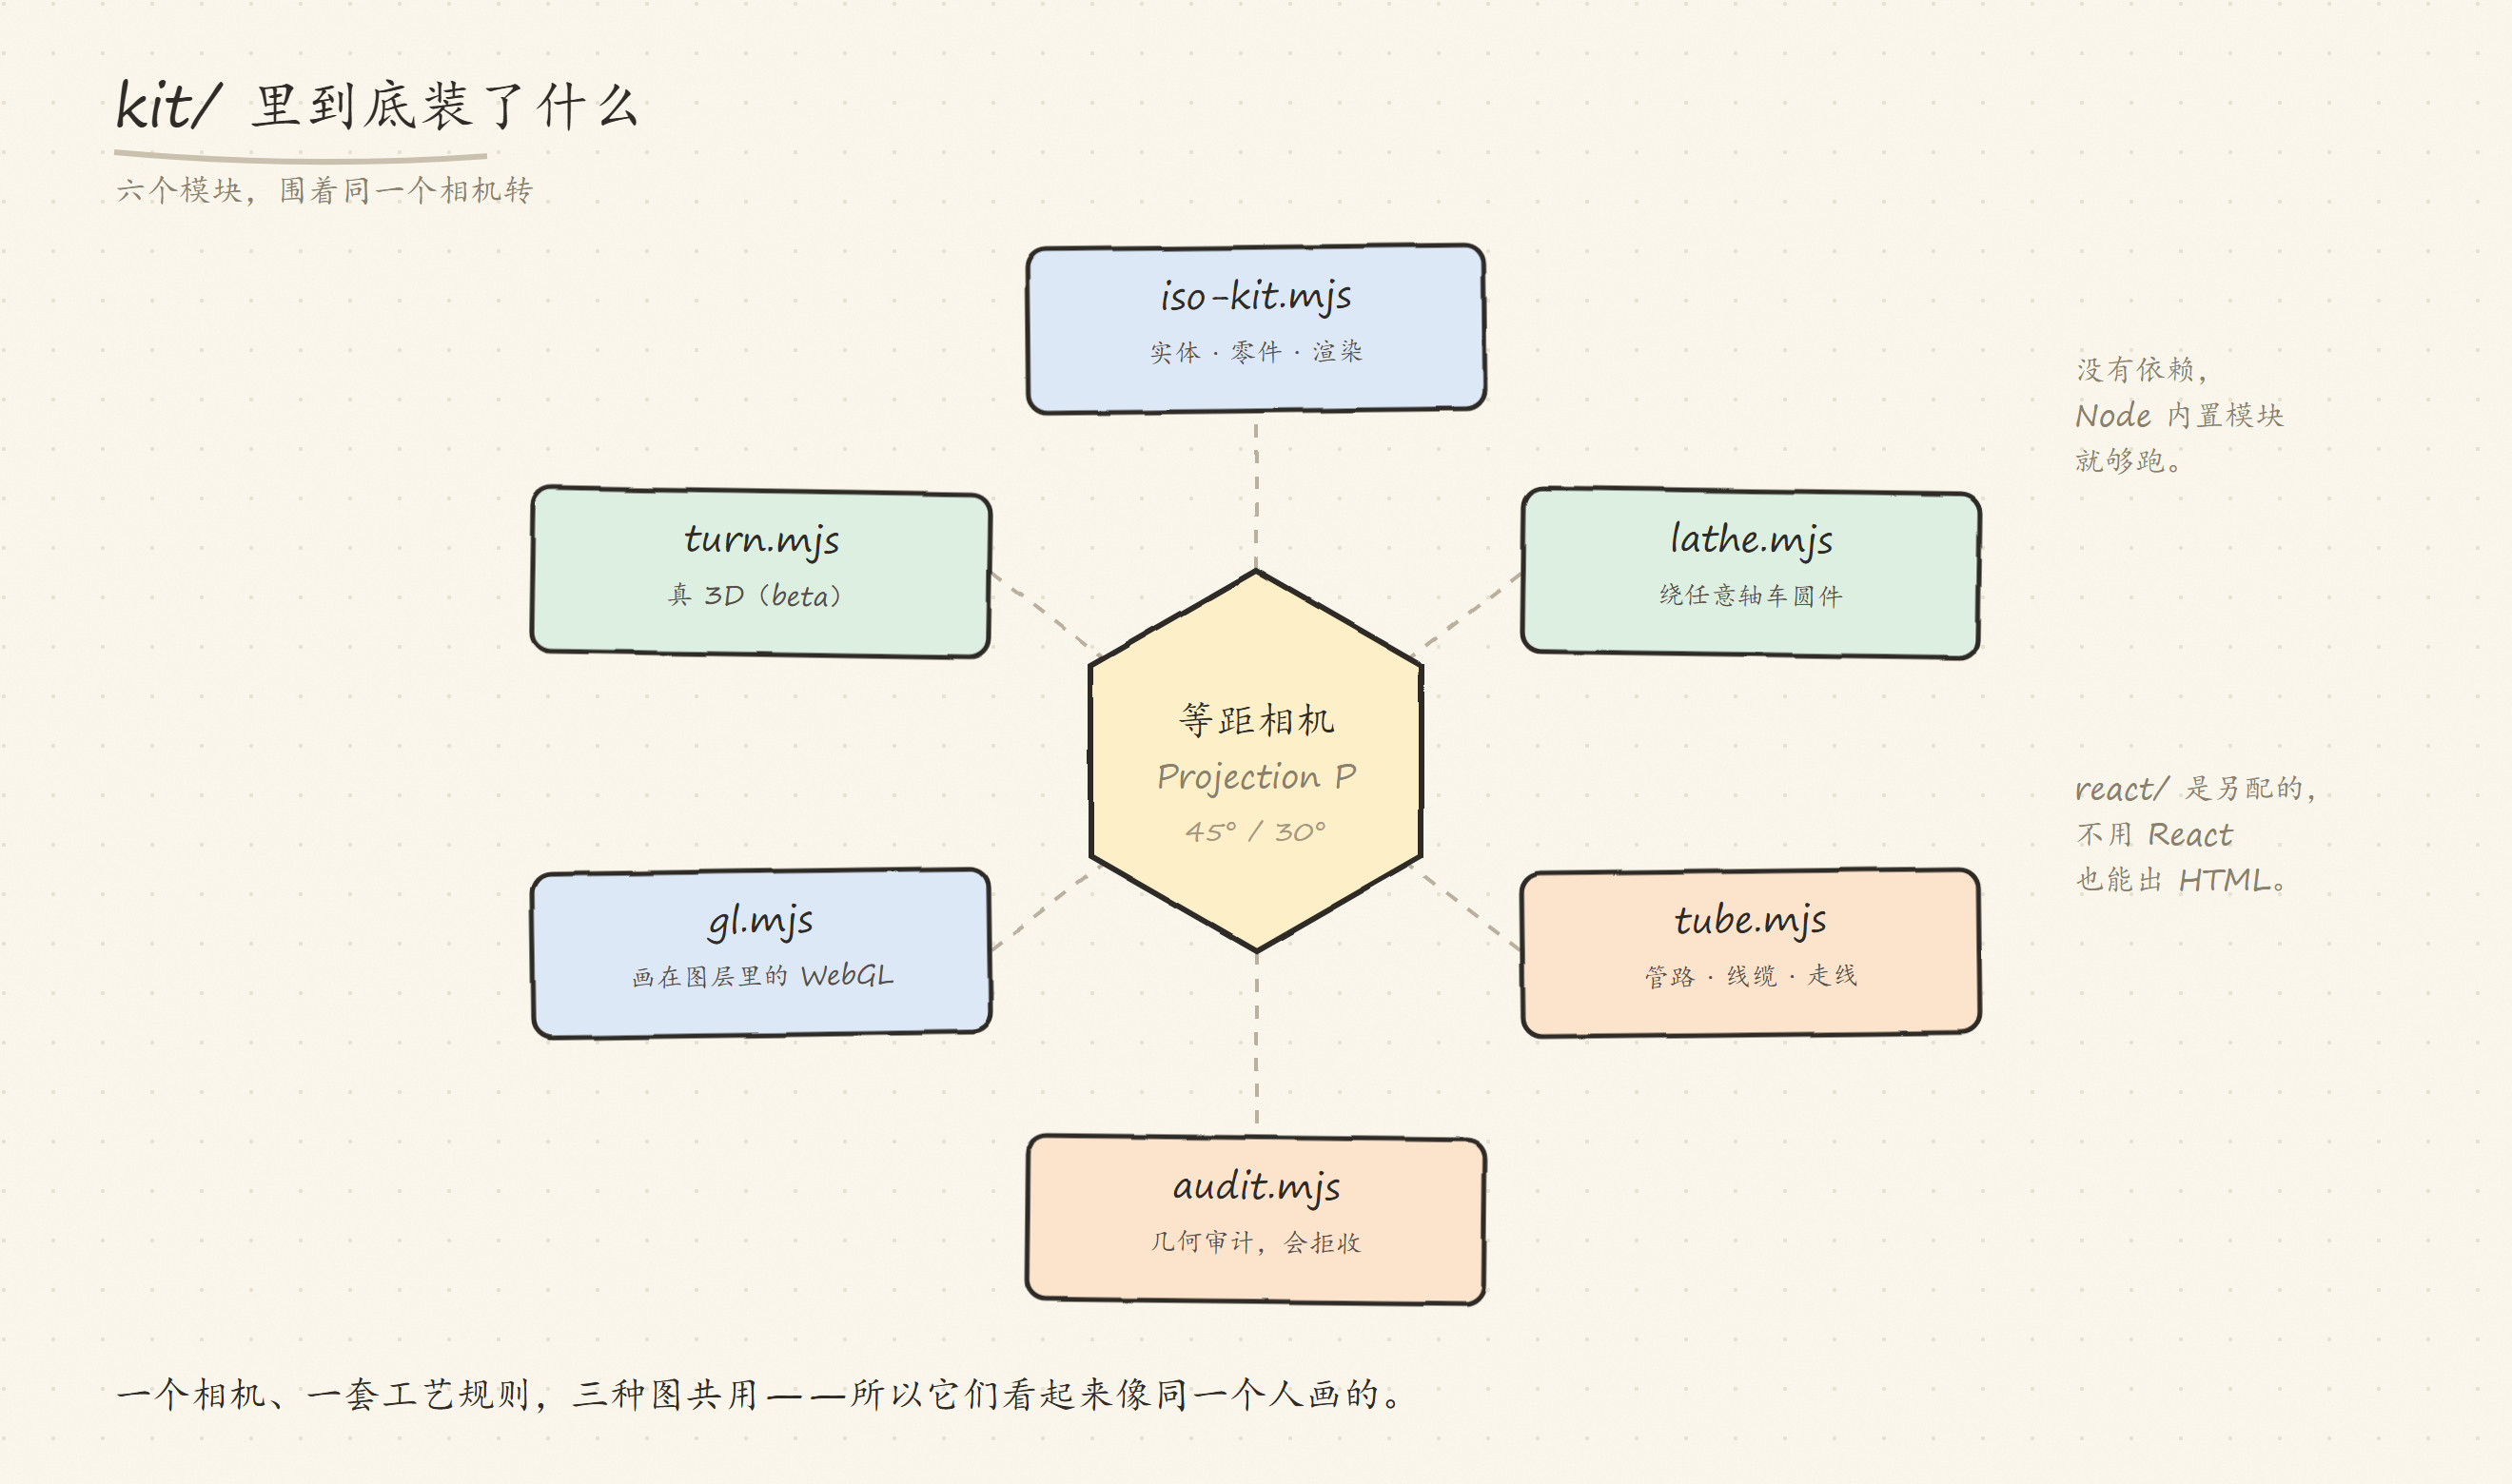
核心其实就三件事:等距投影、四档明暗、画家算法。
等距投影把三维坐标压到二维平面上。四档明暗给每个面一个固定亮度(顶面最亮、两个侧面依次变暗),这样不用光照计算也有体积感。画家算法决定谁先画谁后画,远的先画,近的后画,遮挡关系自然就对了。
// kit/iso-kit 的核心:投影 + 三面着色
const C30 = Math.cos(Math.PI / 6);
const S30 = Math.sin(Math.PI / 6);

export function iso(x: number, y: number, z: number) {
  return {
    x: (x - y) * C30,          // 水平方向:x 往右下,y 往左下
    y: (x + y) * S30 - z,      // 垂直方向:z 越大越靠上
  };
}

export function box(x, y, z, w, d, h, tone) {
  const p = (a, b, c) => iso(a, b, c);
  // 三个可见面:+x 面、+y 面、顶面
  return [
    face([p(x + w, y, z), p(x + w, y + d, z), p(x + w, y + d, z + h), p(x + w, y, z + h)], tone.dark),
    face([p(x, y + d, z), p(x + w, y + d, z), p(x + w, y + d, z + h), p(x, y + d, z + h)], tone.mid),
    face([p(x, y, z + h), p(x + w, y, z + h), p(x + w, y + d, z + h), p(x, y + d, z + h)], tone.light),
  ].join('');
}就这么点东西。真正难的不是这段代码,是用这点东西把一台机器拼对。一百多个零件,每个都要落在该落的地方,每个都要被前面的东西挡住或者挡住后面的东西。
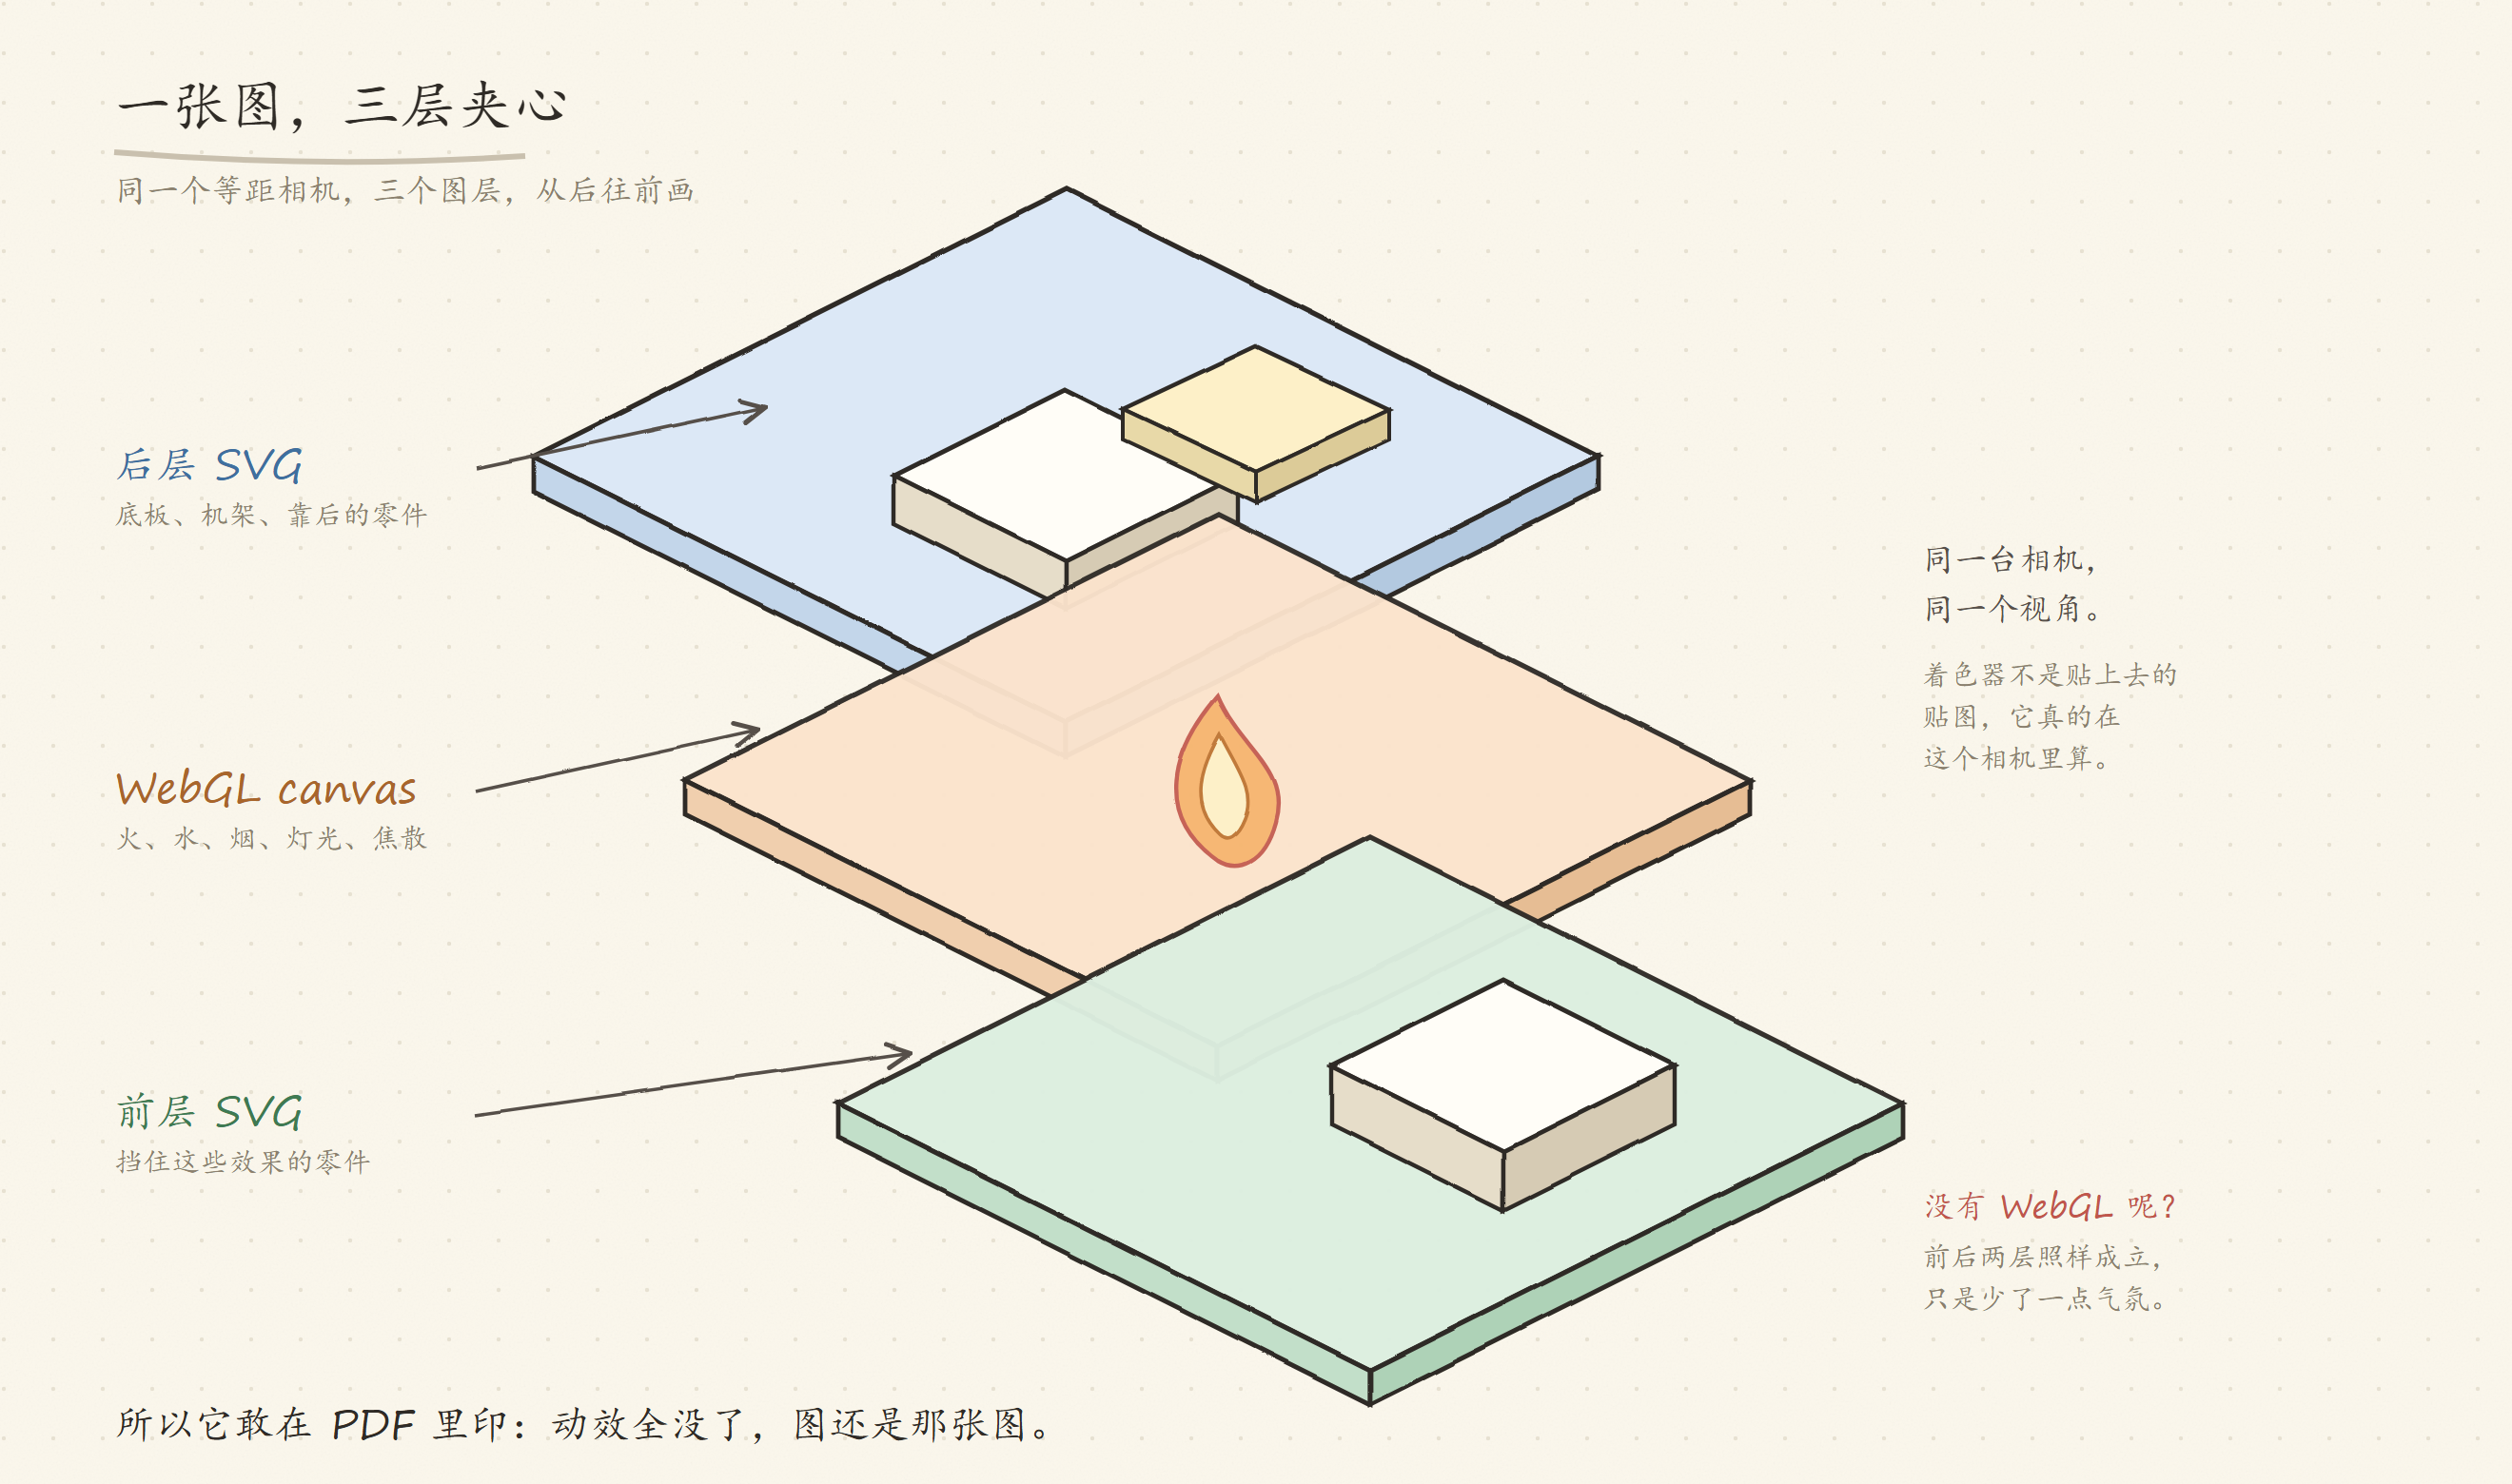
六、读数和零件必须同源
这是我踩过最深的坑,也是我觉得 Machine-Skill 最有价值的一条规则。
早期我自己写生成图的脚本,干过这种事:图上画个桶,水位大概是 60%,然后在右下角写「6 / 10 tokens」。看着没问题。
后来参数一改,桶的容量变成 8,水位线我还按 60% 画,卡片上的数字还是 6/10。图没报错,代码也没报错,但图是错的。
Anatomy 的做法很粗暴:所有数字必须来自同一个模型,图上不许手写任何数字。
// 唯一的事实来源
export type Bucket = { capacity: number; tokens: number; rate: number; last: number };

export function createBucket(capacity = 10, rate = 2): Bucket {
  return { capacity, rate, tokens: capacity, last: 0 };
}

export function refill(b: Bucket, now: number) {
  const dt = Math.max(0, now - b.last) / 1000;
  b.tokens = Math.min(b.capacity, b.tokens + dt * b.rate);
  b.last = now;
  return b;
}

export function take(b: Bucket, now: number) {
  refill(b, now);
  const ok = b.tokens >= 1;
  if (ok) b.tokens -= 1;
  return { ok, tokens: b.tokens, level: b.tokens / b.capacity };
}
然后几何那边只做一件事:把 level 翻译成高度。
const level = bucket.tokens / bucket.capacity;
const waterTop = Z0 + level * (Z1 - Z0 - 0.2);   // 水位线
const shown = bucket.tokens.toFixed(1);          // 卡片上的数字
水位和数字,一个来源,两处消费。参数怎么改都不会打架。
我把这套东西真的跑了一遍,下面是代码跑出来的图,不是手绘的:
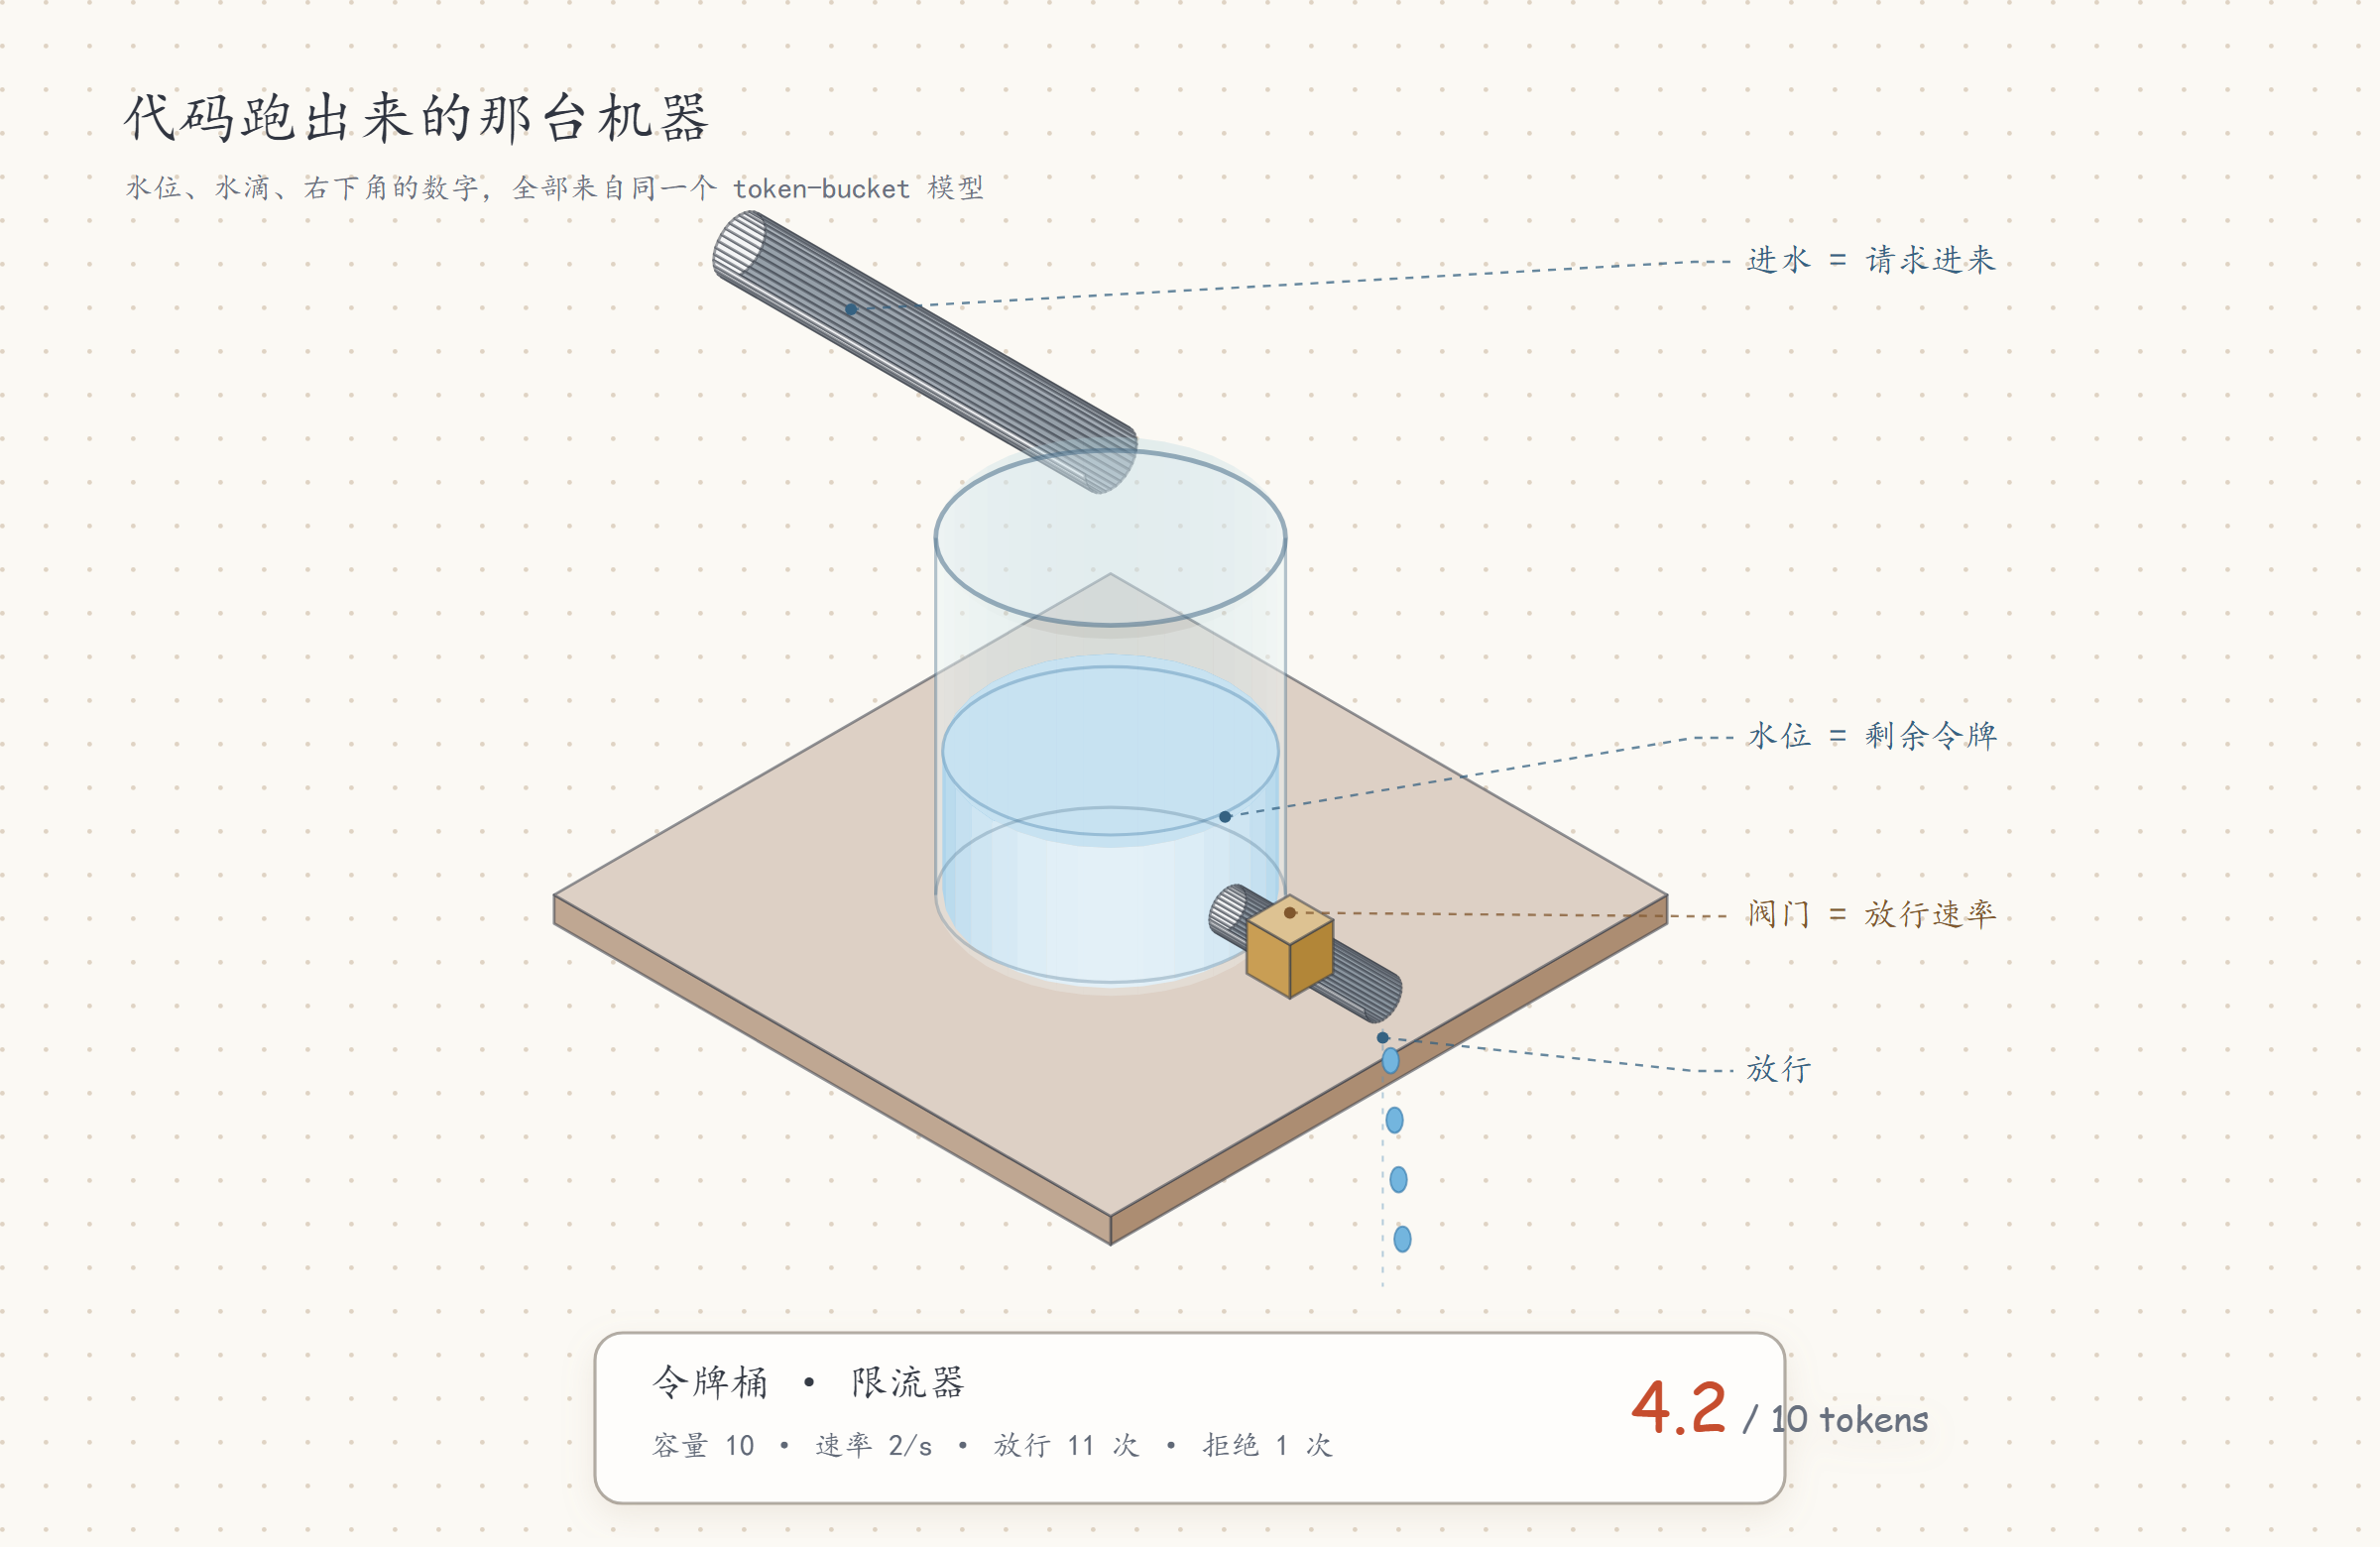
注意水滴的个数。我没有写「画四滴水」,我写的是「模型说放行了几次,就画几滴,最多四滴」。这样把并发数从 12 改成 20,水滴会自己变多,不用改绘图代码。
这就是「机器」和「图」的区别:机器会跟着参数变,图不会。
七、它怎么知道自己画错了
这是我最想让你看的一节。因为大部分人评价 AI 生成图的标准是「看着还行」,这个标准太低了。
Anatomy 的仓库里塞了三个检查工具,我愿称之为「自证清白三件套」。
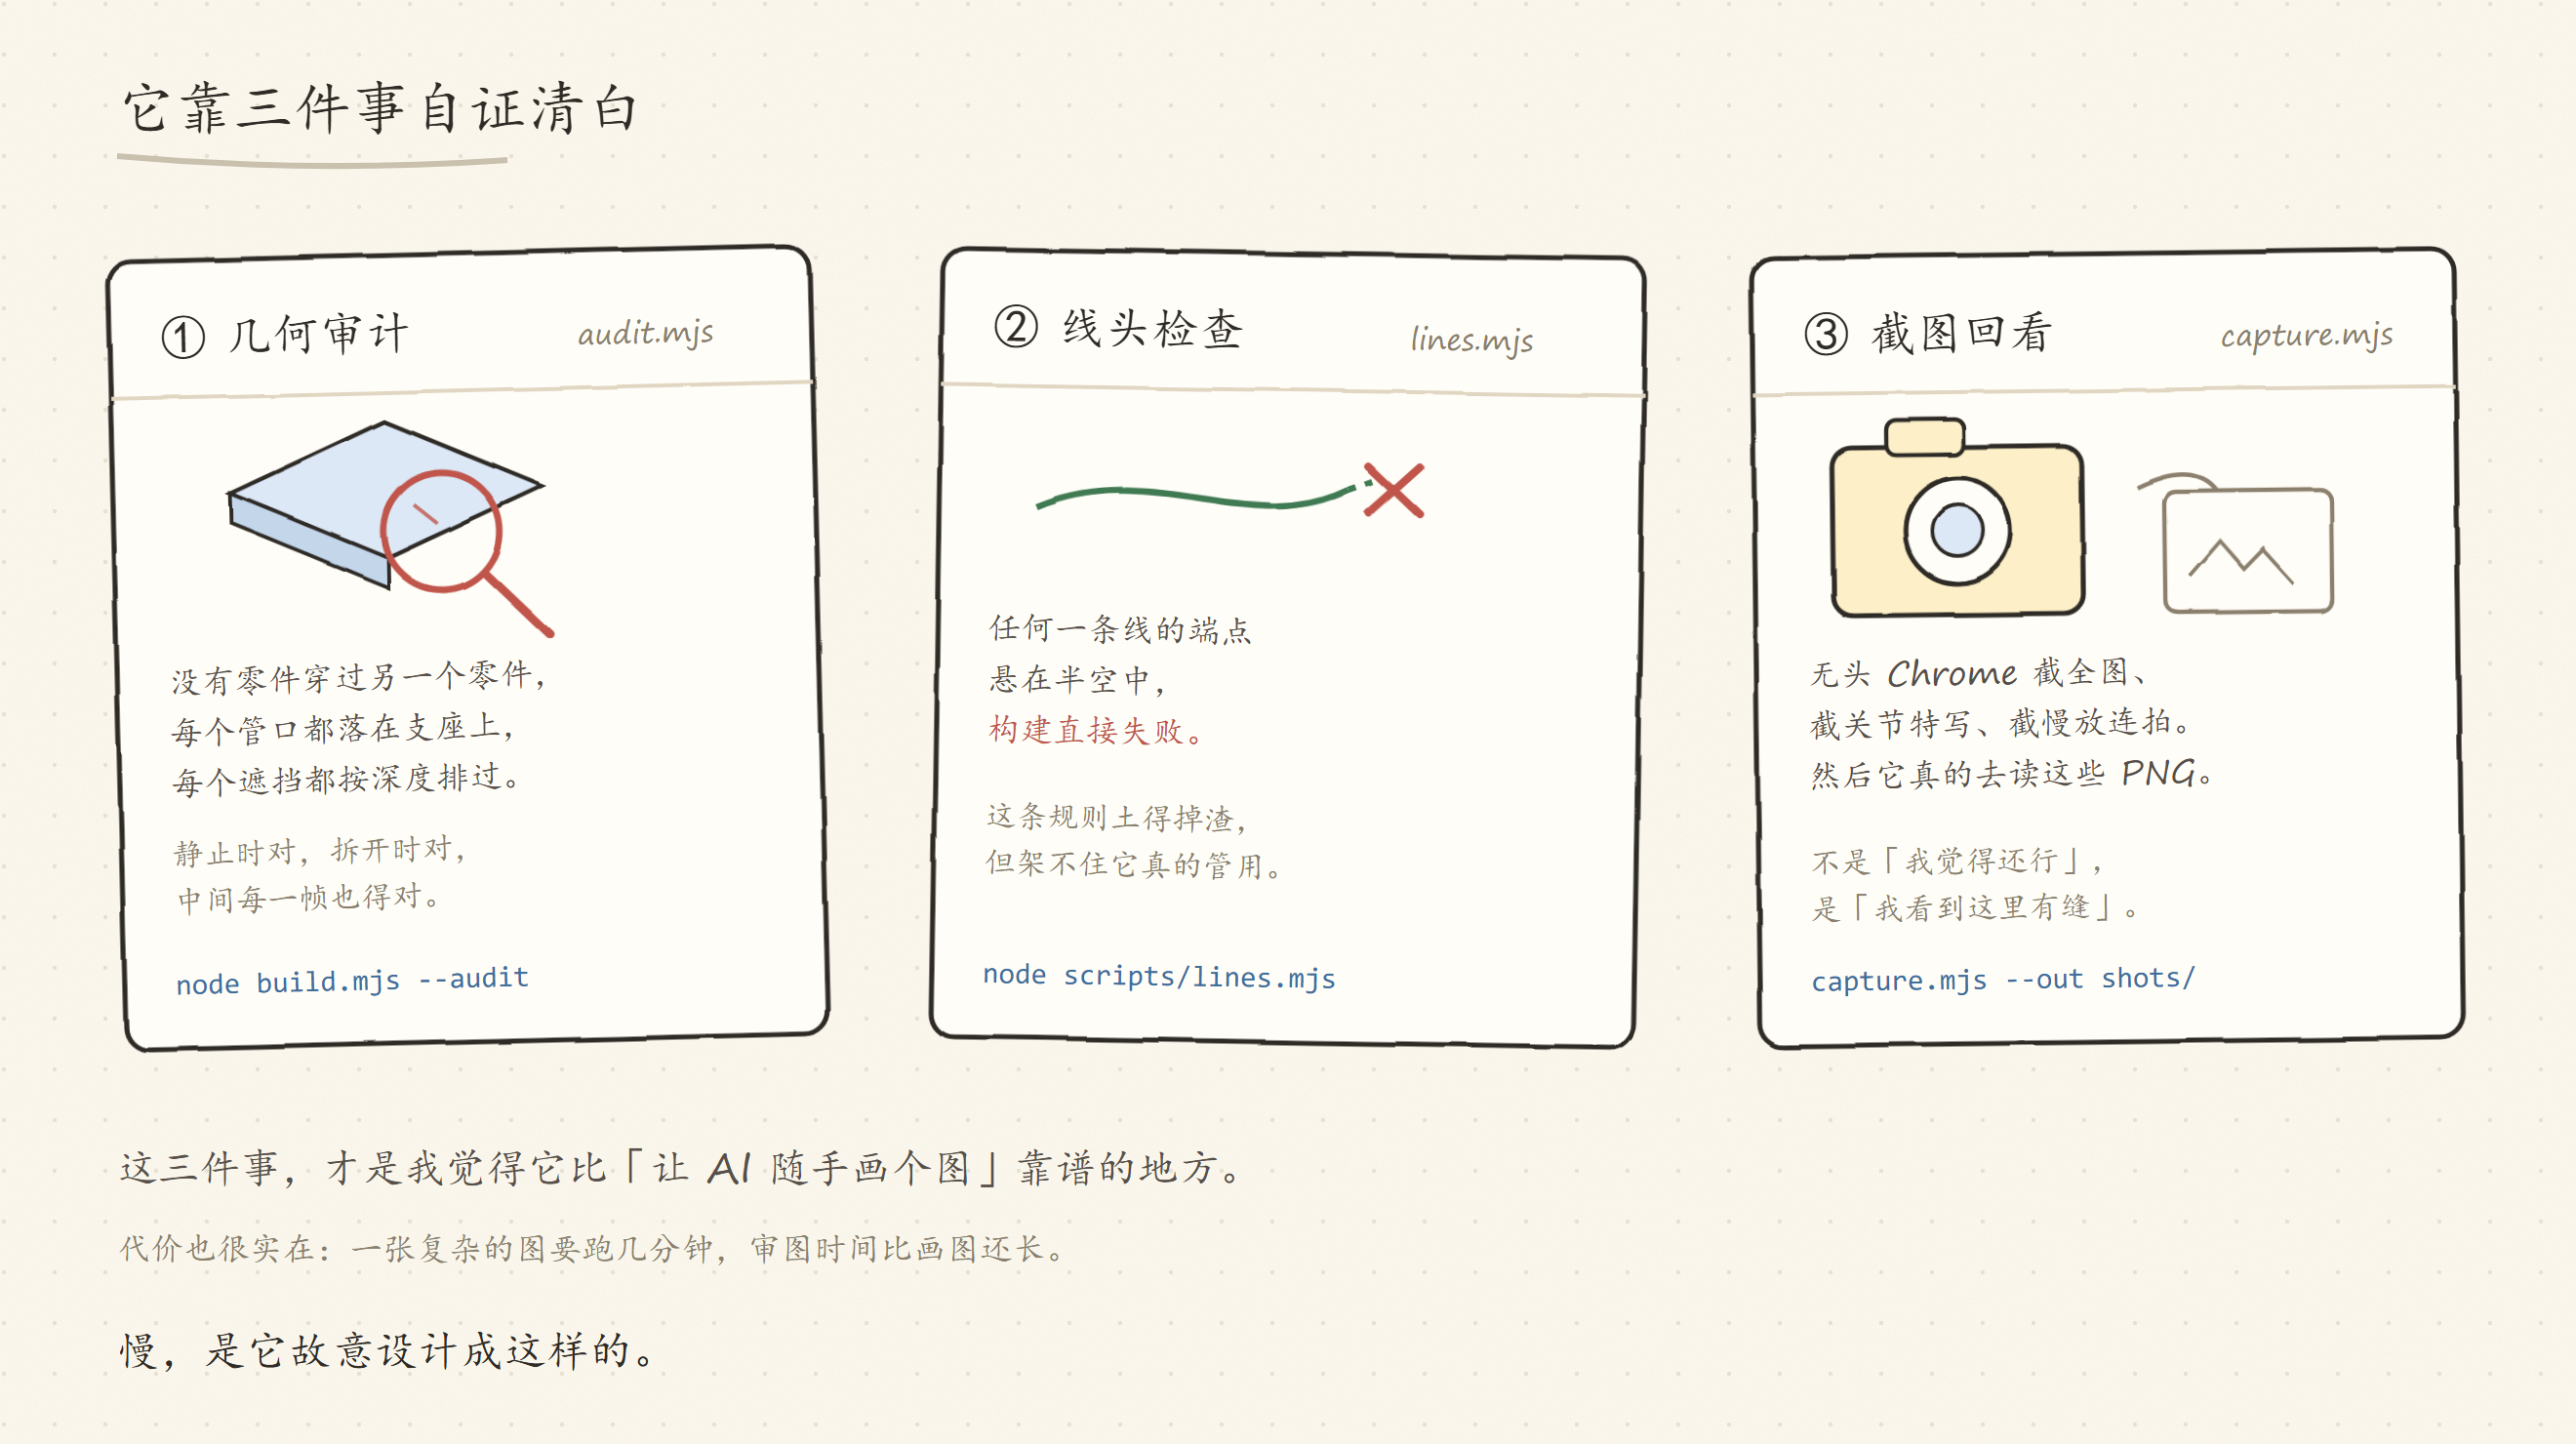
几何审计最硬核:它不看你画得好不好看,它算两个实体有没有交集。
// 简化版:轴对齐包围盒相交检测
type Box = { x: number; y: number; z: number; w: number; d: number; h: number };

const overlap = (a: Box, b: Box) =>
  a.x < b.x + b.w && b.x < a.x + a.w &&
  a.y < b.y + b.d && b.y < a.y + a.d &&
  a.z < b.z + b.h && b.z < a.z + a.h;

for (const part of parts) {
  for (const other of parts) {
    if (part === other || part.allowTouch?.includes(other.id)) continue;
    if (overlap(part.box, other.box)) {
      throw new Error(`穿模:${part.id} 撞上了 ${other.id}`);
    }
  }
}
真实的 audit.mjs 比这个复杂得多(要考虑旋转件、圆柱、管路的接触判定),但逻辑就是这个逻辑:不许穿模,不许悬空,不许出现在深度顺序里被画反。
第三个检查最有意思:无头 Chrome 截完图,它真的会去读那些 PNG。不是「我觉得应该没问题」,是「我看到了这里有条缝」。
注意中间那两次「回去改」。这个过程不是一次成型的,是反复打回。这也是为什么它慢。
八、完整实战:把「限流器」造成一台机器
前面都是拆零件,这一节把整条链路走一遍。我按真实项目里的做法写,你可以直接照着改。
场景
网关要给新来的产品经理讲清楚一件事:为什么压测的时候,有一小部分用户会拿到 429。
背景数字(这些是真实参数,不是编的):
参数 | 值 | 含义 |
|---|---|---|
capacity | 10 | 桶容量,也就是允许的突发量 |
rate | 2 /s | 每秒补充的令牌数,也就是稳态 QPS |
burst | 12 | 压测并发数 |
窗口 | 720ms | 12 个请求打完的时间 |
产品经理的诉求很具体:不要给我看架构图,我要知道「为什么第 12 个请求被拒了」。
第一步:先算,不先画
const bucket = createBucket(10, 2);
const requests = Array.from({ length: 12 }, (_, i) => ({ id: `r${i + 1}`, t: i * 60 }));

const log = requests.map((r) => {
  const res = take(bucket, r.t);
  return { ...r, ok: res.ok, tokens: +res.tokens.toFixed(2) };
});

console.table(log);
跑出来是这样:
┌─────────┬──────┬────┬────────┐
│ (index) │ id   │ t  │ tokens │
├─────────┼──────┼────┼────────┤
│ 0       │ 'r1' │ 0  │ 9      │
│ 1       │ 'r2' │ 60 │ 8.12   │
│ 2       │ 'r3' │ 120│ 7.24   │
│ 3       │ 'r4' │ 180│ 6.36   │
│ 4       │ 'r5' │ 240│ 5.48   │
│ 5       │ 'r6' │ 300│ 4.6    │
│ 6       │ 'r7' │ 360│ 3.72   │
│ 7       │ 'r8' │ 420│ 2.84   │
│ 8       │ 'r9' │ 480│ 1.96   │
│ 9       │ 'r10'│ 540│ 1.08   │
│ 10      │ 'r11'│ 600│ 0.2    │
│ 11      │ 'r12'│ 660│ 0.32   │  ← ok: false
└─────────┴──────┴────┴────────┘
第 12 个请求进来的时候,桶里只有 0.32 个令牌,不够 1 个,所以拒绝。
这一步做完,图其实已经画完了。 后面只是把这张表翻译成形状。顺序反过来的话,你会先画一个「大概满了的桶」,然后为了让故事成立去改数字,最后数字和现实对不上。
第二步:列零件清单
| 零件 | 数量 | 约束 |
|---|---|---|
| 木底座 | 1 | 9×9,厚 0.4,所有东西坐在上面 |
| 玻璃桶 | 1 | 半径 2.0,高 5.0,底面贴底座 |
| 水体 | 1 | 半径 1.92,高度 = level × 4.8 |
| 进水管 | 1 | 从左上水平进入,z = 6.5 |
| 喷嘴 | 1 | 垂直,末端在桶口上方 0.2 |
| 出水管 | 1 | 从桶右侧水平伸出,z = 1.15 |
| 阀门 | 1 | 装在出水管中段,z = 0.75 |
| 水滴 | 0..4 | 只出现在出水管末端下方 |
| 读数卡片 | 1 | 画面底部,显示 tokens / capacity |
清单的作用不是给 AI 看的,是给你自己看的。零件列不出来,说明你还没想清楚这台机器长什么样。
第三步:把零件拼起来
// demo/build.mjs(节选,可运行版本在仓库 demo/ 目录)
const TX = 4.6, TY = 4.6, R = 2.0, Z0 = 0.4, Z1 = 5.4;
const waterTop = Z0 + level * (Z1 - Z0 - 0.2);

let body = '';
body += box(0.1, 0.1, 0, 9.0, 9.0, 0.4, WOOD);          // 底座
body += cylX(-1.4, TX, TY, 6.5, 0.42, STEEL);            // 进水管
body += cylZ(TX, TY, 0.34, 5.6, 6.5, STEEL);             // 喷嘴

const tank  = cylZ(TX, TY, R, Z0, Z1, GLASS, { opacity: 0.3 });
const water = cylZ(TX, TY, R - 0.08, Z0 + 0.05, waterTop, WATER);

body += tank.back;                    // 桶的后半圈
body += water.back + water.front;     // 水体
body += tank.front; // 桶的前半圈(半透明,能看见水)这里有个细节值得说一下:玻璃桶必须拆成「后半圈 + 水体 + 前半圈」三段画。直接画一个完整的桶,水就被挡在后面了;先画水再画桶,水又会盖住桶。拆开以后,遮挡关系才是对的。
这就是第⑥步「由远及近上色」的真实含义:它不是一句口号,它决定了你的代码怎么组织。
第四步:把交互接上
图能动了,才叫机器。最小可用的交互就三行:
const valve = document.querySelector('#valve') as HTMLElement;
valve.addEventListener('input', (e) => {
  bucket.rate = Number((e.target as HTMLInputElement).value);  // 拖阀门 = 改速率
  render();                                                    // 重画,读数跟着变
});
拖阀门,速率变,水滴变密,水位下降变慢,卡片数字跟着变。产品经理拖了两下,自己就说出「哦,速率调低了桶就更容易空」这句话。
这句话是图教给他的,不是我讲的。
第五步:审计
node build.mjs --audit✗ 穿模:valve(3) 与 tank(1) 相交,重叠深度 0.12
✗ 悬空:pipe_in(2) 末端 (4.6, 4.6, 6.5) 未落在任何零件上
✓ 深度排序:47 个实体,无逆序
✓ 读数一致:card=4.2, level=0.42, capacity=10第一版就是这两条报错。阀门位置我按「贴着桶壁」摆的,结果嵌进去 0.12;进水管我忘了接喷嘴,末端悬在桶口上方。
如果没有审计,这两处我大概会放过。因为从缩略图上看,它们是对的。放大到 400% 才看得出来。
修完再跑:
✓ 穿模:0
✓ 悬空:0
✓ 深度排序:47 个实体,无逆序
✓ 读数一致:card=4.2, level=0.42, capacity=10
这才敢发出去。
九、什么时候别用它
吹完了说点实话。
第一,它不是图表工具。 你要画一张带坐标轴的性能曲线,别用它。它画的是机器、仪器、家具这类有实体结构的东西,不是数据可视化。
第二,抽象概念会翻车。 「幂等」「最终一致性」这种没有物理形态的东西,硬要造机器,很容易造出一个看起来很酷但什么也没解释的装置。这时候老老实实写文字更快。
第三,它真的很慢。 一张复杂的图,跑十几分钟很正常。你要是想批量生成 50 张封面图,用别的方案。
第四,它画不了人和地图。 说明书里写得很直白:machines, instruments, tools, furniture。人和精确地图不在射程内。
第五,3D 还是 beta。 官方自己标了,30 个零件的轨道审计要跑 15 到 20 分钟,380 个零件的压力测试只有 13 到 20 帧。能用,但别拿它做产品。
十、想把 Machine-Skill 搬进自己项目,我建议五件事
这部分是我自己的经验,跟 Anatomy 没关系,你可以直接拿走用。
1. 先定数字,再定形状。
不管你做的是报告、图表还是代码生成,先把关键数字写成常量,让所有输出都从这几个常量里取。做不到这一点,后面全是玄学。
2. 每个交付物,至少要有三条能被机器检查的规则。
「专业」「有深度」这种词不算规则。规则是「字数不少于 1500」「每个数字都要有出处」「图上不许出现手写数字」这种能被 assert 的东西。
3. 把「不合格就打回」写进流程。
不是「生成完看一眼」,是「生成完,跑检查,不合格回到第几步重来」。这一步写进技能文档,模型的行为会明显不一样。
4. 让模型自己读自己的产物。
截图、导出、渲染,然后真的去读那张图。这一步能捞出一大半的低级错误。很多人省了这一步,然后抱怨 AI 交付质量不稳定。
5. 别追求一次成型。
Anatomy 的八步里有两次打回。承认「第一遍是草稿」,比追求「一次就对」靠谱得多。慢一点,但省掉后面所有的返工。
回到最开始那个问题:为什么第 12 个请求被拒了?
以前我的答案是「因为桶空了」。这句话是对的,但它什么也没解释。
现在我的答案是:让他看着那台机器,拖一下阀门,看水位掉到 0.32,然后水滴停住。他自己会说出那句话。
概念不是被「描述」出来的,是被「造」出来的。
这大概就是 Anatomy 想说的那件事,也是我觉得 Machine-Skill 这个思路值得抄的原因。它不解决「AI 会不会画图」,它解决的是「AI 交付的东西,你怎么知道它是对的」。
后一个问题,比前一个重要得多。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号