大模型驱动 AIOps 2.0:最佳实践->云原生场景下企业一线落地案例与项目复盘
原创
大模型驱动 AIOps 2.0:最佳实践->云原生场景下企业一线落地案例与项目复盘
原创
用户5741377
修改于 2026-10-22 11:56:00
修改于 2026-10-22 11:56:00
——从告警风暴、根因研判到 对话式运维与预测式弹性的完整闭环
作者:韩先超
作者简介:腾讯云架构师北京同盟成员、清华大学出版社《Kubernetes从入门到DevOps企业应用实战》畅销书作者
关键词 | AIOps 2.0;大模型;云原生;告警降噪;RAG;ChatOps;MCP;预测式 HPA |
|---|---|
技术底座 | DeepSeek × Prometheus/Zabbix/EFK × Jenkins × Kubernetes × RAG/MCP |
【摘要】:原生架构规模化落地后,传统依赖固定阈值告警、人工排查的运维模式,已难以应对告警风暴、跨域根因定位与突发流量冲击等难题。Gartner将 AIOps 核心能力归纳为:跨域事件采集、资源拓扑构建、事件关联分析、异常模式识别与自动化修复增强;中国信通院《智能化运维(AIOps)能力成熟度模型》则从感知、分析、决策、执行、知识更新五大维度,定义了 L1~L5 的能力分级标准。2024 年调研数据显示,58.42% 的企业自评 AIOps 能力已达到 L3 进阶智能化水平;但生成式大模型在运维场景中,多数企业仍停留在研究了解阶段(占比 51.81%),完成平台自建或 API 接口接入、生产落地的案例尚属少数。本文方案无需替换企业现有监控底座,通过 10 套可落地的工程化项目,将大模型能力嵌入运维全链路,覆盖告警故事线闭环、基于 MCP+DeepSeek 的对话式运维、Zabbix/Prometheus自适应阈值、EFK 结合 RAG 挖掘隐性故障、预测式 AI-HPA、集群自然语言管理等典型场景。
正文如下:
云原生与Kubernetes技术大规模推广应用后,依托人工运维与固定阈值判断的传统运维体系,逐渐暴露出一系列突出问题:告警风暴问题突出、故障根因定位效率低下、突发流量易引发业务故障,海量日志的人工分析难以支撑业务稳定运行需求。
大模型技术的发展,使得AIOps具备生产环境落地条件。本文依托作者(韩先超)在互联网、政企、科研研究院等多场景工程项目实践,梳理了10个可落地的 AIOps 实战方案,包含告警治理、MCP+DeepSeek 对话式运维、RAG 私有运维知识库、K8s 智能管控、Pod 预测式弹性伸缩等方向,论述基于大模型搭建 AIOps 端到端闭环的建设思路、工程实现方法与落地实践经验,可为相关从业者提供参考。
主流报告里的 AIOps发展趋势
AIOps 并非新概念。Gartner 早年曾提出论断:there is no future of IT operations that does not include AIOps,即没有 AIOps,IT 运维便没有未来。其 2024 年《AIOps 平台解决方案标准》将 AIOps 平台核心能力归纳为五项:跨域事件采集、资源拓扑构建、事件关联分析、故障识别、自动化修复增强。而在 2025 年市场指南中,Gartner 进一步将该品类更名为Event Intelligence Solutions(事件智能解决方案),强调依托 AI/ML 增强可观测与监控事件处理、加速故障处置,最终实现自动化响应。此次更名并非否定 AIOps,而是将行业重心从 “平台概念叙事” 回归到从事件到动作这条可量化验收的业务价值链。
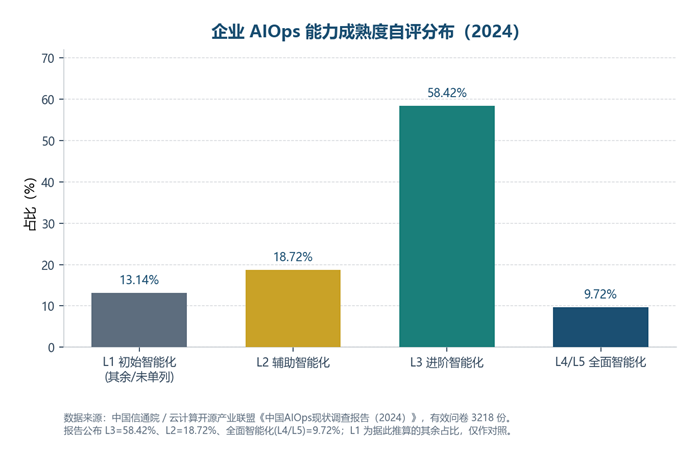
国内也形成了清晰的能力评估体系。中国信通院《云计算智能化运维(AIOps)能力成熟度模型》从感知、分析、决策、执行、知识更新五个维度,划分 L1~L5 五级能力等级。云计算开源产业联盟《中国 AIOps 现状调查报告(2024)》基于 3218 份有效问卷显示:超半数企业自评 AIOps 能力达到 L3 进阶智能化(58.42%),较 2023 年提升超 20 个百分点;L2 辅助智能化占 18.72%;仅有 9.72% 的企业自评达到 L4/L5 全面智能化阶段。当前落地主战场仍集中在质量与效率场景,包括异常检测、告警收敛、根因分析、故障恢复;同时成本与容量预测场景的关注度正在显著提升。
一、背景:传统运维面临的现实困境
从事运维行业多年,亲历了运维模式的迭代。在云原生大规模上云之前,传统运维以人工、固定阈值监控为主。但随着容器化业务爆发,K8s 集群规模持续扩大,监控指标、日志、告警数量呈爆炸式增长,传统运维模式的短板被无限放大。
在我接触过很多企业生产环境中,普遍遇到几类共性痛点:
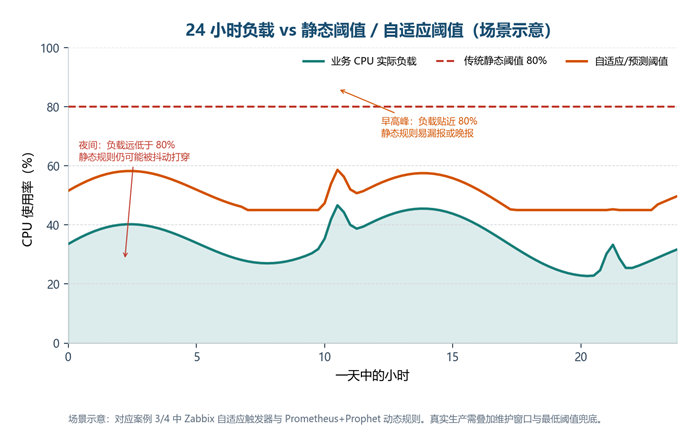
告警风暴问题:Prometheus、Zabbix 产生大量碎片化告警,一个根因故障衍生几十上百条告警,运维人员很难快速区分根因告警和衍生告警,容易被无效告警淹没,真正故障被忽略。固定阈值告警无法适配业务昼夜峰谷,高峰漏报、夜间误报频发。
故障定位效率低:故障发生后,需要人工翻阅海量容器日志、集群事件,跨多个监控平台核对指标,应急处置滞后,线上故障排查耗时久。
应急运维受环境束缚:线上突发故障,运维人员必须登录 PC、接入VPN才能操作 Jenkins 流水线、K8s 集群,夜间故障响应效率低。
知识库难以利用:企业沉淀大量故障 SOP、历史排障文档,普通大模型存在幻觉,无法结合企业私有运维知识输出准确的处置方案。
K8s原生能力存在短板:原生HPA只根据实时CPU负载做扩缩容,遇到突发流量,Pod 冷启动存在 30s2min 延迟,很容易出现503业务报错,缺少预判式弹性能力。
单纯依靠人工运维、静态阈值监控,已经很难适配云原生时代的生产诉求。大模型的到来,给 AIOps 带来真正落地的机会,但很多团队做 AIOps 容易停留在 demo 演示,很难真正落地生产。基于这个现状,我在多个企业项目中,围绕 “大模型 + 云原生 AIOps” 做了大量工程实践,沉淀一批可以直接运行、二次改造复用的项目原型。
二、AIOps 落地建设思路:拒绝炫技,以业务闭环为核心
很多团队做 AIOps 容易陷入误区:一味追求前沿大模型能力,忽略运维本身业务诉求,做出来的产品好看但无法落地生产。
我的落地思路总结为三点:
以真实运维痛点作为出发点,不做空洞技术演示,所有功能围绕告警治理、故障定位、应急处置、资源管控这些真实运维场景;
安全优先:所有自动化处置能力增加预校验、黑白名单、dryrun 模拟执行机制,避免 AI 误操作破坏生产业务;
完整闭环思维:数据采集AI 分析决策研判安全校验执行处置结果输出反馈迭代,形成完整闭环,而不是只做单纯的数据分析展示。
整体技术底座上,我主要基于DeepSeek大模型作为推理底座,结合Prometheus、Zabbix、EFK日志栈、Jenkins、K8s API、RAG 检索增强等技术,把大模型能力嵌入运维全流程。下面结合实际项目案例展开介绍。
AIOps1.0 和 2.0 到底差在哪,必须先清楚
AIOps 1.0 可以理解为:用统计、聚类、时序模型做异常检测和静态/半静态阈值,价值在「发现」;AIOps 2.0 是大模型把碎片读成故事,再通过 MCP/IM/API 把故事变成可回滚动作,并且用 RAG 把老师傅经验接回下一轮感知。AIops1.0里的Prophet、基线、动态阈值等技术在本文里仍然在用;AIOps2.0 只是把「发现之后怎么办」接上。
维度 | AIOps 1.0 | AIOps 2.0(本文) |
|---|---|---|
数据对象 | 单域指标/日志 | 指标 + 告警 + 日志 + 变更 + SOP |
核心算法 | 阈值、统计、时序预测 | 1.0 算法 + LLM 推理 + RAG |
输出形态 | 告警点、曲线、工单 | 故障故事线、证据链、可执行步骤 |
人机界面 | 控制台 / 大盘 | Web 对话 + 微信 ChatOps |
动作边界 | 通知到人 | dry-run → 确认 → 执行 → 报告回写 |
安全模型 | 较少 | 白名单、内网闭环、操作审计 |
三、一线项目实战案例分享
案例 1:告警风暴闭环治理平台,解决告警泛滥难题
技术栈:DeepSeek 大模型 + Prometheus + Alertmanager
传统监控系统,一个底层故障会连锁触发大量告警,也就是常说的告警风暴。运维人员面对几十条、上百条告警,很难快速定位源头。开发的告警风暴闭环处理平台,完整实现链路:Prometheus采集监控告警数据 → AI告警降噪过滤无效告警 → 告警关联挖掘故障故事线 → 大模型根因分析决策 → dryrun安全预校验 → 执行自动修复 → 输出报告反馈迭代优化规则。平台对接 Prometheus、Alertmanager 拉取原始告警事件,利用大模型完成告警降噪、告警关联,把碎片化告警梳理成故障故事线,区分根因告警和衍生告警。这里重点加入dryrun预执行模式,AI 输出修复方案之后,先模拟执行,不会直接改动生产,运维确认之后才真正执行修复,保障生产安全。执行结束还可以直接导出 Word 诊断报告,用于故障复盘。
落地收获:这套原型可以直接迁移到云原生生产环境,解决告警泛滥问题,把故障根因定位效率大幅提升。
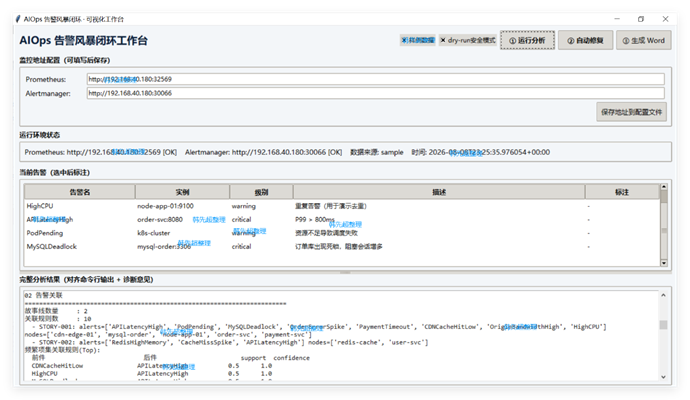
告警风暴闭环工作台
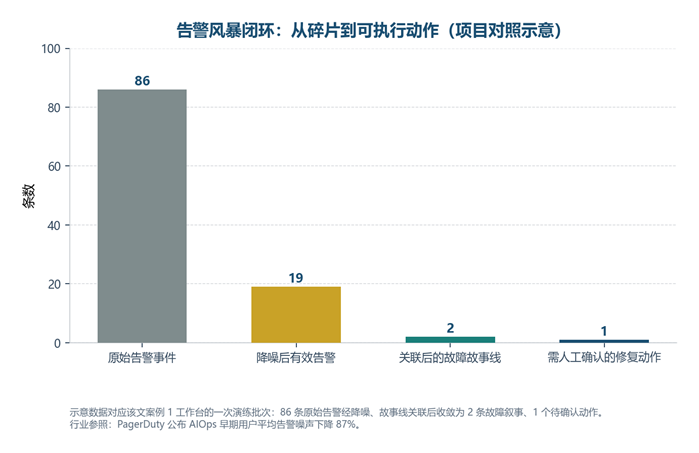
Gartner 把「把多源事件识别成同一故障及其下游效应」写成 AIOps 的关键能力。我在工程上的翻译就是强制模型输出故事线:时间、对象、依赖、源头告警、衍生告警。没有故事线的根因,值班运维不敢签字。dry-run 则对应 EIS 所说的 accelerated remediation——加速修复,但不是绕过责任。
案例 2:对话式运维平台建设,自然语言完成运维操作
单纯靠命令行操作,对运维人员门槛高,遇到夜间故障,还需要登录电脑、接入 VPN。我做了两套不同形态 ChatOps 实践。
1)基于 MCP 协议的 Web 对话运维操作台
技术栈:DeepSeek 大模型 + MCP 模型上下文协议 + Jenkins DevOps + Streamlit
通过 MCP 协议标准化打通大模型与 Jenkins DevOps 流水线,运维人员输入自然语言,就可以查询流水线、触发构建、查看任务状态,不需要记忆复杂命令。
完整闭环:自然语言输入 → MCP 协议解析调度 → 调用 Jenkins 接口执行 DevOps 操作 → 获取流水线数据 → AI 分析故障状态输出诊断建议。
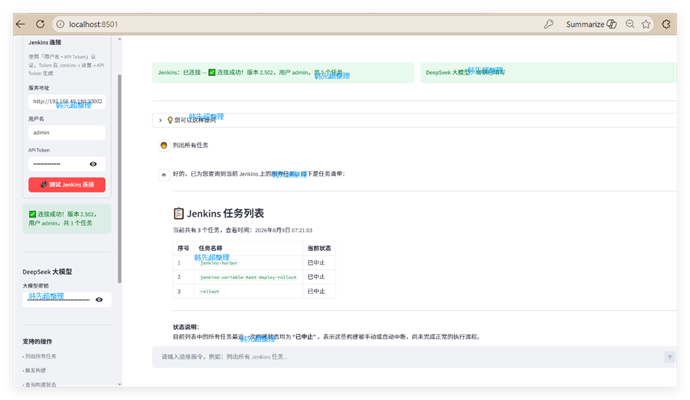
MCP + DeepSeek 对话式运维台:自然语言查询 Jenkins 任务并给出状态解释
2)微信端 ChatOps 机器人 OpenClaw
技术栈:OpenClaw (ClawBot) + 微信 IM + DeepSeek + Jenkins
把运维能力集成到微信聊天窗口。手机发送自然语言指令,即可触发 Jenkins 构建、查询流水线状态、读取构建日志,识别人工审批阻塞节点,手机端直接拿到故障处置建议。解决夜间突发故障必须登录 PC 后台的痛点,真正实现移动应急运维。
这一段和 CloudQ 强调的全渠道 ChatOps 是同一类问题:运维已经活在 IM 里,AIOps 如果还要求再学一套控制台,使用频率会掉成「汇报时提一句」。我给 ChatOps 定的铁律是——只读查询可以快,变更必须二次确认,聊天记录就是审计日志。MCP 的价值则是把「查流水线、拉日志、改副本」收成可插拔 Skill,而不是写死在 Prompt 里。
案例 3:大模型结合传统监控 Zabbix,实现 AI 根因分析与自适应告警
很多企业存量环境依旧大量使用 Zabbix 监控,如何把大模型能力赋能传统监控,也是非常现实的课题。
1)Zabbix 集成DeepSeek 开发桌面故障分析工具
基于 Python TKinter 开发桌面工具,对接 Zabbix JSONRPC API,自动拉取多时间窗口监控、告警数据,检测 CPU 内存高占用进程,交给大模型完成根因研判,输出故障报告、修复方案。同时设计进程黑白名单安全机制,白名单业务进程支持安全自动重启,核心系统进程强制保护,规避误操作风险,整套工具运行在内网,监控数据不会对外泄露。
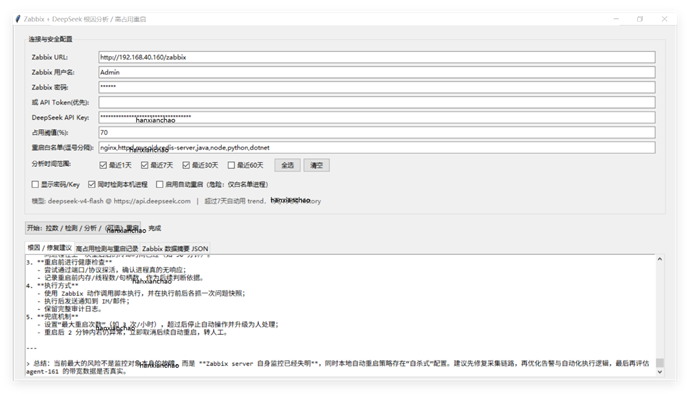
内网桌面工具:Zabbix 多时间窗口采集 + DeepSeek 根因报告 + 白名单重启
2)Zabbix 自适应CPU 告警触发器
传统 Zabbix 静态阈值,业务高峰、低谷很容易出现误报漏报。我通过 Python+Paramiko SSH 远程采集服务器 CPU 负载,算法动态计算告警阈值,调用 Zabbix API 自动更新触发器表达式,增加最低阈值保护兜底,实现告警规则自适应业务波动,减少大量无效告警。该方案同样可以拓展到内存、磁盘、网络等各类监控指标。
history 和 trend 不能混用:短窗口看 history,长窗口看 trend,粒度错了,模型会把平滑均值当成「一直很稳」。这是传统监控二次开发里最容易被大模型放大的坑。
案例 4:时序预测实现 Prometheus 动态告警与K8s预测式 AIHPA
静态阈值的问题在 Prometheus 体系同样存在。
1)Prophet 时序预测做 Prometheus 自适应告警
基于 Python 拉取 Prometheus 历史时序指标,使用 Prophet 时序预测模型学习业务周期规律,计算动态告警阈值;通过 Paramiko 远程修改 rules.yml 告警配置,远程重启 Prometheus 让规则生效,区分日间高峰、夜间低负载两套阈值策略,降低误告警。
2)AI 预测式弹性扩缩容操作台(AI-HPA)
K8s 原生 HPA 只看当前实时负载,流量突增的时候,Pod 冷启动延迟,极易出现 503 错误。我们引入大模型做流量预判:Prometheus 持续采集 CPU、内存、QPS、延迟时序数据,汇总历史指标交给大模型,输出未来 10/30/60 分钟负载预测以及副本数建议,再通过 K8s API 调整 Deployment 副本,做到流量到来之前主动扩容,规避突发流量故障。
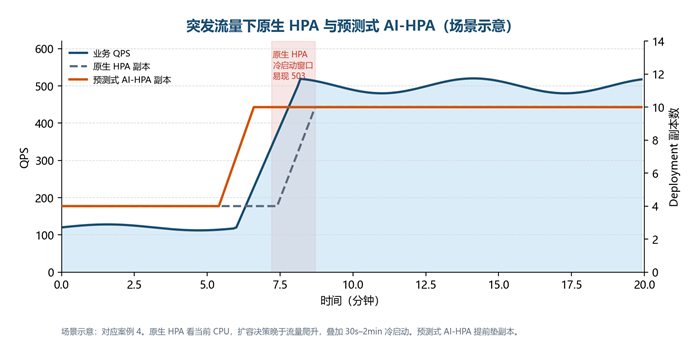
突发流量下原生 HPA 的冷启动窗口 vs 预测式 AI-HPA 提前调副本
预测结果在生产上从不直接覆盖人工红线,而是「预测建议 ∩ 安全下限 ∩ 变更冻结窗口」。节假日、全量发布、演练日,模型降级为建议,不当控制平面。防抖同样关键,否则预测抖动会把集群扩缩成拉锯。信通院 2024 年报告里成本与容量预测关注度显著上升,这一段就是把「关注」落成可调用的 API。
案例 5:日志 AI 异常检测 + RAG 私有知识库,挖掘隐性故障
海量 K8s 日志里面隐藏很多隐性故障,传统监控很难发现,人工排查日志效率极低。
1)EFK 日志栈 AI 异常检测平台
对接 Elasticsearch,读取 EFK 采集的 K8s 集群日志,基于历史日志训练集群健康基线,AI 识别偏离基线的异常日志片段,大模型完成故障研判,输出包含风险等级、影响范围、根因、应急方案的运维报告,支持 Word/PDF 导出,解决日志大海捞针式排障难题。
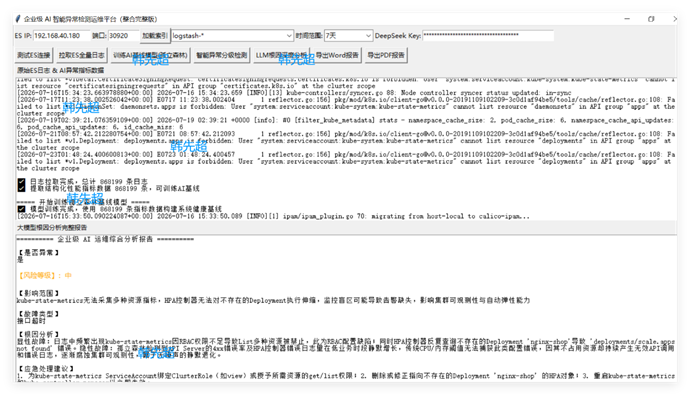
EFK 日志基线 + 大模型研判:输出风险等级、影响范围与处置建议
工程上必须「统计和基线做召回,大模型做解释」。让 LLM 直接扫全量日志又贵又慢,还容易被重复堆栈带跑。这与信通院可观测性标准里「采集—存储—处理—观测」的层次是一致的:模型只能站在处理好的数据之上。
2)基于 RAG 的运维私有知识库问答系统 & K8s RAG 故障诊断平台
通用大模型存在幻觉,输出的排障方案不一定匹配企业内部环境。我们把企业故障手册、SOP、历史真实案例做向量库,搭建 RAG 私有知识库。遇到故障,输入故障现象,RAG 检索企业内部文档,大模型整理输出可直接复制执行的 Shell 命令、排障步骤。在此基础之上,我还实现 K8s Pod 一键诊断工具,自动采集 Pod 状态、容器日志、集群事件,结合 RAG 知识库,一键输出完整故障诊断报告,替代人工翻阅海量日志排查问题。
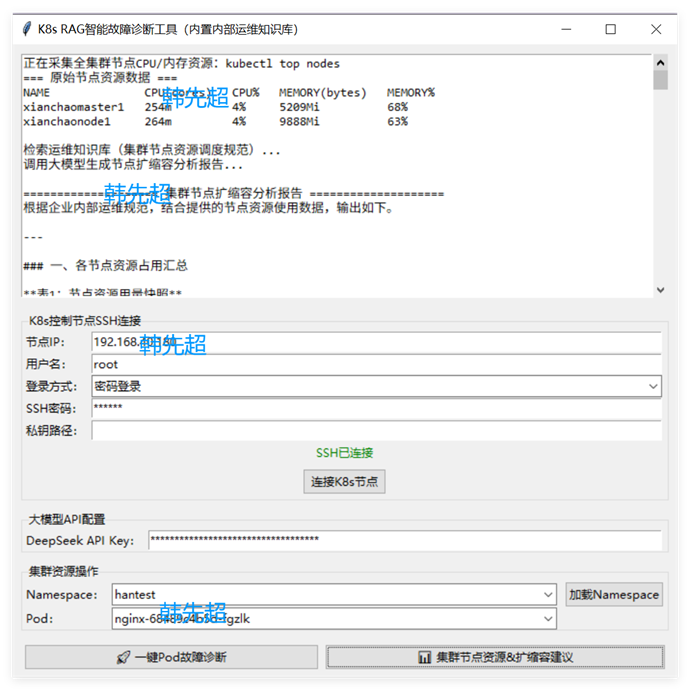
K8s RAG 诊断工具:采集节点/Pod 现场数据,检索内部规范后生成扩缩容与排障报告
我会要求输出出现知识库条目标题;对不上的,必须写「知识库未覆盖,仅作假设」。这是建立信任最低成本的办法,也对应报告里「可解释性」这一主要顾虑。
案例 6:自然语言驱动 K8s 智能工作台、低代码快速开发运维平台
K8s 原生 kubectl 命令复杂,普通人员上手门槛高。
1)MCP 自然语言 K8s 运维工作台,基于 Streamlit 搭建 Web 控制台,内网部署,输入中文自然语言,解析转换 MCP 标准化 JSON 指令,调用 K8s APIServer 完成资源增删改查,做到 “说话管理 K8s 集群”,降低操作门槛。
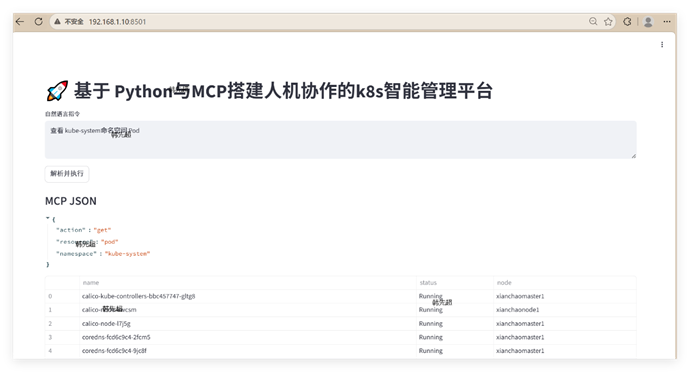
自然语言 → MCP JSON → APIServer:人机协作的 K8s 智能管理台
2)同时实践 Cursor AI 辅助开发,快速搭建两套 Web 平台:一套私有化运维对话编程助手,内网环境,输入自然语言生成 Nginx 配置、Dockerfile、K8s YAML、Shell 脚本;另一套轻量化 K8s 集群管理系统,30 分钟完成基础版本,网页完成 Namespace、Deployment、Pod 等资源全生命周期管理,不用依赖官方 Dashboard。
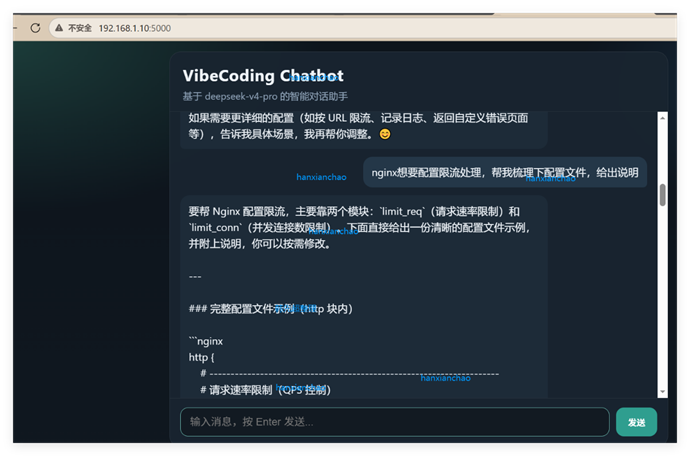
内网 VibeCoding 助手:用自然语言生成带注释的 Nginx 限流等运维配置
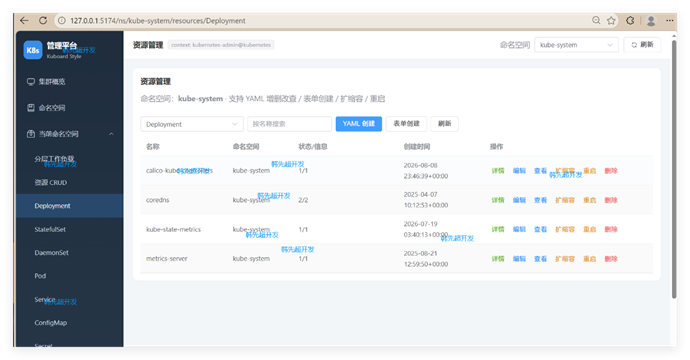
轻量化 K8s 管理台:表单/YAML 完成工作负载全生命周期,数据不出集群
人不用背 kubectl,但系统内部必须是可审计的 API 调用,而不是模型自由发挥。这和「Skill 资产共创」是同一件事:查资源、改副本、生成清单,都要有输入、输出、失败处理和爆炸半径。
项目 | 解决的现场问题 | 智能层 | 安全垫 | 可沉淀 Skill |
|---|---|---|---|---|
告警风暴闭环 | 碎片告警淹没根因 | 降噪/关联/RCA | dry-run、报告回写 | Alert-Storyline |
MCP 对话台 | 命令行门槛、工具割裂 | 意图解析 | 只读默许/变更确认 | Pipeline-Ops |
微信 ChatOps | 夜间必须连 VPN | 日志与阻塞识别 | IM 二次确认、审计 | Mobile-ChatOps |
Zabbix+LLM | 存量监控无法用 AI | 根因报告 | 进程黑白名单、内网 | Legacy-RCA |
自适应阈值 | 峰谷误报漏报 | 动态表达式 | 最低阈值兜底 | Adaptive-Threshold |
Prophet 规则 | Prometheus 静态 rule | 周期预测 | 冻结窗口 | Predict-Threshold |
AI-HPA | 冷启动 503 | 10/30/60 分钟预测 | 防抖、下限 | Predictive-HPA |
EFK 基线 | 日志里的隐性故障 | 偏离检测+研判 | 结构化报告 | Log-Baseline |
RAG SOP | 幻觉、环境不匹配 | 检索增强 | 强制引用文档 | Ops-RAG |
K8s 工作台 | kubectl 门槛 | NL→MCP JSON | 内网、RFC1123 清洗 | K8s-NL-Ops |
表 4 十个项目一览:问题、智能层、安全垫与可共创 Skill(便于抽成行业资产)
四、落地过程当中踩过的坑与实践感悟
在这么多项目落地过程中,我也踩过不少坑,这里做几点经验总结:
不要过度信任大模型输出结果,安全机制必不可少:AIOps 自动化处置,最核心是生产安全。直接让大模型执行操作风险极高。所以几乎所有项目都增加 dry-run 模拟预执行、黑白名单、操作日志留存,AI 给出方案之后,优先给到人做确认,再执行,不能完全交给 AI 自主决策。
大模型不是万能,要做好能力边界划分:大模型擅长文本推理、日志解读、根因分析、方案生成;但是原始指标采集、接口调用、集群操作,交给传统程序、SDK 去完成。大模型作为 “大脑”,而不是包揽全部工作。
优先复用企业现有监控底座,不要推倒重来:很多企业已经有 Zabbix、Prometheus、EFK,落地 AIOps 不需要替换原有系统,而是做二次开发对接,把 AI 能力叠加在现有运维体系之上,落地成本更低,更容易被企业接受。
Demo 原型和生产落地中间有巨大鸿沟:做演示 demo 很容易,但是生产环境要考虑鉴权、内网隔离、权限管控、异常重试、超时、日志审计。我所有项目原型优先保证内网闭环,数据不出企业集群,适配企业安全管控要求。
RAG 知识库质量决定输出效果:RAG 运维知识库,文档质量、切片策略直接影响回答准确度,如果知识库本身 SOP 文档质量差,再强大的大模型也无法输出可靠排障方案。
我把生产动作分成三级,建议写进规范
级别 | 典型动作 | 是否自动 | 必须具备的垫子 |
|---|---|---|---|
L0 只读 | 查询、摘要、报告、故事线 | 可自动 | 鉴权、脱敏、审计 |
L1 可逆变更 | 扩副本、重跑流水线、白名单重启 | dry-run + 人确认 | 白名单、回滚点、超时 |
L2 高爆炸半径 | 删资源、改生产配置、关节点 | 默认不自动,只出方案 | 双人、窗口期、变更单 |
五、总结与展望
AIOps这个概念提出很多年了。AIOps1.0 时代,主要靠时序算法、固定统计规则做异常检测,很多项目看着好看,但很难真正落地到生产。 等到 DeepSeek、ChatGPT 这类大模型出来之后,AIOps 正式进入2.0 时代。我在给各类企业做培训的时候,明显看到:越来越多成熟项目已经真正落地跑起来了。
但大家一定要理清定位:AIOps 不是用 AI 把运维工程师替代掉。它核心是把人从告警轰炸、反复排查日志、写重复脚本这些枯燥机械的工作里释放出来,让工程师专注架构优化、深度故障治理这些高价值工作。
这次分享的 10 个实战项目原型,包含告警治理、对话式运维、RAG 运维知识库搭建、K8s 智能管控、预测弹性伸缩等场景,都可以二次改造,直接移植到企业环境。
后续我也会持续深耕大模型结合云原生的 AIOps 方向,持续打磨告警闭环、K8s 智能故障诊断、预测式弹性伸缩方案,也希望和行业各位同行多多交流,共同推动 AIOps落地,一起推动AIOps更好发展。
#AIOps最佳实践
#一线落地案例
#AIOps一线落地案例
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号