概述
企业在自建 GPU 集群上私有化部署大模型时,完成模型部署仅为第一步,决定生产可用性的是模型前置的流量治理层。单张 GPU 的吞吐存在上限,单个推理节点存在故障风险,集群规模亦会随业务增长而变化。若各业务直连固定节点,将出现节点间负载不均,以及单节点故障导致业务整体不可用的问题。传统做法是自建负载均衡并监控以应对上述问题,但通用负载均衡器无法感知大模型推理的负载特征:其仅能识别连接数,无法识别单个请求消耗的 Token 数量、Cache 占用情况,以及不同请求长度带来的算力差异。结果通常表现为请求分配均匀,但 GPU 利用率不均。
在该场景中,模型路由 CMR 承担负载均衡网关职能。它对上提供统一的 OpenAI 兼容入口,对下按面向推理的策略将请求分发至多个 GPU 节点,并内建健康探测与用量监控。相较自建负载均衡监控,CMR 使客户以近乎零运维的方式获得负载均衡、故障定位与性能监控等能力,从而专注于模型与业务本身。
方案价值
负载均衡的目标并非请求数均匀,而是算力利用率最大化、尾延迟最小化与故障影响最小化。CMR 面向推理场景的调度策略即围绕上述目标设计。其中较易被低估的是调度策略选型带来的差异。以最低繁忙路由为例,其将新请求分配至当前最空闲的节点,可规避长请求集中导致的排队;最低延迟路由则更适用于节点性能不均的场景,直接以端到端时延为优化目标。对同一 GPU 集群,仅调整调度策略即可能在吞吐或尾延迟上获得可观提升。此即面向推理优化的网关相较通用负载均衡器的价值所在。同时用户也可指定模型优先级与权重,网关将按优先级权重进行请求分配。
维度 | 客户收益 | 实现机制 |
负载均衡 | 面向推理负载的调度,充分利用每张 GPU,提升集群整体吞吐。 | 优先级权重 / 最低繁忙 / 最低延迟 / 用量均衡策略 |
高可用 | 健康探测自动剔除故障节点,恢复后自动回补,无需人工介入。 | 健康探测 |
性能监控 | 统一采集延迟、Token 用量并呈现,直接观测性能。 | 可观测能力 |
降本增效 | 免去自建负载均衡与监控、扩缩容与运维成本,开箱即用。 | 托管式网关能力 |
架构说明
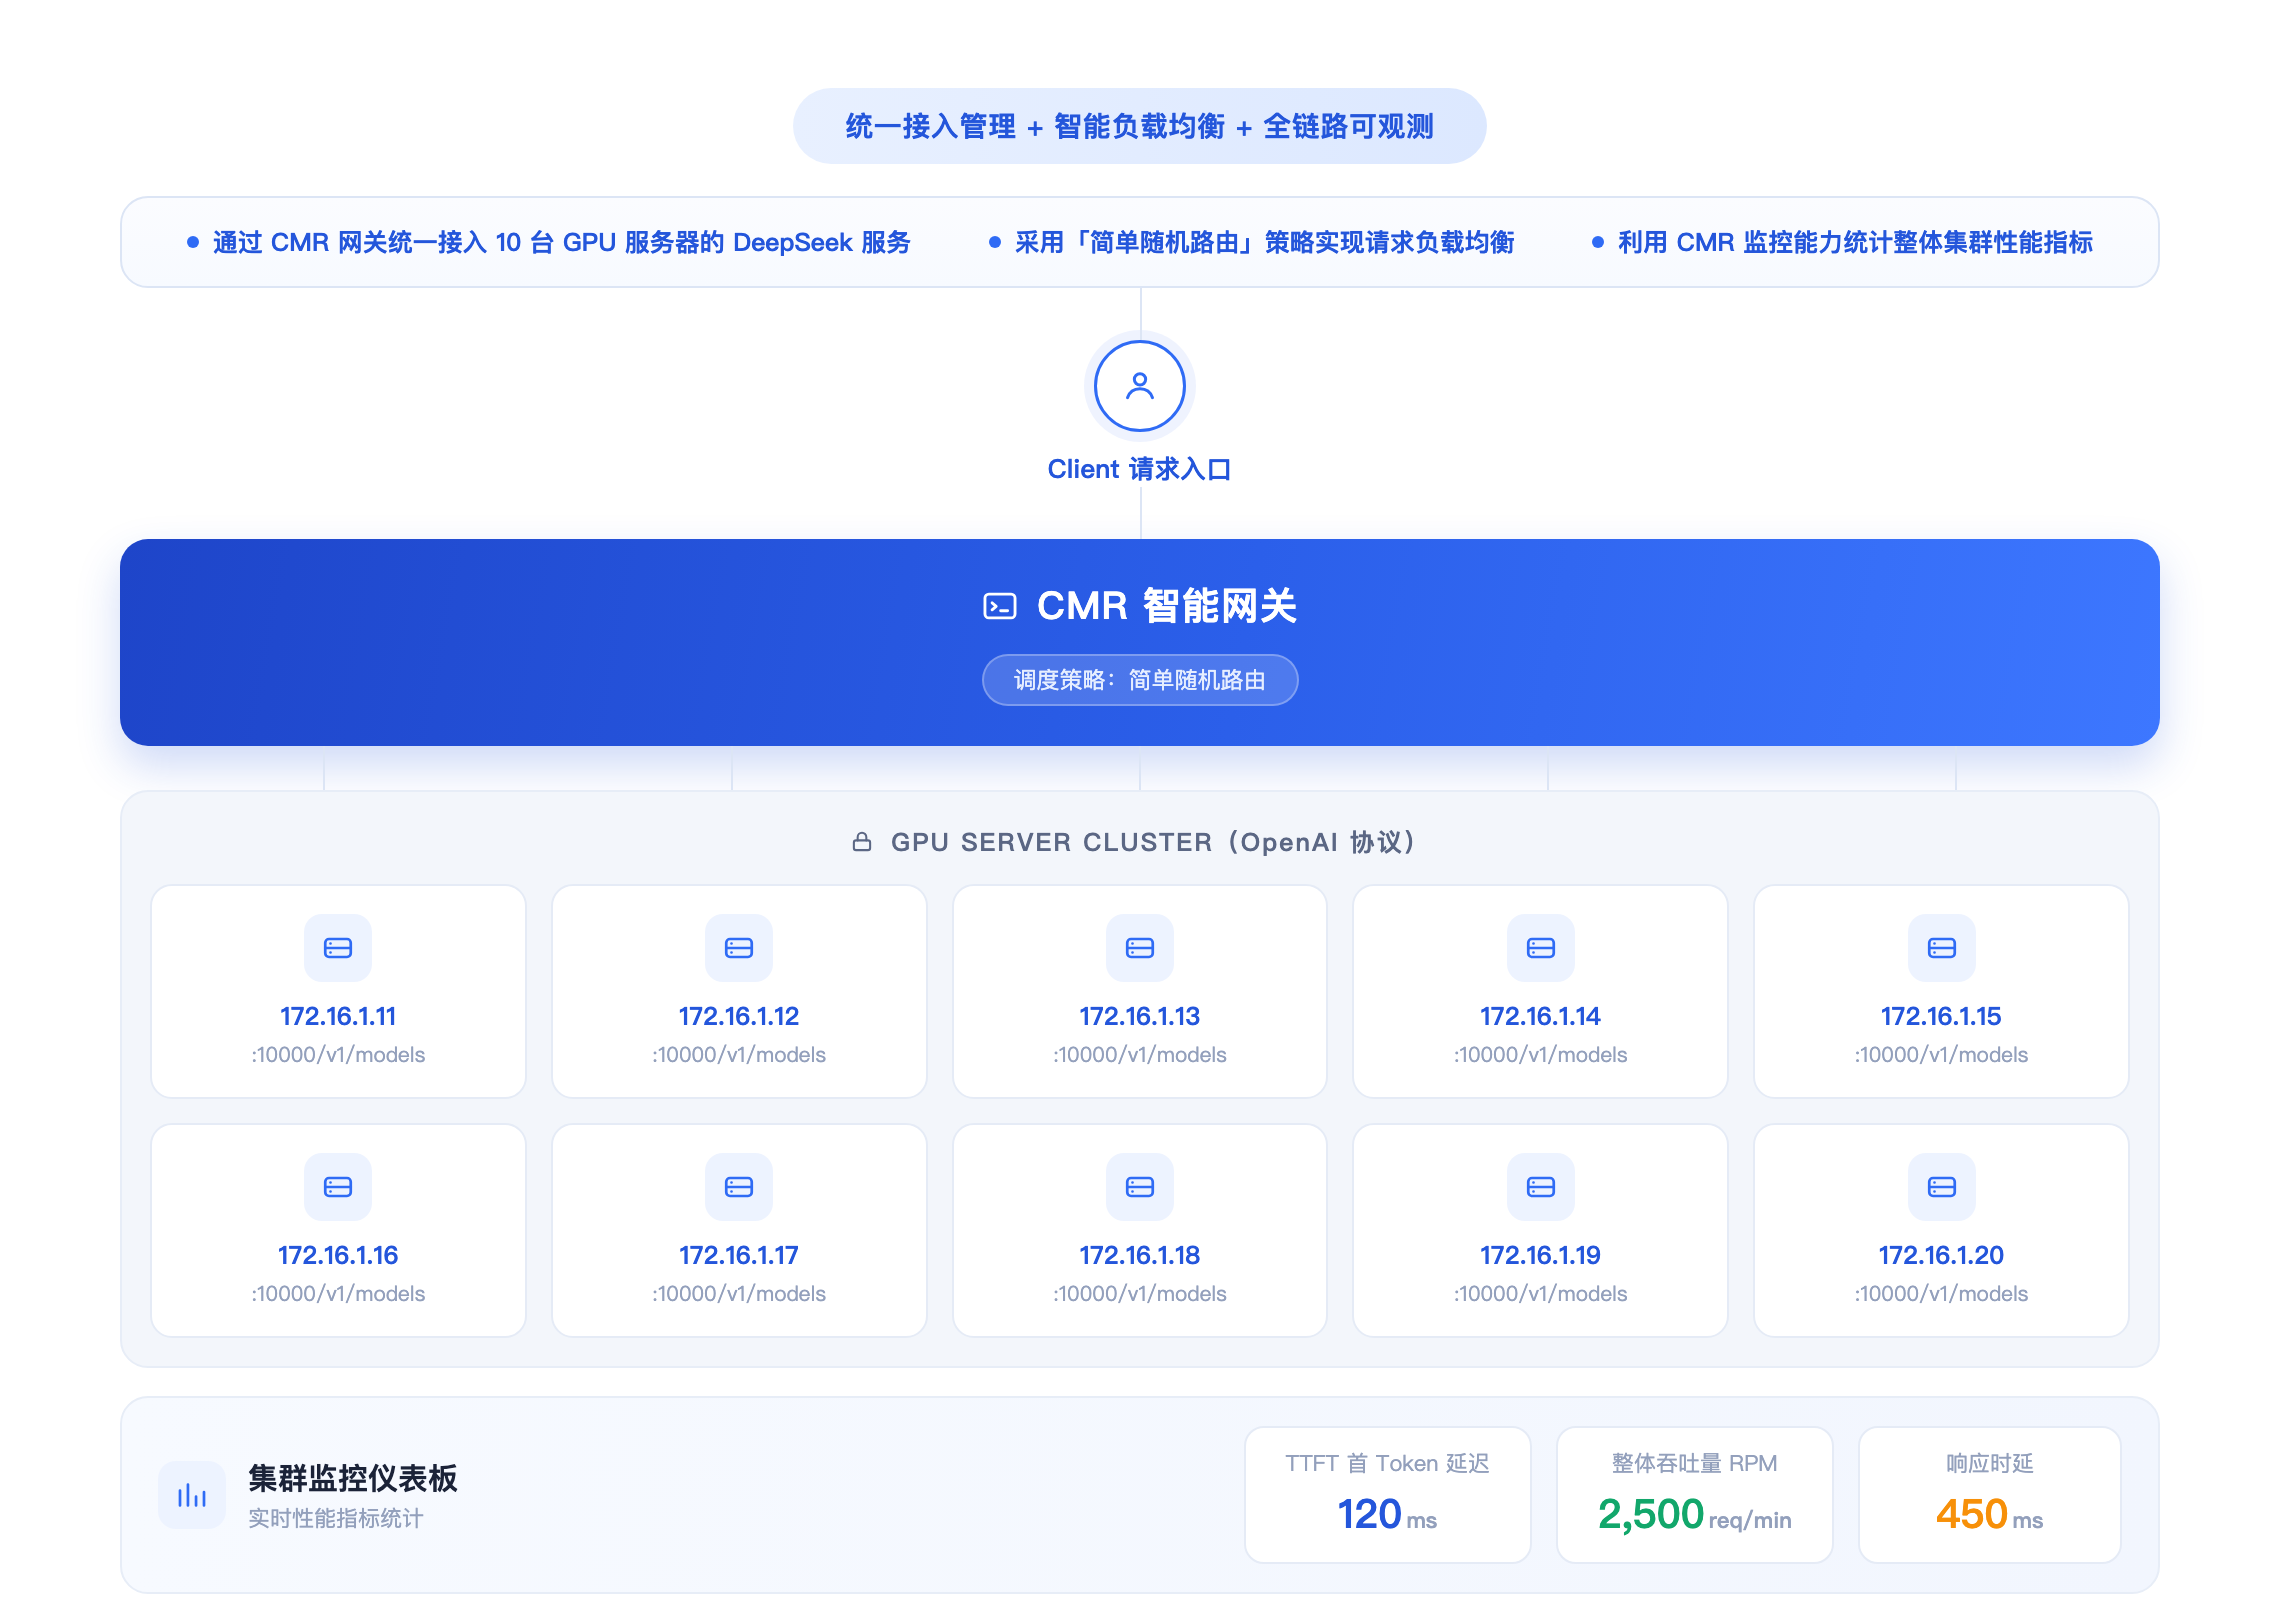
架构的核心是将“单一逻辑模型”与“多个物理后端”解耦。业务应用的高并发请求统一进入 CMR 网关;网关将其分发至由 GPU 推理节点 1 至 N 组成的后端池,并通过健康探测持续判断各节点可用性,自动剔除异常节点。对业务而言,其始终面对一个稳定的模型名称,而背后的节点数量、健康状态与调度细节均由网关屏蔽。
在调度之外,可在用量看板中呈现延迟、Token 消耗等指标,形成调度与监控的闭环:调度决定流量分配方式,监控揭示分配效果,二者共同支撑容量规划与瓶颈定位。
前提条件
1. 已在自建 GPU 集群上部署多个提供 OpenAI 兼容接口的推理节点(如基于 vLLM、TGI),各节点运行同一模型、同一版本以保证结果一致性,并记录各节点内网地址与凭证。
2. 已创建企业型内网 CMR 实例,具体操作请参见 创建模型路由实例。网关与 GPU 集群通过同 VPC 或云联网内网互通,以获得低时延与内网带宽。
3. 已根据 GPU 集群的实际处理能力规划 CMR 实例和 API Key 的 TPM、RPM 或积分预算。
操作步骤
本实践默认已经完成 GPU 推理节点和模型服务的部署。以下步骤从接入自建模型开始。
步骤1:部署 GPU 推理节点
1. 在自建 GPU 集群部署多个推理节点,确保结果一致性。
2. 确认各 GPU 推理节点均能通过 API 地址正常访问。
3. 确认各节点模型的请求协议及响应格式。
4. 分别向各节点发送测试请求,确认模型能够正常返回响应。
步骤2:创建 BYOK
对于具有不同 API 地址的 GPU 推理节点,分别创建自建 BYOK 配置。
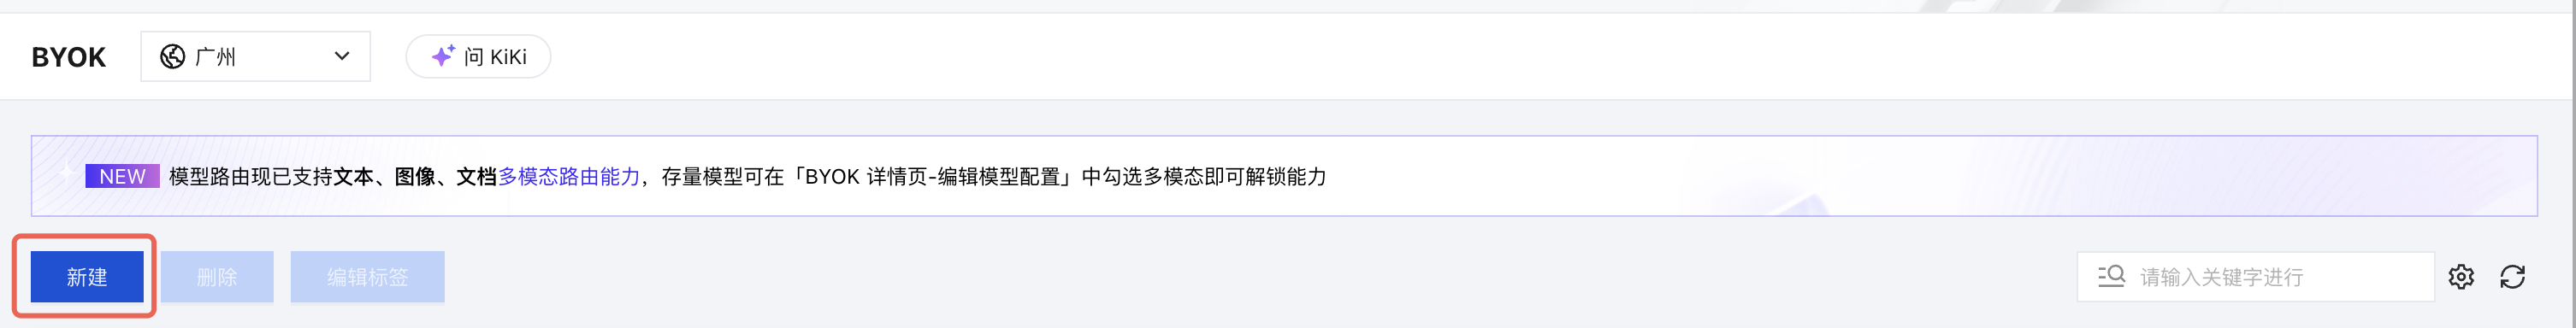
1. 登录 模型路由 控制台,在左侧导航栏中选择 BYOK,单击新建。
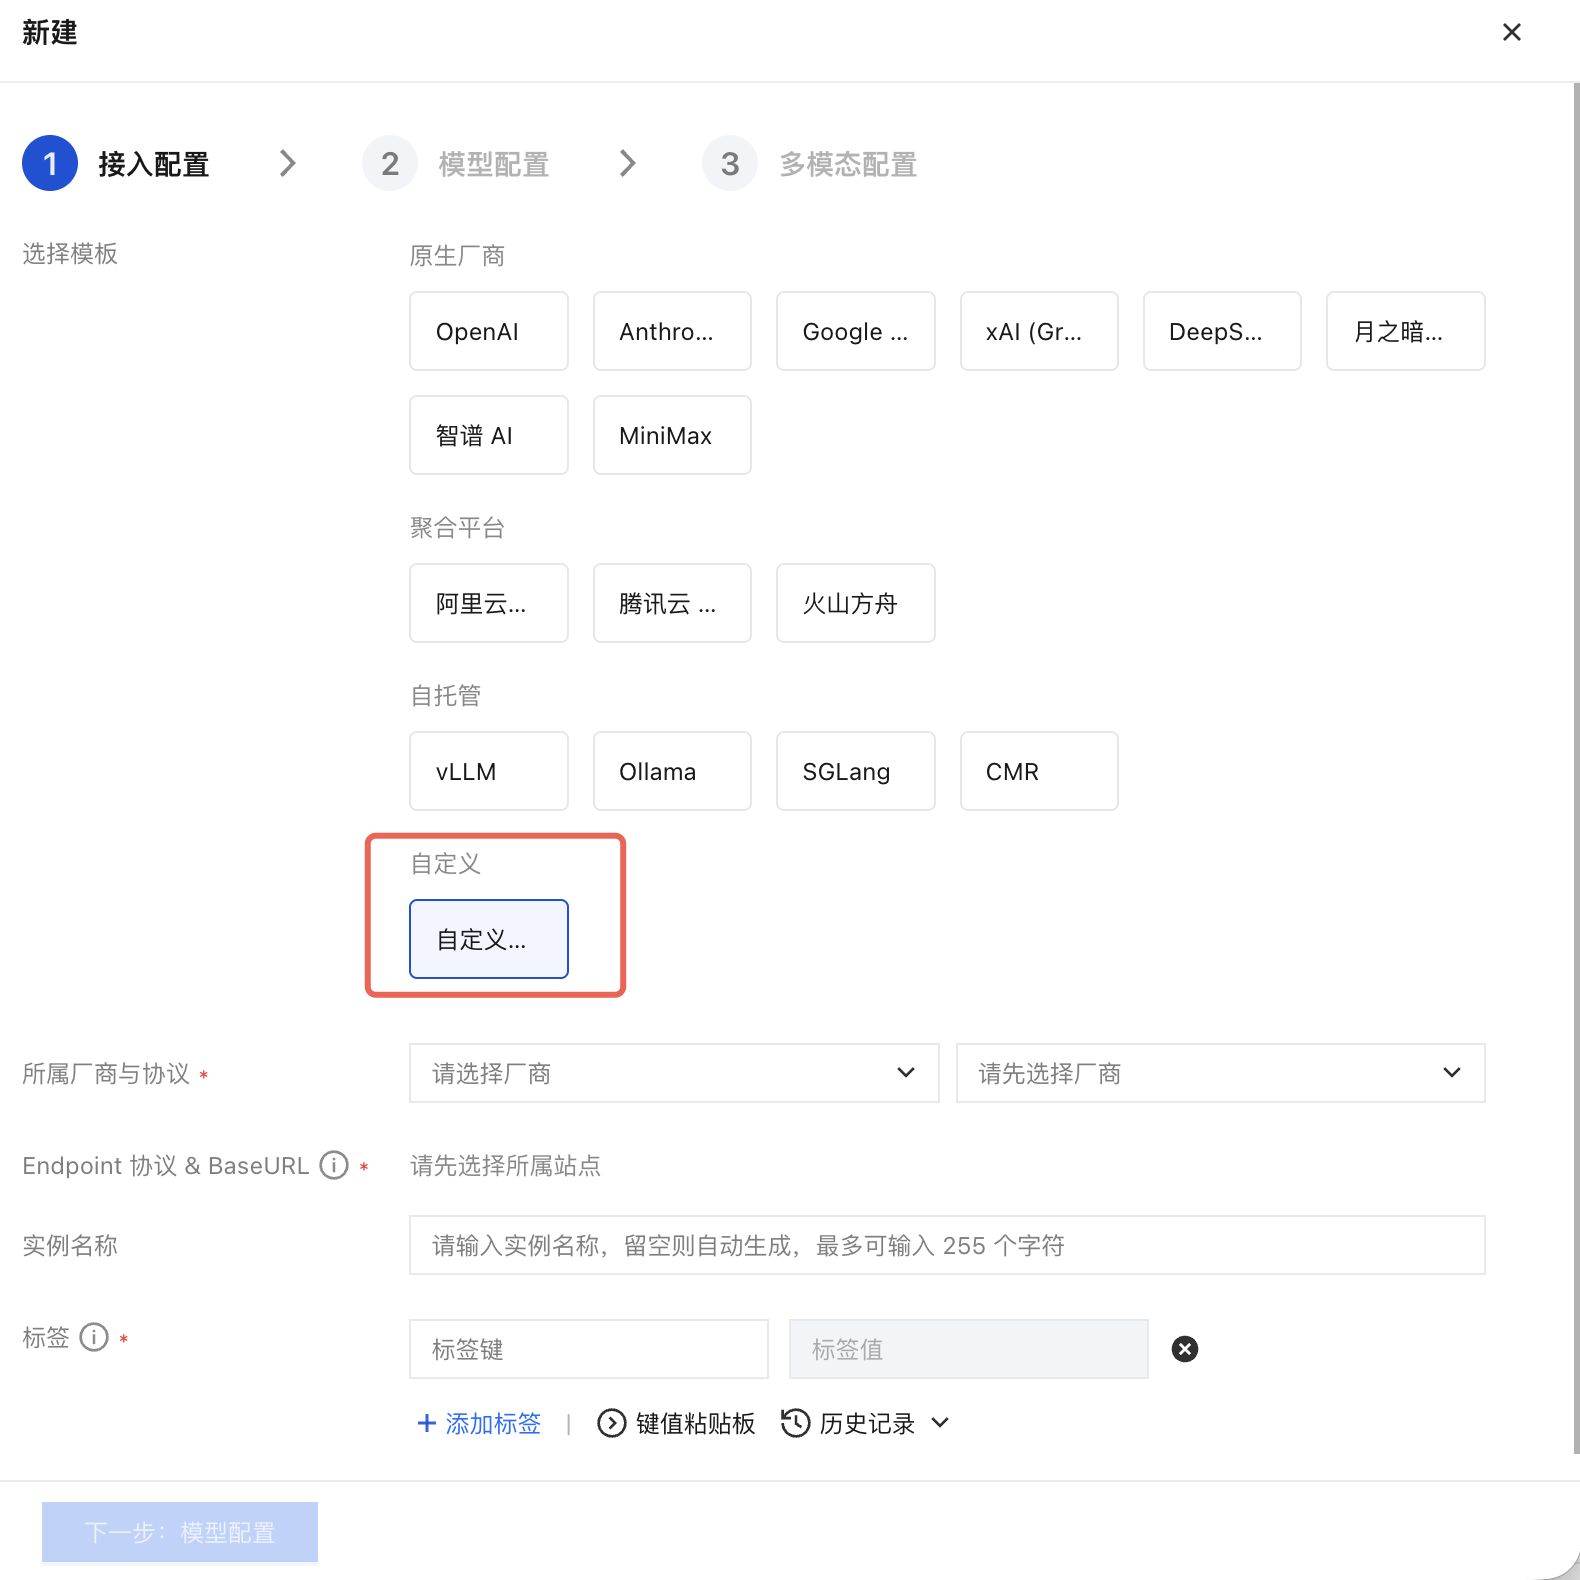
2. 选择自定义,完成接入配置。
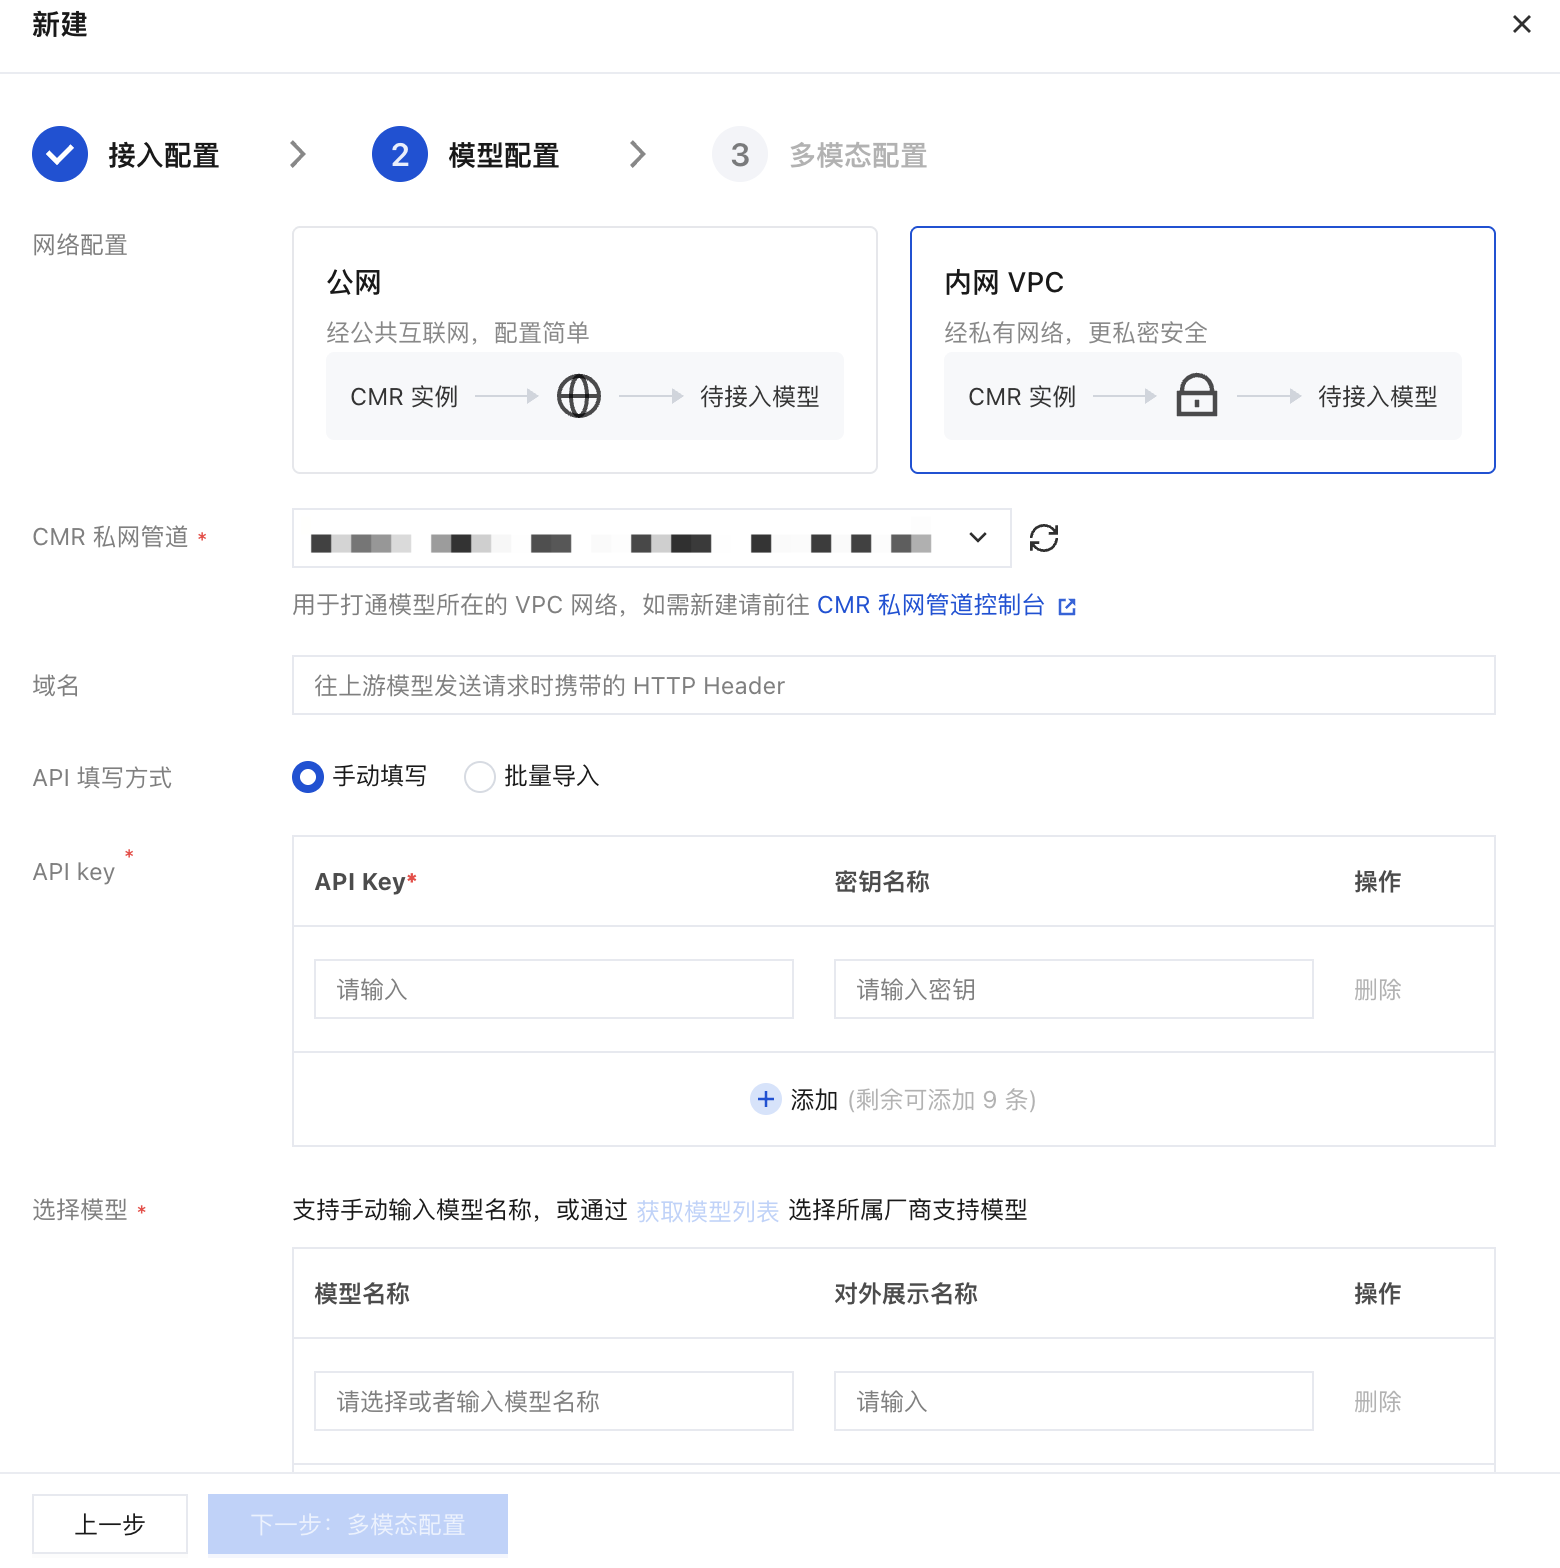
3. 选择内网 VPC 配置相应 CMR 私网管道。并填写模型信息,完成多模态配置。
4. 按照相同方式完成其他 GPU 推理节点的自建 BYOK 模型配置。
步骤3:关联模型
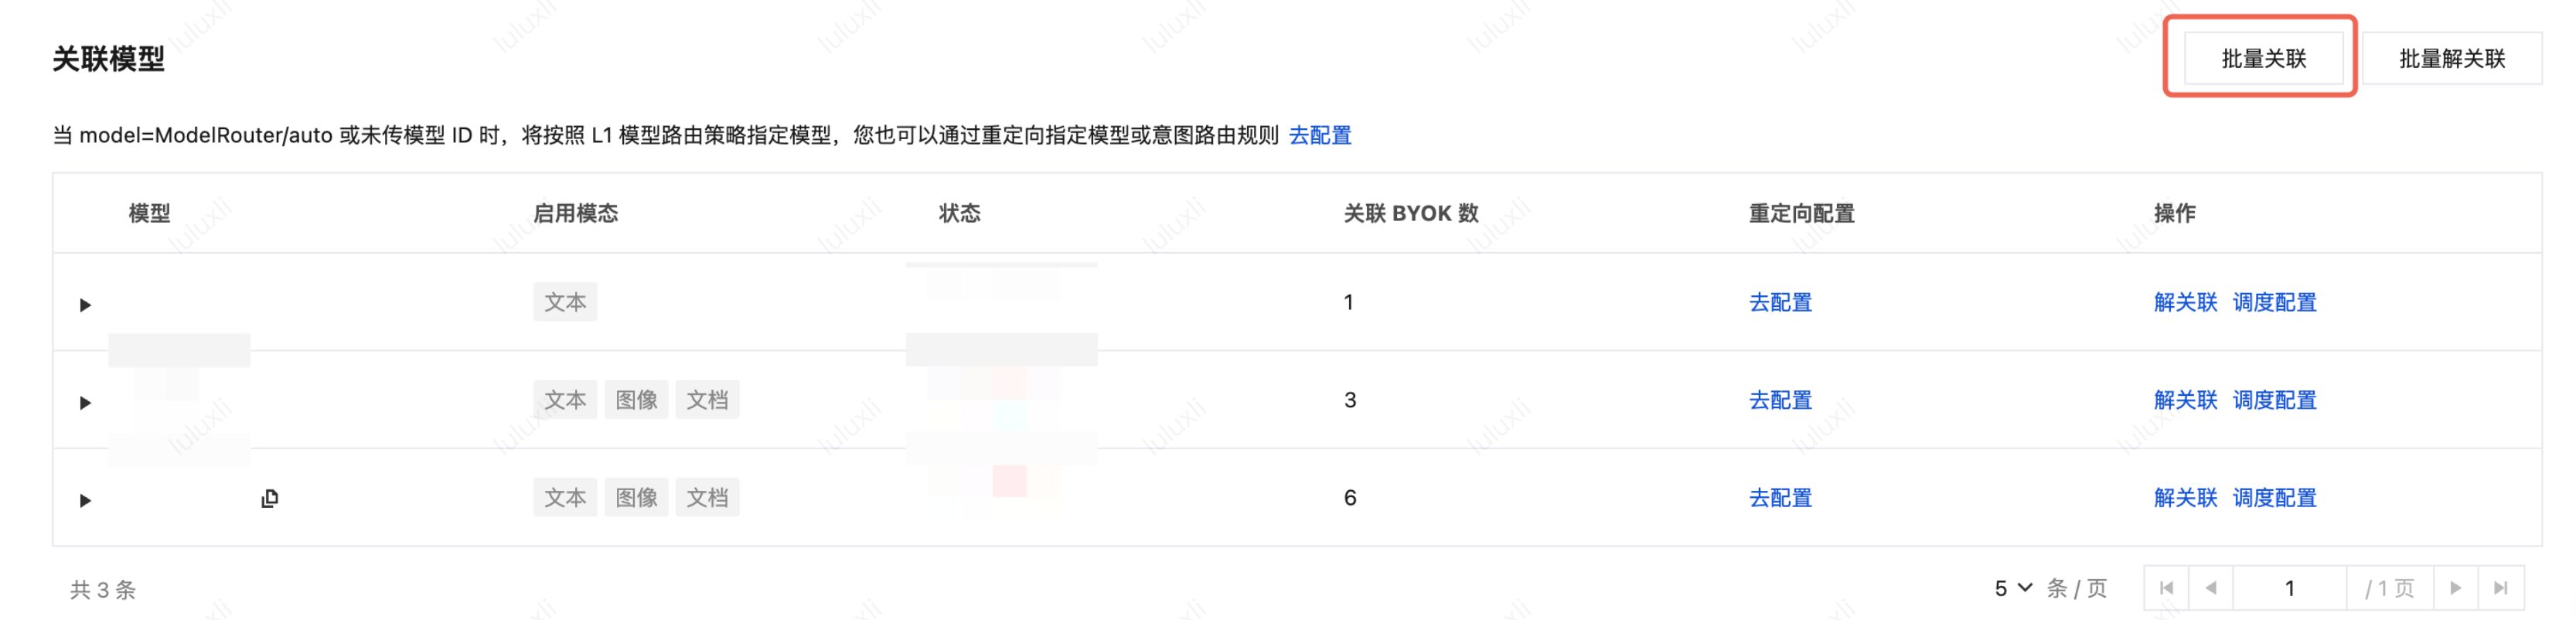
1. 在实例管理页面,单击目标实例 ID,进入目标实例的基本信息页面。选择模型调度管理页签。
2. 在关联模型区域,将前述自建 BYOK 配置中的模型关联至当前 CMR 实例,并设置优先级权重。详细操作请参见 配置模型调度管理。
步骤4:配置模型内路由
1. 在路由策略示意图中的模型内路由节点,单击切换来配置模型内路由策略。
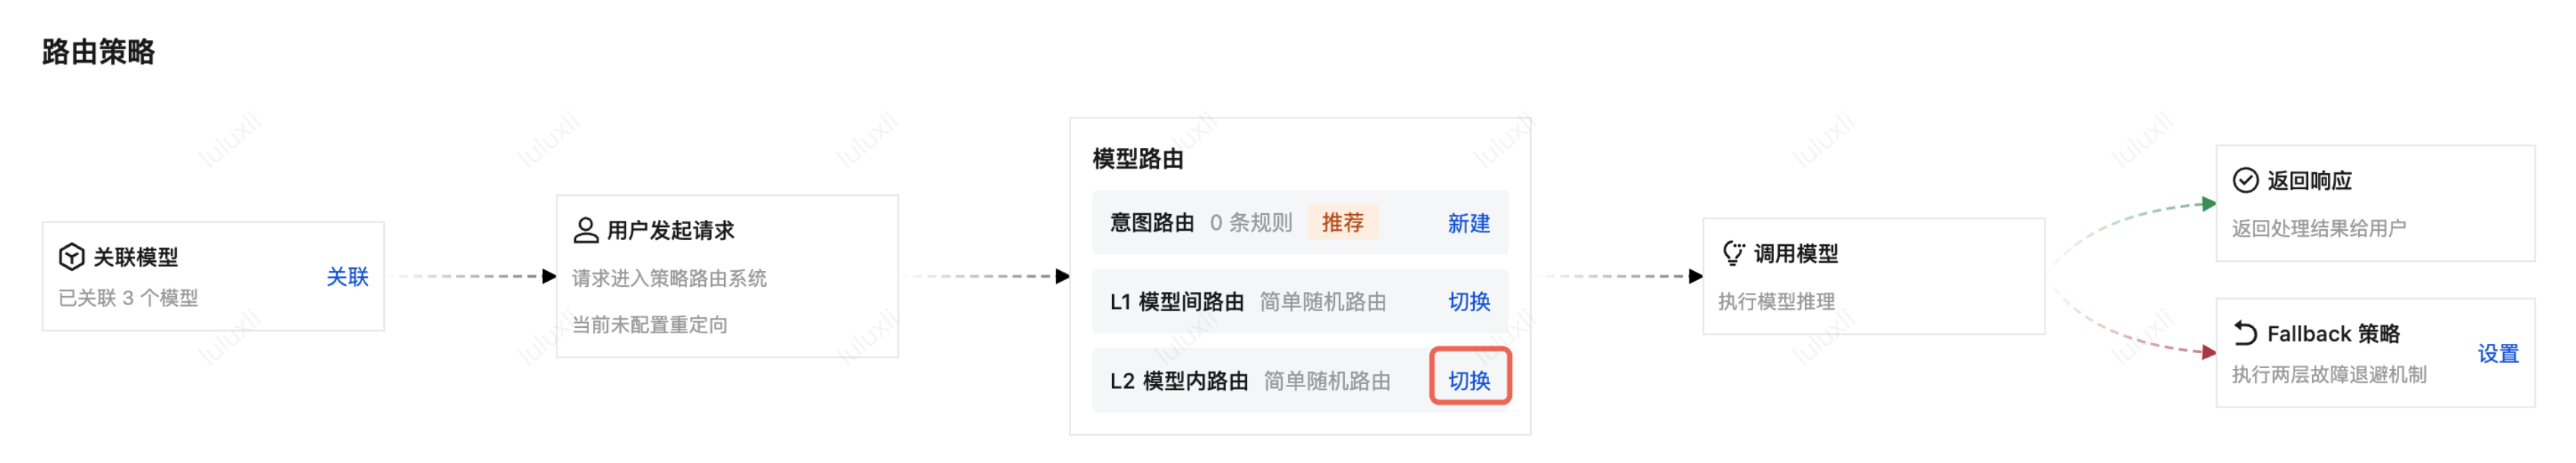
2. 根据业务目标选择路由策略:
策略 | 说明 |
简单随机路由 | 在可用模型中随机选择。 |
最低繁忙路由 | 将请求分配给当前最空闲的模型。 |
最低延迟路由 | 自动选择当前延迟最低的模型。 |
用量均衡路由 | 按用量均衡分配请求到各模型。 |
最低系数路由 | 优先分发到积分系数较低的模型。 |
3. 保存配置。
步骤5:创建 API Key
1. 进入已创建的 CMR 实例详情页,选择用户组页签。
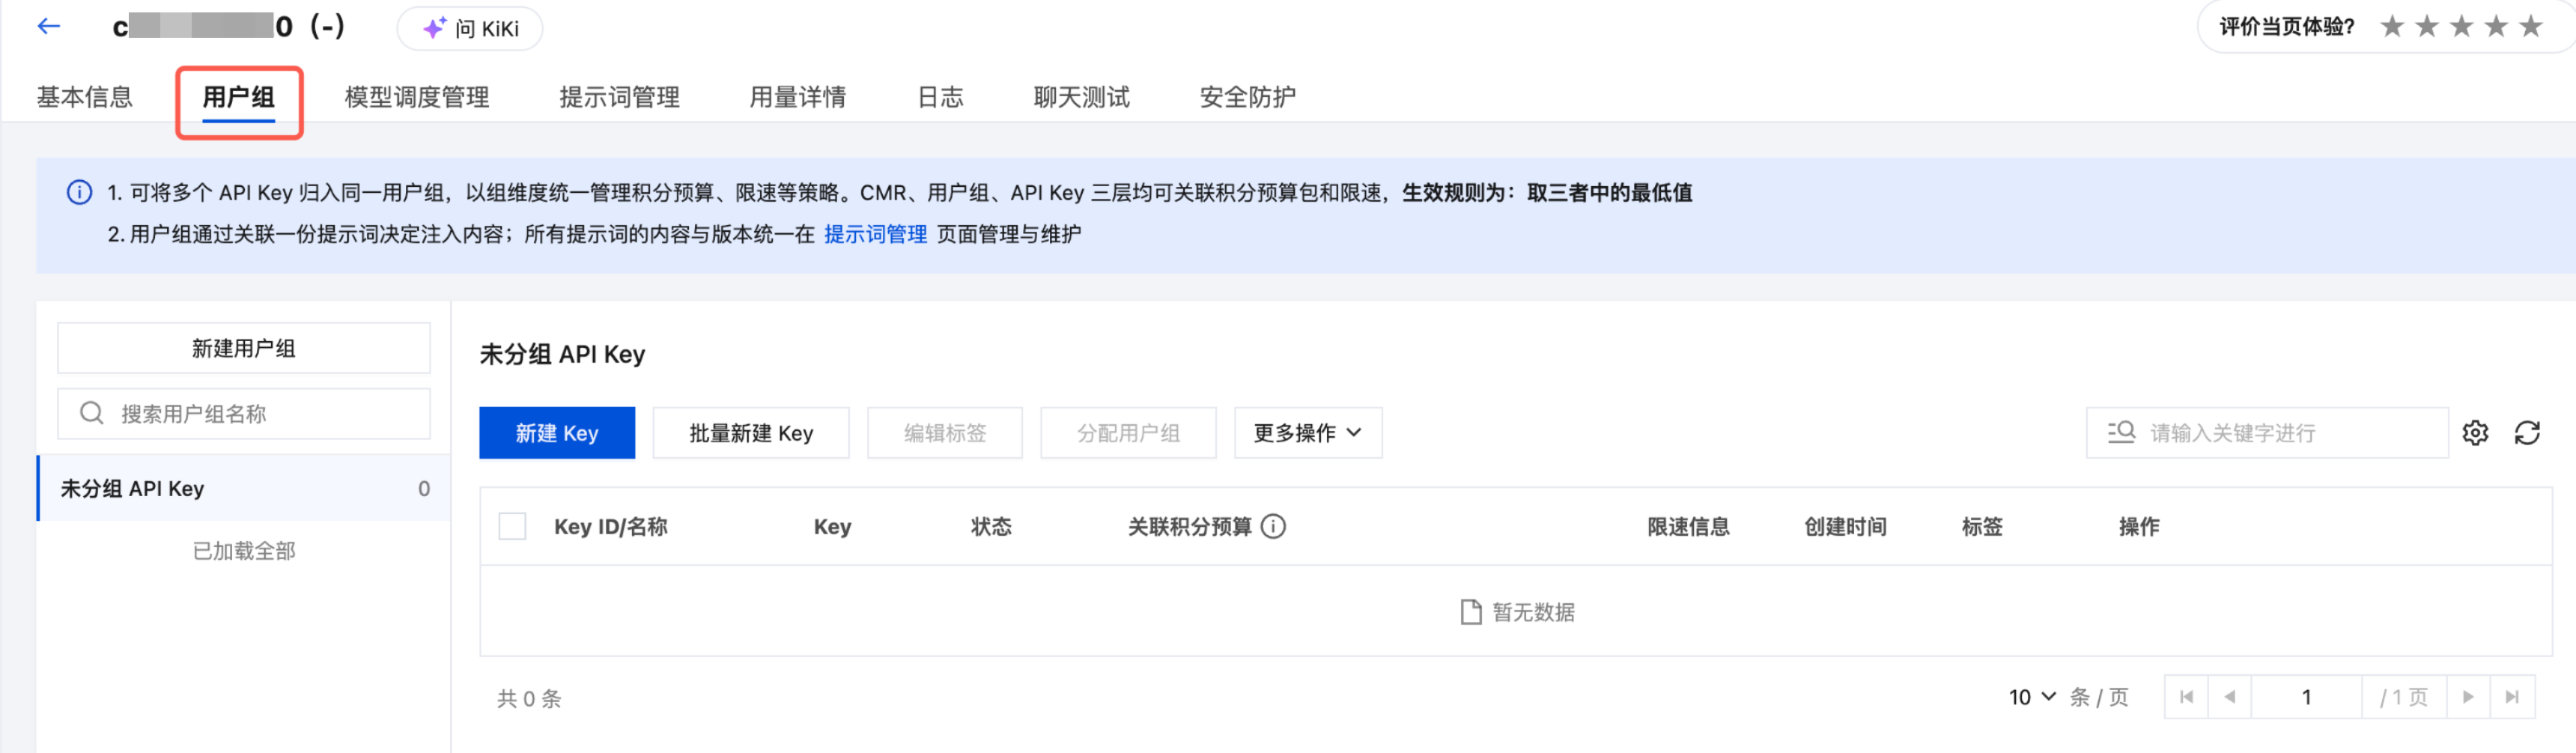
2. 选择目标用户组。如果不需要按业务或人员分组,可以选择未分组。
3. 单击新建 Key。
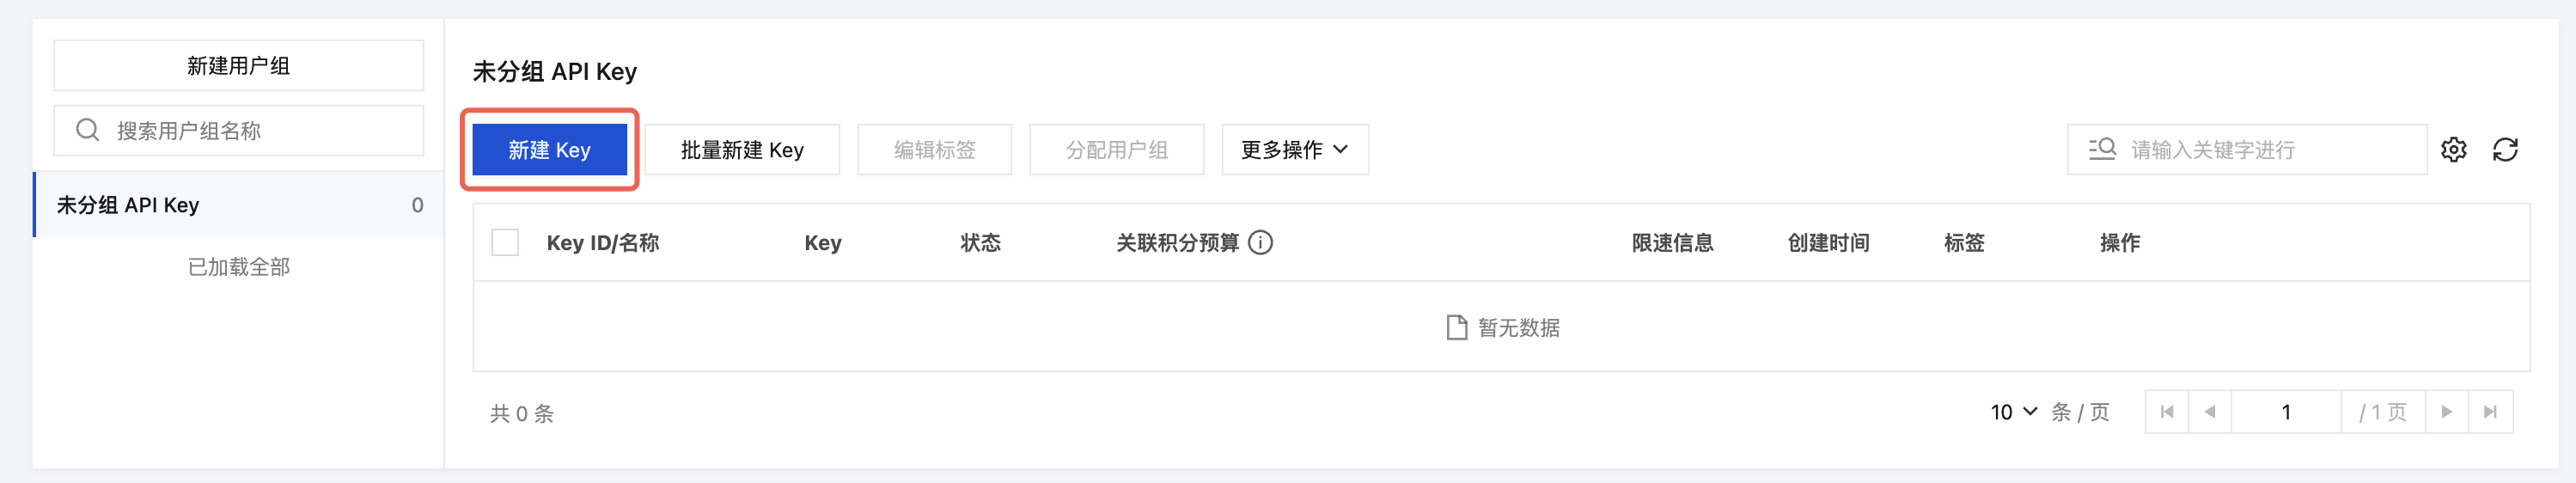
4. 配置 Key 名称、标签和限制类型。
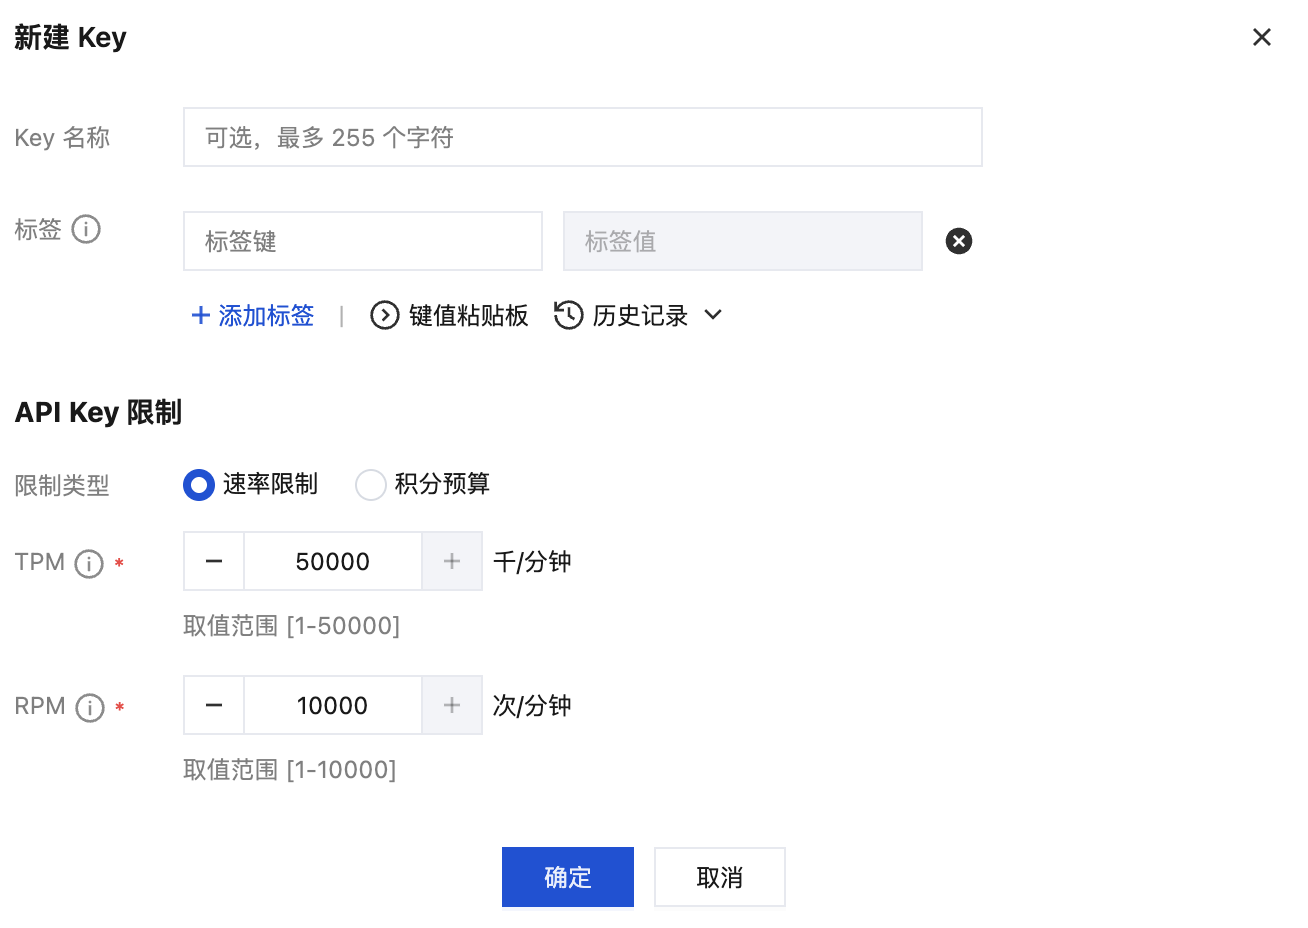
5. 创建完成后,复制并妥善保存完整的 API Key。
步骤6:验证结果
完成配置后,按照以下步骤验证 CMR 的负载分配和可观测能力。
1. 调用创建的模型路由 API Key 通过业务应用或测试工具连续发送多次模型请求,确认 CMR 能够正常返回响应。
2. 在 CMR 控制台的用量详情中,查看请求数量、Token 用量、上游模型调用时延等检查分配结果是否符合路由策略。
3. 在测试环境中停止一个 GPU 推理节点或使其暂时不可访问,再次发送请求,确认其他可用节点仍能继续处理后续调用。
相关文档
创建模型路由实例
配置模型调度管理
查看用量详情