简介
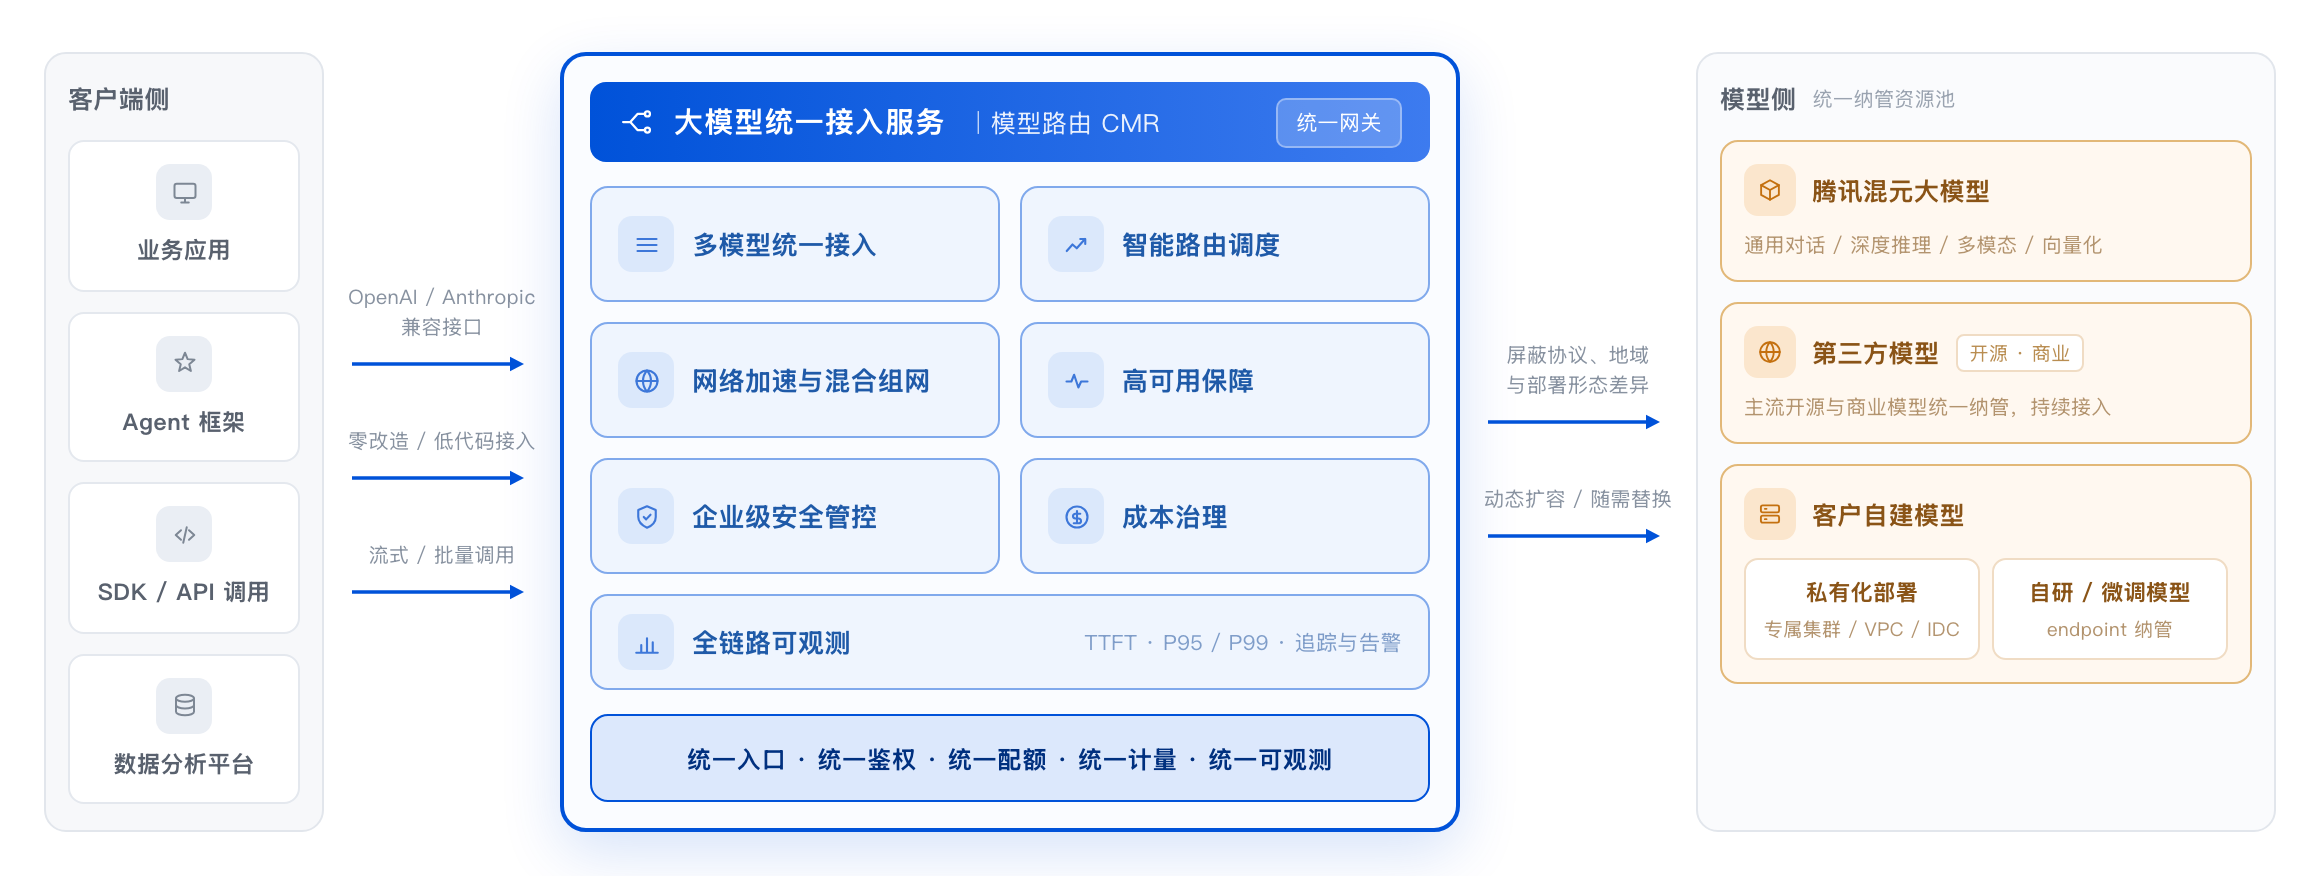
模型路由(Cloud Model Routing,CMR)是腾讯云提供的面向企业级 AI 应用的统一大模型网关服务。CMR 支持以标准兼容接口统一客户端接入,纳管公有云、第三方及私有化部署的各类大模型服务。企业无需为每家模型厂商单独适配协议和配置密钥,配置接入 CMR 即可调用多方模型资源,并获得统一的鉴权、配额、审计与可观测能力。
模型路由与私有网络 VPC 深度集成,支持接入 VPC 内、自建 IDC 及公网部署的模型服务,并可结合公网加速优化跨域访问。内置自动重试、健康检查与多级 Fallback,在屏蔽各厂商 API 差异的同时降低调用失败率、提升服务可用性。产品提供覆盖整个调用链路的监控与分析能力,协助您掌握业务的运行状态。
核心功能
多模型统一接入
减少各厂商 API 适配的操作,将主流模型统一纳管,业务应用无需逐一适配。
功能描述 | 解决问题 |
OpenAI / Anthropic 兼容接口:面向客户端侧,提供统一接口协议,配置接入 CMR 即可透明切换后端供应商。 | 各厂商 API 格式、鉴权、参数不统一,应用侧需适配多套 SDK 与调用逻辑;切换或新增供应商需重复改造。 |
多厂商纳管:模型侧支持接入腾讯混元、DeepSeek 等主流模型,并支持自研、微调及私有化部署模型的 endpoint 的纳管。 | 自研、微调、私有化部署模型与公有云模型分散在不同入口,缺少统一纳管与统一调用方式。 |
智能路由调度
基于意图路由等高级路由引擎的路由转发策略,将请求自动分发至符合预设路由策略的模型,无需在应用侧编写复杂判定逻辑。
功能描述 | 解决问题 |
意图路由:按业务意图(客服问答、代码生成、文档总结等)自动匹配模型,支持基于 Prompt 内容的意图分类与动态路由。 | 模型选择依赖人工经验,应用侧 if-else 规则复杂且难以持续优化。 |
负载感知调度:依据用量、繁忙度、延迟等实时指标,动态调度至负载最低的节点,规避热点过载。 | 请求集中到少数节点造成热点过载,延迟升高、限流增多。 |
会话亲和:多轮对话中同一会话始终路由至相同实例,保持上下文连续。 | 多轮对话被分散到不同实例,上下文断裂影响体验和缓存命中率。 |
灰度发布与流量染色:支持配置优先级与权重,将部分请求导向新模型,实现安全灰度。 | 新模型上线缺少可控的小流量验证手段,全量切换风险高。 |
网络加速与混合组网
为不同部署形态的企业提供灵活的网络接入方案,并优化跨域模型调用的访问速度1。
功能描述 | 解决问题 |
混合组网:支持公网、VPC、IDC、专线 / 云联网等多种网络环境的统一接入。 | VPC / IDC 内模型、公网大模型分散在不同网络与权限体系内,网络难以可控互通。 |
公网加速:提供公网加速通道,优化跨域调用的延迟与稳定性。 | 模型跨域链路波动,延迟高且不稳定,影响业务体验。 |
高可用保障
模型路由提供健康检查、自动重试和故障切换等能力,可辅助提升模型调用链路的可用性。
功能描述 | 解决问题 |
健康检查与熔断:持续探测后端模型健康状态,异常节点自动隔离,恢复后自动加回。 | 模型不可用时请求仍被打到故障节点,故障扩散且需人工介入摘除。 |
自动重试:调用失败或超时时自动重试,支持可配置的重试策略(次数、间隔、退避算法)。 | 上游限流、超时或偶发错误直接透传到业务侧,调用失败率偏高。 |
多级故障切换:主模型不可用时,自动降级至备用模型或备用供应商,支持多级 Fallback 链配置。 | 单一模型或单一供应商故障即导致业务中断,应用侧缺少自动容灾能力。 |
企业级安全管控
安全能力深度集成到模型调用链路中,提供网络隔离、访问控制、内容风险检测和审计日志等可配置能力,可辅助客户开展安全管理与审计留存。
功能描述 | 解决问题 |
网络层安全:路由实例原生部署于用户 VPC 内部,支持安全组和网络 ACL 等访问控制。 | 面向客户端侧的模型访问控制需要达到企业网络安全等级要求。 |
内容安全 WAF:内置可配置的 LLM-WAF 审核管道,可按配置规则对输入 Prompt 和返回内容进行实时内容风险检测,支持敏感信息脱敏、规则命中后的拦截及自定义规则2。 | 输入输出内容缺少合规检测,存在敏感信息泄露与违规内容风险。 |
细粒度访问控制:结合 CAM 与用户组能力,实现模型级、API Key 级权限管理。 | 模型 API Key 分散在业务代码中,权限无法按团队/应用隔离。 |
全链路审计(CLS):全部调用记录写入日志服务 CLS,支持检索、报表与合规审计。 | 调用链路缺少审计日志,安全合规与事后追溯要求无法满足。 |
成本治理
按 CMR 实例、API Key、用户组、BYOK 、标签等维度拆分 Token 消耗与费用明细,并设定预算与配额,超限自动告警或阻断。
功能描述 | 解决问题 |
多维成本拆分:按业务维度精细核算 Token 消耗与费用,支撑内部成本归因。 | 不同团队、应用、模型的 Token 用量难以拆分,成本归因与优化缺少依据。 |
预算与配额管控:为实例、API Key、用户组设定调用上限,超限自动告警或阻断,防止费用失控。 | Token 用量不可控,异常调用或突增导致费用失控。 |
语义缓存:对语义相似的重复请求进行缓存匹配,提升上游缓存命中率,减少无效 Token 消耗。 | 重复或高度相似的请求反复调用模型,产生大量无效 Token 消耗。 |
智能成本路由:依据用户配置、模型质量、延迟与价格等策略进行调度。 | 缺少质量、延迟与价格之间的权衡机制,高价模型被无差别使用。 |
全链路可观测
覆盖模型调用全链路的监控与分析能力,实时掌握 AI 应用运行状态。
功能描述 | 解决问题 |
统一调用监控:支持展示已接入且已开启相应监控采集的模型调用指标,如模型调用的请求量、成功率、延迟分布与 Token 消耗,并在支持的调用链路范围内提供追踪能力。 | 多模型调用状态分散,缺少统一视图掌握请求量、成功率与消耗情况。 |
LLM 专属指标:除传统 QPS 与延迟外,提供首 Token 延迟(TTFT)、Token 产出速率等指标,支持 P95 / P99 延迟分位统计。 | 传统 QPS / 延迟指标无法反映大模型体验,首包与产出速率无处衡量。 |
全链路追踪:基于 OpenTelemetry 协议,从网关入口到模型推理完成,追踪单次调用的完整链路。 | 单次调用耗时或失败原因难以定位,问题排查依赖人工比对日志。 |
智能告警:基于异常检测,Token 消耗突增、成功率骤降或延迟异常时自动通知。 | 异常与用量突增发现滞后,往往事后才被察觉。 |
转发路径
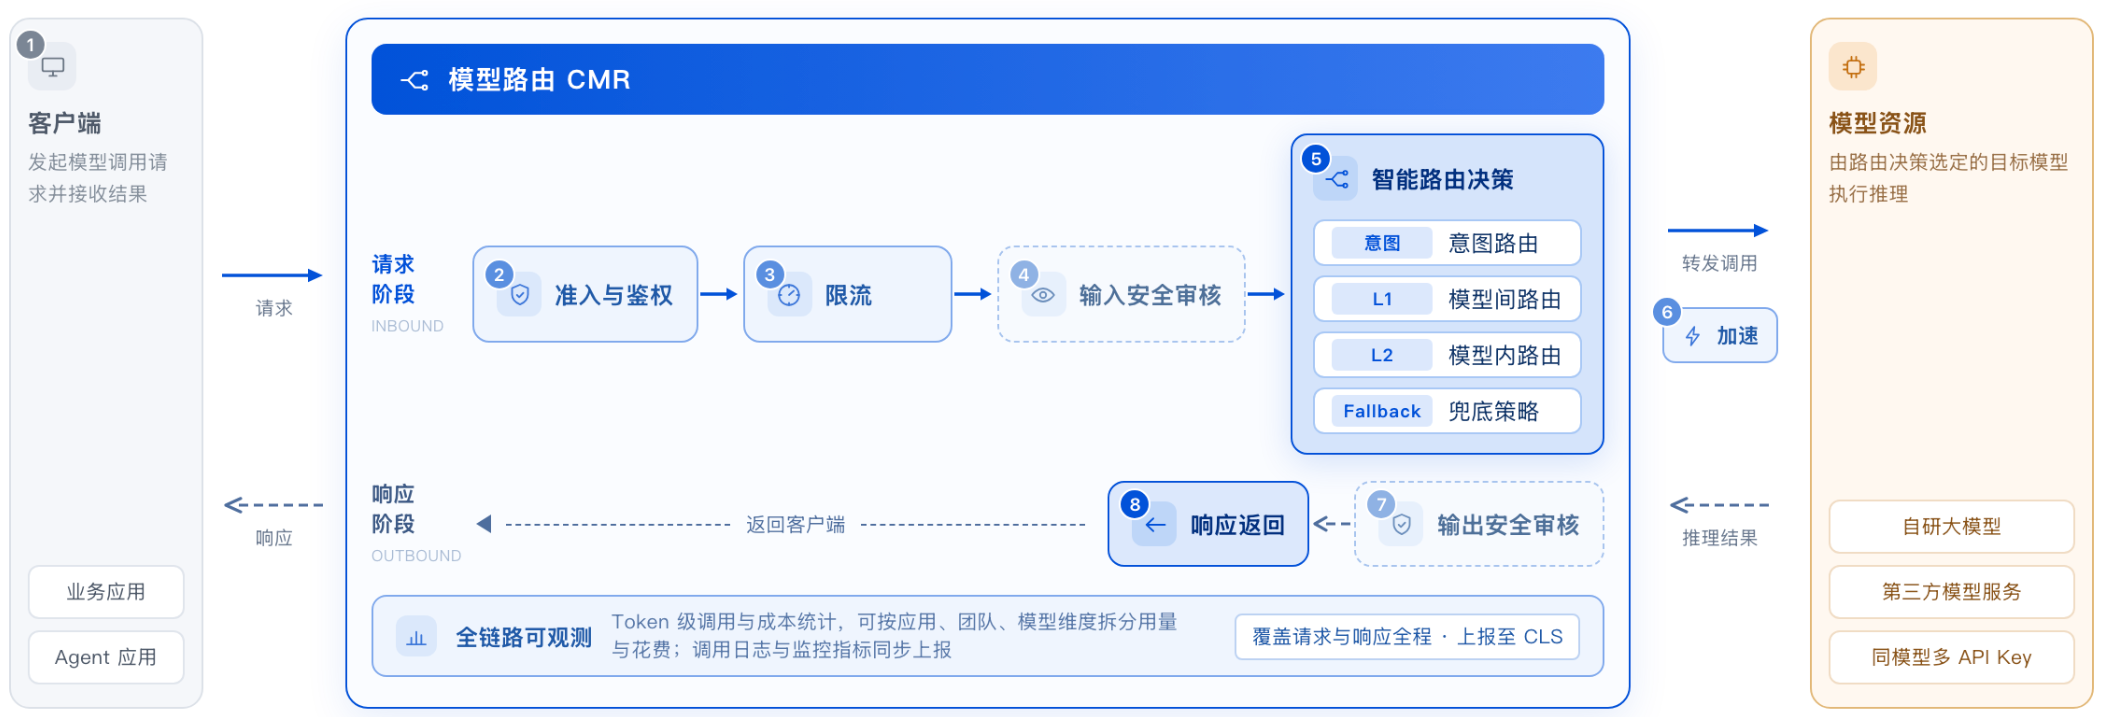
模型路由 CMR 提供 Token 级的调用与成本统计,可按应用、团队、模型等维度拆分用量与花费,帮助企业清晰掌握大模型调用的成本结构3。在转发过程中,提供全链路可观测能力。
1.客户端发起请求
客户端向模型路由 CMR 发起请求,请求体包含模型标识、Prompt 消息及 thinking 开流式开关等字段。
2.准入与鉴权
在客户端发起请求后,根据客户配置的安全组或者用户组中的策略,进行准入与鉴权审核。只有符合策略要求的请求才允许通过。
3.限流
模型路由 CMR 支持在 CMR 实例、用户组和 API Key 维度设置 TPM/RPM 限速值,或者绑定积分预算。可提供有效的模型使用与资源消耗管理能力,帮助团队或项目有效规划、监控与优化 Token 消耗。
4.入方向安全审核
腾讯云 WAF 大模型安全针对大模型应用场景提供专属安全防护,包括提示词攻击防御、输入内容安全审核、敏感数据泄露防护、算力消耗防护、运行时防护等核心能力2。
5.智能路由决策
模型路由 CMR 提供意图路由、L1 模型间路由和 L2 模型内路由。CMR 根据请求客户关联的模型和路由策略,逐级匹配,最终选定模型。
6.加速
依托腾讯云支持的网络节点和线路,模型路由 CMR 基于节点就近调度,可为跨域调用场景提供网络加速能力,有助于降低跨域网络延迟、提升连接稳定性。
7.出方向安全审核
腾讯云 WAF 大模型安全针对大模型应用场景提供专属安全防护,包括输出内容安全审核、敏感数据泄露防护、算力消耗防护、运行时防护等核心能力2。
8.响应返回
模型推理结果以流式(SSE)或一次性方式返回客户端,调用日志及监控指标同步上报至 CLS,供后续审计与分析。
开通说明
注意:
官网文档里的产品概述、优势、应用场景等文档中的数据描述,均来源于2026年腾讯内部实验测试结果,测试基于特定环境、条件及时间范围,仅反映相应测试场景下的情况,实际效果可能因业务场景、配置及使用情况不同而存在差异。
文中涉及的第三方名称、商标及软件归其各自权利人所有,仅用于说明兼容性或适配范围,不构成认可、担保或背书。
说明:
1. 使用跨域模型或跨域网络链路前,客户应结合实际数据类型、处理目的和适用地域,依法完成必要的数据与个人信息保护义务。具体支持的模型、地域、网络线路和数据处理范围以产品文档及控制台展示为准。
2. 客户使用内容检测及处理相关数据时仍应依法履行数据和个人信息保护义务。
3. 实际命中率和 Token 消耗以调用场景及配置为准,模型、场景等不同可能导致命中率不同。


