模型路由 CMR 面向企业级大模型统一接入与智能调度场景,在提供多模型兼容、混合网络打通、智能路由和高可用保障的同时,支持 Token 级成本治理与全链路安全审计,广泛适用于多供应商纳管、跨域访问加速、AI Agent 开发及企业合规管控等多元化业务场景。
多模型、多供应商的统一接入与智能分发
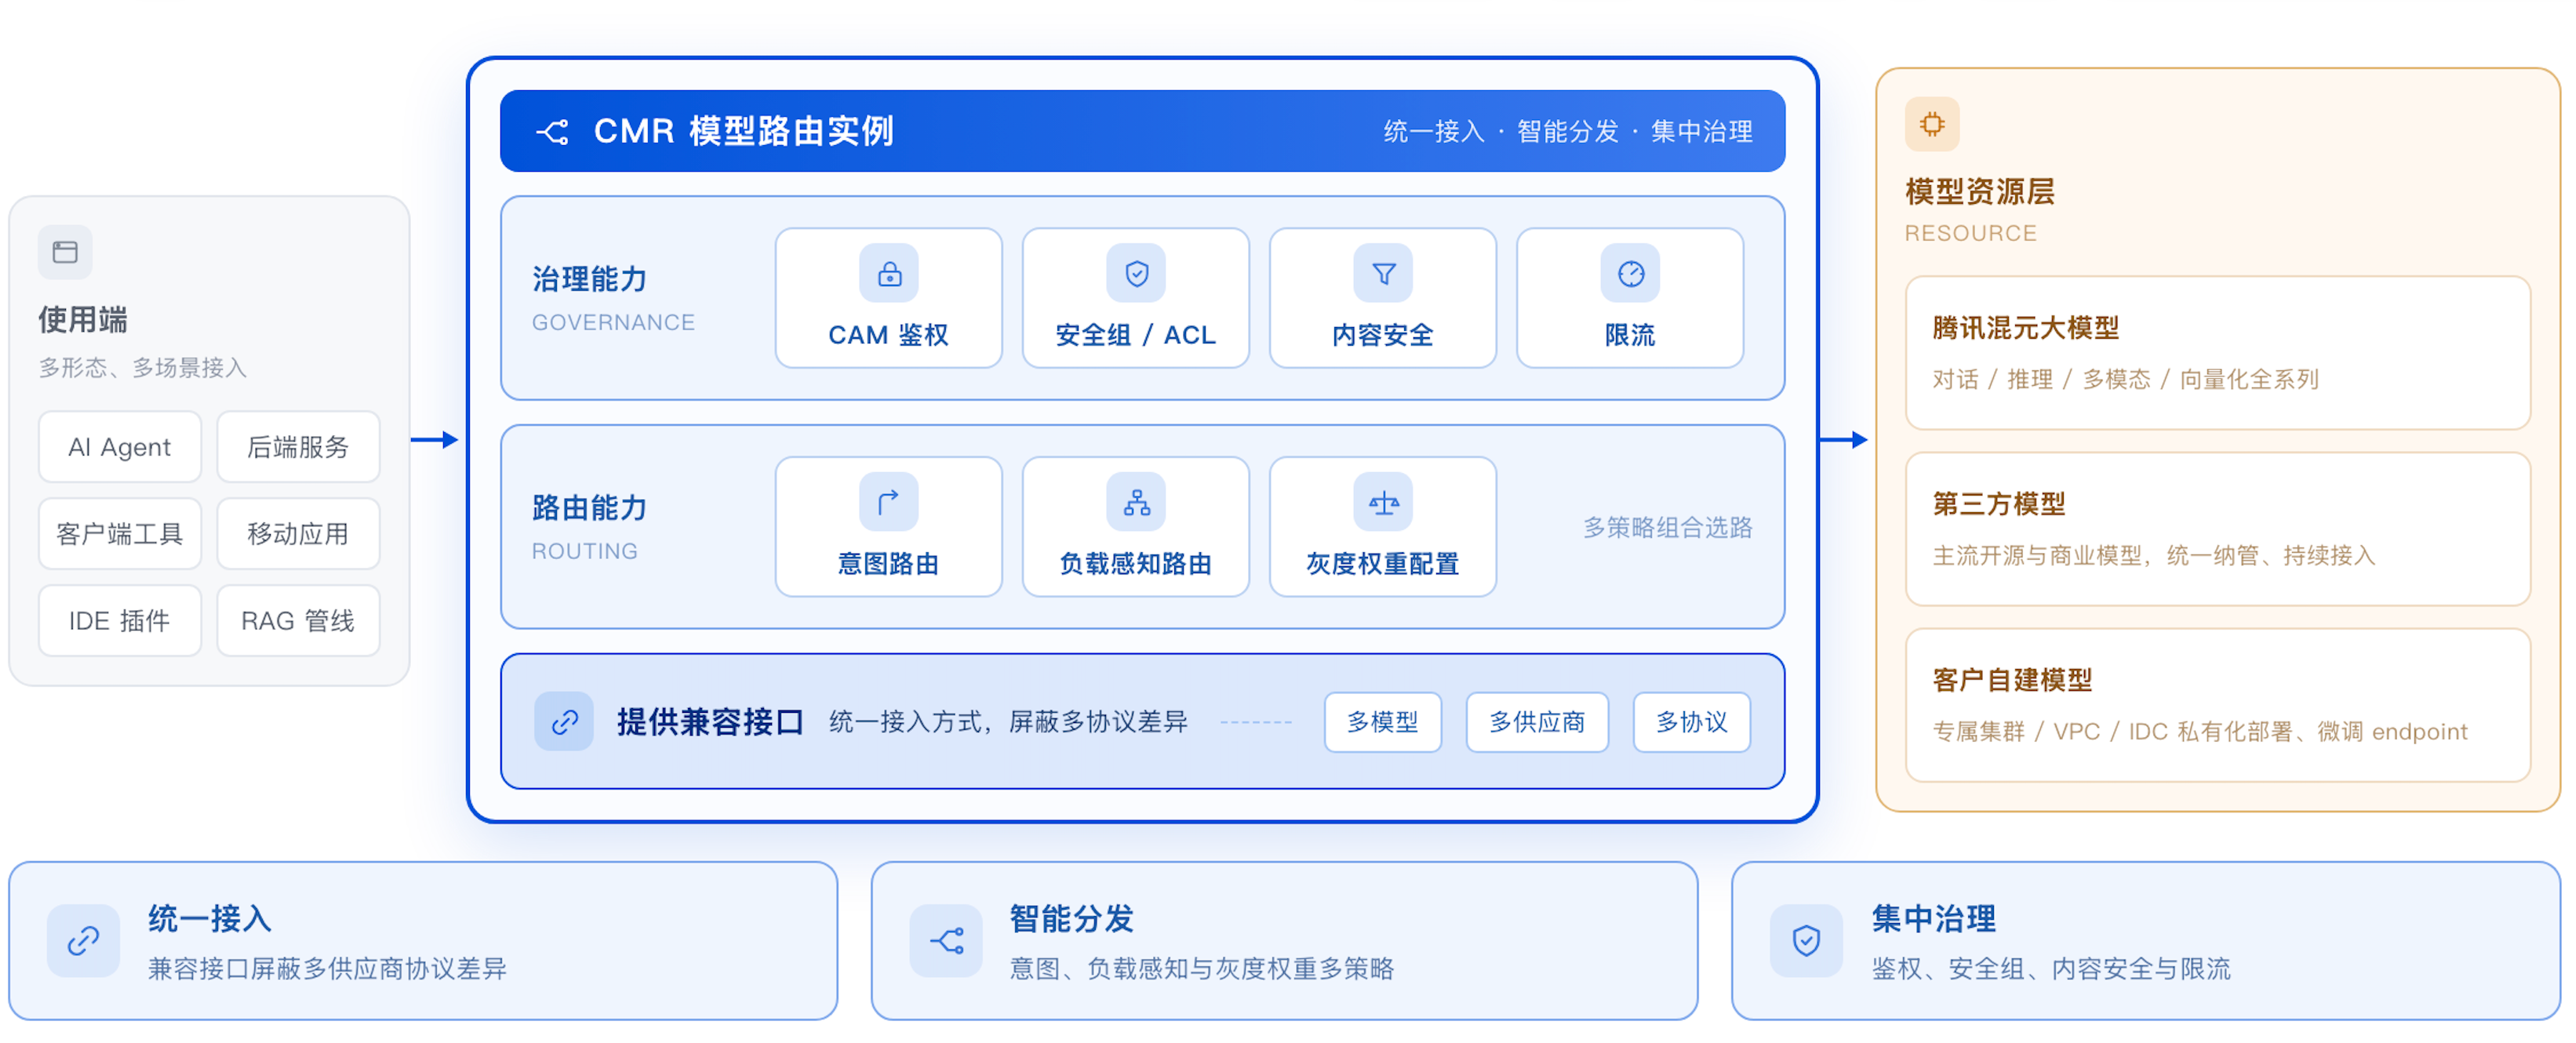
在企业 AI 应用快速迭代的过程中,业务团队往往需要同时接入多家模型厂商的服务,既包括开源与自建模型(如 DeepSeek、Llama、Qwen 等),也包括各类商业大模型。不同厂商的 API 格式、鉴权方式、参数定义与错误码各不相同,即便部分厂商提供了兼容接口,应用侧仍需分别适配、维护多套调用逻辑,开发与维护成本较高。
模型路由 CMR 提供兼容 OpenAI 与 Anthropic 的统一 API 接口,将国内外主流模型服务纳管到同一个路由平面。业务应用无需为每个厂商单独编写适配代码,配置接入模型路由 CMR 即可透明调用多个后端模型。同时,模型路由 CMR 的意图路由引擎可按业务意图(如客服问答、代码生成、文档总结)将请求自动分发至合适的模型,减少在应用侧维护复杂 if-else 判定规则的工作量。
此外,模型路由 CMR 支持为不同业务线、团队或应用分配独立的 API Key,并可按 Key 配置调用额度、权限范围与成本归属。多团队共享同一路由平面时,便于实现用量隔离、成本拆分与权限管控,也便于在 Key 泄露或异常调用时快速定位与吊销,降低统一管理的风险。
VPC、IDC 与公网的混合模型统一治理
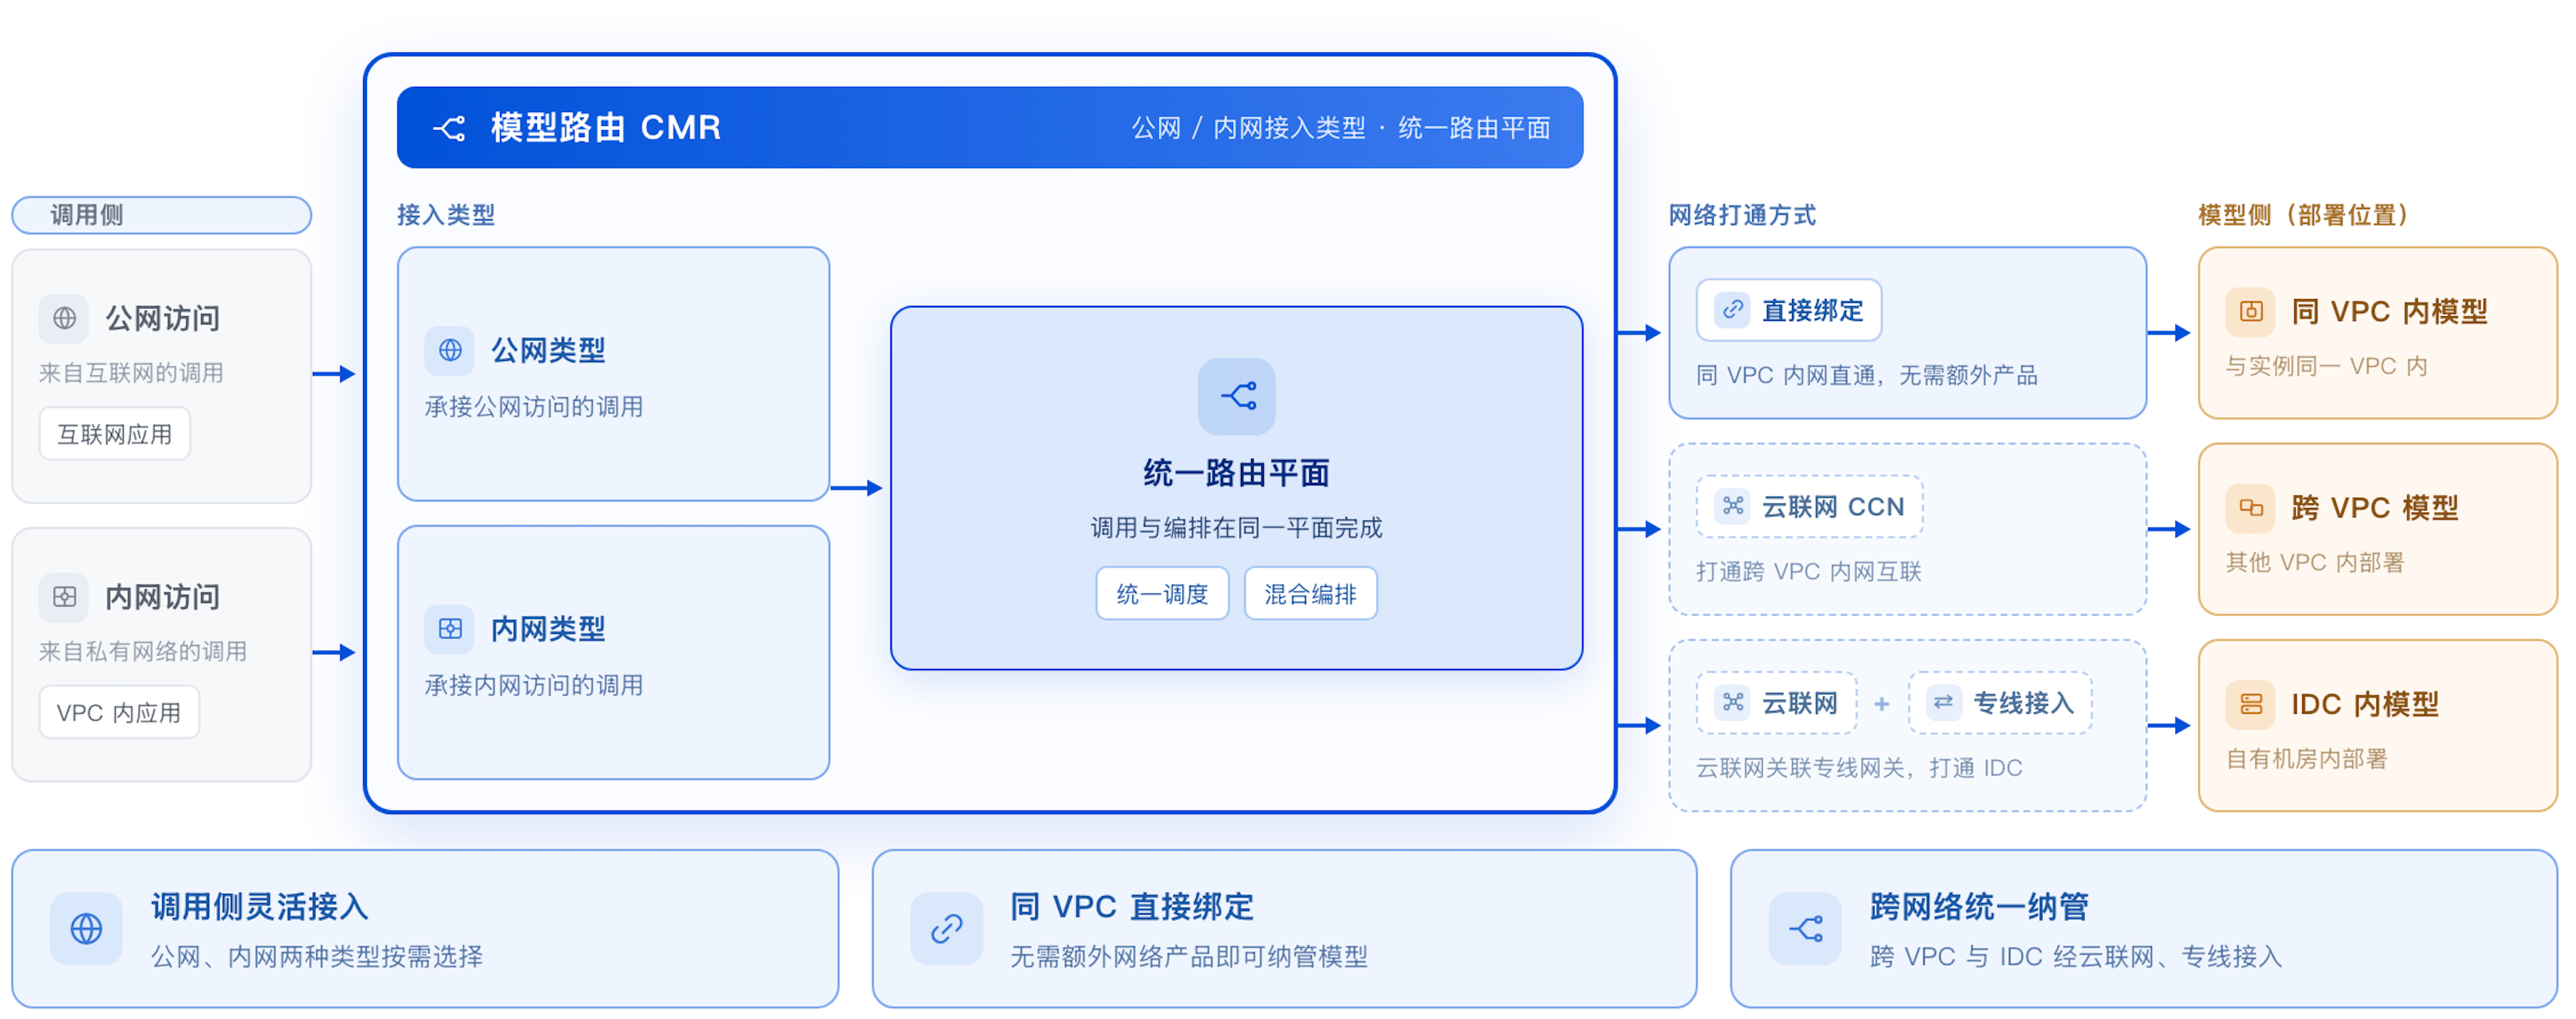
企业在落地大模型时,往往会同时存在多种部署形态:出于数据安全与自主可控的考虑,将开源模型(如 DeepSeek、Llama、Qwen 等)私有化部署在自有的 VPC 内网或 IDC 机房;同时,部分场景又需要调用部署在公网的外采模型服务,以补齐特定能力。这些分散在不同网络与权限体系中的模型,难以实现统一的接入与管控。
模型路由 CMR 原生支持混合组网部署,路由实例可按需部署到企业的 VPC 内部,通过专线或云联网打通 IDC 环境,并支持以安全代理方式访问公网模型。自有部署的开源模型与外采的公网模型可在同一路由平面下混合编排、统一调度,模型调用流量经由统一的 模型路由 CMR 实例入口管控,实现多网络环境下的一体纳管。结合 私有网络 VPC 与 云联网,企业无需改变现有网络架构,即可将「自建开源模型 + 外采公网模型」纳入同一套调用治理平面。
模型的跨域访问加速
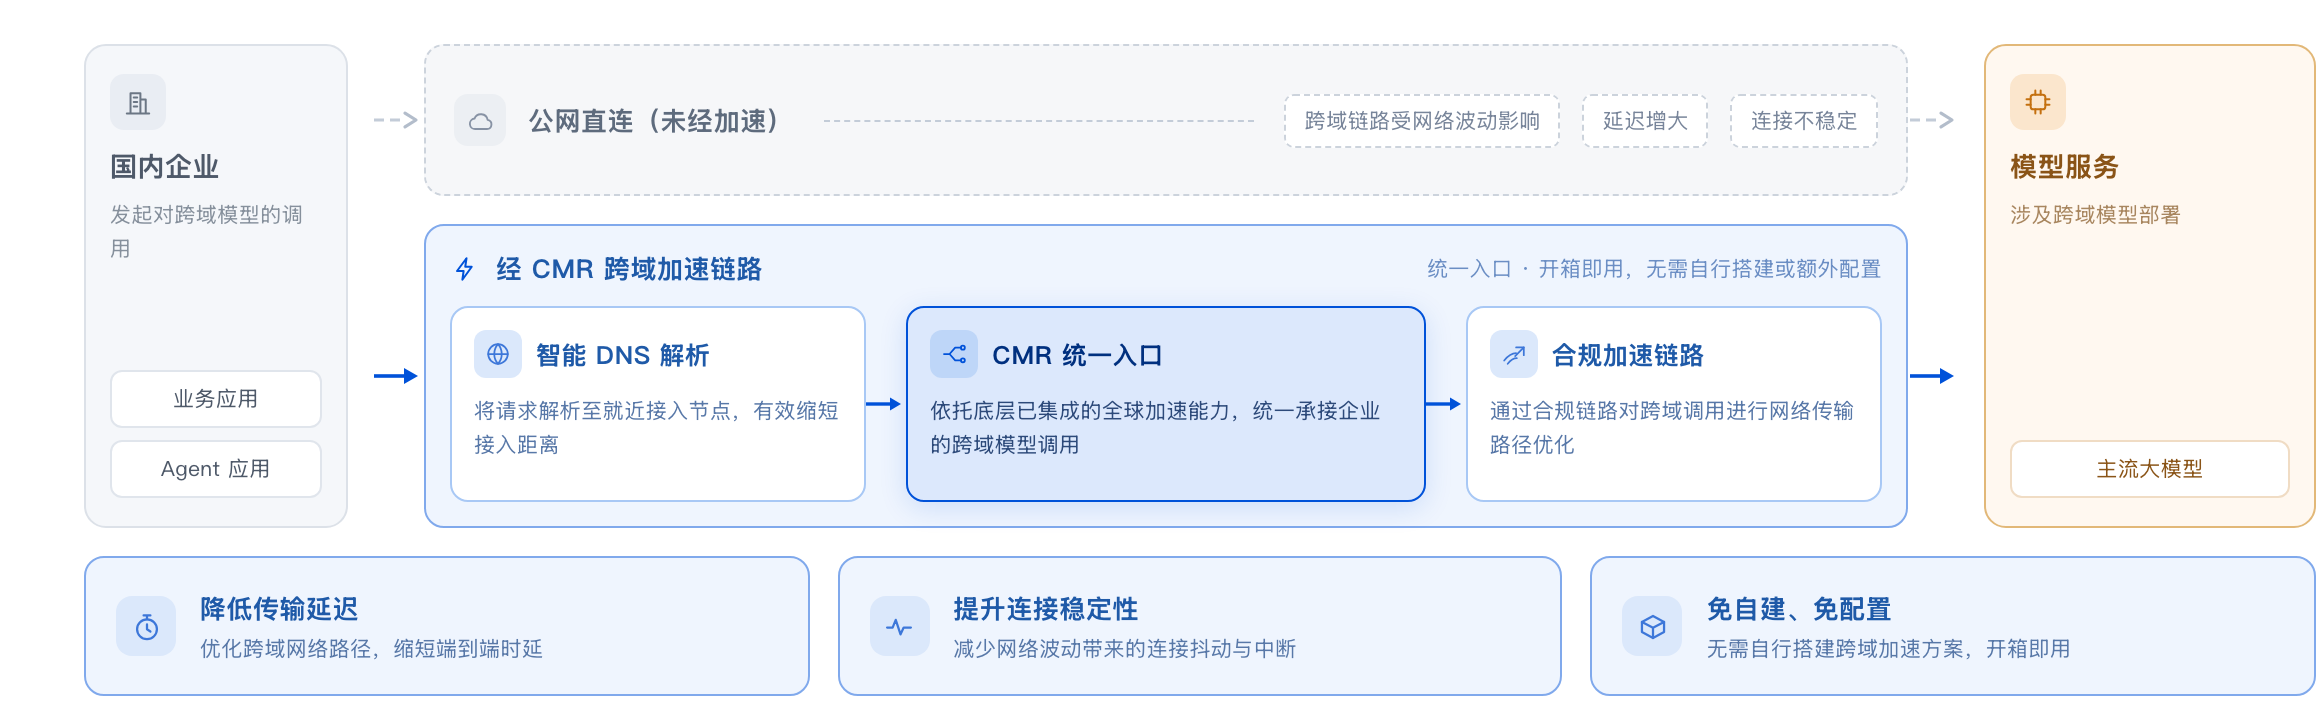
企业在国内调用跨域的主流模型时,跨域链路容易受到网络波动影响,出现延迟增大、连接不稳定等问题,影响业务体验。模型路由 CMR 依托底层已集成的全球加速能力,通过合规的加速链路对跨域调用进行网络路径优化,并结合智能 DNS 解析就近接入节点,有助于降低传输延迟、提升连接稳定性。企业无需自行搭建或额外配置跨域加速方案,通过 模型路由 CMR 统一入口即可获得开箱即用的跨域访问优化体验。
多级容错与业务连续性保障
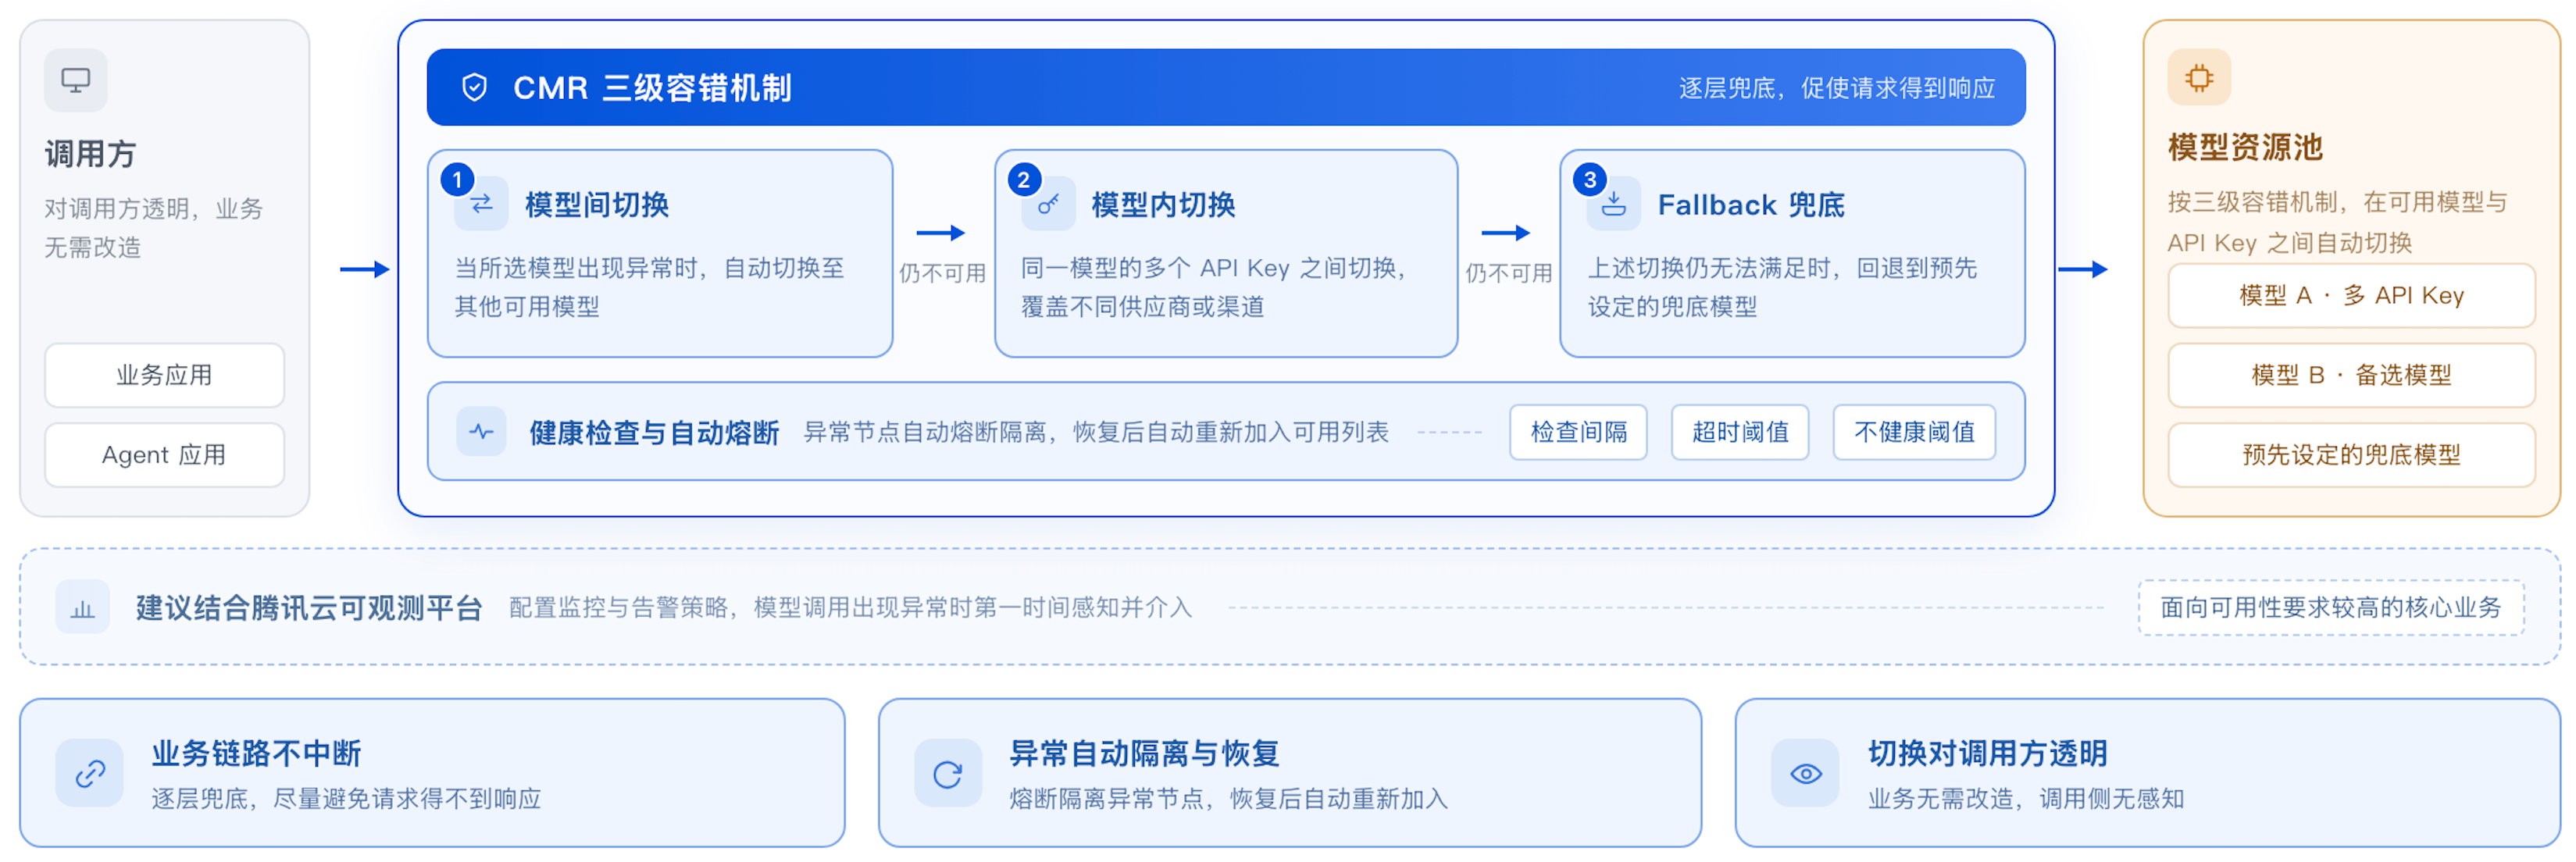
大模型服务在生产环境中难免遇到上游限流、超时或临时不可用等情况,若缺少自动容灾能力,业务链路可能直接中断。
模型路由 CMR 提供三级容错机制,逐层兜底以保障请求得到响应:
模型间切换:当所选模型异常时,自动切换至其他可用模型
模型内切换:同一模型的多 API Key(供应商)切换,同一模型可配置多个 API Key(对应不同供应商或渠道),当某个 Key 限流或对应供应商不可用时,自动切换至该模型的其他可用 Key。
Fallback 兜底:当上述切换仍无法满足时,回退到预先设定的兜底模型,避免请求得不到响应。
针对性配置健康检查策略(检查间隔、超时阈值、不健康阈值),异常节点自动熔断并隔离,恢复后自动重新加入可用列表。整个过程对调用方透明,帮助业务在模型异常场景下维持稳定运行。面向对可用性要求较高的核心业务,建议结合 腾讯云可观测平台 配置监控与告警策略,在模型调用出现异常时第一时间感知并介入,进一步保障业务连续性。
Token 消耗的精细化管理与成本治理
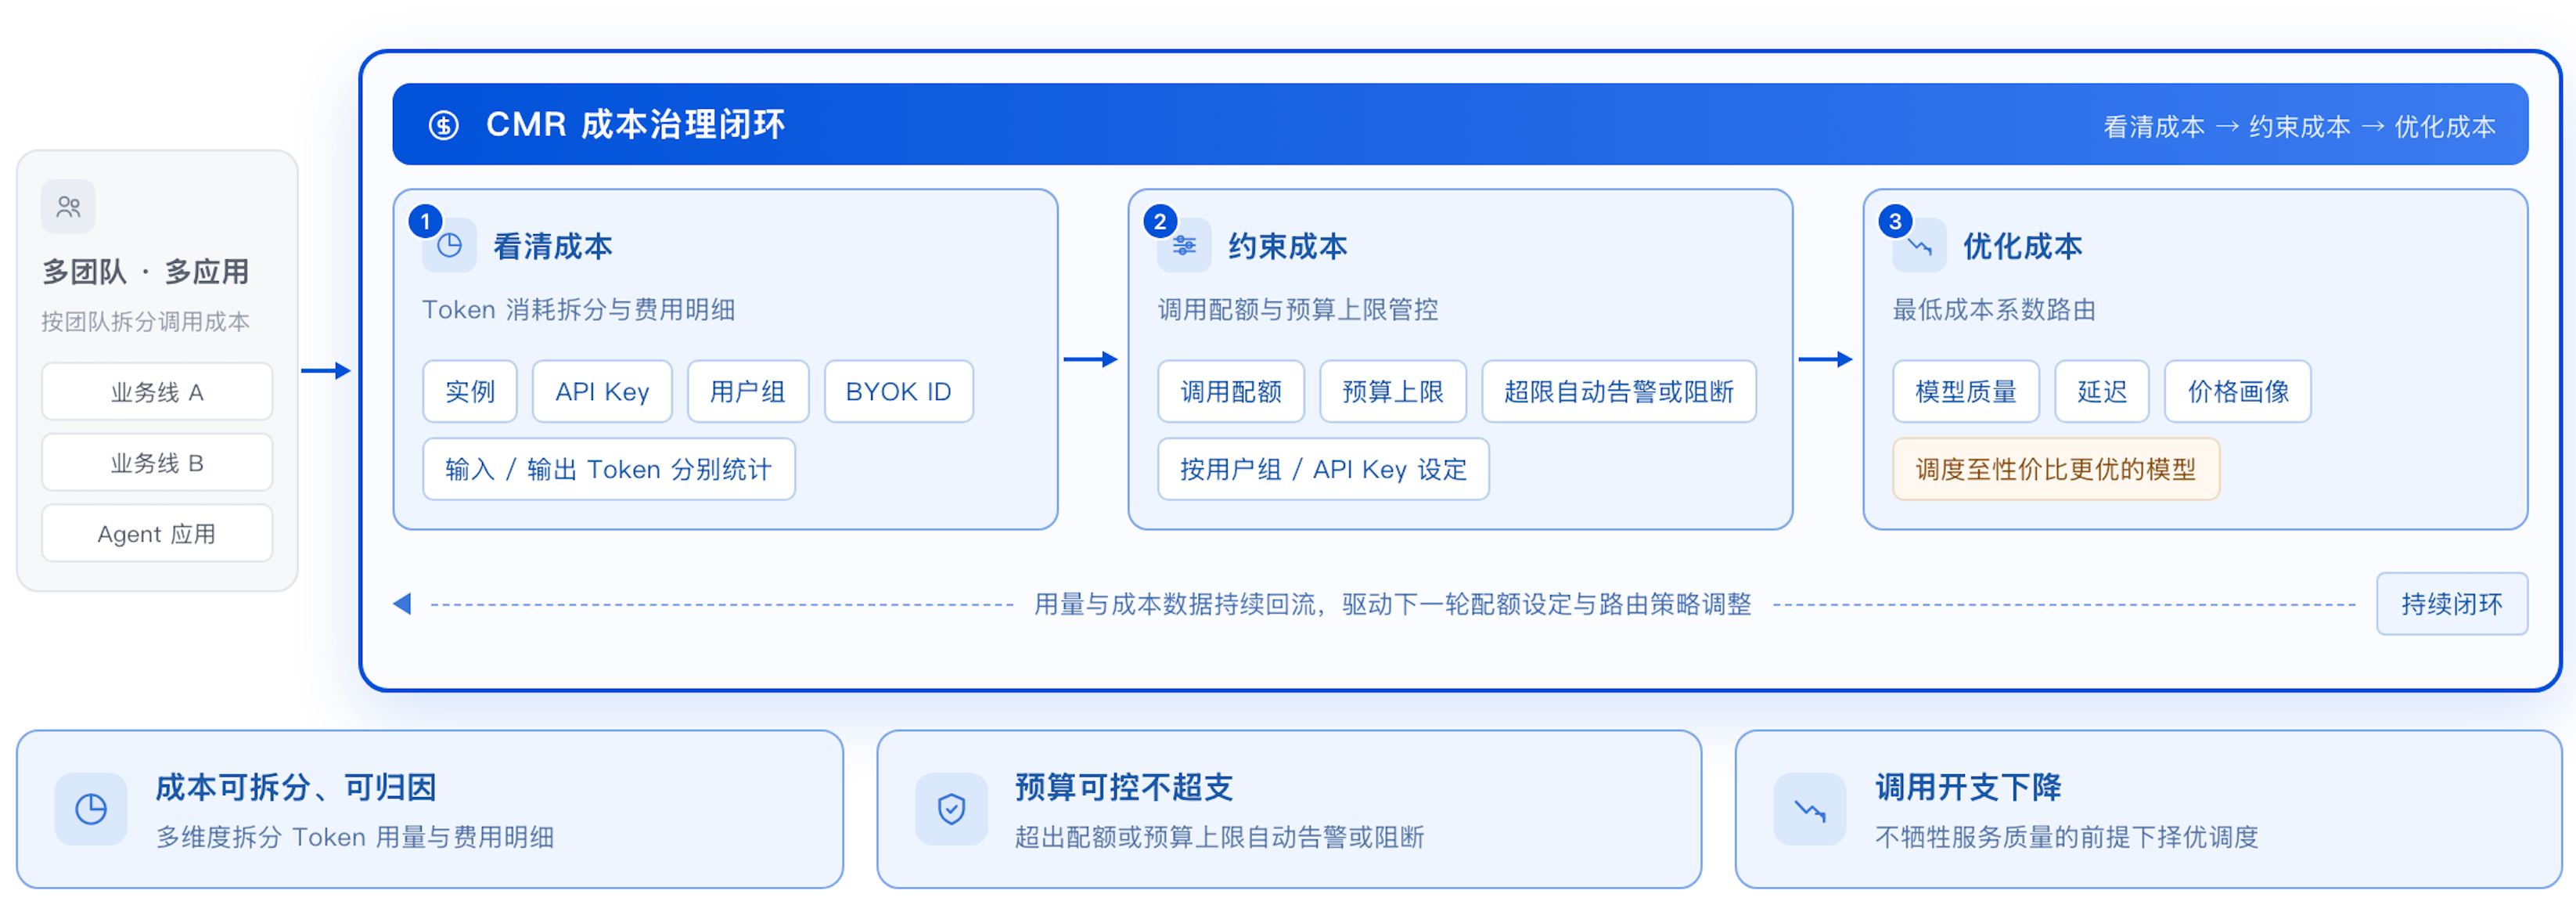
在多团队、多应用共享模型资源的场景下,不同业务线、不同 API Key 的 Token 消耗难以拆分,成本因此缺少依据,容易出现预算超支或资源浪费。
模型路由 CMR 提供按 CMR 实例、API Key、用户组、BYOK ID 等维度的 Token 消耗拆分与费用明细,支持输入 / 输出 Token 分别统计,让每一笔调用开销都可归因、可核算。您可以为不同用户组或 API Key 设定调用配额与预算上限,超限时自动触发告警或阻断,把成本约束在可控范围内。
在看清成本构成的基础上,模型路由 CMR 进一步提供两项主动降本能力,帮助从“成本可见”走向“成本更优”:一是语义缓存,对语义相近的重复请求可直接复用已有结果,提升缓存命中率,从而减少重复计算带来的无效 Token 消耗;二是智能成本路由,可结合模型质量、延迟与价格画像,将请求自动调度至性价比更优的模型,在不牺牲服务质量的前提下降低模型调用开支。两者与前述的用量拆分、配额管控相互配合,形成「看清成本 → 约束成本 → 优化成本」的闭环。
企业级安全与全链路审计
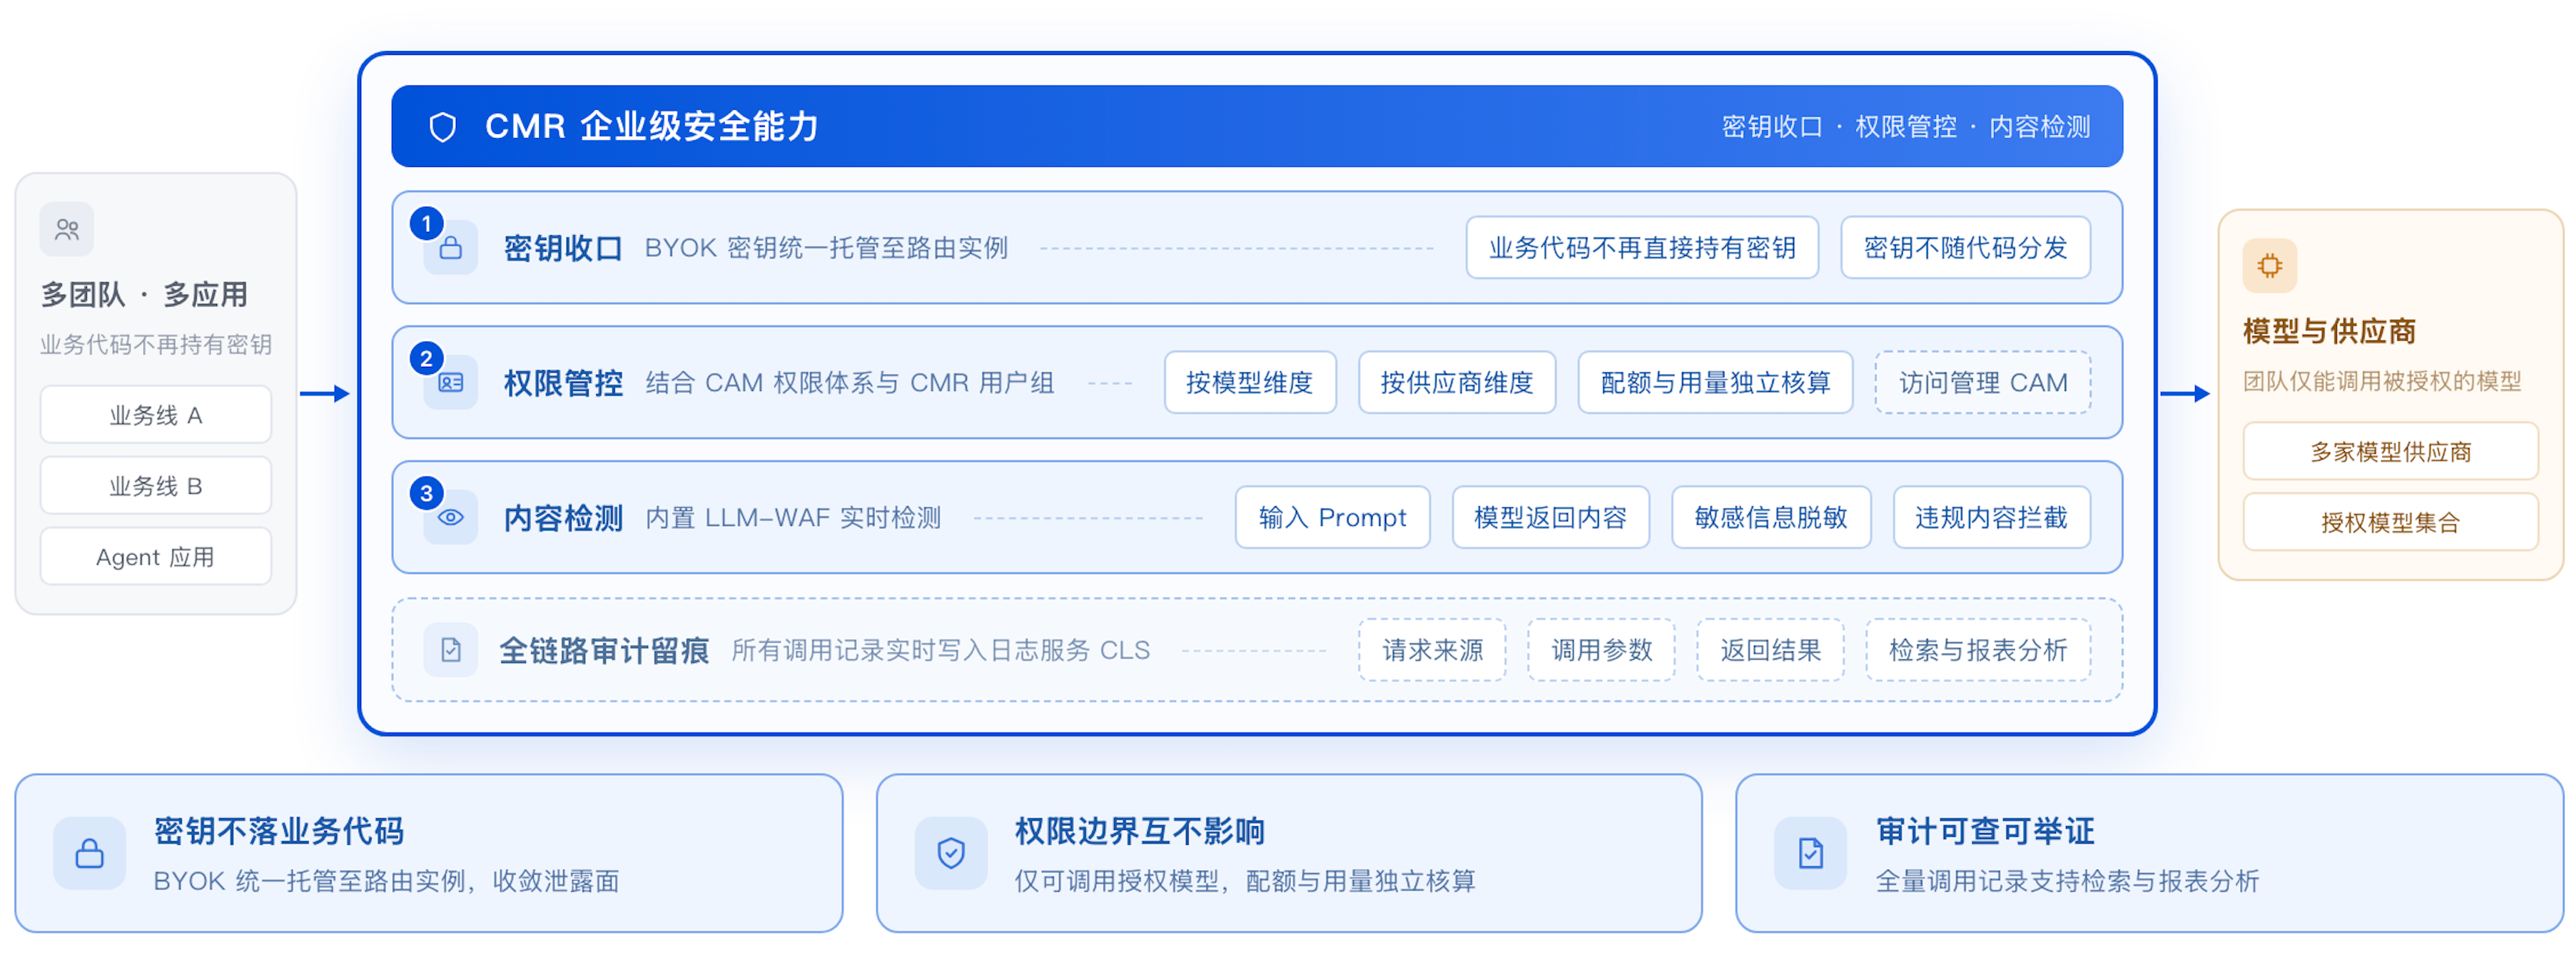
当企业内多个团队、多个应用同时接入大模型时,模型 API Key 往往散落在各业务代码中,既增加泄露与滥用风险,又使调用行为缺乏统一记录,难以满足内部安全管理与审计要求。
模型路由 CMR 支持将 BYOK 密钥统一托管至路由实例,业务代码中不再直接持有密钥。结合 访问管理 CAM 的权限体系和模型路由的用户组能力,您可按模型、供应商维度配置细粒度访问策略:不同团队与业务线只能调用被授权的模型,各自的配额与用量独立核算,权限边界与资源用量互不影响。
内置 LLM-WAF 对输入 Prompt 与模型返回内容进行实时检测,支持敏感信息脱敏与违规内容拦截。所有调用记录实时写入 日志服务 CLS,涵盖请求来源、调用参数、返回结果等字段,支持检索与报表分析,为企业的内部审计与合规举证提供完整依据。


