TDSQL Nexa 是一个 AI 原生多模数据库:它在一套系统内融合了宽表、分析、搜索等计算能力,并通过核心引擎与实时数据流通道,把各引擎的数据无缝打通、把各引擎的能力按需组合编排,从而支撑智能驾驶、具身智能、搜索、广告、推荐以及企业 Agent 等场景下,从数据产生、分析到应用的全链路。
为什么选择 TDSQL Nexa
长期以来,构建一个数据应用意味着先做一道选择题:交易数据放进事务数据库,日志与文本丢给 Elasticsearch,报表分析再搭一套数仓,语义检索还要额外引入向量库。每一种负载都能找到一个最合适的数据库,但把它们拼在一起,得到的却是一套离散、碎片化的数据方案——数据被复制成多份,散落在不同系统中,靠 ETL 和消息队列艰难地缝合。系统复杂度、运维成本与故障概率,都随着组件数量的增加而被成倍放大。
进入 Agent 时代,这种碎片化的代价被进一步放大。Agent 需要的是统一、一致的上下文,以及一套可以直接调用的数据处理工具;而面对四五套语义各异、口径不一、时效参差的数据系统,Agent 既难以获得完整的数据视图,也难以可靠地完成数据操作。数据层的割裂,最终会拖慢整个业务的迭代与演进速度。
在 TDSQL Nexa 里面,事务、分析、检索等多种存储与计算引擎开箱即用,覆盖数据应用所需的主要负载类型;更重要的是,这些引擎在产品内原生打通,数据在引擎之间实时流转,能力之间可以自由组合编排。业务不再需要为了一条数据链路去拼装多套系统,而是可以在一个数据库里完成整个数据应用的构建。
在此之上,TDSQL Nexa 还内置了 Knowledge Agent,帮助人与 Agent 更好地理解数据——数据在哪里、是什么含义、该怎么用,从而让数据应用的构建过程本身也变得更加智能和高效。
TDSQL Nexa 的架构
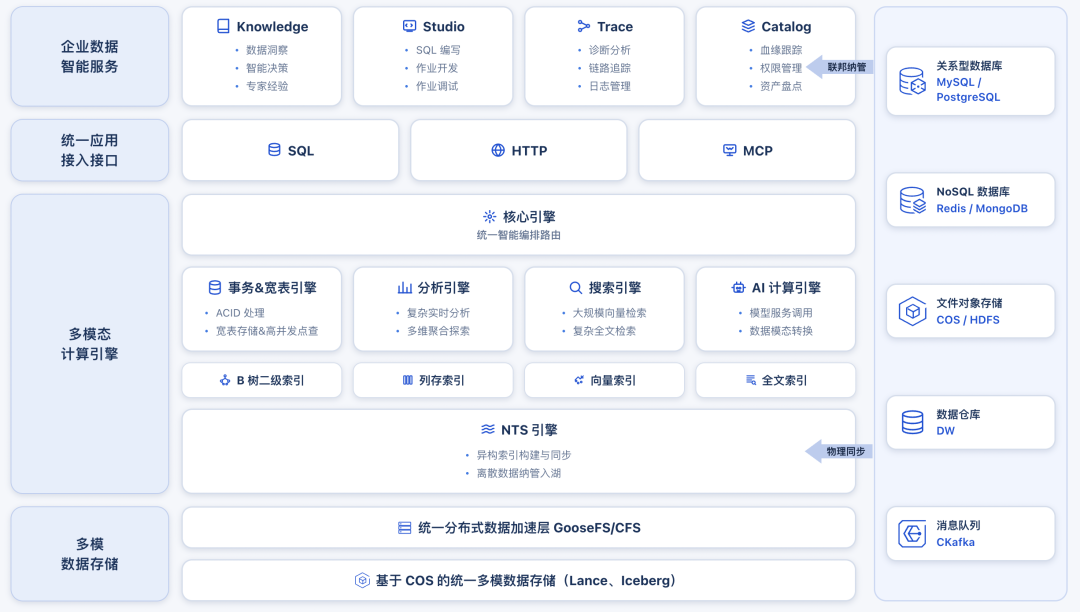
TDSQL Nexa 的架构中最核心的是多模态计算引擎。由此向下看的组件解决数据如何流动与沉淀,向上看的组件解决能力如何被编排和使用。
核心:多模态计算引擎
每一类计算引擎都依托各自的底层存储结构,提供一类专门的数据处理能力,同时保持对主流开源生态的接口兼容。
引擎 | 核心能力 | 接口兼容 |
宽表引擎 | 高并发写入与点查、ACID 事务、宽表存储 | MySQL、HBase |
分析引擎 | 分布式并行计算分析、高效数据压缩与扫描 | MySQL、PostgreSQL |
搜索引擎 | 大规模向量与文档数据的存储与检索 | OpenSearch、Elasticsearch |
AI 计算引擎 | 非结构化数据处理:文档解析拆分、视频拆条与转码等 | Ray |
向下:NTS 引擎与统一存储
有了核心的多模引擎之后,往下一层是 NTS 引擎,它是各引擎之间数据得以无缝打通的关键:
异构索引同步:负责各计算引擎之间异构索引的构建与同步,让同一份数据在不同引擎中保持一致视图。
实时入湖:将各多模存储引擎的数据实时沉淀到数据湖,形成低成本、格式开放的统一底座(基于 COS,采用 Lance、Iceberg 等表格式)。
离散数据纳管:对外部离散的各类数据源提供纳管能力,一键同步到各异构引擎,或直接写入数据湖。
湖上数据的访问性能,由统一分布式数据加速层 GooseFS / CFS 提供,弥合低成本对象存储与高性能计算之间的性能差距。
向上:核心引擎&统一应用接入接口
在多模引擎之上是核心引擎。它让多个引擎对外表现为一个数据库或者是一个表:各引擎既可以作为彼此的索引相互配合,也可以被组合编排后统一对外提供服务——应用只需表达需求,无需关心由哪个引擎执行、如何协同。
再往上是兼容各开源协议的访问层,提供 SQL、HTTP 与 MCP 等接入方式,既贴合既有的开发习惯与工具生态,也为 AI Agent 提供标准化的数据调用入口。
最上层:企业级数据智能服务
构建在整套数据系统之上的企业级数据智能服务,让数据不只是被存储和查询,更能被理解和使用:
服务 | 能力 |
Knowledge | 基于统一的数据解决数据洞察、智能决策问题,沉淀专家经验 |
Studio | 统一的 SQL 编写、作业开发与作业调试能力 |
Trace | 诊断分析、链路追踪、日志管理 |
Catalog | 血缘跟踪、权限管理、资产盘点 |


