概述
不同框架上报的 Trace 数据,字段名称和写法各不相同。例如同样是"一次工具调用",OpenTelemetry、OpenInference 和 Langfuse 各有各的写法。
Agent 可观测在数据写入时会自动进行归一化,将这些不同写法统一为同一套格式。无论您使用哪种框架上报,调用类型、输入输出、Token 用量、会话等信息都能在控制台中正确展示和统计,无需修改应用代码或调整上报方式。
下图以“一次工具调用”为例,展示归一化的过程:
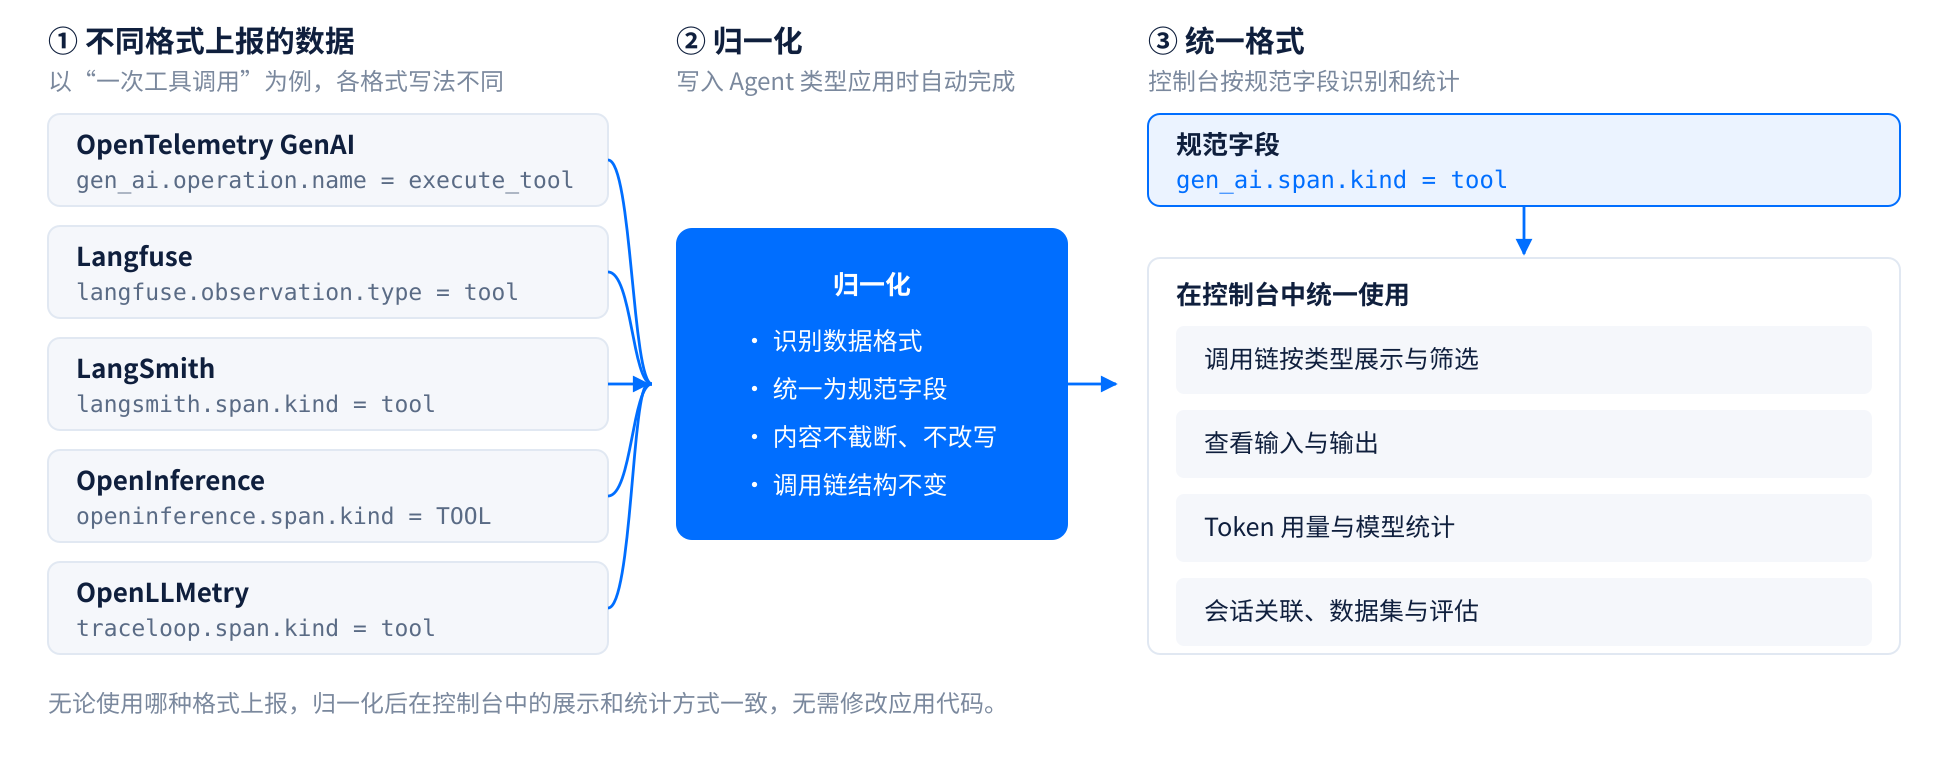
说明:
归一化仅对接入类型为 Agent 的应用生效。接入类型为 Langfuse 的应用保留 Langfuse 原生数据格式,不进行归一化。
归一化的作用
归一化完成后,以下信息可在控制台中统一查看:
信息 | 在控制台中的体现 |
调用类型 | 调用链中每个节点按类型展示,如入口、Agent、模型调用、工具调用、检索,并可按类型筛选 |
输入与输出 | 在调用详情中展示每一步的输入和输出内容 |
Token 用量 | 在调用详情中展示,并汇总到应用的 Token 统计 |
模型 | 在模型调用节点中展示所使用的模型 |
会话与用户 | 同一会话的多轮调用可关联查看,并可按用户检索 |
支持的上报来源
以下格式的数据上报到 Agent 类型的应用后,均会自动归一化,与上报时使用哪种接入方式无关:
OpenTelemetry GenAI
Langfuse
LangSmith
OpenInference
OpenLLMetry
同一个应用中可以同时使用多种上报来源,各自独立识别,互不影响。
示例
不同格式记录同一类信息时使用的字段不同,归一化会把它们统一为规范字段。以下是几类核心信息的转换示例。
调用类型
以“一次工具调用”为例,五种格式的写法如下:
上报格式 | 上报时的写法 | 归一化后的写法 |
OpenTelemetry GenAI | gen_ai.operation.name=execute_tool | gen_ai.span.kind=tool |
Langfuse | langfuse.observation.type=tool | gen_ai.span.kind=tool |
LangSmith | langsmith.span.kind=tool | gen_ai.span.kind=tool |
OpenInference | openinference.span.kind=TOOL | gen_ai.span.kind=tool |
OpenLLMetry | traceloop.span.kind=tool | gen_ai.span.kind=tool |
五种写法归一化后都统一为
gen_ai.span.kind=tool,控制台据此把这类节点识别为工具调用。模型调用、Agent、检索等其他调用类型也按同样方式统一,例如 openinference.span.kind=LLM 和 langfuse.observation.type=generation 都统一为 gen_ai.span.kind=chat,在控制台中识别为模型调用。模型、输入输出、Token 用量与会话
信息 | 上报时的写法(举例) | 归一化后的写法 |
模型 | llm.model_name(OpenInference)、langfuse.observation.model.name(Langfuse) | gen_ai.request.model |
输入 | input.value(OpenInference)、langfuse.observation.input(Langfuse) | gen_ai.input.messages |
输出 | output.value(OpenInference)、langfuse.observation.output(Langfuse) | gen_ai.output.messages |
输入 Token | llm.token_count.prompt(OpenInference)、langfuse.observation.usage_details 中的 input(Langfuse) | gen_ai.usage.input_tokens |
输出 Token | llm.token_count.completion(OpenInference)、langfuse.observation.usage_details 中的 output(Langfuse) | gen_ai.usage.output_tokens |
会话 | session.id(Langfuse、OpenInference) | gen_ai.session.id |
完整示例:一次模型调用
以 OpenInference 上报的一次模型调用为例,归一化前后的数据如下(仅列出与归一化相关的字段)。
上报时的数据:
{"openinference.span.kind": "LLM","llm.model_name": "deepseek-v3","input.value": "[{\\"role\\": \\"user\\", \\"content\\": \\"订单 ORD-70007 能换成大容量的吗?\\"}]","output.value": "{\\"role\\": \\"assistant\\", \\"content\\": \\"可以换货,需补差价 40 元。\\"}","llm.token_count.prompt": 1423,"llm.token_count.completion": 286,"session.id": "session-001"}
归一化后的数据:
{"gen_ai.span.kind": "chat","gen_ai.request.model": "deepseek-v3","gen_ai.input.messages": "[{\\"role\\": \\"user\\", \\"content\\": \\"订单 ORD-70007 能换成大容量的吗?\\"}]","gen_ai.output.messages": "[{\\"role\\": \\"assistant\\", \\"content\\": \\"可以换货,需补差价 40 元。\\"}]","gen_ai.usage.input_tokens": 1423,"gen_ai.usage.output_tokens": 286,"gen_ai.session.id": "session-001"}
归一化后,这次调用在控制台中显示为模型调用节点,可以查看输入输出、所用模型和 Token 用量,并与同一会话的其他调用关联。完整的规范字段定义请参见 Agent 可观测 Trace 规范字段定义说明。
常见问题
归一化会改变原始数据吗?
不会。归一化只统一字段的写法,不影响数据本身:
不丢弃数据:不符合规范或无法识别的数据同样正常写入,原始字段完整保留。
不截断内容:输入、输出等内容按原样保存,不做截断、改写或摘要。
不改变调用链:调用链的父子关系、开始时间和耗时与上报时一致。
为什么有的调用没有显示类型?
通常是上报的数据中没有携带调用类型信息,或者所用框架的某种类型暂不在支持范围内。这类数据仍会正常写入并完整保留,只是不显示类型。建议在上报端补充调用类型信息,具体可参见 Agent 可观测 Trace 规范字段定义说明。
为什么按原来的字段名搜不到数据?
归一化后,部分字段统一为规范名称,原字段名可能不再单独保留。数据并未丢失,可改用规范字段名检索。
需要做什么配置才能使用归一化?
不需要。将数据上报到接入类型为 Agent 的应用,写入时即自动完成归一化。
为什么 Langfuse 类型应用中的数据没有归一化?
归一化仅对 Agent 类型的应用生效。Langfuse 类型的应用保留 Langfuse 原生数据格式,字段含义请参见 Langfuse SDK Trace 字段说明。如需归一化,请将数据上报到 Agent 类型的应用。
相关文档
选择接入方式


