功能概述
为支撑 “边打电话边看屏” 一类的 AI 实时语音助手场景,TRTC AI 实时对话在音频对话链路的基础上,提供截图 + 视频上行的视觉理解(VLM)能力:客户端按需截取屏幕 / 摄像头画面并上行,AI 后台将截图连同用户的语音提问一同送入多模态大模型,LLM 基于“用户语音 + 画面内容”共同理解并回复。
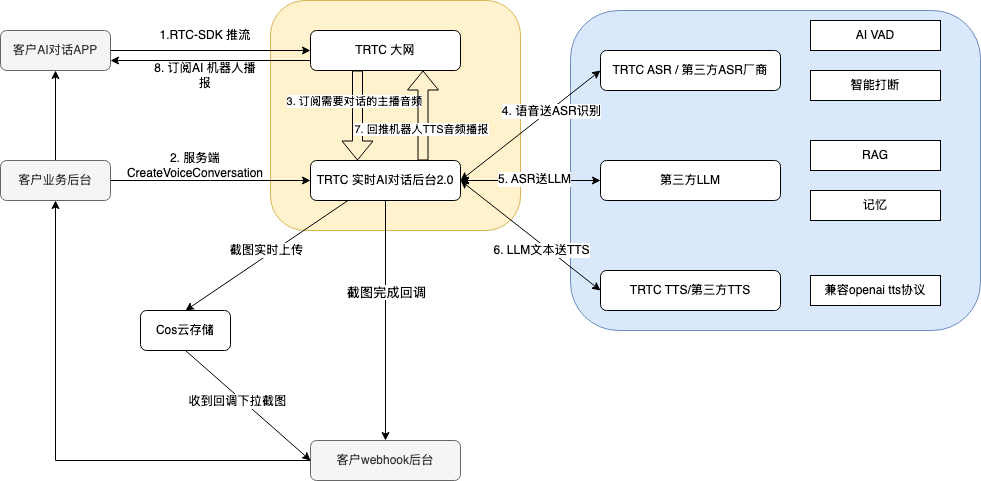
截图对话(三段式)架构图:
功能原理
视觉理解链路不进行实时逐帧推理,而是围绕“按需截取、按需理解”设计:
环节 | 说明 |
截图策略 | 基于环境变化、陀螺仪感知等触发,截取屏幕 / 摄像头画面。 |
后台缓存 + 存储 | TRTC 后台接收后缓存最近若干帧(滑动缓冲区);可选将截图异步上传到云存储归档。 |
按需送 LLM | 发生交互时(用户语音提问、周期性触发),后台从缓存队列取出截图,连同用户文本/指令发送给多模态 LLM 分析。 |
VLM 回复 | LLM 基于“用户语音 + 截图内容”共同理解并回复,例如:“你截图里的这个按钮点不动,是因为它当前是灰色禁用状态”。 |
典型的交互形态包括:视频截图对话(对当前画面提问)、定帧提问(对指定帧提问)、本地相册提问(对本地图片提问)。
配置结构
创建 AI 对话任务时,通过
VisionConfig 启用视觉理解:"VisionConfig": {"Enable": true,"StorageType": 0,"CloudStorage": null}
VisionConfig 字段说明:
字段名 | 必选 | 类型 | 描述 |
Enable | 是 | Boolean | 是否启用 VLM。运行时不可切换,需重建任务。 |
StorageType | 否 | Integer | 存储类型: 0=不存储(默认);1=指定云存储(需填 CloudStorage)。不支持更新。 |
CloudStorage | 否 | Object | 云存储归档配置,见下表。 |
CloudStorage 字段说明:
字段名 | 必选 | 类型 | 描述 |
Vendor | 是 | Integer | 0=腾讯云 COS;1=AWS S3。 |
Region | 是 | String | 存储地域。 |
Bucket | 是 | String | 存储桶名称。 |
AccessKey | 是 | String | 访问密钥(COS 对应 SecretId)。 |
SecretKey | 是 | String | 密钥(COS 对应 SecretKey)。 |
FileNamePrefix | 否 | Array of String | 存储路径前缀数组,总长度 ≤ 128。 |
启用条件
条件 | 说明 |
多模态模型 | LLMConfig.Model 必须是多模态模型,例如 hunyuan-vision / gpt-4o / gpt-4o-mini / qwen-vl-plus。 |
仅 Cascade 模式 | 视觉理解仅三段式模式支持,S2S + VLM 组合暂不可用。 |
SDK 版本 | 客户端 TRTC SDK 需升级到支持截图功能的版本。 |
不支持热更新 | VisionConfig 不支持运行时更新,变更需结束任务并重新创建。 |
客户端接入
步骤1:进房
客户端集成 TRTC SDK 后,以主播角色进入房间(成功条件:
TRTCCloudListener.onEnterRoom(result > 0)):TRTCParams params = new TRTCParams();params.sdkAppId = <sdkAppId>;params.userId = <localUserId>;params.userSig = <userSig>;params.roomId = <roomId>;params.role = TRTCRoleAnchor;trtc.enterRoom(params, TRTC_APP_SCENE_VIDEOCALL);
步骤2:连接后台机器人
trtc.callExperimentalAPI(JSON);JSON:{"api": "aiConversation","params": {"command": "connect","robotid": "<Robot User Id>"}}
连接结果通过
onExperimentalEvent 的 onCommand 事件回调:code | 含义 |
0 | 通道建立成功。 |
-2 | 参数错误,缺少 robotid。 |
2001 | 任务不存在或已结束。 |
2002 | SDK 版本过低,不支持所需能力。 |
步骤3:截图提问
使用 TRTC 截图 API 截取画面,压缩为 JPEG 后通过试验性接口发送给 AI:
trtc.snapshotVideo("", TRTCCloudDef.TRTC_VIDEO_STREAM_TYPE_BIG,TRTCCloudDef.TRTC_SNAPSHOT_SOURCE_TYPE_VIEW,new TRTCCloudListener.TRTCSnapshotListener() {@Overridepublic void onSnapshotComplete(Bitmap bitmap) {if (bitmap == null) {return;}try {ByteArrayOutputStream out = new ByteArrayOutputStream();bitmap.compress(Bitmap.CompressFormat.JPEG, 80, out);// 将 JPEG 数据 Base64 编码后调用 sendImage 接口发送}catch (Exception e) {e.printStackTrace();}}});
trtc.callExperimentalAPI(JSON);JSON:{"api": "aiConversation","params": {"command": "sendImage","robotid": "<Robot User Id>","payload": {"format": "jpeg","image": "<Base64 JPEG>"}}}
说明:
sendImage 同样适用于本地相册提问,将相册图片读取并 Base64 编码后,通过同一接口发送即可。发送成功不回调,仅失败时通过 onCommand 事件返回错误码。云存储归档
配置
StorageType=1 + CloudStorage 后,后台将收到的每帧截图异步上传至您的云存储桶归档,对象路径规则:vision/{SdkAppId}/{YYYYMMDD}/{TaskId}/{captureTs}_{reason}_{frameId}.jpg
路径字段 | 说明 |
SdkAppId | 应用 ID。 |
YYYYMMDD | 截图日期。 |
TaskId | 任务 ID。 |
captureTs | 截图时间戳。 |
reason | 截图原因(例如 scene_change)。 |
frameId | 帧 ID。 |
注意:
不配置
CloudStorage 时,截图仅驻留后台内存用于当轮对话理解,不落盘、不归档。注意事项
1. 多模态模型是硬性前提:
LLMConfig.Model 为纯文本模型时启用 VLM 会导致视觉内容无法被理解。2. 不支持热更新:
VisionConfig(含 Enable、StorageType、CloudStorage)均不支持通过修改任务接口变更,需重建任务。3. 仅 Cascade 模式支持:S2S 模式下音频直接进端到端模型,暂无视觉理解链路。
4. 截图时机:后台对截图做缓存后按需取用,无需业务侧实时推送每一帧;建议结合环境变化、陀螺仪感知等策略截取关键画面,降低上行带宽。


