Llama3.1大模型
原创
背景
Llama 3.1是一款由Meta(前Facebook)推出的先进大型语言模型。它在自然语言处理领域具有显著优势,为用户提供高质量的文本生成、理解和推理能力。
Transformer架构
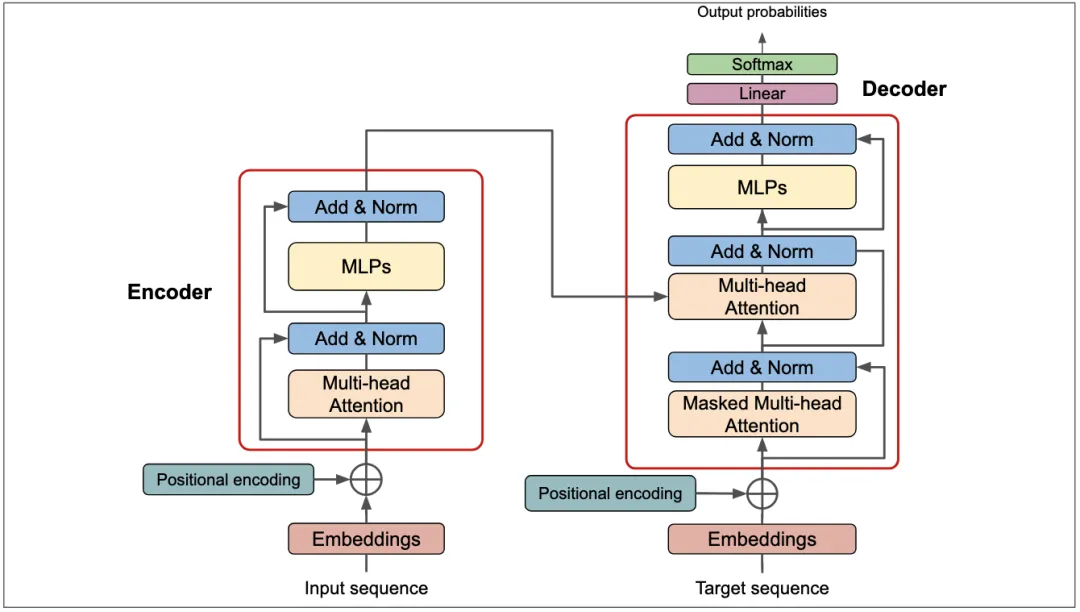
Transformer是一种神经网络架构,可以处理文本、音频、视频和图像等顺序数据(作为图像补丁的序列)。Transformer不使用任何循环层或卷积层。它的基础层叫做Attention(注意力)。它还包含其他基本层,如全连接层、规范化层[主要是LayerNorm](Ba, Kiros, and Hinton 2016)、Embedding层和位置编码层。在下一节中,我们将看到这些层的作用。
图片
Llama 3.1基于Transformer架构,通过庞大的训练数据集进行训练,使其具备强大的语义理解和上下文捕捉能力。该模型在多个NLP任务中表现出色,如问答、文本摘要、情感分析等。
此外,Llama 3.1还注重模型的可解释性和安全性。它采用了一系列技术手段来提高模型的透明度,使用户能够更好地理解模型的工作原理。
同时,通过对抗性训练和安全评估,Llama 3.1在防止恶意攻击和生成不安全内容方面也取得了显著成果。
开源版本
Llama 3.1 405B is the first openly available model that rivals the top AI models when it comes to state-of-the-art capabilities in general knowledge, steerability, math, tool use, and multilingual translation.目前Llama 3.1 模型的开源版本有3个:
- 8B
- 70B
- 405B(当前最大的开源大模型)
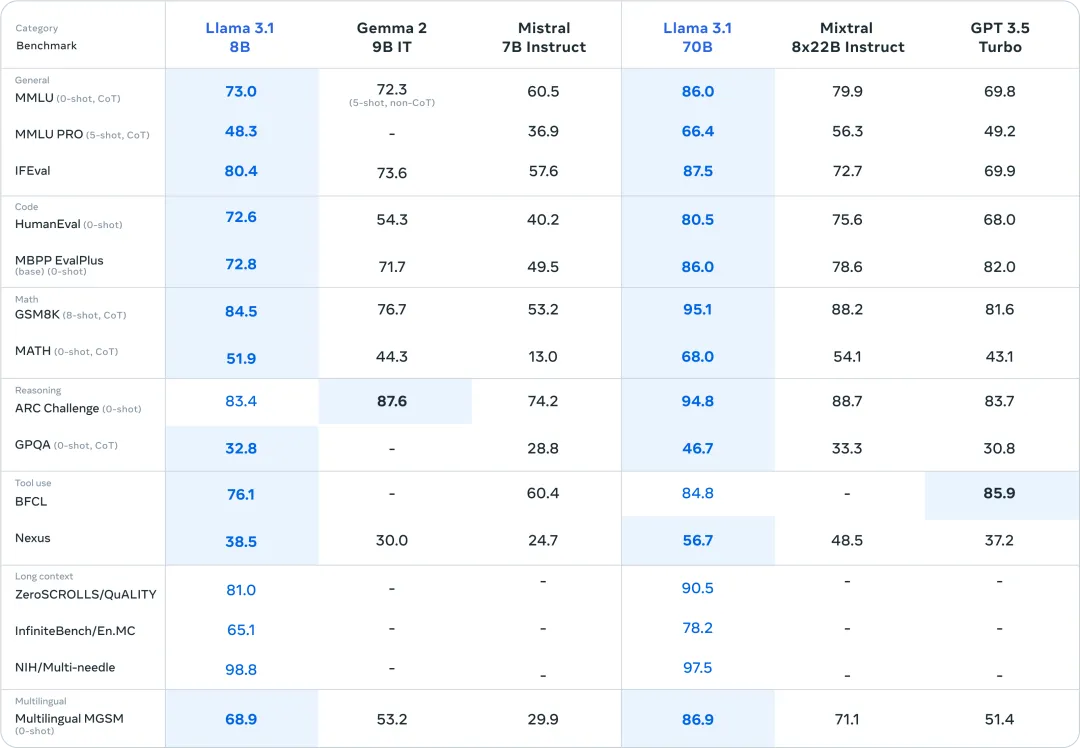
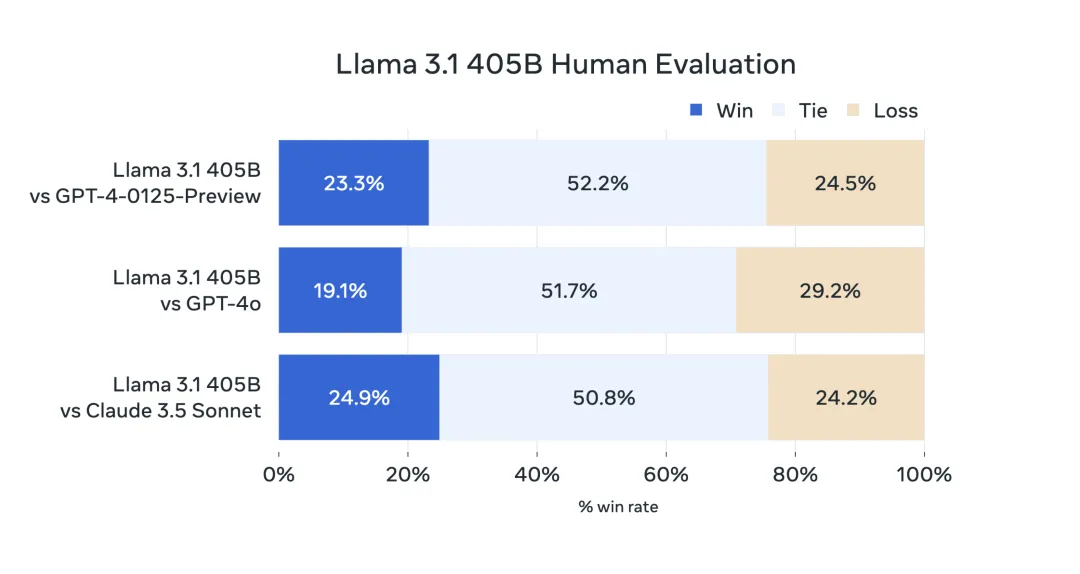
模型评估
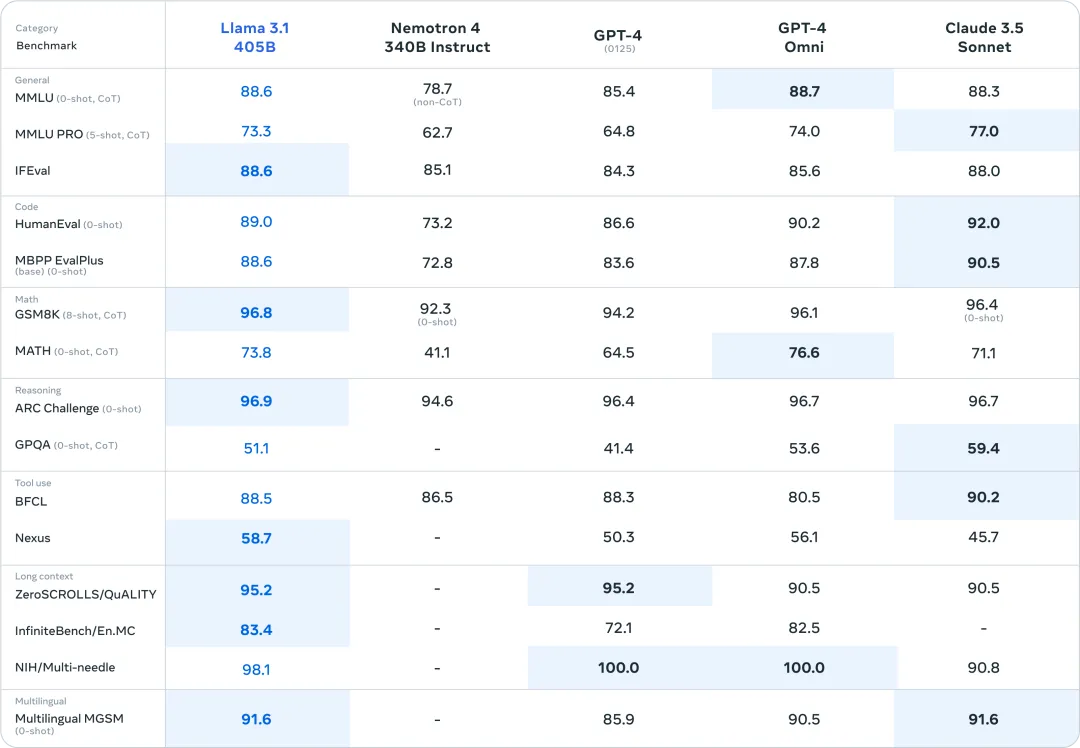
从公布的基准测试来看,Llama3.1已经可以轻松击败GPT-4了。
图片
图片
- 人工评估结果
图片
总结
Llama 3.1大模型凭借其卓越的性能和可靠性,为自然语言处理领域带来了新的突破。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号