GLM-PC和Operator对比:哪个Agent效果更好?
原创
GLM-PC和Operator对比:哪个Agent效果更好?
原创
算法一只狗
发布于 2025-02-05 21:57:58
发布于 2025-02-05 21:57:58
最近,智谱和OpenAI都发布了自己的第一个智能体,可以基于多模态自动化操作电脑。
目前智谱的GLM-PC已经推出了1.1最新的版本,mac和windows用户都可以去到官网中下载体验:

而OpenAI的Operator目前仅支持浏览器操作。也就是它可以自己使用浏览器查询,查看网页并通过键入、点击和滚动与之交互。目前OpenAI发出的是预览版,仅提供给Pro用户(200美元一个月)进行使用,所以我这个普通的plus用户还没有资格体验到。

他们的差别是什么?
在技术路线方面,GLM-PC 与 Operator 采用了相似的技术方案,即基于多模态大模型的视觉识别与空间交互能力。据 OpenAI 介绍,Operator 依托其最新研发的 Computer-Using Agent (CUA) 模型,能够通过直接观察屏幕并使用虚拟鼠标和键盘执行任务,而无需依赖专门的 API 接口。
CUA 的核心流程如下:本质上,该模型通过处理原始像素数据理解屏幕状态,并结合鼠标和键盘的操作完成相应指令。其优势在于能够执行 多步骤任务,具备 错误处理能力,并能适应 动态变化的环境,从而在各种数字场景中高效运行。无须特定 API 的支持,CUA 即可完成如 自动填写表单、网页浏览、界面操作 等复杂任务,展现出高度的通用性与自主适应能力。

从整体架构来看,Operator 的输入包括用户命令和当前扫描到的屏幕状态信息,随后利用 COT(Chain-of-Thought)思维链 进行推理,总结出需要执行的步骤,并最终操作浏览器完成相应任务。其工作流程可概括为以下三个核心阶段:
1. 感知(Perception)
CUA 通过截取 屏幕截图 作为计算机当前状态的视觉快照,并将其纳入模型的上下文。这些截图提供了环境信息,使模型能够实时追踪任务进展,并调整后续操作。
2. 推理(Reasoning)
基于 链式思维(Chain-of-Thought, COT),CUA 结合 当前和历史截图 以及 已执行的操作步骤 进行推理。这种“内部独白”机制使模型能够更精确地评估观察结果,追踪任务中间状态,并动态调整执行策略,以提高任务的完成准确性与灵活性。
3. 操作(Action)
模型执行点击、滚动、文本输入等交互操作,直至判断任务完成或等待用户进一步指令。对于 敏感操作(如登录信息输入或 CAPTCHA 验证),CUA 具备安全策略,会请求用户确认,以确保隐私保护与数据安全。
早在 2023 年 12 月,智谱发布了 CogAgent——其首个 基于视觉语言模型(Visual Language Model, VLM) 的开源 图形界面智能体(GUI Agent)。GLM-PC 作为 CogAgent 的早期产品,进一步拓展了这一技术的能力。据开发文档介绍,GLM-PC 通过 多模态感知 实现了对整个 GUI 空间的交互,使其能够像人类一样以 视觉方式感知界面元素和布局,并模拟人类操作,如 点击、滚动、键盘输入 等基础交互。这一能力显著拓宽了智能体在 虚拟交互空间 中的应用场景,为 自动化办公、智能助手、软件自动化测试 等领域提供了更强的支持。
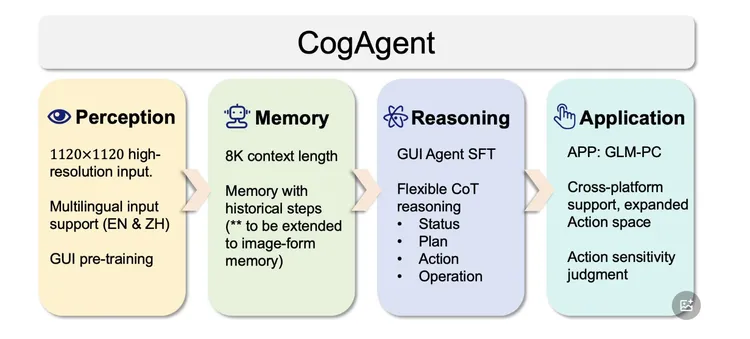
GLM-PC和operator技术路线看,大致都是相同的。两者均基于多模态大模型,具备视觉识别与空间交互的核心能力。也依赖多模态感知(视觉语言模型)来观察屏幕元素,并在虚拟环境中执行任务。
但更大的差异性在于用户体验,从官方给出的文档上看,GLM-PC的功能更加完善,而且完全免费,下载就能玩。相比于要用200美元去体验OpenAI的operator,我更愿意使用智谱的GLM-PC。来使得我的电脑更加智能。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号