InfluxDB 时序数据的高效解决方案
原创
InfluxDB 时序数据的高效解决方案
原创
左诗右码
发布于 2025-06-23 16:53:20
发布于 2025-06-23 16:53:20
InfluxDB 是什么?
它是一种开源的数据库,主要针对时间序列数据进行优化,能够高效地存储、检索和分析大量的时间序列数据。

官方首页
InfluxDB 使用 Tag-Key-Value 模型来组织数据,这种模型便于对时间序列数据进行分类和聚合。它支持类 SQL 的查询语言 InfluxQL 和 Flux,适合复杂查询需求。InfluxDB 的架构设计使其在处理高频率、连续的时间序列数据时表现出色,例如监控系统中的指标数据、物联网设备的传感器数据、日志数据等。
InfluxDB 有哪些特点?
InfluxDB 是一款时序型数据库,主要特点包括:
- 专注时序数据:专为处理随时间变化的连续数据设计,常用于监控、物联网(IoT)、日志分析、实时分析等场景。
- 高性能写入与查询:能够支持高并发写入(例如每秒千万级数据点),同时针对时间范围查询做了专门优化。
- 灵活的无模式数据模型:不像传统关系型数据库那样需要预先定义表结构,InfluxDB 使用 Measurement(类似表)、 Tags(索引字段)和 Fields(实际数据)来存储数据。
- 内置数据生命周期管理:通过数据保留策略(Retention Policy)和连续查询(Continuous Query),自动处理数据归档、下采样和删除,降低存储成本。
InfluxDB 解决了哪些痛点?
在传统数据库中,处理时序数据时往往面临以下问题:
- 高写入负载难题undefined传统关系型数据库如 MySQL 在海量、高频率数据写入场景下容易出现性能瓶颈,写入延迟较高。而 InfluxDB 专为高写入量设计,可以快速写入海量时序数据。
- 低效的时间查询undefinedMySQL 的数据以行存储,数据行之间没有天然的时间序列组织;而 InfluxDB 针对时间区间查询进行优化,能够高效聚合和分析数据。
- 存储成本高undefined时序数据通常量大且增长迅速,InfluxDB 通过数据压缩和自动清理过期数据(保留策略),大幅降低存储成本。
- 实时监控和预警需求undefined对于运维监控、设备监控等业务,需要实时获取数据并进行预警。InfluxDB 内建的连续查询和内置函数能够迅速聚合和处理数据,满足实时需求。
InfluxDB 和 MySQL 的区别
数据模型
InfluxDB 采用 Tag-Key-Value 模型,数据以时间戳为主索引,支持快速写入和查询大量数据点。而 MySQL 使用传统的表格模型,数据以行和列的形式组织,适用于结构化数据的存储。
查询语言
InfluxDB 支持 InfluxQL 和 Flux 查询语言,专注于时间序列数据的查询和分析。MySQL 则使用标准的 SQL 查询语言,能够进行复杂的查询操作,适用于各种通用的数据库应用场景。
性能
InfluxDB 在处理时间序列数据时性能更优,特别是在大数据量下的写入和查询操作。MySQL 在处理结构化数据时性能稳定,适合复杂的 JOIN 操作和事务处理。
扩展性
InfluxDB 支持水平扩展,可以通过增加节点来提高性能和存储容量。MySQL 也支持水平扩展,但通常需要更复杂的配置和硬件资源。
事务支持
InfluxDB 不支持事务,适用于实时分析场景。MySQL 支持事务,确保数据的一致性和完整性,适合需要复杂事务处理的业务场景。
存储管理
InfluxDB 提供自动数据保留、下采样和压缩等功能;MySQL 则需要开发者手动设计归档方案来处理大量数据。
InfluxDB vs MySQL
特性 | InfluxDB | MySQL |
|---|---|---|
数据模型 | 时序数据(时间为主键) | 关系型数据(主键自增) |
查询语言 | InfluxQL / Flux | SQL |
写入性能 | 单机百万级/秒 | 万级/秒 |
存储效率 | 高压缩(适合海量数据) | 低压缩(适合事务数据) |
典型场景 | 监控、IoT、实时分析 | 电商、ERP、用户管理 |
在 InfluxDB 中,有一些专业名词,它们与传统数据库中的名词有相似之处但又有所不同。了解这些名词的类比关系有助于更好地理解和使用 InfluxDB。
InfluxDB 术语 | 类比 MySQL | 说明 |
|---|---|---|
Measurement | Table | 数据表(如 |
Point | Row | 一行数据(包含时间戳) |
Tag | 索引列 | 用于快速过滤(如 |
Field | 普通列 | 存储实际数值(如 |
Bucket | Database | 数据存储桶(类似数据库) |
Timestamp | Primary Key | 每条数据的唯一时间标识 |
InfluxDB 的优势和应用场景
优势
- 高性能读写:InfluxDB 针对时间序列数据进行了优化,能够快速地写入和读取大量数据,适用于高频率、连续的数据流。
- 灵活的数据模型:使用 Tag-Key-Value 模型,便于对时间序列数据进行分类和聚合。
- 自动数据管理: 自动删除或降采样过期数据,降低存储成本,适用于数据量巨大且增长迅速的业务,可以节省存储空间。
- 丰富的查询功能:支持 InfluxQL 和 Flux 查询语言,适合复杂的时间序列数据查询和分析。
- 可扩展性:支持水平扩展,可以通过添加更多的节点来增加存储和查询能力。
- 无模式设计: 灵活调整标签和字段,无需预先定义严格的表结构,适应快速变化的数据格式。
- 生态完善:与 Grafana、Telegraf 等工具无缝集成。
应用场景
- 运维监控undefined用于监控服务器、网络设备和容器的运行状态,实时告警和性能分析。
- 物联网undefined存储传感器数据、设备状态数据,实现实时数据采集与预警。
- 实时数据分析undefined如金融数据、市场数据等需要按时间维度进行分析和预测的业务场景。
- 日志管理undefined对日志数据进行聚合、归档和实时搜索。
下载安装
可以使用 docker 镜像 来进行安装 influxDB
docker run \
    --name alex-influxdb \
    -p 8086:8086 \
    influxdb:2
当容器启动之后,可以在主机上通过浏览器访问 http://localhost:8086 来查看 influxDB 的管理界面。
第一次访问时,需要设置初始管理员账号和密码。
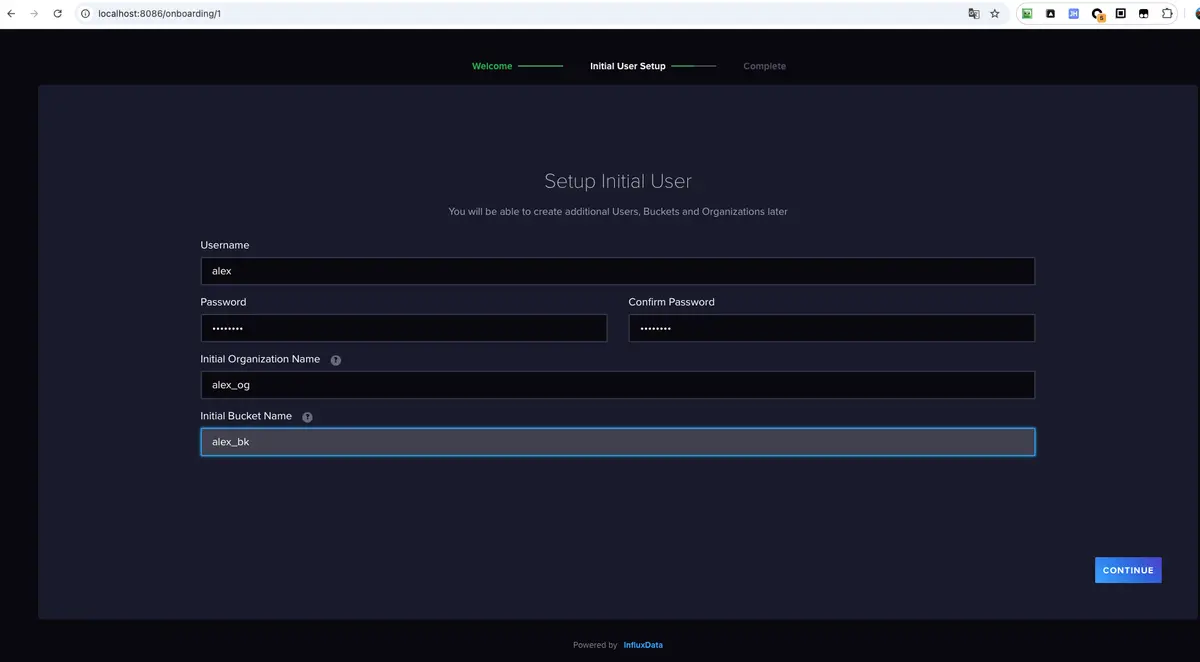
设置管理员账号和密码
然后提交成功之后,会提示你记住这个 token!一定要记住,且只会让你查看这一次,不然就找不到了。
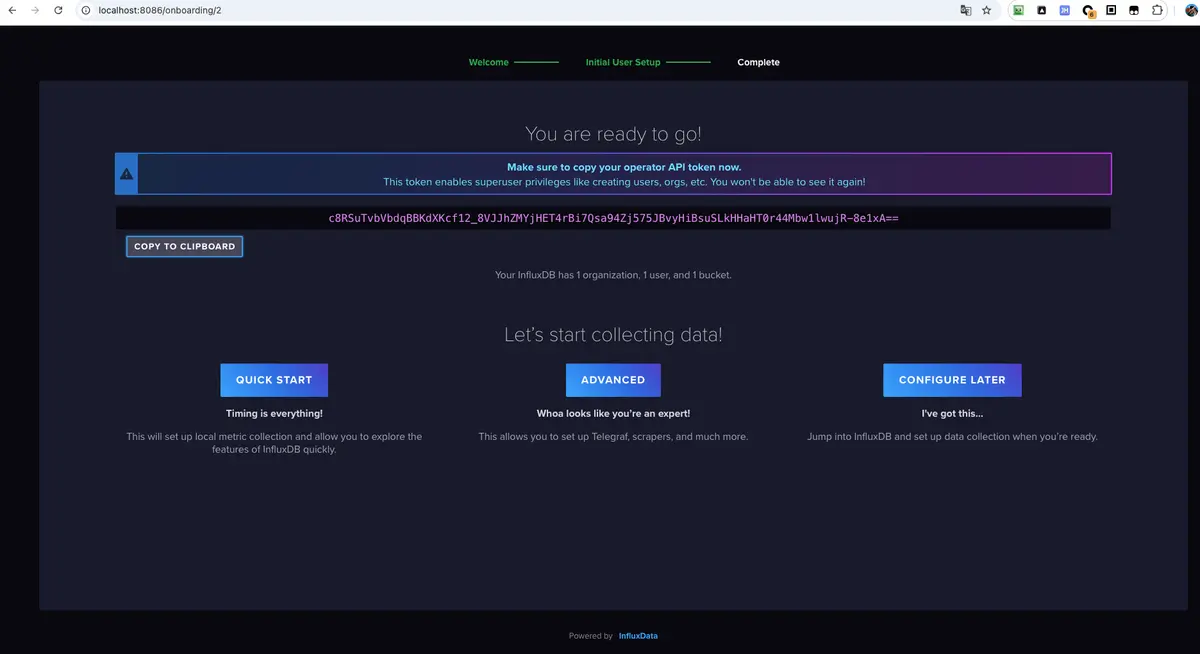
一定要记住这个 token
如果要想在容器启动时,就设置账号密码,则可以运行
# $PWD/data:要挂载在容器的 InfluxDB 数据目录路径下的主机目录
# $PWD/config:要挂载到容器的 InfluxDB 配置目录路径下的主机目录
# <USERNAME>:初始管理员用户的名称
# <PASSWORD>: 初始管理员用户的密码
# <ORG_NAME>:初始组织的名称
# <BUCKET_NAME>:初始存储桶(数据库)的名称
docker run -d -p 8086:8086 \
  -v "$PWD/data:/var/lib/influxdb2" \
  -v "$PWD/config:/etc/influxdb2" \
  -e DOCKER_INFLUXDB_INIT_MODE=setup \
  -e DOCKER_INFLUXDB_INIT_USERNAME=<USERNAME> \
  -e DOCKER_INFLUXDB_INIT_PASSWORD=<PASSWORD> \
  -e DOCKER_INFLUXDB_INIT_ORG=<ORG_NAME> \
  -e DOCKER_INFLUXDB_INIT_BUCKET=<BUCKET_NAME> \
  influxdb:2
代码实战
下面的代码示例演示了如何使用 InfluxDB Go 客户端连接、写入和查询数据。我们将逐步拆分代码并解释每个部分的作用。
先安装 Go 客户端
go get -v github.com/influxdata/influxdb-client-go/v2基本配置与连接
package main

import (
	"context"
	"crypto/rand"
	"fmt"
	"math/big"
	"strconv"
	"time"

	influxdb2 "github.com/influxdata/influxdb-client-go/v2"
)

// 配置信息
const (
	serverURL   = "http://127.0.0.1:8086" // InfluxDB 地址
	token       = "your_token"            // 认证令牌(需替换为实际值)
	org         = "your_org"              // 组织名称(需替换)
	bucket      = "your_bucket"           // 存储桶名称(需替换)
	measurement = "sensor_data"           // 表名(Measurement)
)
连接 InfluxDB
func connInflux() influxdb2.Client {
	// 1. 创建 InfluxDB 客户端
	client := influxdb2.NewClient(serverURL, token)

	return client
}解释:connInflux 函数用于创建与 InfluxDB 的连接。通过 influxdb2.NewClient 方法,使用服务器地址和认证令牌作为参数,建立客户端连接,以便后续进行数据的写入和查询操作。
随机数生成辅助函数
// GenerateRandomDigit 生成一个 1 到 9 之间的随机数字
func GenerateRandomDigit() int {
    num, err := rand.Int(rand.Reader, big.NewInt(9))
    if err != nil {
        return 1
    }
    return int(num.Int64()) + 1
}

// GenerateRandomNumber 生成指定长度的随机数字,并转换为整型
func GenerateRandomNumber(length int) (int, error) {
    const digits = "0123456789"
    result := make([]byte, length)
    for i := 0; i < length; i++ {
        num, err := rand.Int(rand.Reader, big.NewInt(int64(len(digits))))
        if err != nil {
            return 0, err
        }
        result[i] = digits[num.Int64()]
    }
    numInt, err := strconv.Atoi(string(result))
    if err != nil {
        return 0, err
    }
    return numInt, nil
}
讲解
GenerateRandomDigit用于生成 1 到 9 之间的随机数字,用于决定生成随机数的长度。GenerateRandomNumber接受一个长度参数,并生成相应长度的随机数字字符串,最终转换为整型返回。这两个函数主要用于模拟传感器数据,如温度和湿度。
写入数据点
// writePoints 将一条数据写入 InfluxDB
func writePoints(client influxdb2.Client) {
    // 获取写入 API,使用阻塞方式保证数据写入成功后再继续执行
    writeAPI := client.WriteAPIBlocking(org, bucket)

    // 随机生成 temperature 和 humidity 数据
    t1, err := GenerateRandomNumber(GenerateRandomDigit())
    if err != nil {
        panic(fmt.Sprintf("生成随机数 temperature 失败: %v", err))
    }
    t2, err := GenerateRandomNumber(GenerateRandomDigit())
    if err != nil {
        panic(fmt.Sprintf("生成随机数 humidity 失败: %v", err))
    }

    // ========== C (Create):写入数据 ==========
    // 创建一个数据点(Point)
    p := influxdb2.NewPoint(
        measurement,
        // Tags:用于快速过滤查询,类似于 MySQL 的索引字段
        map[string]string{"device_id": "d1", "location": "room1"},
        // Fields:存储实际数据值,这里 temperature 使用浮点数,humidity 使用整型
        map[string]interface{}{"temperature": float64(t1), "humidity": t2},
        // 当前时间作为时间戳
        time.Now(),
    )

    // 写入数据点到 InfluxDB
    if err := writeAPI.WritePoint(context.Background(), p); err != nil {
        panic(fmt.Sprintf("写入失败: %v", err))
    }
    fmt.Println("数据写入成功!")
}
讲解
- 首先通过
client.WriteAPIBlocking获取一个阻塞的写入 API;这种方式会等待数据写入完成后才返回,适合初学者调试使用。 - 调用前面生成随机数的辅助函数,模拟生成温度和湿度数据。
- 使用
influxdb2.NewPoint创建一个数据点,传入 Measurement 名称、Tags、Fields 以及时间戳。 - 最后调用
WritePoint方法写入数据,并通过错误判断确认写入成功。
查询数据
// fetchData 从 InfluxDB 查询数据
func fetchData(client influxdb2.Client) {
    queryAPI := client.QueryAPI(org)

    // ========== R (Read):查询数据 ==========
    // 构建 Flux 查询语句,查询最近 1 小时内,且 device_id 为 "d1" 的数据
    query := fmt.Sprintf(`from(bucket: "%s")
        |> range(start: -1h)
        |> filter(fn: (r) => r._measurement == "%s" and r.device_id == "d1")`, bucket, measurement)

    // 执行查询
    result, err := queryAPI.Query(context.Background(), query)
    if err != nil {
        panic(fmt.Sprintf("查询失败: %v", err))
    }

    // 遍历查询结果并打印每一条记录
    fmt.Println("\n查询结果:")
    for result.Next() {
        record := result.Record()
        fmt.Printf(
            "[ %s ] %s : %v\n",
            record.Time().Format(time.RFC3339), // 格式化时间
            record.Field(),                     // 字段名(例如 temperature)
            record.Value(),                     // 字段值
        )
        fmt.Println()
    }
    if result.Err() != nil {
        panic(fmt.Sprintf("结果解析错误: %v", result.Err()))
    }
}
讲解
- 通过
client.QueryAPI获取查询 API,并构造了一个 Flux 查询语句。Flux 是 InfluxDB 2.x 中推荐的查询语言,它与传统 SQL 不同,但仍然直观易懂。 - 查询语句从指定的 Bucket 中,选取最近 1 小时内数据,并通过
filter函数过滤出符合条件的数据(例如设备编号为 "d1" 的数据)。 - 使用
Query方法执行查询后,遍历结果集并打印每个记录的时间、字段名和字段值。
主函数
func main() {
	client := connInflux()
	defer client.Close() // 确保最后关闭客户端

	// 尝试每隔 500ms 写入一次数据,写 100 次
	// for i := 0; i < 100; i++ {
	// 	writePoints(client)
	// 	time.Sleep(500 * time.Millisecond)
	// }

	// 查询数据
	fetchData(client)
}解释:在 main 函数中,首先调用 connInflux 获取与 InfluxDB 的连接,并确保在程序结束时关闭连接。注释部分是一个循环,每隔 500 毫秒写入一次数据,共写入 100 次,用于模拟持续的数据采集过程。实际运行时,可以根据需要取消注释并调整参数。最后,调用 fetchData 函数查询并显示存储在 InfluxDB 中的数据。
可以直接通过 Web UI 上查看数据
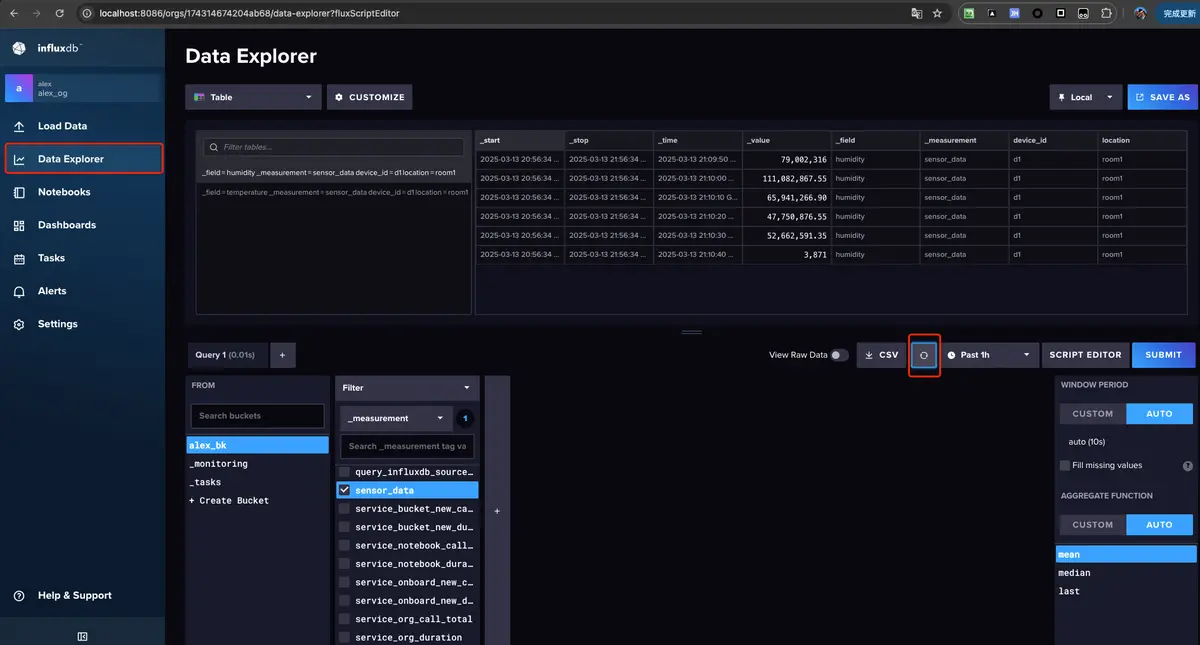
通过 Web 界面查看数据
总结
本文详细介绍了 InfluxDB 的基本概念、它解决的问题以及与传统关系型数据库 MySQL 的差异。InfluxDB 采用 Measurement、 Tags 和 Fields 的数据模型,使其在海量时序数据场景下具有极高的写入和查询性能。其自动数据保留策略和丰富的内建函数,更加适用于运维监控、物联网和实时数据分析等应用场景。
结合本文的 Go 语言代码示例,大家可以了解如何通过 InfluxDB 客户端进行数据写入与查询,助力快速上手时序数据库开发。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号