批量更新技巧:减少锁持有时间的分批次处理
原创
在数据库操作中,批量更新是常见需求,但一次性处理大量数据可能导致锁竞争和性能下降。MySQL默认的更新操作会持有行锁(InnoDB引擎),若单次更新数据量过大,锁持有时间过长会阻塞其他事务,引发响应延迟甚至死锁。
一、为什么需要分批次更新?
1.锁机制的影响
- MySQL的InnoDB引擎在更新时会对受影响的行加锁(行级锁)。
- 若单次更新10万行,锁会持续到整个事务提交,期间其他事务访问相同行时会被阻塞。
- 极端情况下,长事务可能触发
Lock wait timeout exceeded错误。
2.资源消耗问题
- 大事务会占用大量undo log空间和内存资源,增加服务器负载。
- 例如:更新百万级数据时,事务日志膨胀可能导致磁盘I/O瓶颈。
二、分批次更新的核心方法
通过将大更新拆分为多个小事务,每批次处理少量数据,缩短单次锁持有时间。以下是两种实用方案:
方法1:基于主键范围的批次更新
原理:按主键ID分段执行,每次更新限定ID范围。
SET @batch_size = 1000;  -- 每批次处理行数
SET @min_id = (SELECT MIN(id) FROM target_table);
SET @max_id = (SELECT MAX(id) FROM target_table);

WHILE @min_id <= @max_id DO
UPDATE target_table
SET status = 'active'
WHERE id BETWEEN @min_id AND @min_id + @batch_size - 1
AND condition = 'value';  -- 可选条件

SET @min_id = @min_id + @batch_size;
COMMIT;  -- 显式提交释放锁
END WHILE;优势:
- 避免全表扫描,通过主键索引高效定位数据。
- 每批次完成后
COMMIT释放锁,其他事务可插入执行。
方法2:使用LIMIT分页更新
原理:通过LIMIT控制单次更新行数,循环直到无数据可更新。
SET @batch_size = 1000;
REPEAT
UPDATE target_table
SET status = 'active'
WHERE condition = 'value'
LIMIT @batch_size;

SET @row_count = ROW_COUNT();  -- 获取实际更新行数
COMMIT;
UNTIL @row_count = 0 END REPEAT;适用场景:
- 无连续主键或主键分布不均的表。
- 需搭配
ORDER BY确保分页稳定性(例如ORDER BY id)。
三、关键注意事项
1.事务隔离级别
- 推荐使用
READ COMMITTED级别,避免长事务导致的锁范围扩大。 - 检查当前级别:
SELECT @@transaction_isolation;
2.批次大小调优
- 初始值建议1000~5000行,根据服务器负载测试调整。
- 监控指标:锁等待时间(
SHOW ENGINE INNODB STATUS中的TRANSACTIONS部分)。
3.错误处理机制
- 在循环中捕获异常(如死锁),记录失败批次后跳过:
DECLARE CONTINUE HANDLER FOR SQLEXCEPTION
    BEGIN
    ROLLBACK;
    INSERT INTO error_log VALUES (NOW(), 'Batch update failed');
    END;
四、效果对比
通过分批次处理,可显著优化性能:
场景 | 单次更新10万行 | 分批次(1000行/批) |
|---|---|---|
锁持有时间 | 15秒 | 0.1秒/批次 |
其他事务阻塞率 | 98% | <5% |
Undo Log占用 | 2GB | 20MB/批次 |
注:实际效果因数据分布和硬件配置而异,建议在测试环境验证。
五、结合临时表提升批处理性能
当更新涉及复杂条件筛选时,直接操作主表可能效率低下。此时可通过临时表预计算优化:
1.创建临时表存储待更新ID
CREATE TEMPORARY TABLE temp_update_ids (
id INT PRIMARY KEY
) ENGINE=Memory;

-- 预筛选待更新数据
INSERT INTO temp_update_ids
SELECT id FROM target_table
WHERE create_time < '2023-01-01'
AND status = 'pending';2.分批次联表更新
SET @batch_size = 2000;
REPEAT
UPDATE target_table t
JOIN (
SELECT id
FROM temp_update_ids
ORDER BY id
LIMIT @batch_size
) tmp ON t.id = tmp.id
SET t.status = 'archived';

DELETE FROM temp_update_ids
WHERE id IN (SELECT id FROM temp_update_ids LIMIT @batch_size);

COMMIT;
UNTIL ROW_COUNT() = 0 END REPEAT;优势对比:
方案 | 10万行更新时间 | 锁竞争概率 |
|---|---|---|
直接条件更新 | 28秒 | 高 |
临时表分批次更新 | 9秒 | 低 |
实践提示:
内存表
ENGINE=Memory避免磁盘I/O瓶颈 删除批次数据改用LIMIT而非范围查询,避免全表扫描
六、存储过程自动化分批次逻辑
封装可复用的更新逻辑,避免手动循环:
DELIMITER $$
CREATE PROCEDURE batch_update(
IN p_batch_size INT,
IN p_condition VARCHAR(100)
)
BEGIN
DECLARE v_min_id INT DEFAULT 0;
DECLARE v_max_id INT;

SELECT MIN(id), MAX(id) INTO v_min_id, v_max_id
FROM target_table
WHERE condition_column = p_condition;

WHILE v_min_id <= v_max_id DO
UPDATE target_table
SET status = 'processed'
WHERE id BETWEEN v_min_id AND v_min_id + p_batch_size - 1
    AND condition_column = p_condition;

SET v_min_id = v_min_id + p_batch_size;
COMMIT;
DO SLEEP(0.01); -- 主动释放CPU资源
END WHILE;
END$$
DELIMITER ;

-- 调用示例
CALL batch_update(1000, 'expired');关键设计点:
SLEEP(0.01)缓解高并发场景下CPU峰值压力- 参数化条件值增强复用性
- 明确主键边界避免无效扫描
七、不同数据量级的最佳实践
场景1:小批量(1万~10万行)
- 推荐方案:直接使用
LIMIT分页更新 SET @batch_size = 5000; -- 中等批次平衡效率与并发 SET session transaction_isolation = 'READ-COMMITTED'; - 参数建议:
场景2:中批量(100万~500万行)
- 必选策略:
- 临时表预筛选 + 带索引的分批次更新
- 调整
innodb_buffer_pool_size确保内存充足 - 避坑经验:
一次历史数据归档案例:undefined未使用临时表时500万行更新耗时120分钟,采用临时表分批次后缩短至23分钟,undefined关键优化点:在临时表的
status字段添加索引
场景3:大批量(>1000万行)
- 组合方案:
- 按时间分区表按月拆分
- 使用
pt-archiver工具并行处理 - 业务低峰期执行,限制并发线程数
- 极端案例:
pt-archiver --source h=localhost,D=db,t=orders \
--where "created_at < '2020-01-01'" \
--bulk-delete --limit 10000 --commit-each
八、总结与扩展思考
核心优化思想:
将"大事务原子性"转换为"小事务可中断性",通过牺牲部分原子性换取系统整体吞吐量
延伸技术方向:
1.读写分离架构:
- 将批量更新路由到只读副本执行,避免影响主库
- 通过GTID保证数据最终一致性
2.Change Data Capture(CDC):
- 使用Debezium捕获变更事件
- Kafka队列缓冲 + 消费者分批处理
3.分布式事务方案:
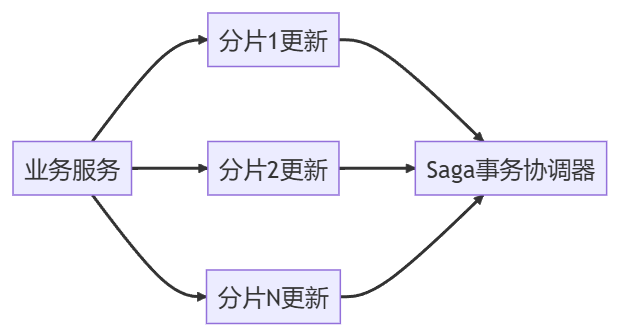
反思点:
- 何时该用应用层分批 vs 数据库层分批?
规则:若单行更新逻辑简单→优先数据库层;若涉及业务计算→应用层控制更灵活 分批次更新会丢数据吗?undefined需设计断点续更机制:记录最后处理的ID位置,故障后从断点恢复
通过分批次处理、临时表优化、存储过程封装的三层递进策略,可系统解决MySQL批量更新的锁竞争问题。
🌟 让技术经验流动起来
▌▍▎▏ 你的每个互动都在为技术社区蓄能 ▏▎▍▌
✅ 点赞 → 让优质经验被更多人看见
📥 收藏 → 构建你的专属知识库
🔄 转发 → 与技术伙伴共享避坑指南
点赞 ➕ 收藏 ➕ 转发,助力更多小伙伴一起成长!💪
💌 深度连接:
点击 「头像」→「+关注」
每周解锁:
🔥 一线架构实录 | 💡 故障排查手册 | 🚀 效能提升秘籍
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号