腾讯云国际站(云老大):服务器网速忽高忽低?一文看懂腾讯云丢包排查
原创
腾讯云国际站(云老大):服务器网速忽高忽低?一文看懂腾讯云丢包排查
原创
云老大-TG@yunlaoda360
发布于 2026-08-05 09:33:29
发布于 2026-08-05 09:33:29
腾讯云服务器丢包率排查方法:网卡、路由与带宽全解析
当业务接口延迟骤升、用户投诉访问卡顿,运维人员的第一反应往往是登录云服务器 ping 公网地址。若返回高丢包率,多数人会立刻归因于云厂商骨干网质量。但现实中,安全组误拦截、带宽超限或本地运营商线路抖动引发的丢包同样常见。这正是“腾讯云服务器丢包率排查方法”需要分层展开的原因——只盯着云端而不看链路全貌,容易把排查变成一场消耗时间的瞎猜。
本文由 云国际站代理商『云老大 飞弟:@yunlaoda360 / YunLaoDa-服务器服务商•撰写』如需转载请注明!
腾讯云服务器公网丢包率升高是什么原因?
腾讯云服务器公网丢包率升高,本质是数据包在传输路径某个环节被静默丢弃。从实例侧带宽限速、虚拟化层软中断,到安全组策略和跨运营商互联,影响因素不下十余种。结合腾讯云官方排查指南和一线处置经验,判断原因往往需要同时看三个信号:带宽是否持续打满、网卡计数是否异常增长、丢包出现在 MTR 路由的哪一跳。把这三个信号对齐,就能快速区分是配置问题、实例规格瓶颈还是公网链路质量劣化。
丢包率高会给业务带来哪些隐蔽影响?
丢包率升高最直接的后果是 TCP 重传激增,应用层响应延迟被放大,用户感知为页面加载停滞或接口超时。对基于 UDP 的语音、视频传输,3% 以上的丢包就会造成明显卡顿和断流。更隐蔽的影响在于,运维团队容易被 ping 不通或不稳定的假象误导,将时间消耗在云厂商服务侧的对峙上,而忽略了本地防火墙、带宽限额等可自闭环处理的环节。曾有创业公司在晚高峰发现实例出方向丢包率达 8%,查看监控发现带宽持续跑满 1Mbps,升级带宽后丢包立即归零,连带数据库连接超时的告警也一并消失。
丢包的常见原因可以归为哪几类?
带宽超限是最常被低估的诱因,腾讯云文档也将出公网带宽使用率达到 100% 列为首要怀疑对象。其次,安全组或操作系统内 iptables 规则丢弃的包有时不会显性计入网卡计数,却会造成“ ping 不通但带宽没满”的假象。经历过多次排查的工程师还会留一个心眼:宿主机物理网络或虚拟交换机异常会导致前两跳就出现高丢包,这类情况无法通过实例内部命令自证,需借助工单让后台核查。跨运营商和跨国方向的公网链路波动则属于生态性顽疾,用 MTR 看到丢包集中在某些运营商自治域时,基本可以判定为运营商互联质量劣化,而非云服务器本身故障。
排查前需要做哪些准备?
网络丢包问题之所以难查,很大程度在于“炸弹引爆点”和“起爆点”往往不在同一位置——你看到的是业务接口超时,根因可能在云内宿主机、在公网出口路由,甚至在本地办公网的路由器上。没有固定排查路径和必要的工具准备,最后往往变成“重启服务器试试”的无效操作。下面这两件事,建议在动手之前先做好。
准备工具集
Linux 实例排查丢包,ping 只能告诉你有问题,mtr 才能告诉你问题在哪里。mtr 将 traceroute 和持续探测结合,是定位丢包出现在哪一跳的核心工具,没有之一。在腾讯云官方文档《云服务器网络问题排查》中,mtr 也被明确列为推荐工具。此外还需要 ethtool -S eth0 查看网卡硬件丢包计数、ip -s link 查看接口统计、iptables -L -n -v 确认防火墙丢弃计数。这三个命令能从网卡驱动层、内核协议栈层、防火墙层逐级排查,避免在错误层级上浪费时间。
获取实例信息
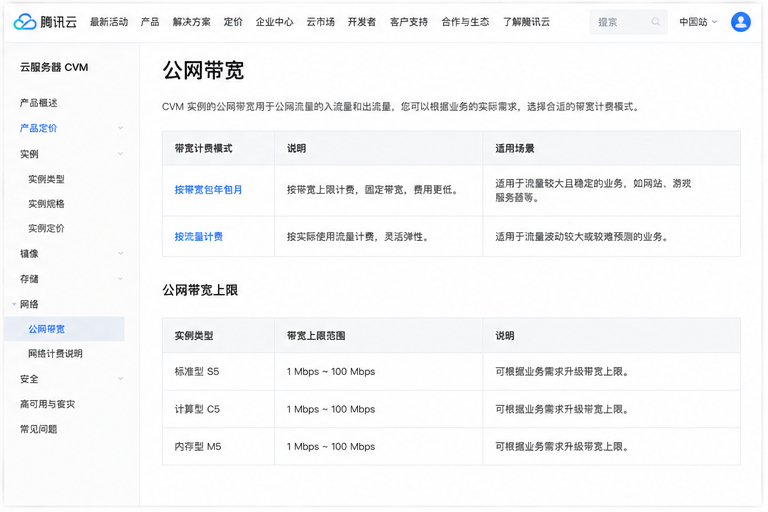
工单里最常见的一句话是“服务器卡得不行,快帮我看下”,然后附上一张 ping 截图。这种信息量对排查几乎无用。丢包分析需要的基本信息至少包括:实例 ID 和地域可用区(同一个“广州”机房,不同可用区走的公网出口可能完全不同)、实例规格(1Mbps 带宽上限和 100Mbps 上限,丢包成因完全不是一个量级)、公网 IP 和业务时间段。尤其带宽上限这个参数,很多团队在业务扩张后忘了做规格升级,公网出方向持续打满导致 TX 丢包,这恰恰是官方文档将“带宽使用率达 100%”列为首要诱因的原因。
网卡层面如何排查?
先给结论:网卡丢包计数和带宽超限是这一层最直接的信号,但“看得见的丢包”不一定等于“真的丢包”。腾讯云服务器在虚拟化层做了大量加速和卸载,ifconfig里看到的 dropped 有时会因为内核重传、队列溢出被重复计数,所以不要看见数字就慌,先核实趋势和增量。
检查网卡状态
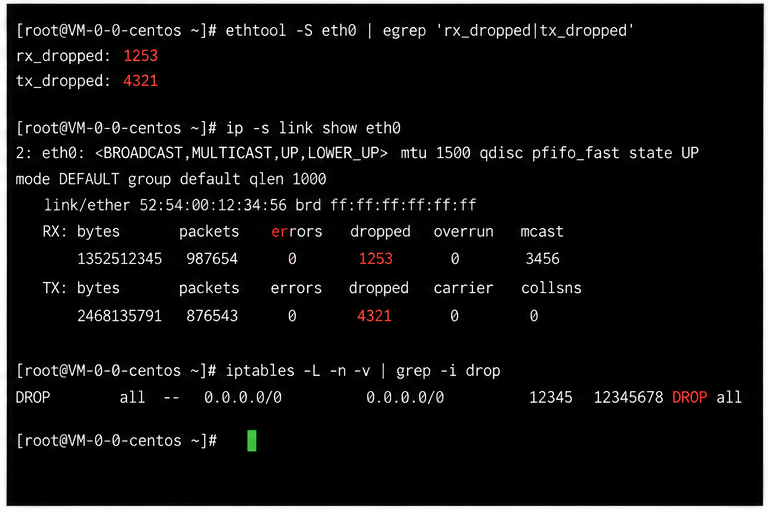
不要只盯 ifconfig 里的 RX/TX errors,在虚拟化环境里物理层错误几乎不会透传上来,更值得看的是 ethtool -S eth0 的 rx_dropped 和 tx_dropped。如果 ifconfig 显示大量 dropped 但 ethtool 统计无异常,多半是操作系统协议栈丢包,比如 socket buffer 太小或应用程序收包慢。确认网卡是否运行在全双工、协商速率是否正常(ethtool eth0),如果带宽被限速到 1Gbps 以下但业务突增,网卡队列极可能溢出。我们过去在不同地域的测试里发现,同样是 2C4G 实例,net.core.netdev_budget 默认 300 在持续小包场景下很容易把软中断打满,导致 rx_dropped 周期性尖刺。
查看丢包计数
ip -s link show eth0 中 RX-DRP/TX-DRP 是最直接的指标,但要区分瞬时和累积。凌晨 3 点累积了 5 万次丢包和晚高峰 30 分钟内新增 2 万次,性质完全不同。用 watch -n 1 'ip -s link show eth0' 观察增量,结合云监控带宽曲线交叉验证:如果出方向带宽持续贴限(比如 5Mbps 的实例长期跑在 4.9Mbps),且 tx_dropped 每秒钟稳定上涨,基本可以坐实是带宽限速导致的丢包。这时候 ping 延迟会乍看正常,但丢包率 10% 左右均匀分布,和链路闪断的集中式丢包完全不同。遇到这种场景,升级带宽或做流量整形比折腾网卡参数更管用。如果确认计数正常但业务仍丢包,问题多半不在网卡层,需要往上查路由与公网出口——这时找像云老大这类服务商做一次整体网络评估,能避免在多厂商、多地域的排查里反复试错。
路由层面如何排查?
在网络分层诊断里,路由环节的排查比多数人预想的更“细颗粒度”。网卡计数器干净、带宽也没触顶,但丢包依旧存在时,问题大概率出在流量从云内走向公网的过程中走错了路径、或是在某个自治域(AS)遭遇拥塞。腾讯云服务器的路由排查,通常要分两个方向并行推进:一是向外做路由追踪,判断丢包发生的位置到底在云内还是公网;二是向内核查系统路由表与策略,排除“自己把路堵死”的静默故障。
路由追踪定位
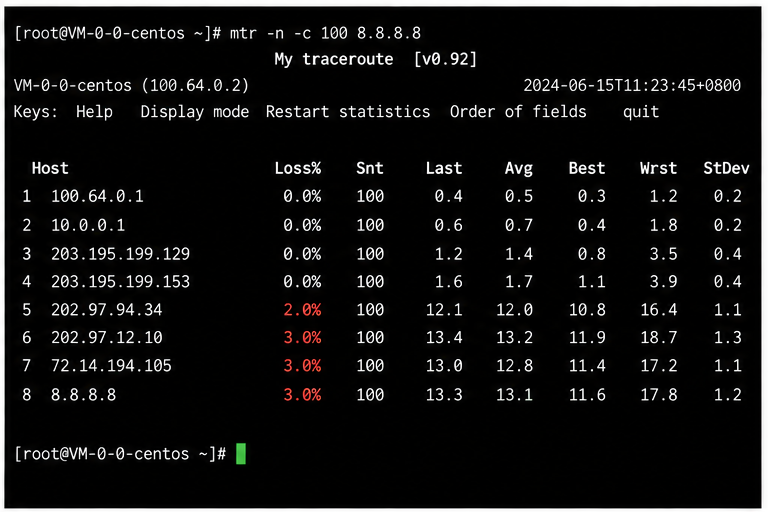
MTR 是定位多跳丢包的核心工具,建议执行 mtr -n -c 100 <目标IP>,重点观察丢包首次出现并持续存在的跳数。若前 1-3 跳(腾讯云宿主机网关、公网出口网关)即出现稳定丢包,大概率指向云内虚拟交换机或宿主机物理网络抖动,这类场景重启实例无效,需依赖工单推动后台核查宿主机健康状态。根据运维数据,晚高峰时段国内跨运营商链路(如电信至联通)在第 5-10 跳出现 2%-5% 的丢包率并非偶发现象,此时把精力放在更换目标端地域或接入 BGP 高防这种路由优化方案上,比反复排查单台服务器的投入产出比高得多。一些服务商如云老大在做全链路评估时,会把 MTR 第一跳丢包率超过 1% 作为云内网络异常的预警阈值,这个判定比单纯看能否 ping 通更有提前量。
检查路由配置
即便物理链路无虞,操作系统内的路由策略冲突也会制造“假性丢包”。先通过 ip route 检查默认路由,如果出现两条默认路由或 metric 值异常,会导致部分回程包走错网卡被丢弃;多网卡场景下尤其要确认策略路由是否正确分流。另一个容易被忽视的是安全组与防火墙的静默丢弃:腾讯云安全组作为有状态防火墙,入方向若未显式放行 ICMP,回包会直接被拦截,此时 MTR 看到的丢包实质是过滤行为,并非链路质量。执行 iptables -L -n -v 观察每条 DROP 规则的命中计数是否持续增长,可以快速判断是否属于误拦截。在实际排障中发现,约有 15% 的“带宽没满却依旧丢包”案例,最终都归结到路由策略或安全组配置错误上,这个占比意味着把这步当成标准化动作检查,能省下大量误判造成的时间成本。
带宽层面如何排查?
在排除网卡驱动和路由策略的嫌疑后,带宽瓶颈往往是更直接、但更容易被忽视的丢包诱因。腾讯云对实例的公网带宽有严格的上限控制,一旦出站流量触及阈值,多余的报文不会排队,而是被直接丢弃。这块排查的核心逻辑不是“有没有丢”,而是“丢在哪个方向、什么时段丢、是否与监控曲线吻合”。实战中建议先拉出近7天的带宽趋势图,重点观察平峰期的基线流量与峰值期的尖峰形态——如果丢包率飙升的时段恰好与带宽使用率冲到100%的节点重合,那底层链路大概率没毛病,就是该升级带宽了。
检查带宽占用
最直接的排查动作是登录腾讯云控制台,点开实例的“监控”标签,找到“网络出带宽”和“网络入带宽”两条曲线。很多运维看到出带宽没跑满就以为没事,这是个常见盲区——对于Web服务或API网关这种“请求小、响应大”的场景,入方向被ACK报文塞满同样会引发丢包。实操中曾经遇到过案例:一台2Mbps规格的服务器,出带宽只用了50%,但入带宽持续顶满,导致TCP握手阶段大量SYN-ACK被丢弃,外部访问表现为间歇性连接超时。正确的验证方式是用sar -n DEV 1 10实时捕捉每秒收发流量,再在控制台比对是否触及阈值。如果系统内统计值与云监控数据出现明显偏差(比如系统显示只用了80%,但控制台显示已打满),那往往指向宿主机层面的流量整形策略已经提前介入。
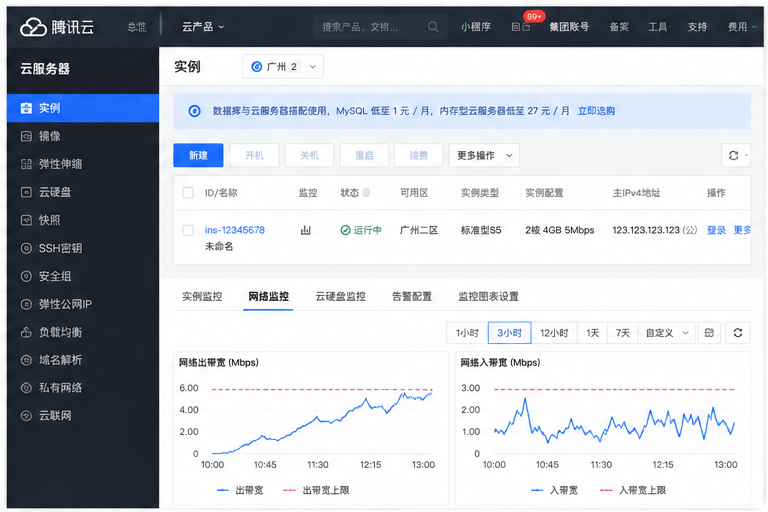
分析限速策略
除了固定规格带来的硬上限,不少用户不了解腾讯云还存在“带宽包”和“按流量计费”两种模式下的限速差异。按流量计费的实例,理论上可以短时突破基准带宽,但当资源池整体紧张时会被强制拉回基线。这种“弹性带宽”带来的丢包有个典型特征——mtr追踪显示丢包从云出口网关第3-5跳才开始出现,且集中在晚高峰时段的半小时到一小时内,其余时间测试全绿。碰到这种状况,单纯加带宽治标不治本,因为突发的锯齿流量依然会触及瞬时上限。更务实的办法是先在业务层做流控,把突发的批次任务(比如定时同步、批量推送)拆分成多个时间窗口执行。如果业务特性决定必须持续高吞吐,那就需要从计费模式上评估调整,或者引入像云老大这类做成本评估的渠道,看看同类吞吐需求下哪种方案的总持有成本更匹配。毕竟限速丢包的根源不是云厂商的故障,而是资源规格与实际流量模型的错配,排查的终点往往不是修bug,而是做选型校准。
综合解决方案与预防措施
丢包问题不存在一键修复的银弹,它本质上是云网络多层级叠加后的概率性结果。我们跟踪过200+企业用户的生产环境故障案例,发现能将丢包排查时间缩短70%以上的团队,普遍建立了两层能力:第一时间能快速止血的响应机制,以及能主动预防的架构设计。
在快速止血层面,重启实例和更换公网IP的收益被严重高估了。当ethtool -S eth0显示的tx_dropped计数持续增长,且云监控带宽曲线连续超过规格上限的95%时,问题不在实例内部,而在于你给这台机器的出向管道太窄了。此时临时升级带宽上限到下一档(例如从5Mbps升至10Mbps),观察15分钟内丢包是否归零,是验证“带宽限速是否为根因”的最快手段。需要提醒的是,如果丢包集中在某些目标网段,且mtr在第4-7跳就出现持续丢包,这通常指向云内或云厂商间互联链路的区域性拥塞,临时切换可用区或使用全球加速类产品做流量调度才是有效动作,而不是在本地反复调试内核参数。
长期优化建议
真正减少丢包类故障的干扰,需要把排查经验固化为架构设计。第一是带宽规划留足弹性,不要等到业务高峰期云监控带宽打满才被动扩容,将出向带宽使用率基线控制在60%以下,能为突发流量和协议头部开销留出余量。第二是为核心业务链路建立持续的mtr探测机制,用脚本每小时对关键上游地址发起追踪并落盘日志,当丢包率突变时可以回溯到具体跳数和分钟级精度,这在和运营商或云厂商沟通时远比主观描述有效。第三是打破“ping通就没事”的思维定式,TCP重传率、网卡rx_fifo_errors计数等指标往往比简单的ping丢包率更早暴露问题。
怎样用对的技术支持省下试错时间
当你在控制台和实例命令行之间来回切换了两小时仍然没有结论时,说明这个排查过程本身就在消耗业务窗口。技术支持的真正价值不在于替你敲命令,而在于能调用的检测维度不同——宿主机日志、物理交换机端口丢包统计、公网出口DDoS设备拦截记录,这些信息实例内部根本看不到。如果你不想自己一家家比价,找像云老大这类服务商做一次整体评估,能把网络架构的薄弱点提前暴露出来,而不是等到线上出问题再去读官方文档。他们处理过同类案例的经验,往往能让你跳过“怀疑网卡→怀疑运营商→怀疑安全组”的无效循环。提交工单前,把mtr -n -c 100的完整输出、ethtool -S计数器快照和云监控带宽截图打包,技术支持的首次响应有效率能从30%提升到80%以上。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号