反射内存网络中断机制全解析:从硬件触发到事件驱动
原创

反射内存网络中断机制全解析:从硬件触发到事件驱动
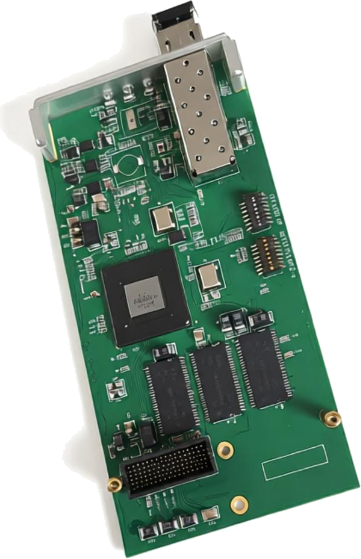
一、中断:让"被动等数据"变成"主动收通知"
反射内存的共享内存模型有一个天然诱惑:既然是共享内存,接收方"轮询"读取不就行了?确实,很多入门应用就是靠轮询跑起来的。但轮询有两个硬伤:一是 CPU 空耗——不管有没有新数据,都要一遍遍去读内存;二是响应延迟不确定——轮询间隔决定了数据被"发现"的滞后,而这个间隔又受 CPU 负载影响。反射内存网络中断机制,正是为了解决这两个问题而设计的:让板卡在特定内存地址被写入时,主动给主机 CPU 发送物理中断,从而把"轮询等数据"升级为"事件驱动收通知"。
二、网络中断的两种模式
反射内存的中断机制分为点到点中断与广播中断两种模式。
点到点中断:发送节点向指定目标节点发送中断。中断包中携带目标节点 ID,只有该目标节点的板卡会检测到并触发主机中断。这种模式适合"节点 A 通知节点 B"的场景,例如从机通知主机任务完成、或主控通知某个特定从机执行动作。
广播中断:发送节点向所有节点发送中断。典型做法是向中断寄存器写入一个广播值(如目标节点 ID 设为 0xFF),中断包在环网中传播,所有节点的板卡收到后都向各自 CPU 触发中断。这种模式适合"全网同步"场景,例如同时触发所有节点的数据采集、或通知所有节点"开始下一帧计算"。
三、中断包的组成与传递路径
一个反射内存中断包通常包含以下信息:发送者节点 ID、目标节点 ID、中断类型信息以及32 位用户自定义数据。
当发送节点写入中断寄存器时,板卡将上述信息封装成中断包,投入光纤网络。接收节点的板卡收到中断包后,将相关信息存储到对应的接收 FIFO 中,同时向主机 CPU 触发一个硬件中断(如 PCIe 的 INTA# 中断或 VMEbus 中断)。主机的中断服务程序(ISR)从 FIFO 读取中断信息,解析发送者、类型与用户数据,然后执行相应处理。
值得注意的是,反射内存通常支持多级可编程中断(如 5565 提供四级中断,每级用户可自定义优先级、中断向量与功能)。这为区分不同事件类型提供了硬件基础:例如中断 1 表示"新控制指令到达",中断 2 表示"数据采集完成",中断 3 表示"节点故障告警"。
四、中断电路的层次结构
以 5565 系列为例,其中断电路采用分层设计。第一层(primary tier)由一组中断源组成,通过本地中断使能寄存器和状态寄存器分别使能与监控;上层再对多个中断源进行汇总,最终输出到单一的中断引脚(如 INTA#)。
这种分层设计的价值在于:开发者可以单独控制每一个中断源(网络中断、DMA 完成中断、链路状态变化等),也可以统一屏蔽或使能。当需要调试时,通过状态寄存器可以精确看出是哪个事件触发了中断,极大地方便了问题定位。
五、中断编程实战要点
(一)初始化顺序。正确的中断编程流程是:先打开设备、映射内存,再配置中断掩码(选择哪些事件触发中断)、注册中断回调函数(ISR),最后使能中断。顺序颠倒(如先使能再注册回调)可能导致中断到来时没有处理函数,引发系统异常。
(二)ISR 务必精简。中断回调在硬件中断上下文执行,必须极其简短:只做"读数据、置标志、唤醒任务"这类原子操作,把耗时工作(如日志记录、磁盘写入、复杂计算)放到中断下半部(Linux 的 workqueue/tasklet、Windows 的 DPC)或独立线程。在 ISR 中做耗时操作,轻则拉高中断延迟,重则导致系统卡死。
(三)中断合并阈值。高频写入可能造成"中断风暴"——每个小写都触发一次中断,反而拖垮系统。多数驱动支持设置中断合并(聚合)阈值,例如连续 N 次写触发一次中断,或设置时间窗口合并多个中断。合理设置阈值可在"响应及时"与"中断开销"之间取得平衡。有实践案例指出,未设置合并阈值是中断丢失或性能下降的常见原因。
(四)中断与 DMA 配合。高性能场景的经典组合是"中断 + DMA":发送方用 DMA 批量搬数据,写完触发中断通知接收方;接收方在中断中启动 DMA 读取,实现零轮询、低 CPU 占用的大数据交互。有工程实测显示,通过这种组合能把反射内存卡的带宽推到接近光纤物理极限,而 CPU 占用率极低。
(五)注意系统中断资源。在 BIOS 中为板卡预留 Legacy 中断(如 IRQ11)或固定 PCIe 中断资源,可避免与其他设备的中断冲突,提升中断响应稳定性。
六、中断 vs 轮询:如何选择
中断并非永远优于轮询。选择依据主要是数据更新频率与应用实时性:
• 数据更新频繁且规律(如周期性遥测):轮询可能更简单,甚至可以结合 DMA 批量读取,避免中断风暴。
• 数据更新稀疏但重要(如指令、告警):中断明显更优,能即时响应且不空耗 CPU。
• 混合模式:高频数据用轮询/批量,关键事件用中断,是工程上最常见且稳妥的组合。
判断标准很简单:如果 99% 的轮询周期都"没有新数据",就应该改用中断;如果几乎每周期都有新数据,轮询未必差。
七、常见中断问题排查
中断不触发:检查中断掩码是否使能、回调是否注册、目标节点 ID 是否配置正确(点到点模式下目标错了自然不会触发)。用状态寄存器确认板卡是否确实收到了中断包。
中断丢失:多因中断合并阈值设置不当或 ISR 处理不及时导致 FIFO 溢出。可调大合并窗口、缩短 ISR 执行时间,或提高中断优先级。
中断风暴导致 CPU 飙升:高频写入未合并。设置合理的合并阈值或改为批量写入。
中断与其他设备冲突:BIOS 中固定中断资源,或更换 PCIe 插槽。
八、从机制到架构
深入理解中断机制后,可以上升一层看架构:反射内存的"共享内存 + 中断"组合,本质上构建了一套"数据面 + 控制面"分离的通信模型——数据通过共享内存批量流动,控制通过中断即时通知。这与分布式系统经典的"数据通路与控制通路分离"思想不谋而合。设计良好的反射内存应用,往往把高频大批量数据走共享内存、低频关键事件走中断,两者各司其职,共同支撑起一个既高效又及时响应的实时通信系统。
九、结语
反射内存网络中断机制,是"事件驱动实时通信"在硬件层面的典型实现。它把 CPU 从无效轮询中解放出来,让系统能够即时响应关键事件,并通过多级可编程中断、点到点/广播两种模式、中断合并等特性,为复杂实时系统提供了灵活而可靠的同步与通知手段。对开发者而言,掌握中断机制的原理与编程要点,是让反射内存应用从"能跑"走向"高性能、高可靠"的关键一步。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号