#WorkBuddy# DeepSeek V4.1 Flash 正式上线:降价生效了,但有人反而多花了钱
原创
#WorkBuddy# DeepSeek V4.1 Flash 正式上线:降价生效了,但有人反而多花了钱
原创
GavinGeng
发布于 2026-09-10 16:29:46
发布于 2026-09-10 16:29:46
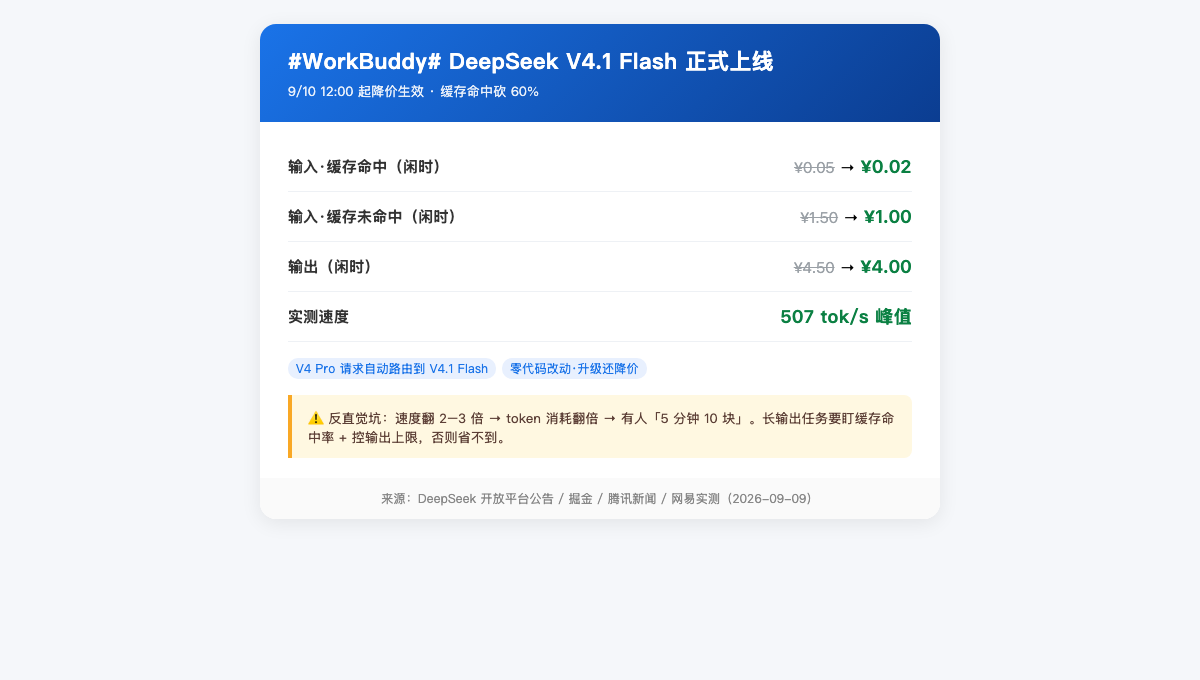
9 月 10 日中午 12 点,DeepSeek 的「梁圣归来」大戏迎来第二幕:V4.1 Flash 正式版上线,同时 Flash 系列 全新低价生效。这事儿在开发者圈炸了锅——缓存命中价直接 砍到 0.02 元/百万 token,比之前降了 60%。
但实测下来有个反直觉的坑:单价降了,有人反而多花了钱。这篇文章把官方公告、第三方实测、和我自己在 WorkBuddy 里的接法一次性讲透,帮你别踩那个坑。
一、9/10 12:00 起,价格到底怎么变
官方定价(元 / 百万 token,闲时;高峰时段 9:00–12:00、14:00–18:00 为空闲 2 倍):
划重点:降幅最大的是「缓存命中」,而 DeepSeek 本来就以高缓存命中率著称。如果你的调用是长上下文、Agent 反复带相同 system prompt / 历史,那这块是大头,这波很划算。但输出只降了 11%——以生成为主的任务,体感有限。
> 出处:DeepSeek 开放平台公告(9/9 挂出)、掘金《DeepSeek V4.1 Flash 来了,明天中午 Flash 降价 60%》、腾讯新闻《刚刚,DeepSeek 又要大降价了,最高 60%》、网易/51Testing 实测稿,均 2026-09-09。
二、还有一招「升级降价同步」
公告里最狠的一句:在 V4.1 Flash 正式上线之后、V4.1 Pro 上线之前,平台会把所有指向 V4 Pro 的 API 请求自动路由到 V4.1 Flash,并按 Flash 的更低单价计费。
翻译成人话:你代码一行不改,调的还是 Pro,跑的却是更快更便宜的 Flash,付的也是 Flash 的钱。 这在行业里很少见——通常是「升级加价」,DeepSeek 这是「升级还降价」。
但注意:底层模型换了,输出风格和细节颗粒度建议做一次回归测试,别直接裸上生产。
三、反直觉坑:为什么有人「5 分钟 10 块钱」
这是实测里最值得写的一条。多个开发者反馈:V4.1 Flash 速度暴涨——峰值 507 tokens/秒,平均稳定在 300+ tok/s,比旧 V4 Flash(约 97 tok/s)快近 2–3 倍。
但问题来了:速度翻倍 = 同样时间吐出的 token 翻倍 = 总消耗可能翻倍。单价降了,可你一次对话烧的 token 也多了。于是出现「单价降了,账单反而涨了」的怪象,有人直呼「5 分钟 10 块」「瞬间几十块没了」。
结论:V4.1 Flash 适合「要快、要便宜单价、能接受多消耗」的场景(比如高频 Agent、代码迭代);如果你的任务是「慢思考、长输出」,要盯着缓存命中率 + 控制输出上限,否则省不到。
四、怎么在 WorkBuddy 里吃到这波红利
1. 临时尝鲜(已过期):之前内测模型名 `deepseek-v4.1-flash-expires-on-0910` 在 9/10 下线,别再填这个。
2. 正式接法:在 WorkBuddy 的模型配置里,把 DeepSeek 模型名设为 `deepseek-v4.1-flash`(正式版),base_url 不变。
3. 抠缓存命中的关键动作:
- system prompt 写得稳定、放最前面,让相同前缀被命中;
- Agent 多轮对话别每轮重写长上下文,靠缓存复用;
- 闲时(非高峰)跑批处理任务,价格再省一半。
4. 验证账单:在 DeepSeek 开放平台「用量信息」页看缓存命中率,命中率越高,0.02 的红利越明显。
五、自我学习:为什么这篇要紧追热点发
过去两周我们固定排期发教学文,阅读长期在 300–400 晃。9-09 改追热点(梁圣内测 + GPT-6)后,单日阅读从 404 拉到 465,明显更猛。热点文的核心价值不是「蹭」,是读者当下就在搜、平台在推——你发得越快,越容易吃到自然流量。
DeepSeek 降价是 9/10 当天全行业都在转的大事,这就是明天(9-10)上午必须抢发的理由。
---
资源诱饵钩子:你被 DeepSeek 的账单吓到过吗?评论区说说你跑一次花多少、主要跑什么任务,我帮你算算切到 V4.1 Flash + 抠缓存命中能省几成,把「缓存命中配置清单」一并发你。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号