Rubix 基础层:从云端到战车,同一套底座怎么跑
原创
Rubix 基础层:从云端到战车,同一套底座怎么跑
原创
老周聊架构
发布于 2026-09-11 21:13:53
发布于 2026-09-11 21:13:53
聊 Palantir 的架构,前面几篇我们把 Foundry、Ontology、AIP 都过了一遍。这些东西看起来各自独立,但有个问题我一直没正面回答:它们到底跑在哪?
一个客户在 AWS 上跑着 Foundry,另一头部队的单兵终端里跑着 AIP,还有一批政府系统彻底断网、物理隔离在机房里。这三处的网络条件、硬件、合规要求天差地别,但 Palantir 的说法是同一套软件栈都能上。这不可能是巧合,背后一定有一层被有意藏在产品光环下面的东西在兜底。
这一层就是 Rubix。它不出现在任何产品的对外宣传里,不卖单独的 license,但你用的每一个 Palantir 产品都坐在它上面。我的看法是,理解 Rubix 才算真正理解 Palantir 为什么能进国防部、能上战车、能进银行核心机房,理解不了这层,前面几篇讲的东西你都只在云上 demo 里成立。
第一层:Rubix 到底是个什么
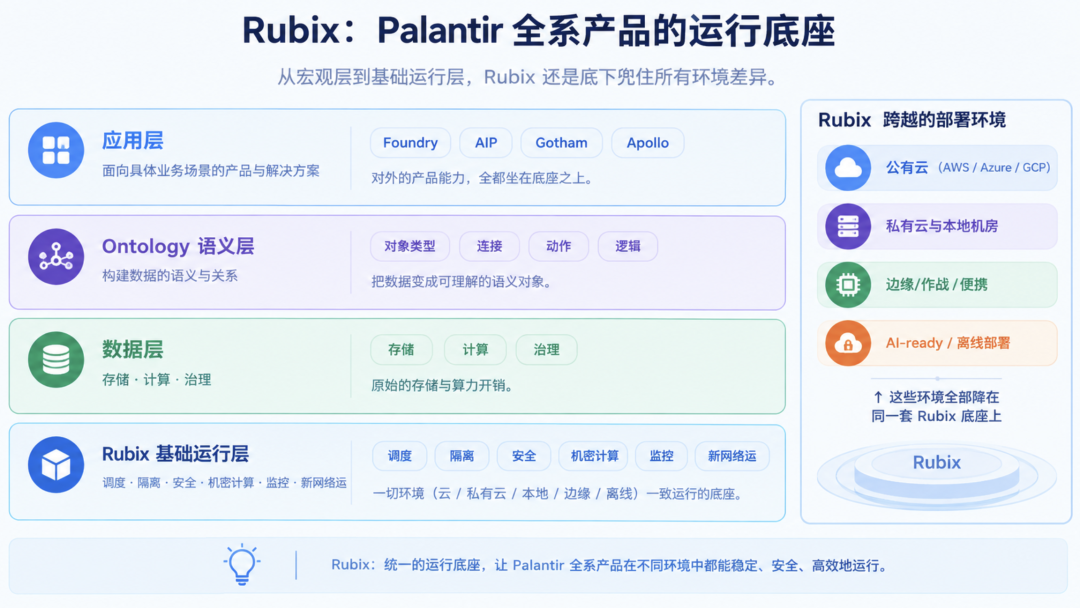
用一句话说,Rubix 是 Palantir 全系产品的运行底座。Foundry、AIP、Gotham,以及管它们的 Apollo,全都是部署在 Rubix 之上的一组工作负载,而不是自己各自带一套操作系统和集群管理能力。
这里有个容易绕进去的弯。我们习惯把"基础设施底座"想成 Kubernetes 或者某个云厂商的托管服务。Rubix 确实构建在 Kubernetes 之上,但它干的事比 K8s 多一层:K8s 解决的是"在一堆机器上把容器调度起来",Rubix 解决的是"在任何一堆机器上,用同一套语义把 Palantir 的软件一致地调度、隔离、监控、保护起来"。机器可以是 AWS 的 EC2,可以是某涉密机房的裸金属,可以是装在一辆战术车辆里的加固服务器,也可以是一台断网的笔记本。机器差异被 Rubix 吞掉,上层的产品感知不到。
所以 Palantir 的架构分层从下往上是这样的:最底下是 Rubix 这一层运行与管理底座;往上是数据存储与计算平面;再往上是 Ontology 语义层;最上面才是 Foundry、AIP 这些对外的应用。Rubix 是所有东西的根,它不出镜,但它一旦出问题,上面几层全部失灵。
为什么说它"不出镜"很关键?因为客户买的是 AIP 的能力,不是 Rubix 的能力。Rubix 是 Palantir 作为一个公司能持续把自己的软件塞进各种极端环境的根本竞争力,但它本身不是一个能单独讲出故事的产品。它是那种"你感觉不到它,但它一直在"的底层。
第二层:为什么非要一套底座跑遍所有环境
如果你只服务云端客户,这事根本不需要。在 AWS 上,你有一整套托管的网络、身份、密钥、监控,直接用能跑就行。Palantir 的麻烦在于它的客户里有一大批根本不在云上,或者只在"部分时间"在云上。
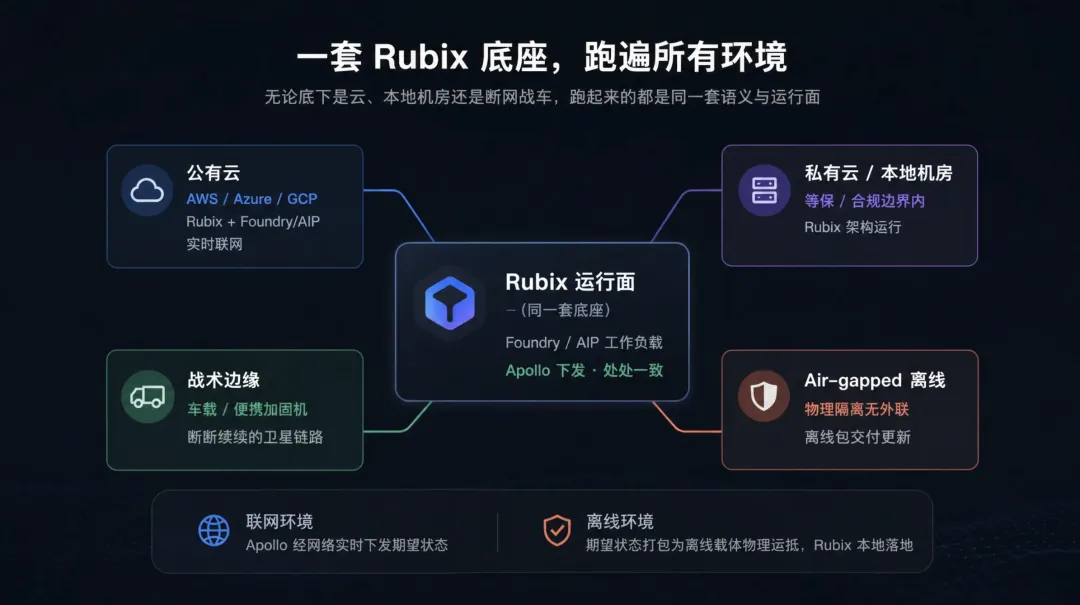
把这个光谱拉直了看,一端是完全连接的商用公有云,中间是私有云、本地数据中心,再过去是战术边缘,最远端是彻底物理隔离、连一根网线都没有的 air-gapped 环境。每一段对基础设施的要求是互相冲突的:
连接性上,云上随时能拉取镜像、回传遥测;边缘经常是断断续续的卫星链路;air-gapped 一字网络不通。算力上,云上可以堆上千核;战车上的加固机可能只有几十核还要留出冗余跑火控。合规上,银行要你证明数据不出特定可用区;情报系统要你证明连 Rubix 自身的管理通道都不会把数据带出去。
传统做法是什么?针对每种环境重新搞一套部署方案。云上用这套 CI/CD,本地用另一套脚本,边缘再雇人手工装。结果就是同一份产品代码,到了不同环境行为不一致,bug 在各处表现不同,安全审计每次都要重做一遍。这种"环境分裂"在普通 SaaS 公司只是交付成本问题,在国防和金融监管场景下是致命的,因为断网那端的系统一旦行为异常,你可能连日志都拿不回来。
Rubix 的答案很朴素:把环境的差异收敛到一个抽象里。无论底下是云还是战车,Rubix 暴露给上层的是同一组原语,声明式地描述"我要跑什么、要多少资源、要怎么隔离",Rubix 负责在这个具体环境里把它变成现实。上层产品写一次,处处成立。
第三层:Rubix 的核心机制是声明式控制面加运行面
具体怎么做到"写一次处处成立"?核心是一套声明式的期望状态(desired state)机制。你不是去某个边缘节点上敲命令装软件,而是向 Rubix 提交一份声明:这套 Foundry 的某个版本、配上某份 Ontology 配置、跑在这些节点上、彼此之间这样隔离。Rubix 自己会去比对当前实际状态和你要的状态,把差异 reconciled 掉。
这听起来和 K8s 的声明式 API 很像,本质上也确实同源,但 Rubix 把这套语义抬到了"产品部署"的粒度,而不是"单个容器"的粒度。对 Rubix 来说,一个可声明的最小单元是一整个 Palantir 产品栈的正确运行形态,包括它的多个微服务、它们之间的拓扑、依赖的配置版本、以及安全约束。它做的是产品级的状态协调,不是单纯的容器编排。
这里还有一层很多人没意识到的设计:Rubix 把节点自身的底座也当成不可变(immutable)的版本化产物来管理。节点的基础操作系统不是一个随时能 apt upgrade 的活系统,而是一份经过签名、带版本号的镜像。要升级,不是在原地打补丁,而是把整张基础镜像换掉、重启到新版本。这个看似偏执的做法,直接决定了它敢不敢进 air-gapped 机房:你离线运进去的是一整张完整、可校验的镜像,而不是一个"跑到一半可能失败的增量脚本"。节点永远不可能停留在"补了一半、状态不一致"的中间态。配合前面说的期望状态机制,Rubix 还会持续比对本节点实际跑的东西和声明是否一致,一旦发现漂移(drift),就按策略要么自动拉回声明状态,要么标记并阻断,不让一台悄悄变样的节点继续混在集群里。
控制面和环境无关是另一件关键的事。在云上,控制面通过 API 实时下发指令;在断网环境,同一份"期望状态"被打包成离线载体,通过物理介质运过去,Rubix 在本地照着同一套语义把状态追平。底下承载的通道千差万别,但声明本身是同一份、同构的。这就是"一套底座"的技术本质:不是代码一样,而是语义一致、协调逻辑一致。
还要提一句可观测性。Rubix 对每个节点、每个工作负载都有统一的遥测与自愈逻辑。节点挂了它重新调度,工作负载不健康它拉起重启,安全策略被绕过它告警并阻断。这些能力在云上靠的是丰富的中间件,在边缘靠的是 Rubix 自己内建的轻量实现。它保证不管环境多瘦,基本的"活着、可控、能告警"这条底线都在。
第四层:安全隔离与机密计算,零信任不是挂在嘴上
到了国防和情报场景,安全不是附加项,是准入门槛。Rubix 在这块做的几件事值得单独拎出来说,因为它直接决定了"这玩意能不能进涉密机房"。
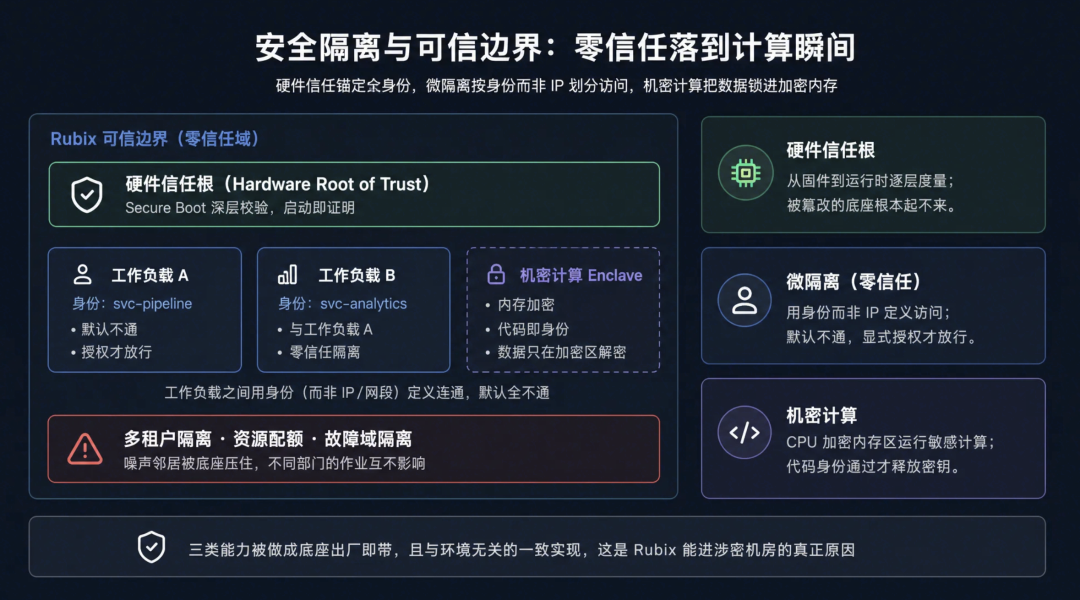
最底层是硬件信任根(hardware root of trust)。Rubix 在启动阶段就做可信启动和硬件证明(attestation),从固件到内核到运行时一层层校验,确保跑起来的不是被篡改过的底座。这一关过了,后面的隔离才有意义,否则你在一个已经被种了东西的机器上做再多逻辑隔离都是空中楼阁。
在这之上做的是微隔离(microsegmentation)和软件定义边界。传统做法是靠网络层画 VLAN、配防火墙,但 Rubix 把隔离下沉到了工作负载之间,用身份而不是 IP 来定义谁能访问谁。一个跑机密分析的任务和跑普通 ETL 的任务,即便在同一台物理机上,彼此之间也是零信任的,默认不通,需要显式的、带身份凭证的授权才放行。这在多租户、多密级的场景下是刚需,一台机器上同时跑不同密级的工作负载而不串味,靠的就是这一层。
多租户隔离还有个常被忽视的层次:资源与故障域。Rubix 不仅要保证 A 租户看不到 B 租户的数据,还要保证 A 租户的一颗疯掉的进程不会把整台机器的 CPU 或内存吃光、拖垮 B 租户。它通过 cgroup 级别的资源配额、独立的加密卷、以及把关键租户的工作负载排布到隔离的故障域里,把"噪声邻居"问题在底座里就压住。这一点在政府或银行那种"一台大机器上塞好多部门"的场景里尤其值钱,因为你不希望某部门的批量作业半夜把另一个部门的实时服务挤瘫。
再往上是机密计算(confidential computing)。Rubix 可以利用 CPU 的加密内存区域(enclave)让敏感计算在内存里也是加密的,哪怕有人能物理插手这台机器、把内存 dump 出来,拿到的也是密文。这对"数据不动计算动"、以及在不可完全信任的硬件上跑高密级任务的场景,是真正的护城河。
这套能力不是开了开关就完事,它有一套闭环的信任链条。一个机密工作负载在拿到密钥和数据之前,Rubix 会先对 enclave 做远程证明(attestation):把运行时加载代码的度量哈希交给验证方,只有当这个哈希落在白名单里、证明跑的就是那份被批准的代码时,密钥才会被释放进加密区域。换句话说,数据访问是被"代码身份"绑定而不是被"机器身份"绑定的。哪怕有人换了一块被污染的硬件、甚至拿到了机器,只要跑的代码不对,就取不到数据。这个"代码即身份"的模型,是把零信任真正推到了计算执行的那一瞬。
我的判断是,Rubix 的安全模型之所以被军方认可,不在于它发明了什么新密码学,而在于它把这些本该分散由不同团队拼凑的能力,做成了底座出厂即带、且和环境无关的一致实现。客户不必在每个环境里重新论证一遍安全,底座到哪都长一样。
第五层:断网续运,air-gapped 与边缘自治
这一节是 Rubix 最硬核、也最容易被云原生工程师忽略的能力。前面几篇我们默认系统一直在线,但在 Palantir 的相当一部分部署里,"在线"才是例外。
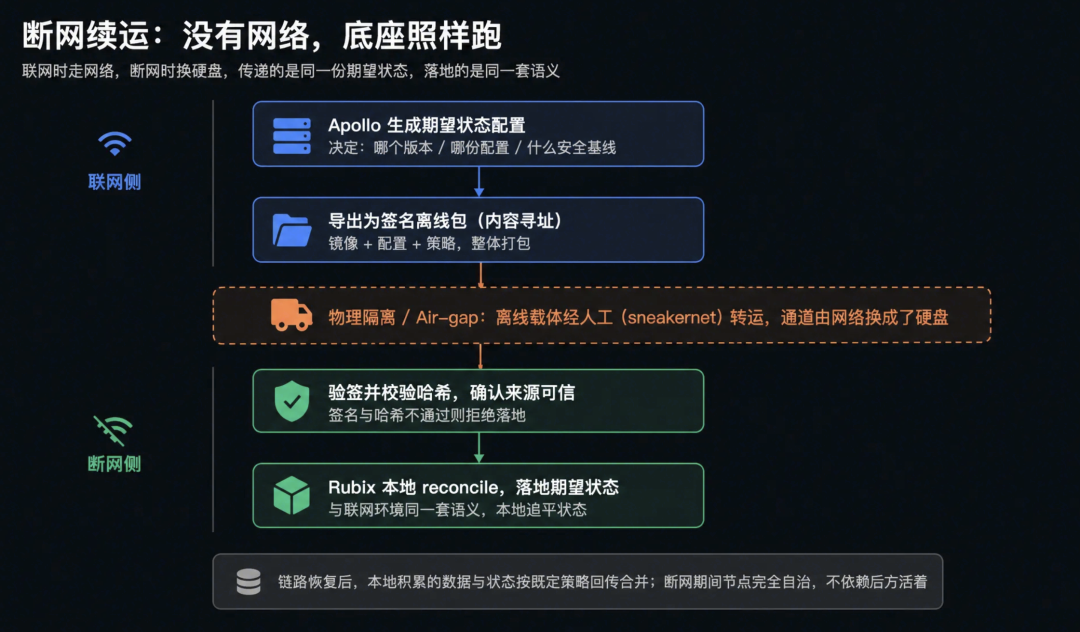
air-gapped 环境意味着没有任何入站和出站的外部网络连接,没有镜像仓库可拉,没有云端遥测可回传,连 NTP 都可能没有。在这种环境里,你没法指望"kubectl apply 一下"就能更新系统。Rubix 的做法是把一切可移动的东西打包成离线载体:软件镜像、配置、安全策略、甚至监控数据的导出,全部做成可以装进加密硬盘、通过人肉(sneakernet)带进去的离线包。到了隔离机房,Rubix 读取这个包,按和联网环境完全一致的语义把期望状态追平。
这里 Apollo 和 Rubix 的配合就显出来了。Apollo 负责生成"这次要变成什么样"的那份期望状态配置,它本来在云端工作;这份配置连同所需产物被打包,物理运抵隔离区后,Rubix 在本地把它落地。也就是说,断网并不改变"谁决定、谁执行"的分工,只是把传递通道从网络换成了硬盘。
这个离线包本身也不是一个随手拷过去的文件夹。它是按内容寻址、带签名的一整份产物集合:Rubix 在应用之前会先验签名、比对哈希,确认这一包确实来自可信来源、且没在运输途中被改过,才会动手落地。这把"离线"带来的供应链风险兜住了,你不会因为介质在半路被人动过手脚,就把一套被篡改的东西灌进涉密网络。等链路恢复,本地积累的数据和状态再按既定策略回传合并。
边缘自治是另一个维度。在战术边缘,链路时断时续甚至长期断联,前线的 AIP 节点必须能自己做推理、自己做数据对齐、自己维持 Ontology 的本地视图,而不能每次动作都等后方回指令。Rubix 给边缘节点提供了完整的本地运行面:它不依赖后方活着才能工作,后方只是偶尔同步状态的另一端。等链路恢复,本地积累的数据和状态再按既定策略回传合并。
这套"能离线跑、能离线更新、能本地自治、能事后对账"的能力组合,是 Rubix 区别于普通 Kubernetes 发行版的根本。K8s 可以断网跑,但它没有把"如何在断网下交付一次原子化、可验证、可回滚的整套产品更新"做成一等公民。Rubix 做了。
第六层:Rubix 与 Apollo 到底怎么分工
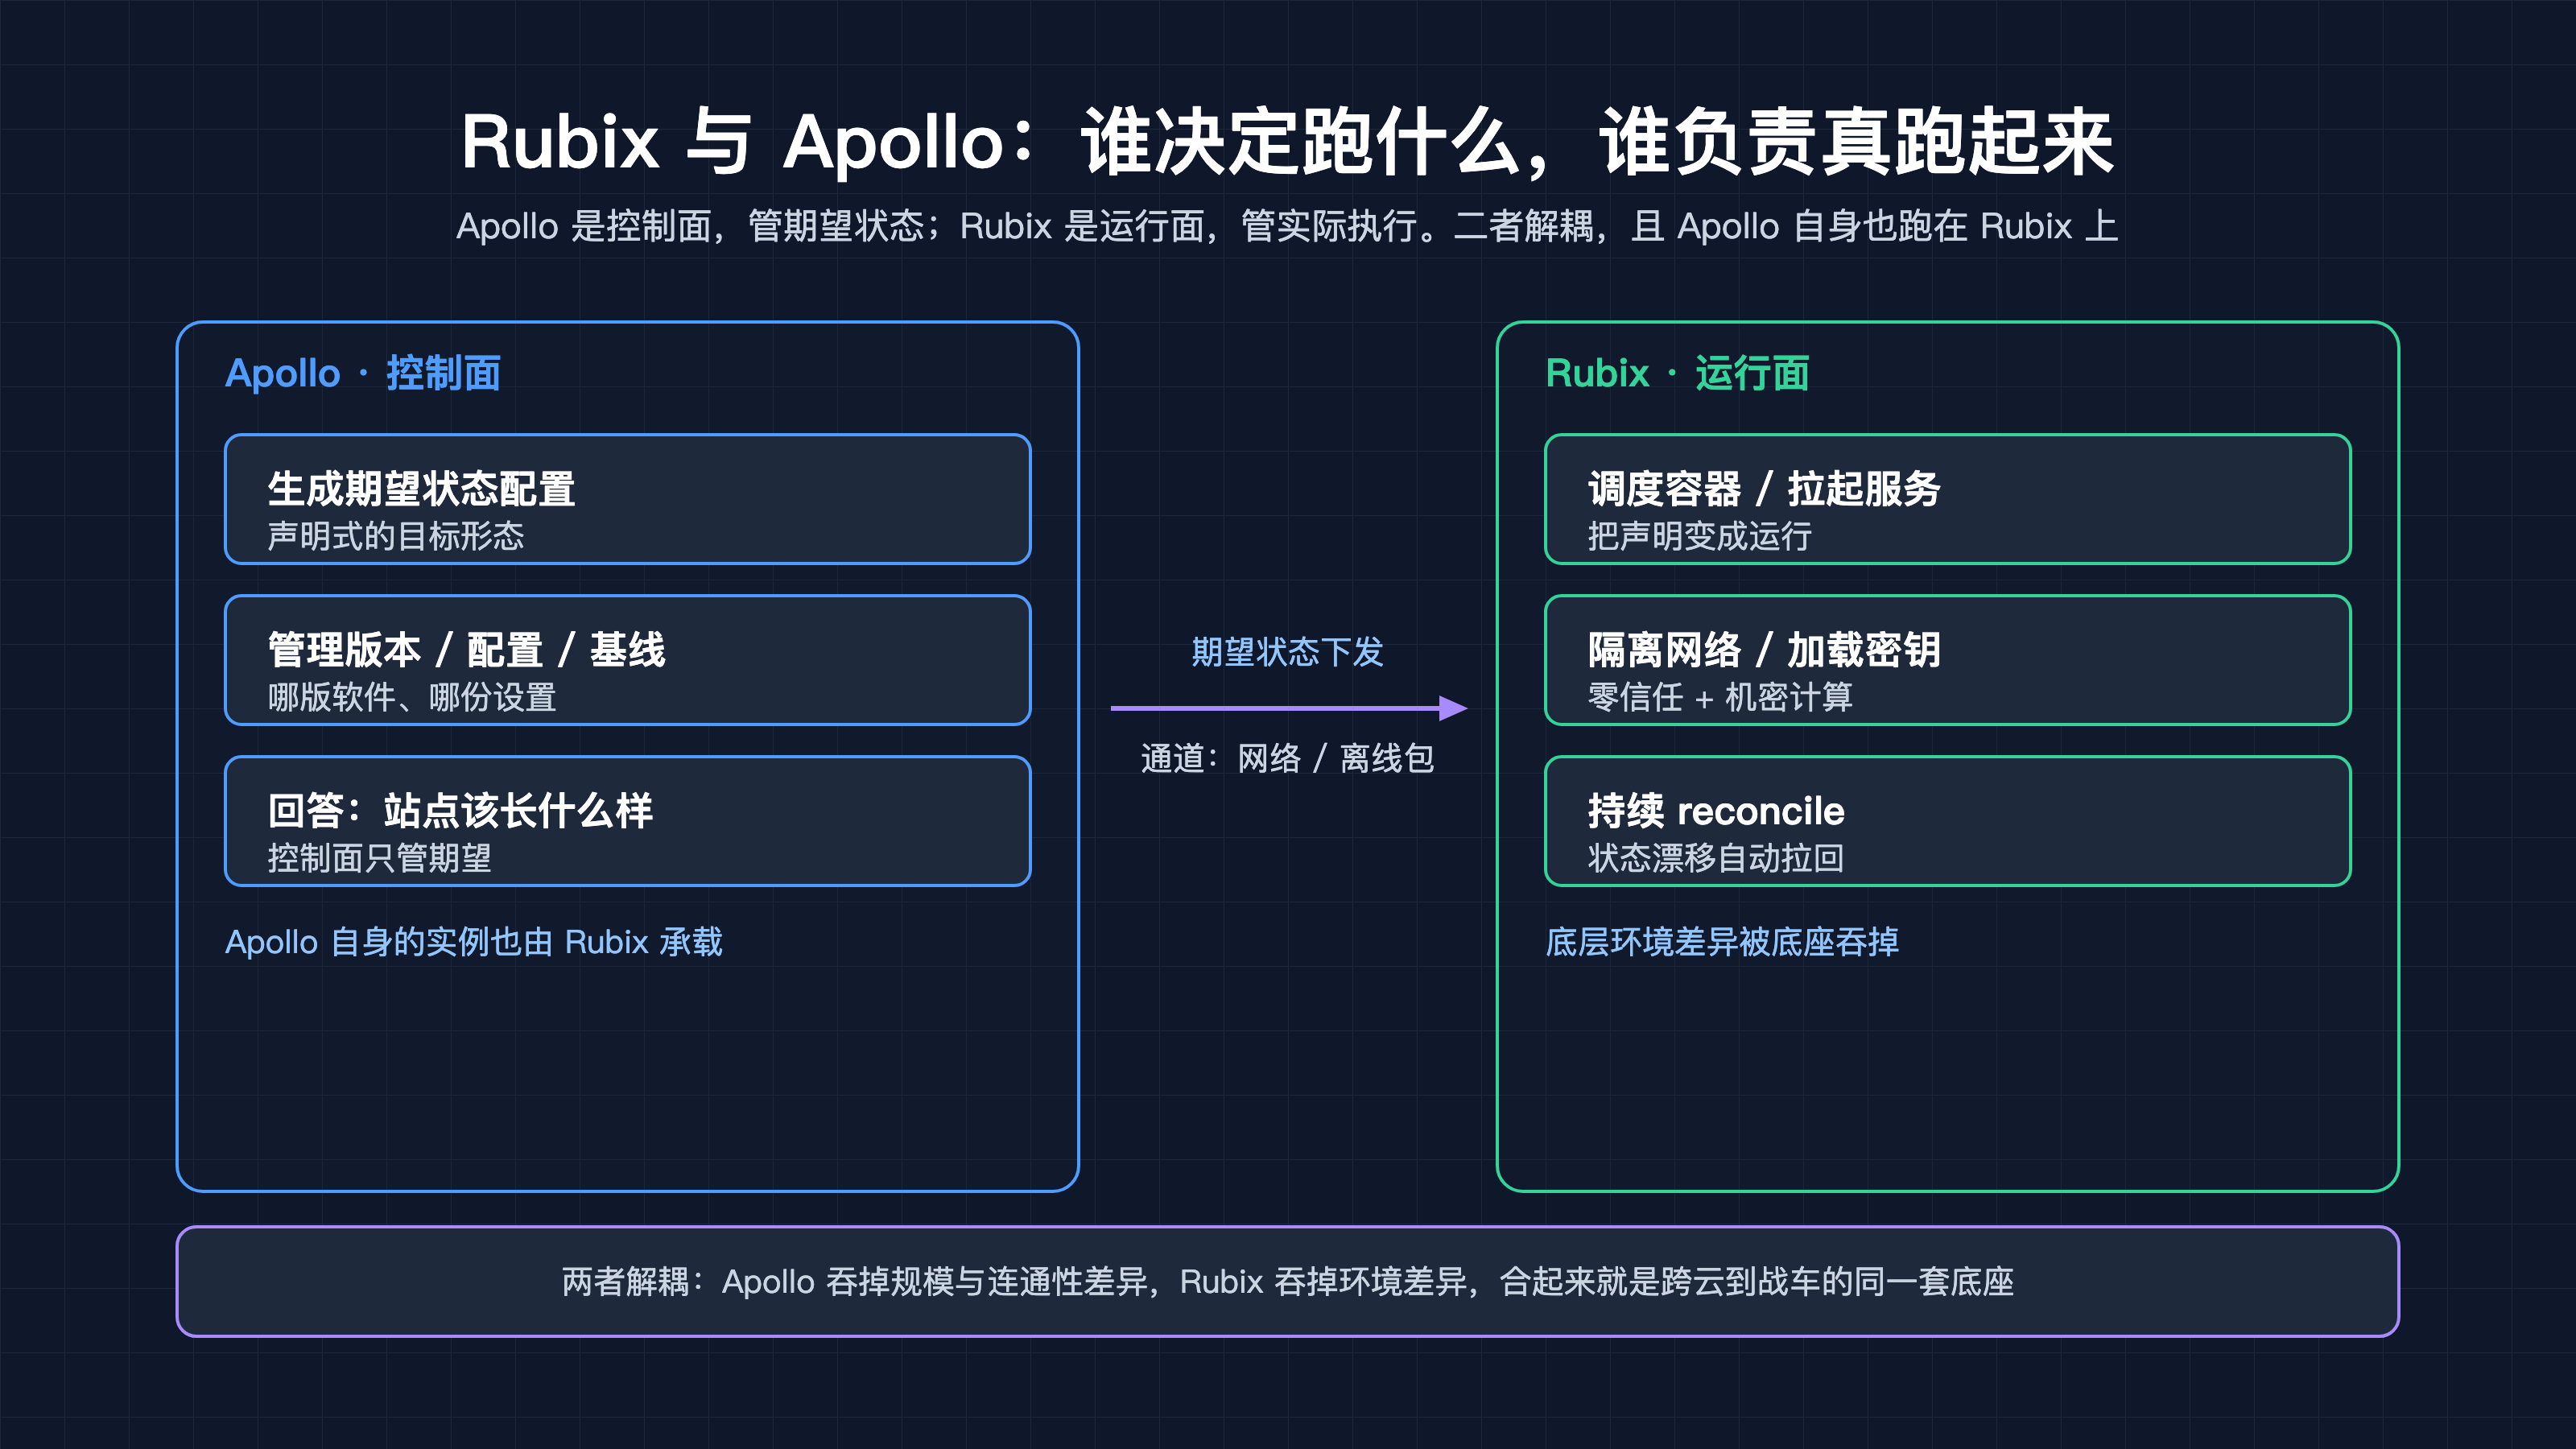
到这里必须把两个名字的边界划清楚,因为它们经常被混为一谈,甚至被外面写成同一个东西。我的表述是:Apollo 决定"应该跑什么、怎么配置",Rubix 负责"真的把它跑起来并维持住"。
Apollo 是 Palantir 的持续交付与配置编排产品,它源自 Palantir 给自己内部部署用的工具链,最早就是为美军那种"要把软件持续推到全球各地、还经常断联的节点"的场景打磨出来的。Apollo 维护的是每个部署的期望状态:哪个产品的哪个版本、配哪份设置、安全基线是什么。它回答的是"现在这个站点应该长什么样"。
Rubix 是承载这些工作负载、并对照期望状态做实际协调与运行的底座。它回答的是"我怎么在这个具体环境里把那个样子真正造出来并且守住"。Apollo 的指令落到 Rubix 上,Rubix 去调度容器、隔离网络、加载密钥、拉起服务,并持续保证实际状态不漂移。
一个容易混淆的点:Apollo 自己也是跑在 Rubix 上的。所以关系是分层的,不是平行的。Apollo 作为控制面,它的控制面实例本身也由 Rubix 承载;它向下管理的是更多的 Rubix 节点。控制面与运行面之间通过一个与环境无关的交付通道通信,联网时走网络,断网时走离线包,对上层透明。
这个分工的妙处在于解耦。Palantir 的产品团队可以专心在 Rubix 上把某个功能写好,交付团队可以通过 Apollo 把它推到全球几千个形态各异的节点,而没有任何一方需要关心另一端具体是云还是战车。Rubix 吞掉环境差异,Apollo 吞掉规模与连通性差异,两者一合,就是 Palantir 能"一套软件卖给从银行到战场"的真实底座。
第七层:从云端到战车,一个真实的部署拓扑长什么样
把前面几层拼起来,看一个最常见的组合拓扑。后方是一个连接云端的 Foundry 主站点,数据治理、Ontology 建模、批量计算都在这里发生,它坐在云上的 Rubix 上。前线是一组战术边缘的 AIP 节点,装在车辆或便携设备里,跑在轻量化的 Rubix 上,本地就能做模型推理和实时决策。
这两端靠同一套 Ontology 对齐语义。后方定义的本体和对象类型,通过 Apollo 把对应的配置与模型产物,以联网同步或离线包的方式推到前线 Rubix 节点,前线在本地用自己的 Rubix 拉起对应的 AIP 工作负载。数据可以因为带宽和密级只同步增量,但运行底座同源、安全模型同源、协调语义同源。
我特别想点破的一件事:很多人以为"边缘 AI"的难点是模型小、延迟低。对 Palantir 这种把全套企业级平台搬到边缘的玩法来说,真正的难点从来不是模型,而是"让一个原本为云数据中心设计的庞杂软件栈,在断网、低算力、不可信硬件的边缘环境里,行为仍然一致、安全仍然可信、更新仍然可控"。Rubix 解决的就是这个,它不是把 AIP 砍薄了塞进边缘,而是让完整的底座能力在边缘也成立。
这也是为什么我说 Rubix 是 Palantir 架构里最被低估的一层。前面几篇讲的 Ontology、AIP 都是看得见的能力,客户愿意为它们付钱。但真正让这些能力能够跨越从商业云到战术边缘这个巨大光谱、还能保持一致的,是底下这套不出镜的底座。它不炫,但它是 Palantir 能把"同一个平台"卖给两种极端客户的前提。理解 Rubix,你就理解了 Palantir 部署能力的边界在哪里,也就理解了为什么它的竞争对手在想进国防和监管核心场景时,往往卡在的不是一个算法,而是缺这一层能跨环境的底座。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号