【#WorkBuddy#】本地任务编排的三个工程问题:幂等、账实核对与策略收敛
原创
【#WorkBuddy#】本地任务编排的三个工程问题:幂等、账实核对与策略收敛
原创
海在路上
修改于 2026-09-12 17:12:54
修改于 2026-09-12 17:12:54
一、起因:一个"每天重复做"的动作,值得做成系统吗
我用 WorkBuddy 处理文档整理与资料汇总,日常有一些固定动作需要按周期重复执行。这类动作有两个特点:单次成本极低,但漏一次就断链。
我一开始也是手动做。三周之后问题暴露出来:
- 一定会漏。入口藏得比较深,忙起来就忘了;而有些动作一旦中断,前面累积的连续记录也跟着重来。
- 算不清优先级。几件事的价值和耗时都不一样,凭感觉排序的结果,往往是把时间花在最不划算的那一件上。
- 不敢用来路不明的脚本。搜到的一些方案是在猜请求参数、试探接口——这既不安全,也不是我想要的做事方式。
所以我的目标从来不是"多做多少",而是:把这类确定性的重复动作,做成一套我自己能长期跑、出问题能查、账目对得上的本地流程。
本文记录这套流程的设计与踩坑。真正让我花时间的,不是"怎么让它跑起来",而是下面三个工程问题。
二、开工前先立规矩:四条硬边界
这四条决定了后面所有设计的形态,也是我判断"某个方向要不要做"的唯一标准:
- 只使用官方已提供的能力。凡是官方没有开放的能力,一律不做。不做接口探测、不改请求参数、不绕过任何限制——这条没有例外。
- 遇到人工验证就停下。需要扫码、验证码或人工授权的环节,一律标记为"待人工处理",不做任何绕过尝试。
- 确定性任务绝不经过大模型。这类动作不需要"智能",交给本地脚本 + 系统计划任务即可,成本恒定;大模型只用来做它擅长的事——读报告、判断异常。
- 幂等是强制项。任何动作执行前先确认状态:已完成就跳过。绝不允许因为重复运行而产生重复提交。
第 3 条直接决定成本,第 4 条决定这套东西能不能一天跑五次还不出事。边界不是束缚,是它能长期跑下去的前提。
三、核心设计:三层架构
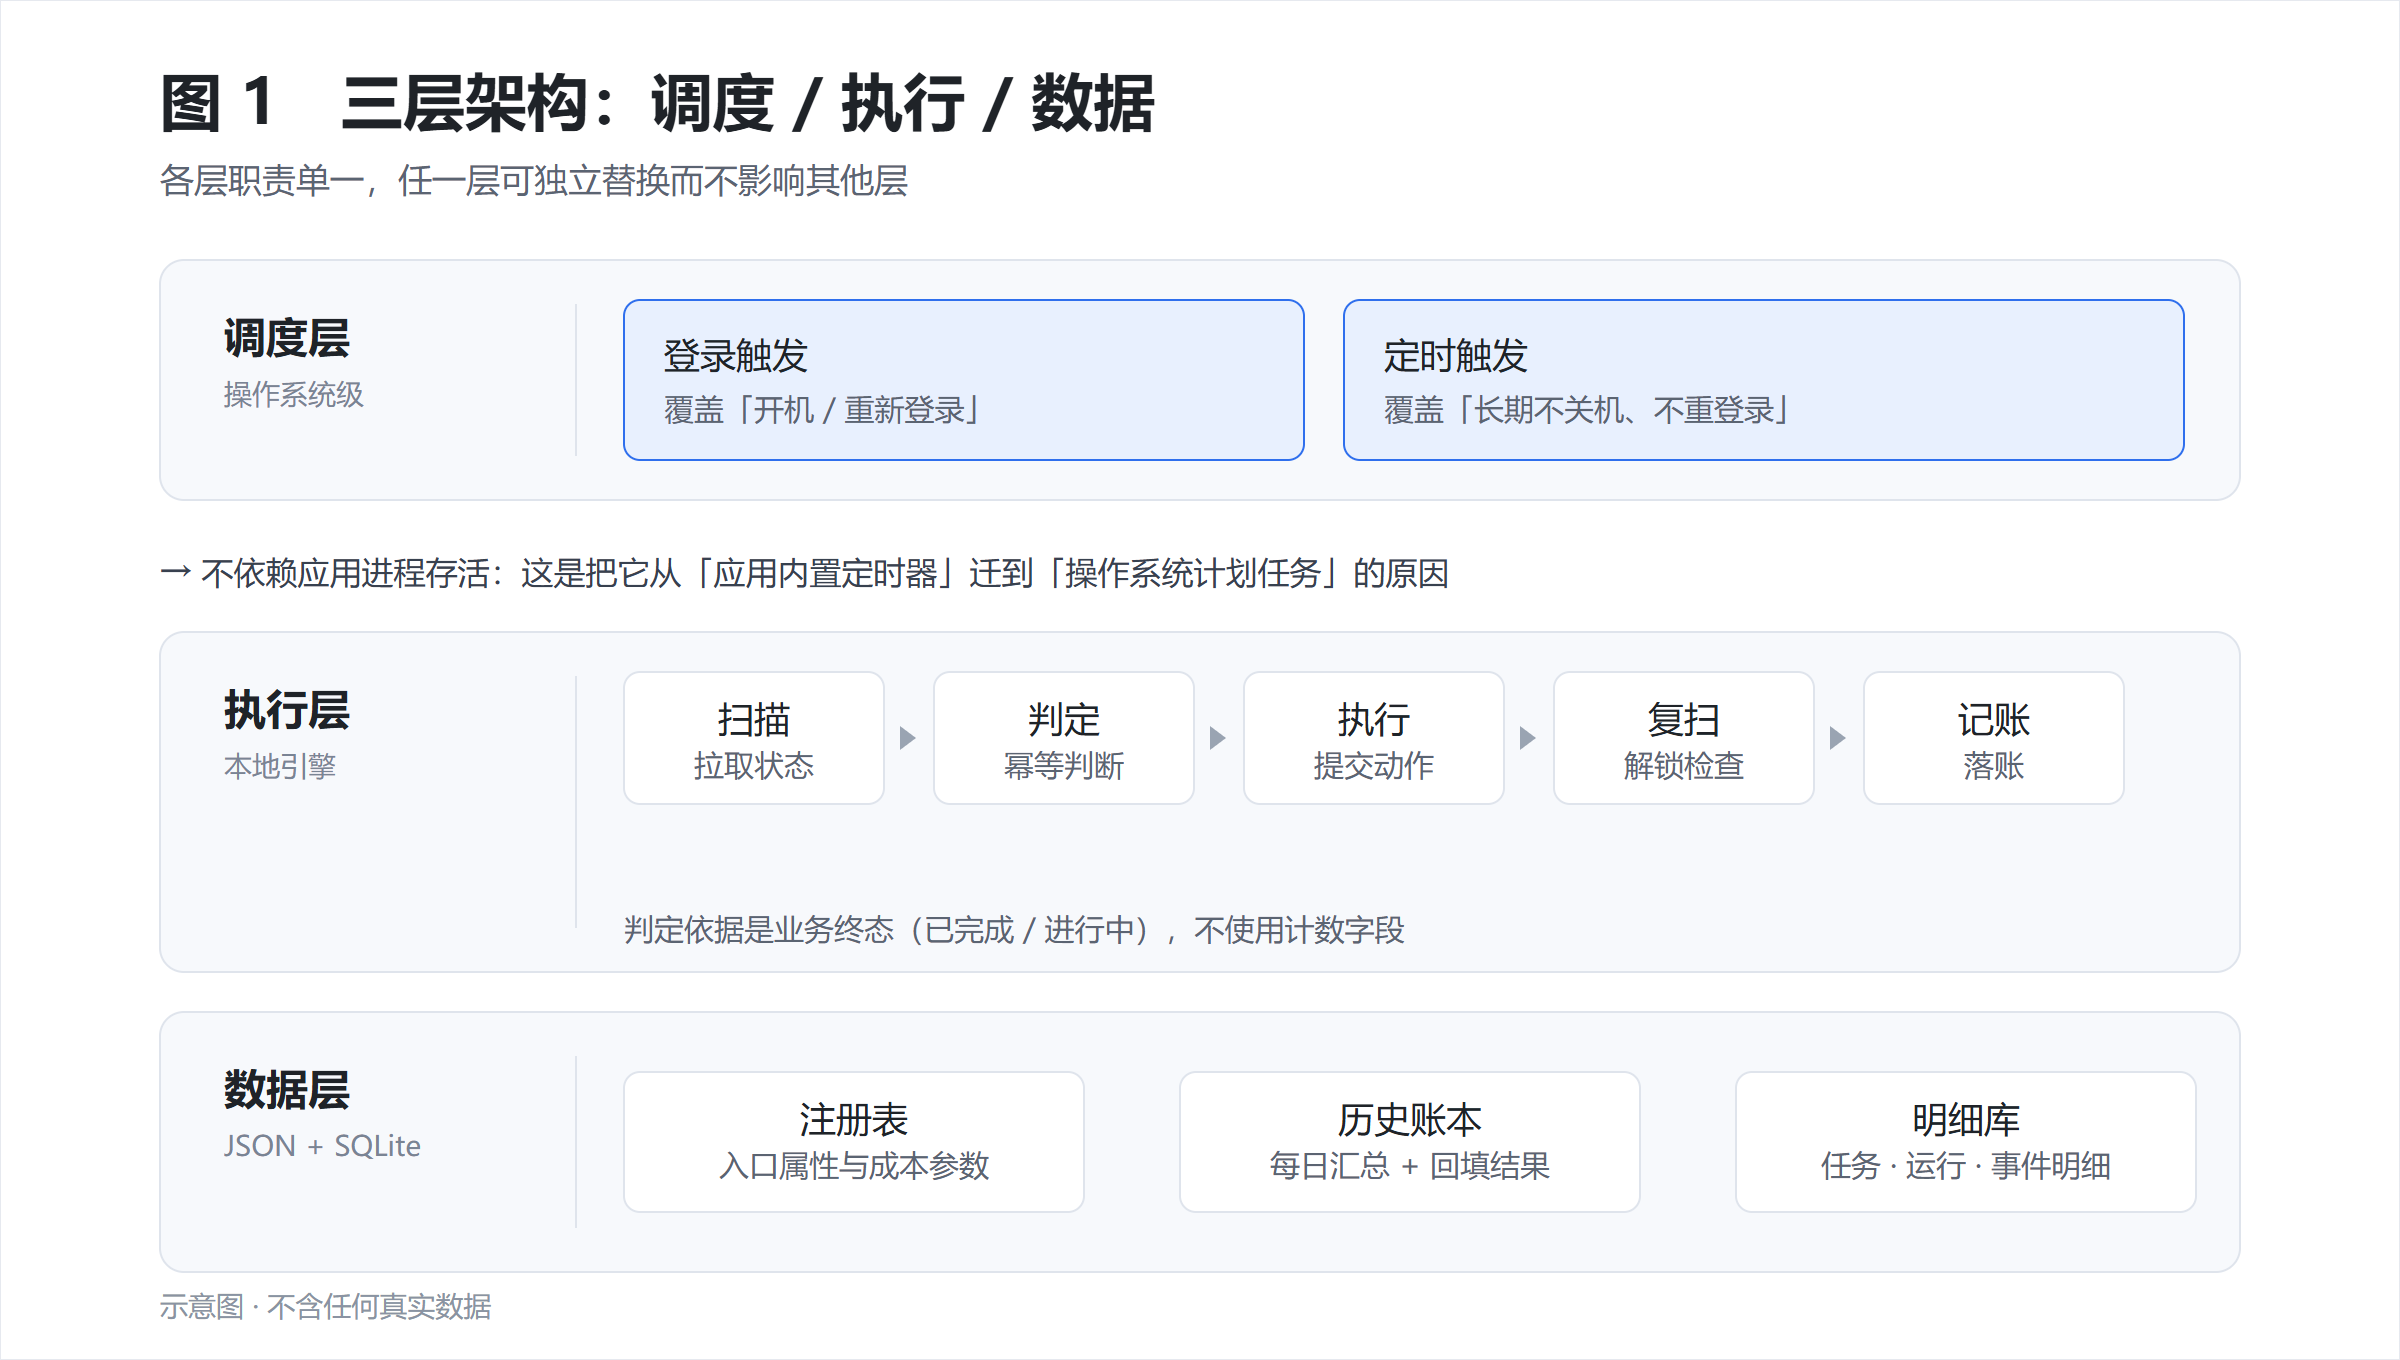
图 1 三层架构:调度 / 执行 / 数据
整套流程分三层,各司其职。分层的收益会在第六节体现出来——换掉任意一层,另外两层都不用动。
层 | 职责 | 关键约束 |
|---|---|---|
调度层 | 决定"什么时候跑" | 不依赖应用进程存活 |
执行层 | 决定"跑什么、怎么不重复跑" | 幂等,可重入 |
数据层 | 决定"怎么记录、怎么对账" | 账与对端事实对齐 |
下面三节分别展开。第七节讲怎么给这些动作排优先级,第八节是几个反直觉的结论。
四、调度层:为什么交给操作系统,而不是应用自己
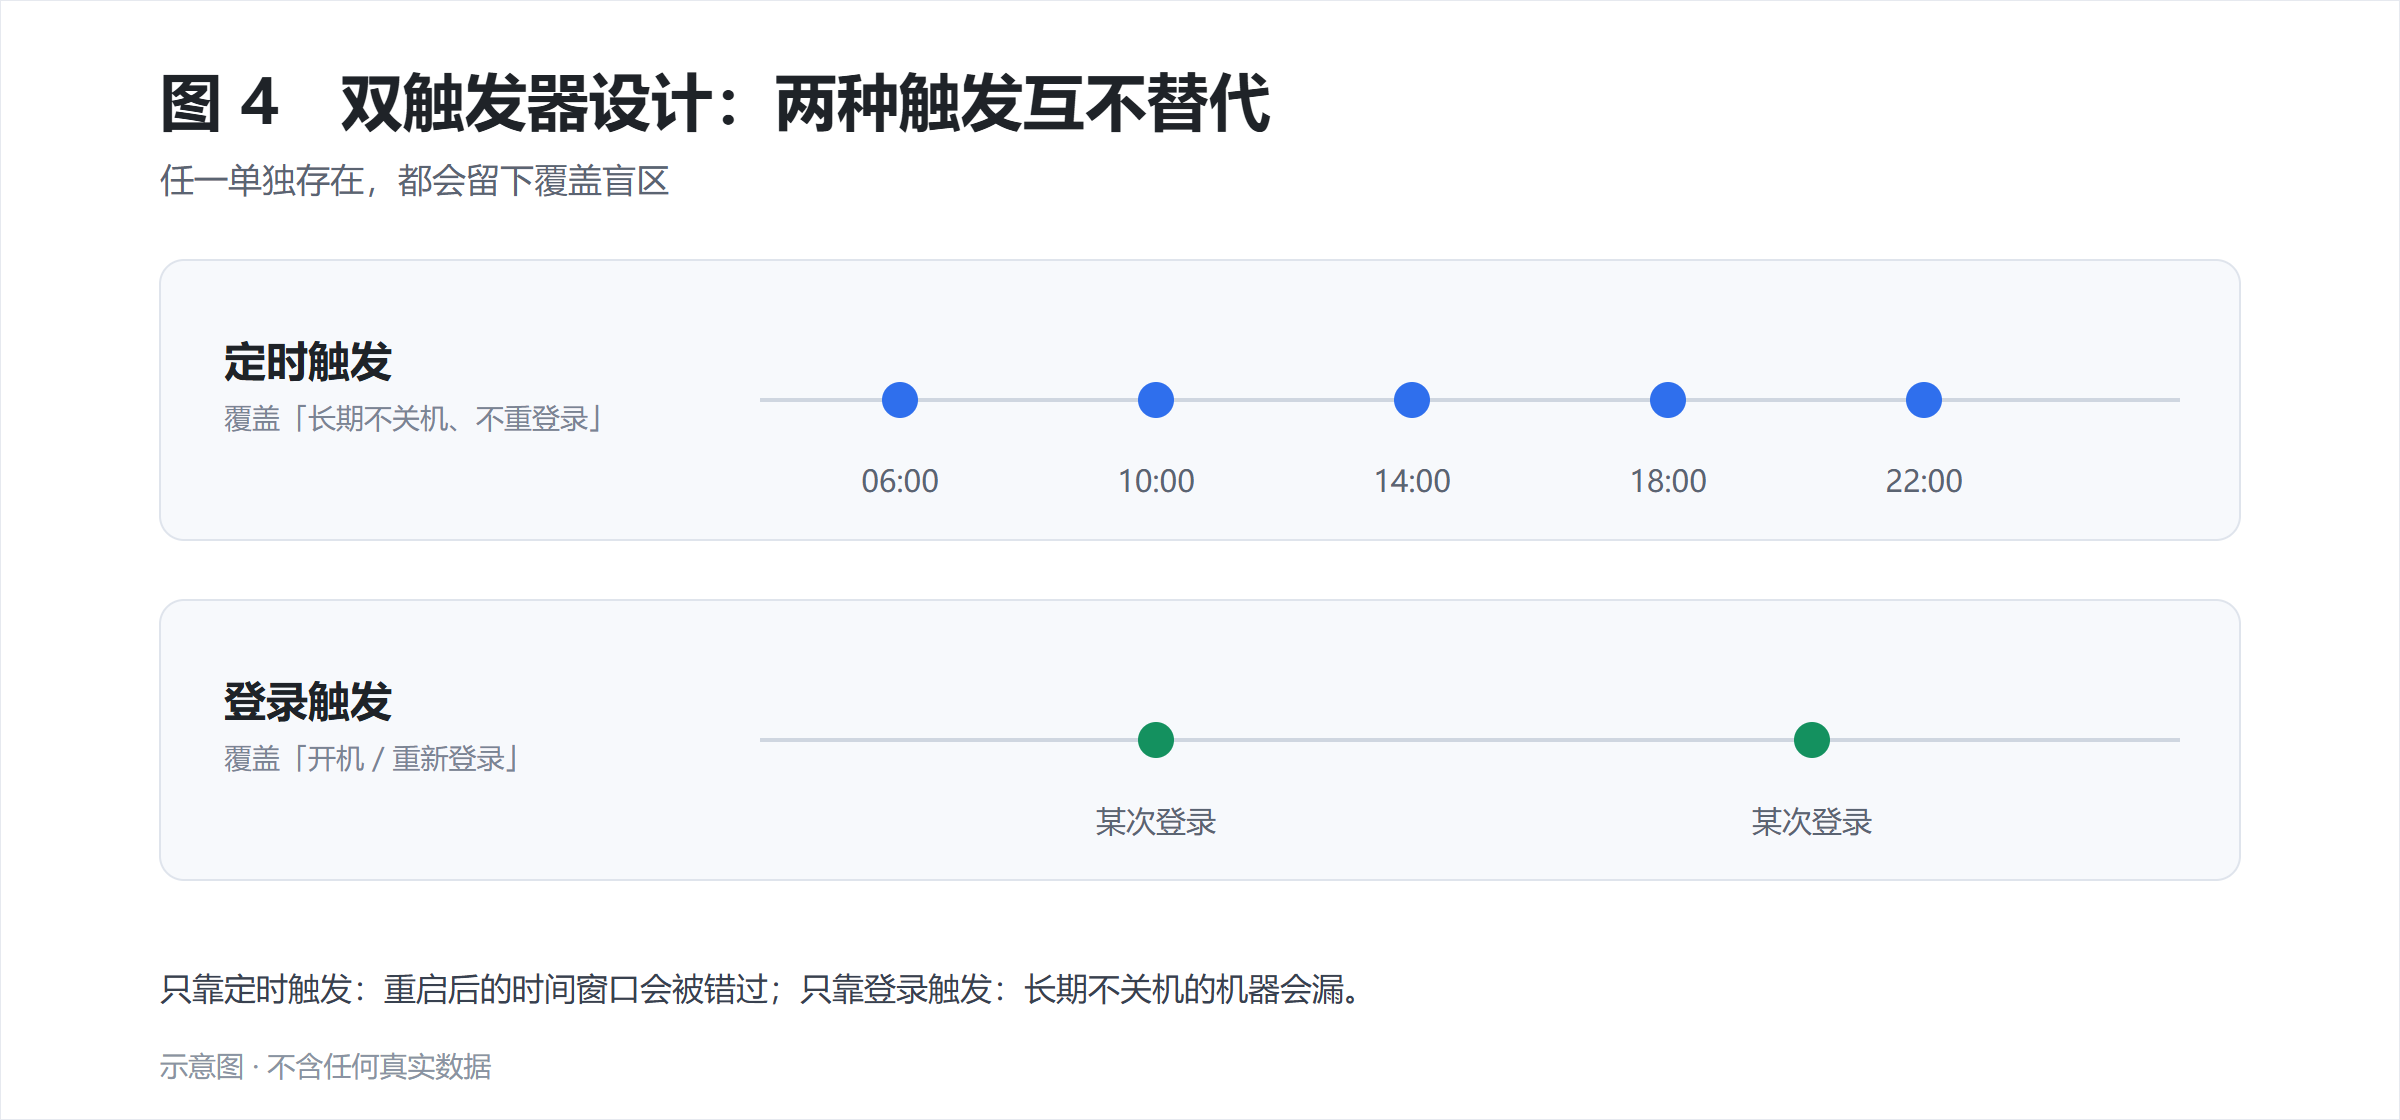
图 4 双触发器设计:两种触发互不替代
我最初用的是应用内置的定时器,实测发现它只在客户端处于运行状态时才生效。有一次我把任务设在晚上,结果那时客户端已经关闭,任务根本没有触发,白白延误了一天。
而这些动作本身只依赖本地登录态、不依赖客户端进程,所以改由系统计划任务触发,可靠性立刻上了一个台阶。我配了两个触发器:
- 登录触发:登录后一段时间触发,之后按固定间隔重复
- 定时触发:每日固定时段起,按固定间隔重复
两个触发器是有意为之,它们是互补的:
- 只靠登录触发 → 长期不关机、不重登录的机器会漏
- 只靠定时触发 → 重启之后的那段时间窗口会被错过
结论:调度不该由被调度的应用自己负责。 谁的生命周期更长,就该由谁来做调度。
注册这样一个双触发器任务,只需要一次性配置:
# 调度交给操作系统:注册一个由两个触发器共同驱动的计划任务
$action = New-ScheduledTaskAction -Execute 'powershell.exe' `
  -Argument '-NoProfile -ExecutionPolicy Bypass -File "<你的脚本>.ps1"'

Register-ScheduledTask -TaskName '<任务名>' -Action $action -Trigger @(
  New-ScheduledTaskTrigger -AtLogOn          # 登录触发
  New-ScheduledTaskTrigger -Daily -At 06:00  # 定时触发
)一个工程细节:Register-ScheduledTask 是幂等的——同名任务再次注册会覆盖而不是叠加。所以这段配置本身可以直接放进部署脚本里反复执行。
五、执行层:幂等收割循环
执行层是我自己写的,负责把「扫描 → 判定 → 执行 → 复扫 → 记账」串成闭环。
先记一个环境上的坑:如果脚本报"未找到可用登录态",多半不是真的没登录,而是登录态文件所在目录与预期不一致——部分安装环境下它位于另一个 AppData 目录。运行前显式指一下路径即可:
# 报「未找到可用登录态」时,先试这一行
$env:APPDATA = $env:LOCALAPPDATA
这个坑我排查了很久,写在这里帮你省时间。
收割循环:先判定,再执行
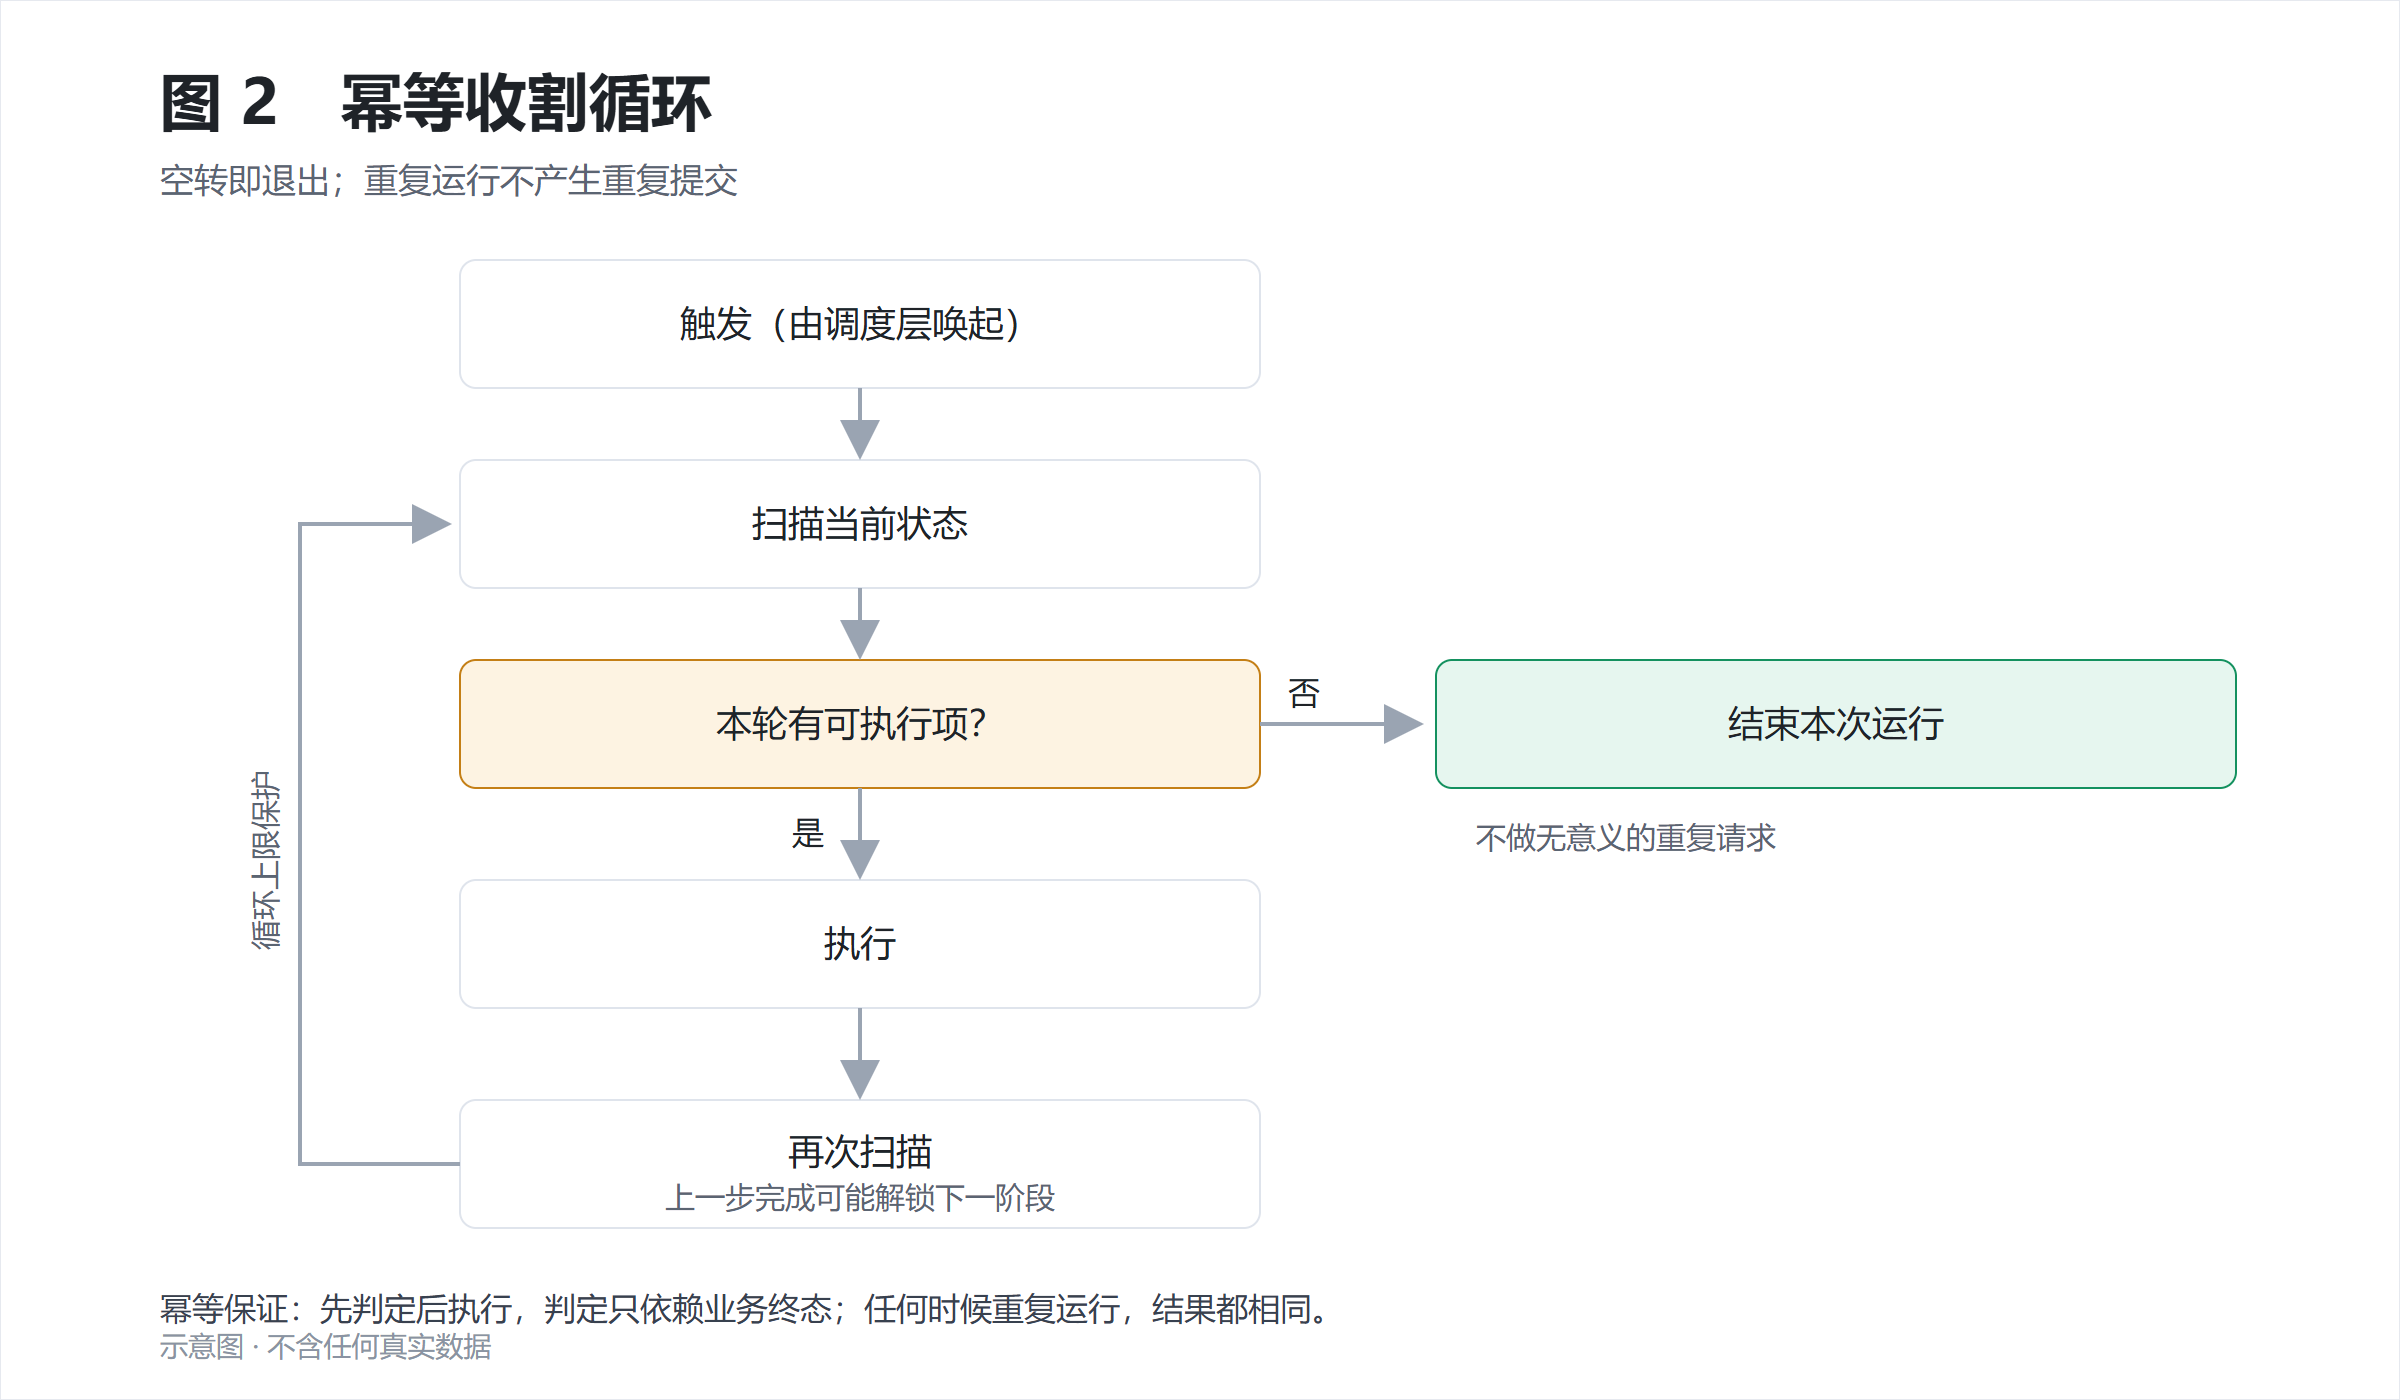
图 2 幂等收割循环
循环的骨架只有四步:
- 扫描状态 —— 拉取当前有哪些可执行项
- 判定 —— 有可执行项吗?没有就直接结束本次运行
- 执行 —— 逐项执行,执行完立刻再扫描一次
- 判断是否继续 —— 若本轮全是空操作,立即停止
第 3 步的"立刻再扫描"是必要的:我在记录里见过"同一个周期内两笔结果都落在同一天"的情况,来源是前一期滞留的动作在当期才完成。上一步完成,可能解锁下一阶段。
但循环不能无限转。我给它设了很小的轮数上限,并且一旦本轮全部返回"已完成 / 进行中"这类终态,立即停止——不做无意义的重复请求。
这里有一条踩过坑才明白的原则:
早期我用返回体里的计数来判断"这件事做过没有",结果发现执行成功之后,那个计数仍然可能是 0。改用"已处理"这类业务结论之后,幂等才真正成立:连续运行多次,输出完全一致。
六、数据层:账实核对
数据层用三种存储,各管一件事:
- 注册表(JSON):记录每个动作的触发条件、价值、频率、是否可自动化、历史成功率
- 历史账本(JSON):每日汇总,以及从运行记录回填的真实结果
- 明细库(SQLite):任务、运行、事件、失败明细分表存放
结构本身没什么技术含量,真正值得写下来的是这次最值得记的一个坑。
账实核对:账必须与对端对齐
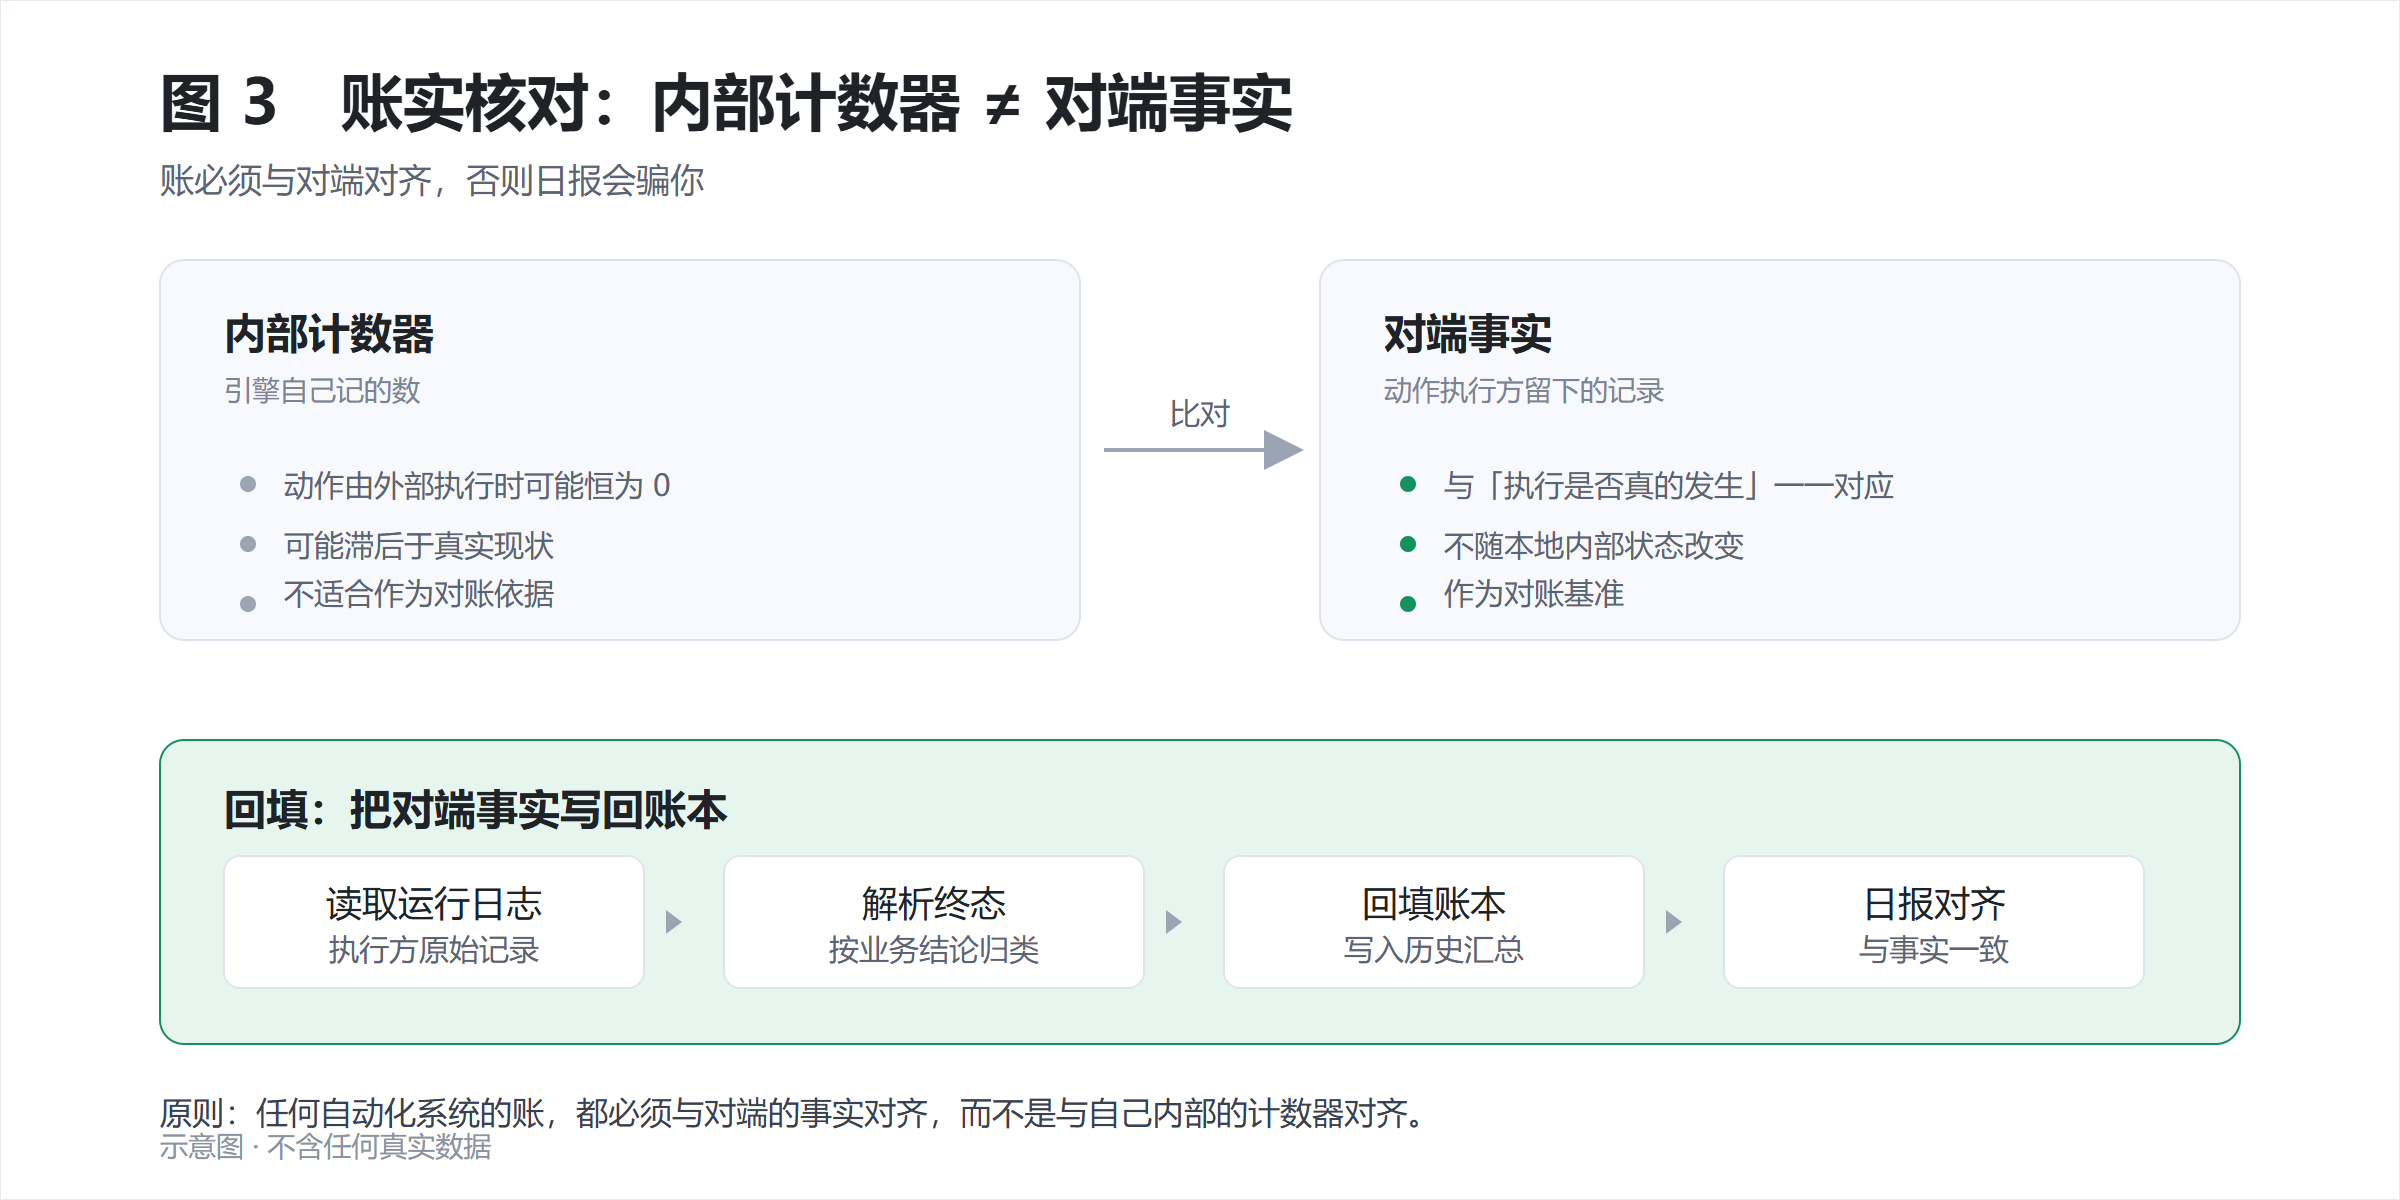
图 3 账实核对:内部计数器 ≠ 对端事实
日报一度显示"今日无收益",但明明当天早上已经执行成功了。排查后原因很明确:
真正执行动作的是系统计划任务,它独立于引擎运行,结果只落在动作执行方自己的运行记录里。 引擎不去解析并回填这份记录,账目就是错的。
也就是说,我的引擎有一个"内部计数器",它统计的是"我发起了几次",而事实记录的是"上游确认完成了几次"。这两者本来就不是一回事。
加上日志解析回填之后,日报才和真实情况对上。这件事让我确立了一条原则:
顺带一个推论:"触发成功"不等于"执行成功"。 如果账只记到触发这一层,它就会持续告诉你一切正常,而事实可能完全相反——这是自动化系统里最危险的一类谎言。
七、成本评分:怎么判断"先做哪个"
直觉上"价值高的比价值低的更值得做",但这通常是错的——如果高价值那件要人手动操作几分钟,而低价值那件脚本几秒跑完,后者划算得多。
所以我给每个动作算一个等效成本,把时间、金钱、打断成本统一折算成"等效秒":
- 等效成本 = 执行耗时(秒) + AI 成本折算 + 人工惩罚(300 秒)
- 优先级分 = 价值 × 成功率 ÷ 等效成本
人工惩罚取 300 秒,因为"被叫过去点一下"的打断成本,远高于动作本身那几秒。这是整个模型里最容易被低估的一项。
跑出来的分档大致是这样:
档位 | 判定标准 | 处理方式 |
|---|---|---|
P0 | 每日必做、耗时接近 0、可自动化 | 交给计划任务 |
P1 | 长周期累积,中断即断链 | 交给计划任务 + 中断告警 |
P2 | 状态机类,需要等待上游 | 交给计划任务 + 二次扫描 |
P3 | 低价值,仅在极低成本时才做 | 暂缓 |
P4 | 必须人工完成 | 不做自动化,排进日历 |
P4 这一档是整个评分系统最大的价值:它逼你承认"哪些事自动化解决不了"。这几件事看着价值不低,但等效成本极高,算下来优先级分接近 0。
预估值还会随实测自动校准:某个动作我最初只能靠估,跑了三次拿到真实结果之后,系统把估值改成实测均值,并把这次变更写进了 strategy_changes 表——连"策略是怎么变的"也被留了痕。
八、几个反直觉的结论
跑下来最有价值的其实是"哪些路走不通":
1. 某个布尔标记为 false,不代表功能已经下线。 我只读查询时拿到过一个 false,一度以为这件事已经结束了;但同一天的实际执行成功了。事后确认,那个标记反映的是活动档期,不是可用性开关。别看到一个 false 就放弃。
2. 状态标志位不能用来做幂等判断。 执行成功之后,返回体里的计数类字段仍然可能是 0。所以幂等只能依赖业务终态结论。这是我早期犯过的最大一个错误。
3. 提高轮询频率不会增加收益。 我本想把触发间隔缩短一半、把轮数拉满。查记录才发现:这类动作的节奏约束在上游,不在我这一侧,提高本地频率只是徒增请求。这个优化方向当场砍掉。能被证据否决的优化,才算真的优化过。
4. 大部分动作无法自动化,也不该自动化。 我逐项核查了自己整理的一张清单,结论是只有极少数具备可编程访问方式,其余都是客户端界面独占、必须人工。这里要特别说明:我没有做过任何接口探测或参数猜测——猜接口这件事本身就在红线之外,无论技术上是否可行。
九、总结
回头看,这套东西的价值不在于每天多完成多少,而在于三个判断:
- 把确定性的交给机器,把创造性的留给自己。 周期性、可判定、结果唯一的动作交给计划任务;需要判断和表达的,老老实实自己做。
- 先算成本,再谈价值。 把时间、金钱、打断成本统一折算成等效成本,很多"看起来该做"的任务会自己掉出优先级。
- 账目必须与事实对齐。 系统内部的计数器会骗你,对端的真实记录不会。
如果你也打算做类似的事,建议先把上面那四条硬边界写进代码里——它们不是束缚,是让这套东西能长期跑下去的前提。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号