#WorkBuddy# DeepSeek V4.1 Flash 技术深扒:CSA2 把 KV 缓存压到 890 字节/token 意味着什么
原创
#WorkBuddy# DeepSeek V4.1 Flash 技术深扒:CSA2 把 KV 缓存压到 890 字节/token 意味着什么
原创
GavinGeng
发布于 2026-09-12 17:53:44
发布于 2026-09-12 17:53:44
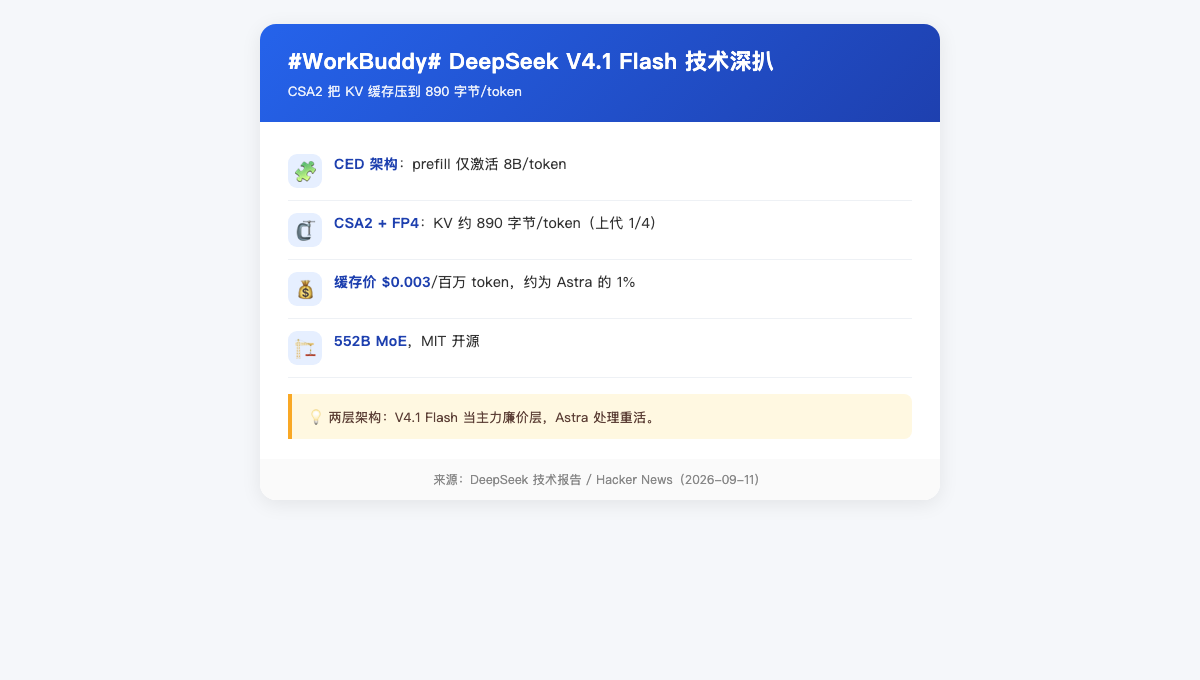
几乎和 Astra 全量开放同一天,DeepSeek 放出了 V4.1 Flash 的详细技术报告,Hacker News 直接置顶。5520 亿参数(552B)的 MoE,却被他们玩成了"省显存王炸"——核心就是把 KV 缓存压到了约 890 字节/token。这篇不聊发布会,只拆架构,讲清楚它对你部署和成本到底意味着什么。
一、先搞懂:KV 缓存为什么卡住推理成本
大模型推理分两步:prefill(一次性处理输入)和 decode(一个个吐 token)。decode 阶段每生成一个字,都要回头看之前所有字的 KV(Key/Value)向量,存在显存里。
所以:
- 上下文越长,KV 占的显存越多
- 并发越高(很多人同时问),显存越爆
- KV 大小直接决定"一台机器能撑多少并发、多长上下文"
过去大家靠量化(INT8/INT4)压 KV,但 DeepSeek 这次上了新架构。
二、CSA2 怎么把 KV 压到 890 字节
V4.1 Flash 用了两个关键设计:
- CED 架构(Causal Encoder-Decoder):20 层因果 encoder 喂 20 层 decoder,prefill 只激活约 8B 参数/token,decode 16B/token——比很多小模型还省
- CSA2(Compressed Sparse Attention 2)+ FP4 KV 缓存:把 KV 做"压缩 + 稀疏 + 4 位存储",整体 KV 压到约 890 字节/token,约为上一代 V4-Flash 的四分之一
效果:缓存命中价低到 $0.003 / 百万 token,整体成本约为 Astra 的 1%。
三、对你意味着什么
1. 长上下文更便宜:同样的钱,能喂更长的上下文、接更多并发
2. 部署门槛"显存侧"下降,但"参数侧"上升:KV 省了,可模型本体 552B 比上代 284B 大了一倍,消费级显卡反而更难本地跑——想本地部署得靠多卡或量化
3. 适合做"主力廉价层":把高频、对极致智能不敏感的任务全丢给它,把贵模型留给少数重活
四、选型:Astra 还是 DeepSeek V4.1 Flash
一句话:
- 要极致智能、长文档综合推理、会操作电脑 → Astra(但贵)
- 要海量并发、低成本、长上下文通吃 → DeepSeek V4.1 Flash(成本约 1%)
很多团队的正确姿势是"两层架构":V4.1 Flash 当默认主力,Astra 只处理真正难的任务。
你更关心"怎么把推理成本压下来"还是"本地能不能跑起来"?评论区告诉我,下篇我直接上部署实测。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号