#WorkBuddy# GPT-6 Astra 攻破 FrontierMath Tier 4:数学评测线到头了,对开发者意味着什么
原创
#WorkBuddy# GPT-6 Astra 攻破 FrontierMath Tier 4:数学评测线到头了,对开发者意味着什么
原创
GavinGeng
发布于 2026-09-13 13:38:15
发布于 2026-09-13 13:38:15
9 月 13 日这天,AI 圈同时冒出两条看起来互相打脸的新闻:
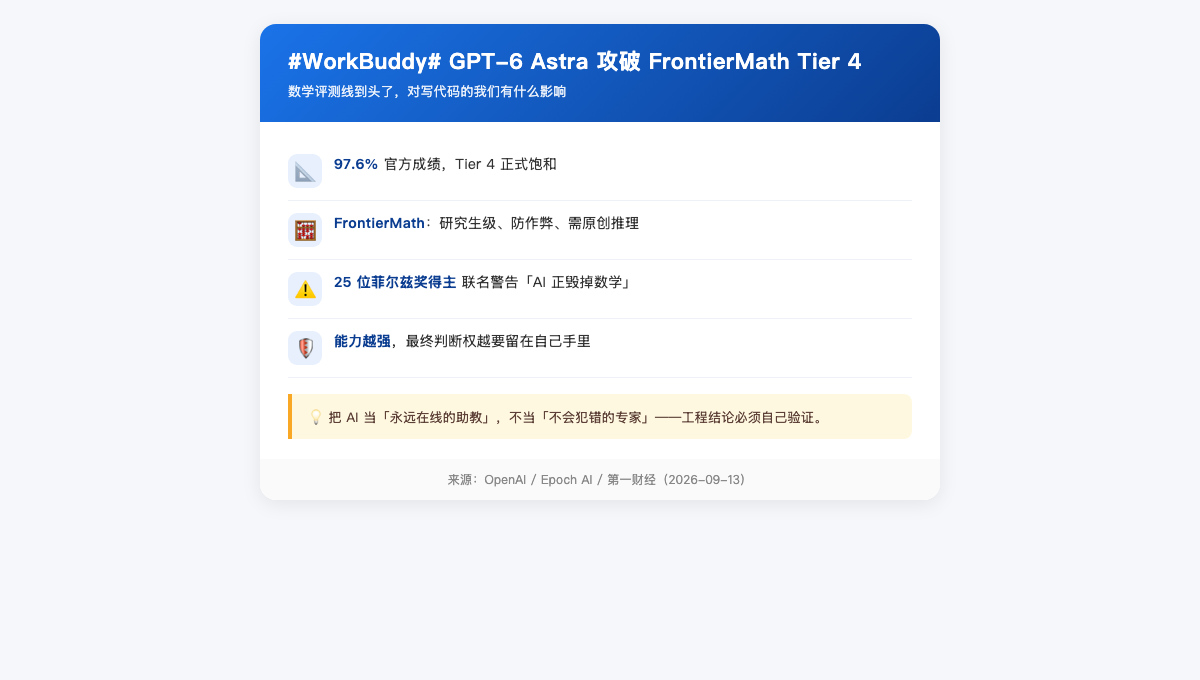
一边是 OpenAI 公布,GPT-6 Astra 把 FrontierMath 最高难度档 Tier 4 全部解完,官方成绩 97.6%,这套曾被称作"大模型数学噩梦"的研究级测试正式宣告饱和。
另一边,陶哲轩等 25 位菲尔兹奖得主 联名发公开信,警告"AI 正毁掉数学"——他们担心的不是 AI 解不出题,而是 AI 以越来越快的速度批量生产"真/假"结论,可能摧毁孕育思想的沃土。
这两件事放在一起,恰好把"AI 数学能力到底到了哪一步、对我们有什么用、又该警惕什么"这个话题,推到了最值得聊的位置。本文不吹不黑,只讲对写代码的开发者真正相关的部分。
FrontierMath 是 Epoch AI 在 2024 年底推出的数学基准,特点是三句话:研究生级、防作弊、需要原创推理。
它和普通的"高考题自动答题"完全不是一回事:
- 题目是数学研究者原创的,网上找不到答案,杜绝了"背题";
- 很多题没有标准套路,需要真正的推导演绎;
- Tier 4 是最高档,题目难度接近专业数学研究本身。
正因为它这么难,过去两年它一直被当成"AGI 数学推理的试金石"。现在 Astra 把这道最后的墙也推平了,意味着:在"解出已知数学问题"这件事上,最强模型已经摸到人类顶尖水平的天花板。
别只盯着"数学家慌不慌",咱写代码的人其实更该关心它带来的工程红利:
1. 算法与数值计算的提效
以前你要手推一个递推公式、验证一个数值方法的收敛性,现在可以直接让模型把推导过程铺开,再拿去代码里跑验证。建模、仿真、量化这类强数学场景受益最直接。
2. 形式化验证的助攻
数学推理强了,意味着模型更擅长帮你写带证明性质的规约、检查边界条件。对安全敏感的系统(支付、权限、并发)这是实打实的帮助。
3. 自动化的"猜想—验证"闭环
研究级推理 + 代码执行,能让 Agent 自己提出假设、写程序验证、再根据结果修正。这比单纯"补全代码"高一个维度。
25 位数学家的联名信核心不是"AI 太强了",而是:AI 批量生产结论的速度,可能快过人类验证的速度。这对开发者是个清醒提醒——
- 模型说"这个推导是对的",不等于真的对。工程里必须自己跑测试、做边界检查;
- "暴力解题"和"真理解"是两回事。模型可能给你一个看起来完美的答案,逻辑链却站不住;
- 把 AI 当协作者(我提假设、它来算、我来验证)比当权威(它说啥我信啥)安全得多。
一句话:能力越强,越要把最终判断权留在自己手里。
具体到日常:
- 解数学/算法难题、做数值推导,直接上最强推理模型(Astra 这类),让它把过程写出来;
- 但涉及上线、涉及钱、涉及安全的结论,一定自己验证一遍;
- 把 AI 当"永远在线的助教",而不是"不会犯错的专家"。
数学能力饱和是里程碑,但"会用"和"盲信"之间差着一条生产事故的距离。
你最想让 AI 帮你解哪类数学或算法问题?是数值计算、公式推导、还是代码里的边界证明? 评论区聊聊你卡过的坑,我把高频场景整理成一份"AI 数学辅助的正确打开方式"发出来。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号