DolphinDB 时序相似检索实战:从波形匹配到诊断案例库
原创
DolphinDB 时序相似检索实战:从波形匹配到诊断案例库
原创
User_芊芊君子
发布于 2026-09-13 17:41:29
发布于 2026-09-13 17:41:29
摘要
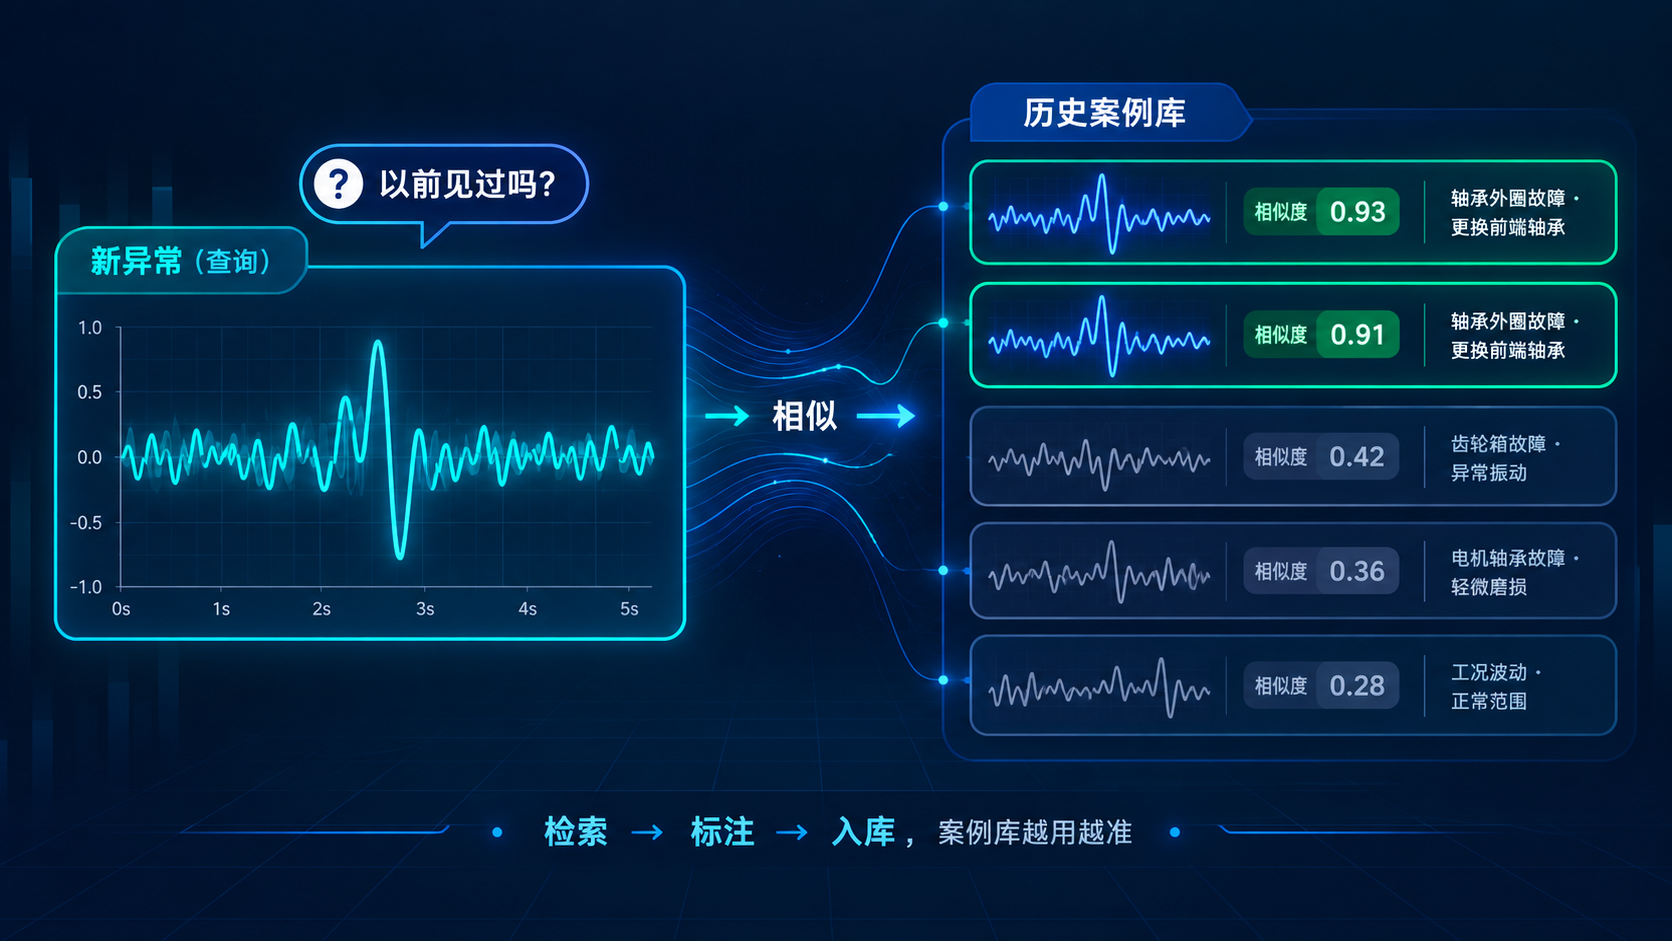
工业现场出异常时,工程师的第一句话往往不是"快算频谱",而是——"这个以前见过吗?"
如果见过,问题基本就解决了一半:上次是什么原因、怎么处理的、换了什么件,照方抓药。这些经验存在于哪里?大部分在老师傅的脑子里、在车间的聊天记录里、在几份没人再翻的故障报告里。老师傅休假,经验就暂时不可用;老师傅离职,经验就永久流失。
而这些经验其实有一个天然的载体——历史数据本身。每一次异常的波形都存在库里,缺的只是两样东西:一是把"找相似"变成一个可执行的查询而不是人肉翻曲线;二是把诊断结论和处理措施挂到数据上沉淀下来,让下一次异常能自动检索到。
本文用 DolphinDB 实现这套能力:事件片段的提取与归一化、相似度的计算方法(相关系数/欧氏距离/DTW)、两级检索的 SQL 实现、以及"检索→标注→入库"的案例库闭环。核心思路不复杂:波形先变成可比的向量,再用"粗筛 + 精排"两级检索找到历史相似案例——把组织记忆从人脑搬进数据库。
一、"找相似"的价值:从个人经验到组织记忆
先把这个需求的价值说透,再谈实现。
1.1 诊断经验正在以三种方式流失
- 随人流失:诊断能力突出的往往集中在少数几个人,他们的经验没有载体,人走经验走
- 随时间模糊:半年前处理过类似的抖动,但"类似"到什么程度、当时波形长什么样,记忆不可靠
- 沉没在记录里:有故障报告,但报告是文本,没法拿当前波形去"搜"一段文字
三种流失的共同根因:经验和数据没有连在一起。波形躺在时序库里,结论躺在文档里,中间没有桥。
1.2 案例库的工作流
补上这座桥之后,日常的工作流变成这样:
新异常发生
    │
    ▼
提取事件片段 ──▶ 相似性检索 ──▶ 命中:复用诊断结论和处理措施
    │                              │
    │                              ▼
    │                         (确认无误,直接处置)
    ▼
未命中 ──▶ 人工诊断 ──▶ 处置 ──▶ 入库(波形特征 + 结论 + 措施)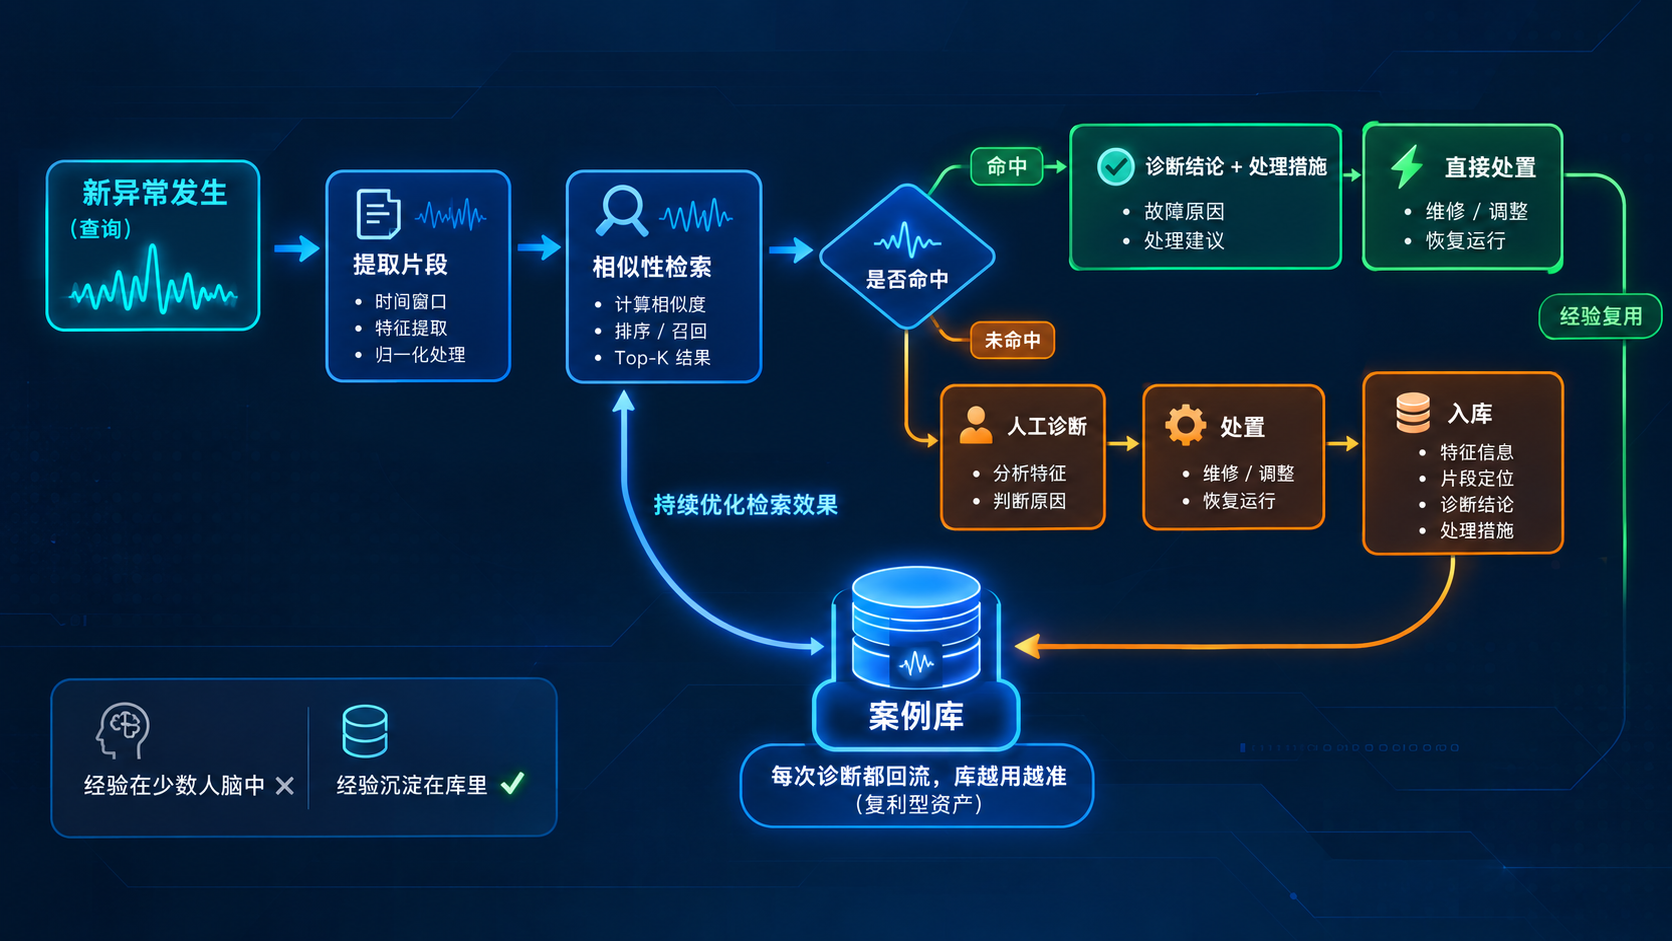
用得越久,库越全,命中越多,诊断越快——这是一个复利型资产:第一天没什么用,一年后新人也能像老工程师一样"记得"每一次历史异常。
二、先把波形变成可比的:片段提取与归一化
相似性检索的地基,是让两段波形处在"可比"的状态。原始数据直接比是不行的,要先过三道处理。
2.1 事件片段提取:从告警点回溯
异常发生时,有价值的不是全天数据,而是告警时刻附近的一段。以告警时间戳为锚点,向前回溯一段固定时长(比如 60 秒):
// 从告警点回溯 60 秒的原始片段
seg = select ts, rms
      from loadTable("dfs://iot", "vibration_rms")
      where deviceId = "PUMP-007"
        and ts between (datetime(2026.03.15 03:15:00) - 60) : datetime(2026.03.15 03:15:00)
回溯长度要覆盖"异常发展全过程"——太短只有故障瞬间,太长混入大量正常段,都会稀释相似性信号。振动类异常 60 秒通常够,具体看故障发展节奏。
2.2 重采样:把片段对齐到固定长度
两段不同设备、不同采样状态的片段,点数大概率不一样——而长度不一的序列没法直接算相似度。解决方法是重采样到固定点数:把片段按时间均分成 N 个桶,每桶取均值,得到定长序列:
// 重采样到固定 120 点:60 秒均分成 120 个 500ms 桶
resampled = select avg(rms) as v
            from loadTable("dfs://iot", "vibration_rms")
            where deviceId = "PUMP-007"
              and ts between (datetime(2026.03.15 03:15:00) - 60) : datetime(2026.03.15 03:15:00)
            group by bar(ts, 500)
bar(ts, 500) 把时间戳按 500 毫秒对齐分桶,avg 取桶内均值。不管原始是 10 点还是 6000 点,出来都是约 120 个点。
2.3 归一化:去掉幅值和量纲,只留形状
不同设备的振动基准不同:A 泵正常 RMS 在 0.5,B 泵在 2.0。直接比数值,幅值差异会淹没形状差异——而诊断经验恰恰主要藏在形状里(突发型?渐进型?周期性脉冲?)。
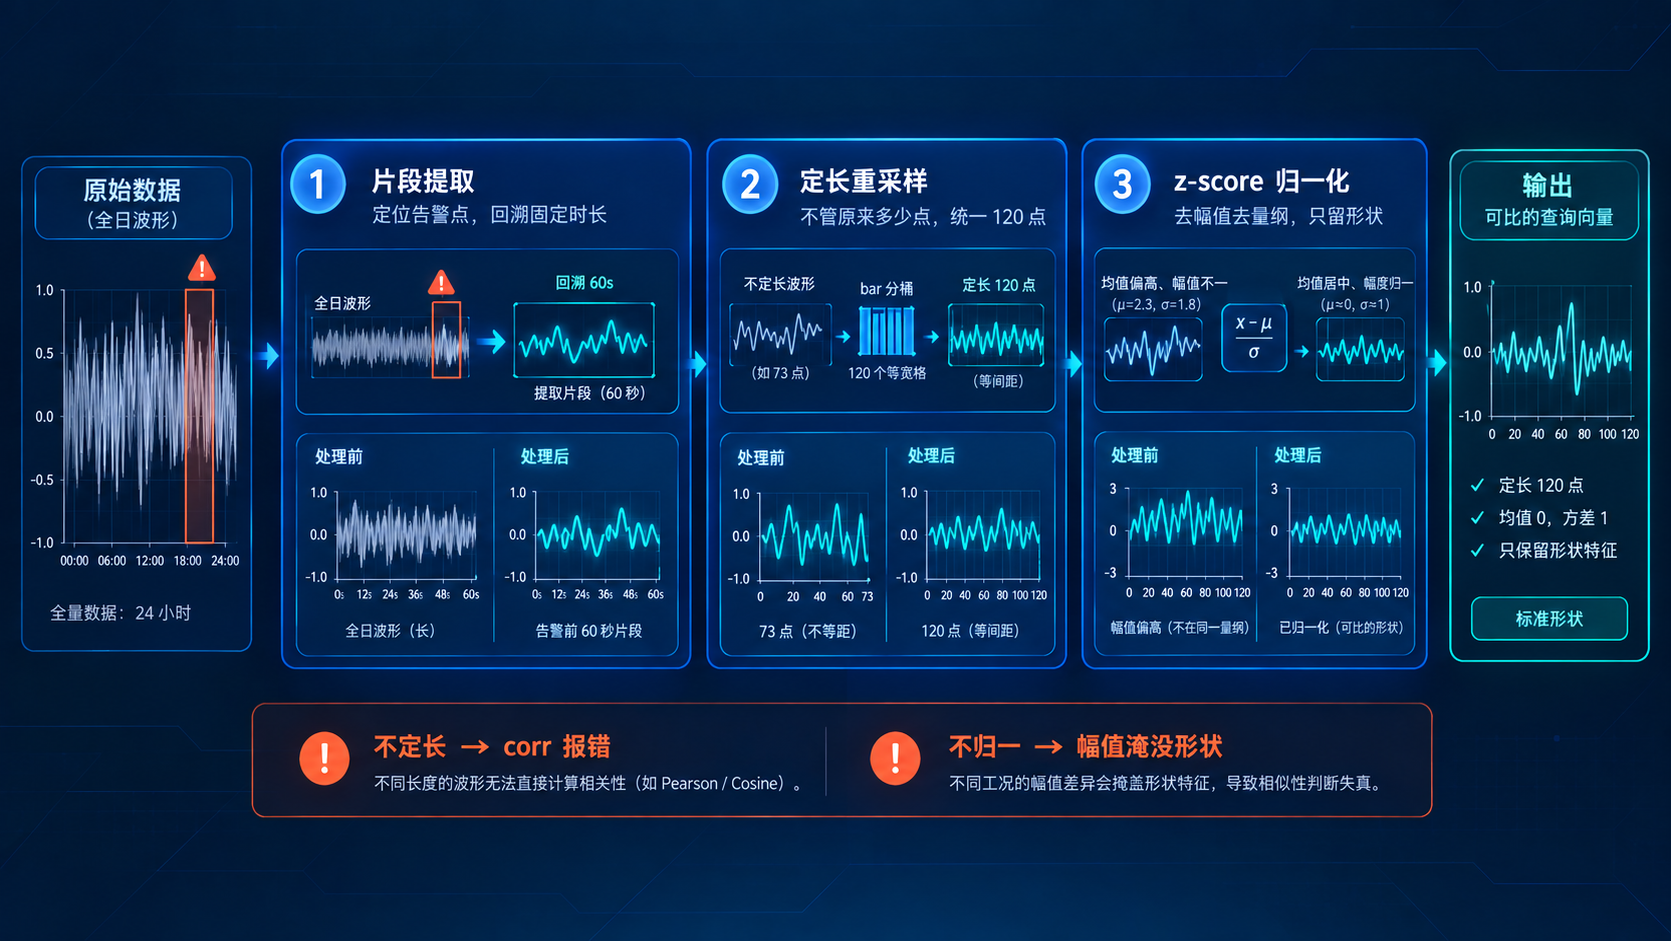
z-score 归一化把每段波形变换成"以自身均值为零点、自身波动为单位"——即对每个点做 (v − 均值) / 标准差——幅值信息抹掉,形状保留。DolphinDB 把这个常用变换封装成了内置函数 zscore,一行完成:
// z-score 归一化:内置函数,等价于 (v - avg(v)) \ std(v)(同为样本标准差)
normalized = select zscore(v) as v from resampled到这里,任何异常片段都变成了一段定长、去量纲、只含形状的序列——可比了。
三、相似度的三把尺子
波形可比之后,"像不像"需要一个量化标准。常用的有三把尺子,各有分工。
3.1 相关系数:形状相似性(主力)
皮尔逊相关系数衡量两段序列的形状一致度,取值 -1 到 1:接近 1 表示同涨同跌形状几乎一致,0 表示无关。
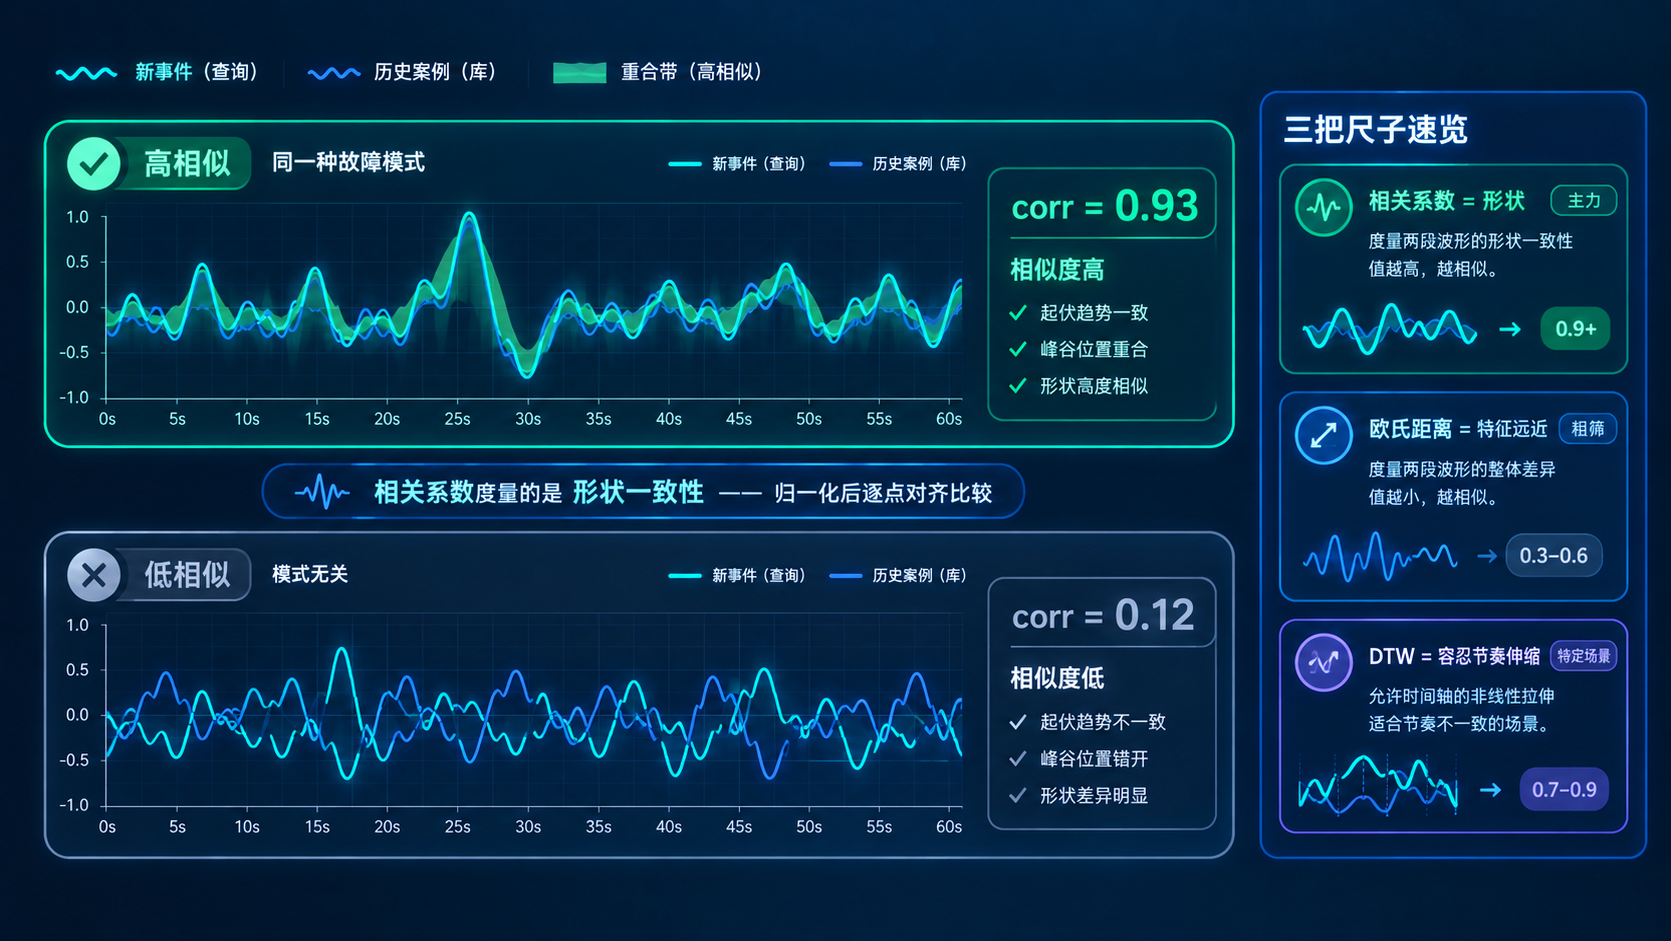
它对幅值天然不敏感(我们在归一化后计算,双重保险),最契合"这两次故障是不是同一种模式"的判断。DolphinDB 内置 corr 函数:
corr(newSeg`v, oldSeg`v) // 两段归一化序列的形状相似度3.2 欧氏距离:特征空间的距离(粗筛用)
除了整段波形,每个事件还可以提取一组标量特征(均值水平、峰值因子、峭度、主频……)——峭度 kurtosis、偏度 skew、频谱 fft,DolphinDB 都有内置函数,特征提取同样是几行 SQL 的事。特征之间的欧氏距离衡量两个事件在"特征空间"里的远近,计算量小——适合先在整库上快速粗筛。
// 特征距离:每个特征先做 z-score 标准化(去量纲),再算平方和开根号
sqrt(pow(f1 - q1, 2) + pow(f2 - q2, 2) + pow(f3 - q3, 2))
3.3 DTW:容忍时间轴伸缩的匹配(概念)
相关系数要求两段波形严格逐点对齐。但有些故障模式会出现"形状一样、节奏不同"——比如同样的冲击群,A 设备 3 秒内出现 5 次,B 设备拉长到 5 秒。逐点对齐的相关系数会把这种相似判低。
DTW(Dynamic Time Warping,动态时间规整)允许时间轴非线性伸缩后再匹配,能抓住"节奏不同、模式相同"的相似。代价是计算量大得多,且容易把不相似的也"扭"出高分。工程上的务实做法:先用相关系数覆盖大多数场景,DTW 作为特定故障模式(变转速设备、间歇性冲击)的补充,不作为默认。
四、两级检索的 SQL 实现(核心)
单独用哪把尺子都不理想:全库逐个算相关系数太慢,只算特征距离不够准。工程解法是两级检索:特征距离粗筛全库,相关系数精排前几十名。
4.1 案例库表设计
先设计案例库——每条历史案例一行,存特征、片段定位和诊断结论:
// 案例库:特征列(入库时已标准化)+ 片段定位 + 诊断与处置
dbCase = database("dfs://iot_case", VALUE, 2026.01.01..2026.12.31)
caseSchema = table(1:0,
    `caseId`deviceId`eventTs`f_rmsStd`f_crest`f_kurtosis`f_peakFreq`diagConclusion`actionTaken,
    [LONG, SYMBOL, DATETIME, DOUBLE, DOUBLE, DOUBLE, DOUBLE, SYMBOL, STRING])
dbCase.createPartitionedTable(caseSchema, "caseLib", `eventTs)
设计要点:
- 特征列存标量(标准化后的值),粗筛是纯标量运算,整库扫一遍也很快
eventTs+deviceId是片段的定位符——原始波形不复制进案例库,精排时按定位符回原始表取,避免数据冗余diagConclusion和actionTaken是经验的载体——检索的终点不是"找到了相似波形",而是"上次怎么处理的"
4.2 第一级:特征距离粗筛
新异常来了,先算它的特征,然后在整库上算距离、取前 20:
// 新事件标准化后的特征: f_rmsStd=-0.3, f_crest=1.2, f_kurtosis=0.8, f_peakFreq=-0.5
candidates = select caseId, deviceId, eventTs, diagConclusion, actionTaken,
    sqrt(pow(f_rmsStd - (-0.3), 2) + pow(f_crest - 1.2, 2)
       + pow(f_kurtosis - 0.8, 2) + pow(f_peakFreq - (-0.5), 2)) as featDist
from loadTable("dfs://iot_case", "caseLib")
order by featDist
limit 20
这一步是标准的 SQL 向量化运算,几十万条案例也就是秒级的事。特征选择建议用有物理含义的指标(峰值因子、峭度、主频)而不是原始数值——它们对转速、负载变化的抗干扰性好,粗筛不容易把真正相似的筛掉。
4.3 第二级:相关系数精排
对粗筛出的 20 个候选,按 deviceId + eventTs 回原始表取片段,走第二节的"重采样 + 归一化"流程,再逐个算相关系数:
// 片段处理函数(第二节的三道工序收成一个函数)
def extractNormSeg(device, eventTs, lookbackSec, n) {
    span = (lookbackSec * 1000) \ n
    seg = select avg(rms) as v
          from loadTable("dfs://iot", "vibration_rms")
          where deviceId = device
            and ts between (eventTs - lookbackSec) : eventTs
          group by bar(ts, span)
    return select zscore(v) as v from seg
}

// 新事件片段(先提出来,循环外算一次)
newSeg = extractNormSeg("PUMP-007", datetime(2026.03.15 03:15:00), 60, 120)

// 对 20 个候选逐个精排
scored = select caseId, deviceId, eventTs, diagConclusion,
             corr(newSeg`v, extractNormSeg(deviceId, eventTs, 60, 120)`v) as shapeSim
       from candidates

// 形状相似度排序,取前 5 展示
top5 = select * from scored where shapeSim > 0.85 order by shapeSim desc limit 5
shapeSim > 0.85 是经验阈值:0.85 以上基本可确认"同一种模式",0.7~0.85 值得人工比对,0.7 以下参考价值有限。阈值要结合自己数据的噪声水平校准。
4.4 检索结果的呈现
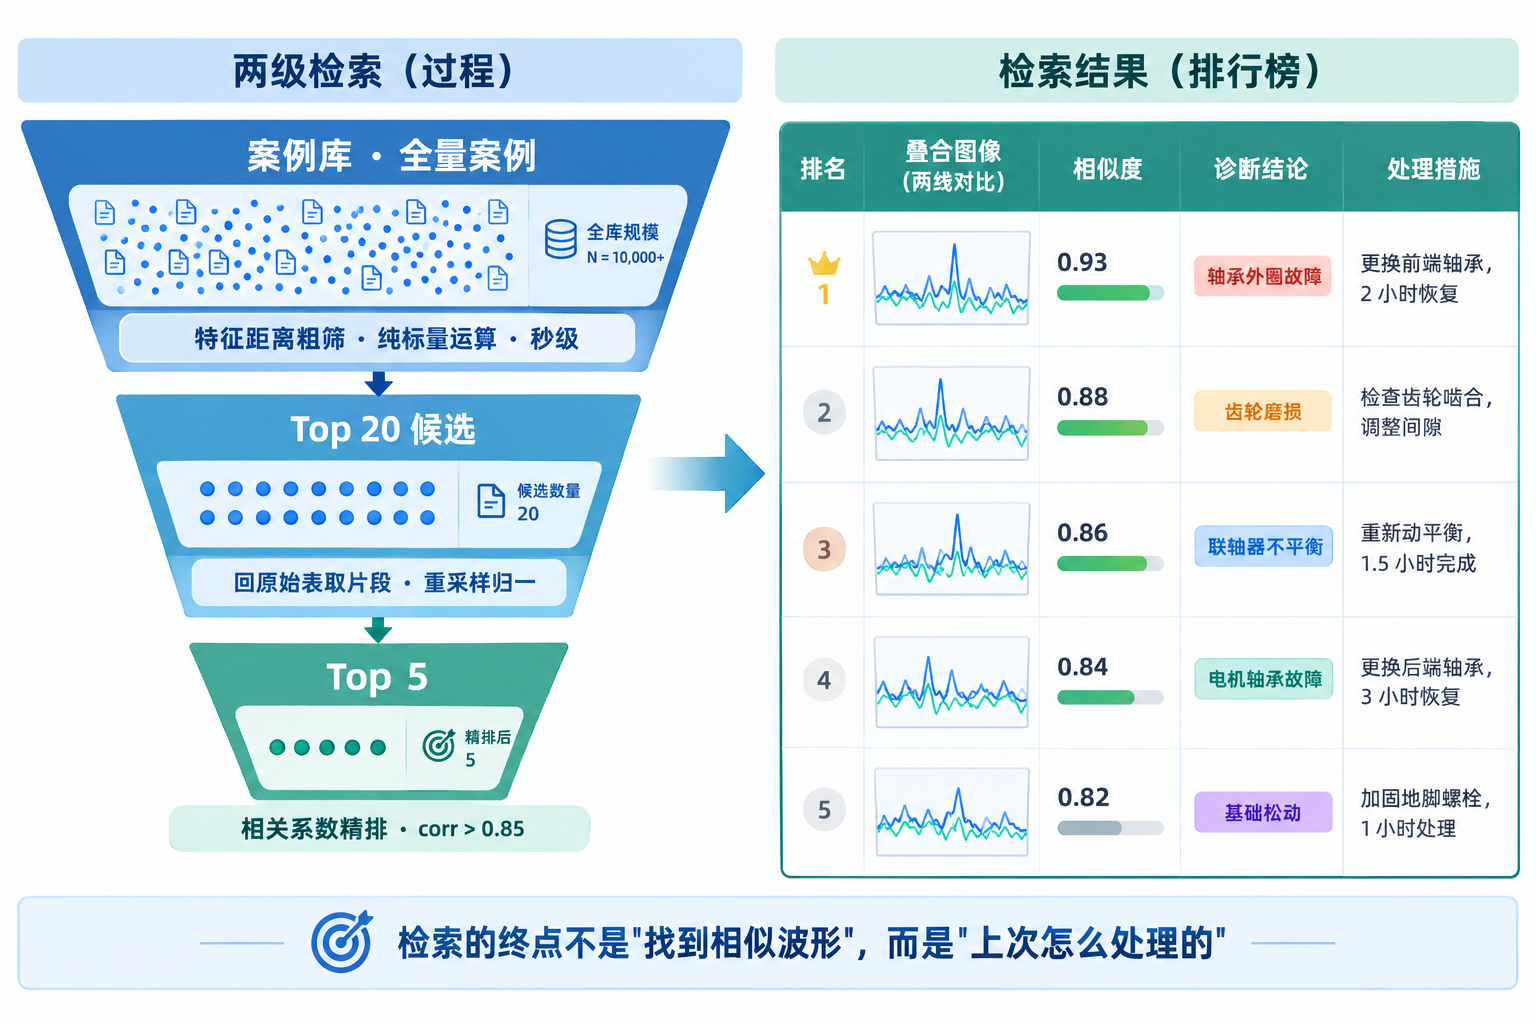
最终交给工程师的是这样一张表:相似案例 + 上次的诊断结论 + 上次的处理措施 + 相似度。它的价值不在算法多精巧,在于把"问老师傅"变成了"查库"——而且老师傅每次的结论都留在库里,不会休假,不会离职。
五、把检索做成闭环:检索→标注→入库
检索只解决"命中"的情况。让案例库持续增值,靠闭环。
5.1 未命中→诊断→入库
新异常检索不到相似案例,走人工诊断。诊断处置完成后,把这次事件入库——特征算好、片段定位、结论措施写全:
def archiveCase(device, eventTs, conclusion, action) {
    // 特征提取:滑动窗口时域特征(kurtosis、skew 等)+ 频谱主频(fft)——内置函数,常规计算,略
    // 入库
    loadTable("dfs://iot_case", "caseLib").tableInsert(
        table(rand(long(1e9), 1) as caseId, tableObject...)
    )
}入库的关键纪律是结论质量:diagConclusion 用受控词表(轴承外圈故障 / 不对中 / 松动……)而不是自由文本——自由文本检索出来了也聚合不了,受控词表才能支撑后续按故障类型统计。
5.2 冷启动:历史告警批量入库
案例库第一天是空的。冷启动的办法是把历史告警记录批量过一遍:每条历史告警按 eventTs 提取片段、算特征入库;有故障报告的对着报告补结论,没有的先标 UNKNOWN 入库——至少波形特征可比了,结论慢慢补。
一个运行了两三年的平台,历史告警里往往藏着几百个现成案例,冷启动并不需要等新故障发生。
5.3 反馈修正
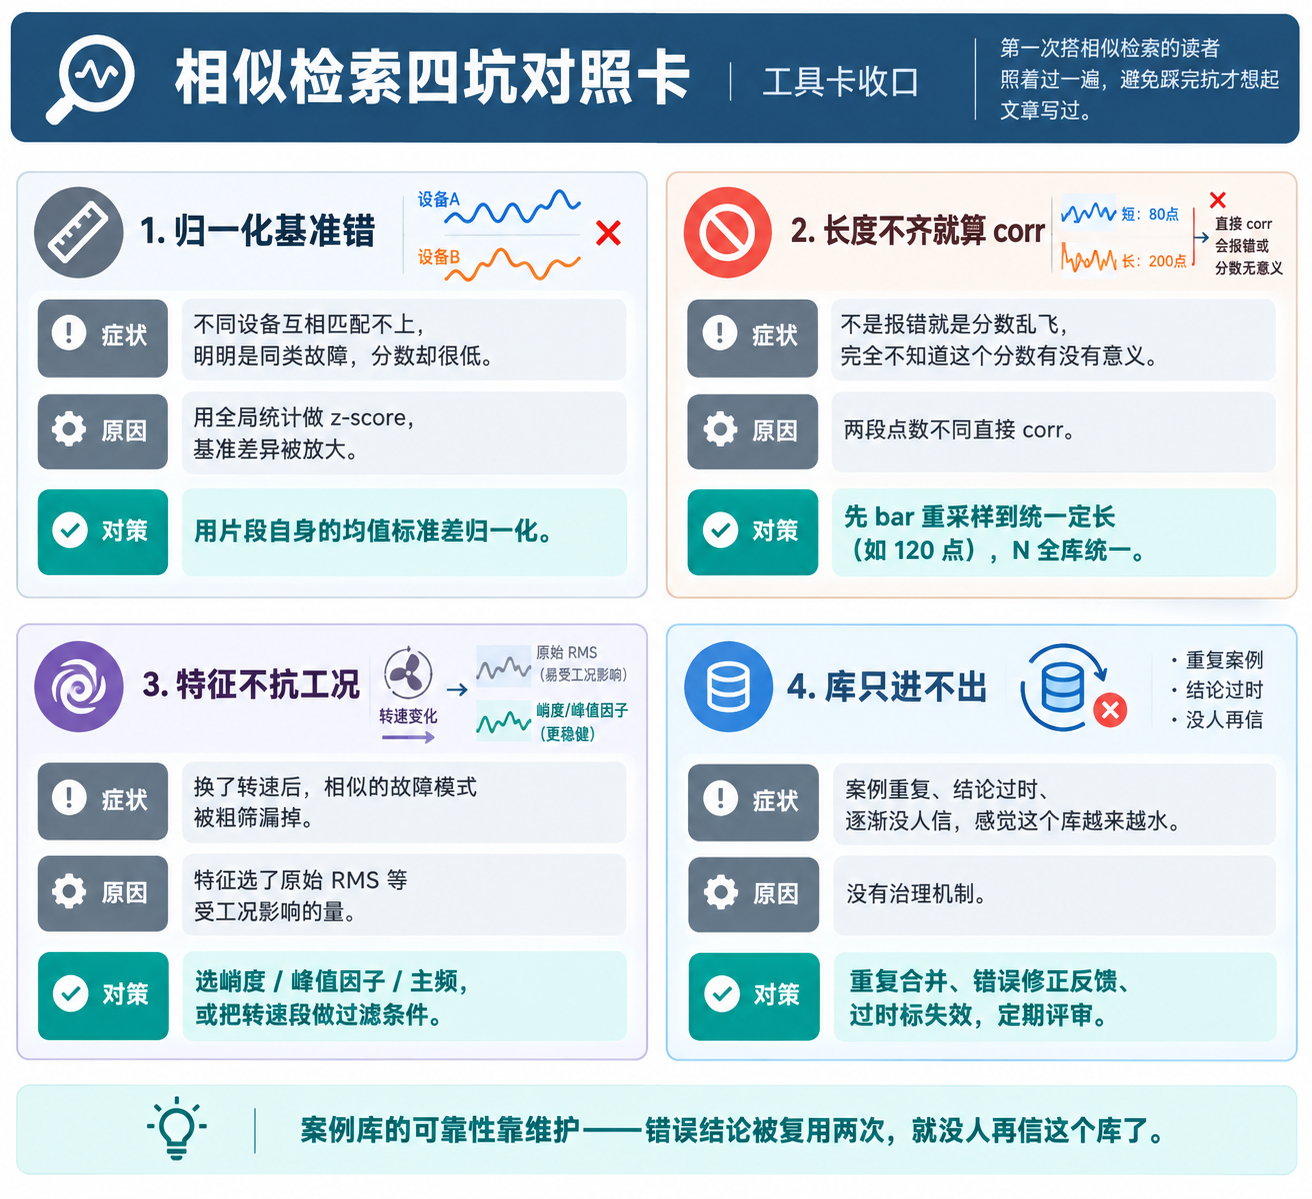
检索命中但结论错了(现场处置发现上次诊断不对),要更新案例记录而不是只改脑子。案例库的可靠性靠这个维护——错误结论被检索复用两次,工程师就不再信这个库了。
六、工程细节与坑
6.1 归一化基准:设备自身,不是全局
z-score 用片段自身的均值和标准差(第二节的做法),不要用全厂全局统计——全局基准会把"高振动设备"和"低振动设备"的正常差异放大成形状差异,干扰匹配。先用自身归一化抹掉基准差异,让形状说话。
6.2 定长重采样是相关系数的前提
忘了重采样直接 corr,两段长度不同的序列会直接报错或得到无意义的值。任何进精排的片段,先过"定长 N 点"这道工序,N 固定统一(比如都用 120),不同 N 的序列之间依然不可比。
6.3 粗筛的特征要"抗工况"
转速、负载变化会改变波形的数值特征。粗筛特征如果选了受工况影响大的(比如原始 RMS 均值),换工况的相似模式会被筛掉。优先选相对稳定的形态类特征:峭度(冲击敏感性)、峰值因子(冲击/均值比)、主频(转速归一化后)。必要时把工况标签(转速段)作为粗筛的过滤条件。
6.4 案例库也要治理
库会随时间膨胀出三类问题:重复案例(同一故障多次入库,可合并)、错误结论(靠反馈修正)、过时结论(设备改造后旧案例不再适用,要标记失效)。定期(比如每季度)做一次案例评审,比让库烂掉再重建便宜得多。
七、写在最后
工业数据平台做了很多"向前看"的事:实时告警、趋势预测、健康评分。这篇做的是一件"向后看"的事——借用 DolphinDB 把历史经验变成可检索的资产。
技术上,整条链路没有一个复杂算法:片段提取是普通查询,重采样是 bar 分桶,归一化是内置 zscore,粗筛是特征距离,精排是 corr。组合起来,解决的却是工业现场持续了几十年的问题——诊断经验跟着人走。
四个收尾要点:
- 可比性优先:定长重采样 + 自身归一化,是相似检索能工作的地基
- 两级检索:特征距离粗筛全库,相关系数精排前几十,快和准兼得
- 闭环增值:检索→标注→入库→反馈修正,案例库是复利型资产
- 结论受控:诊断用受控词表,库才聚合得动、统计得出东西
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号