人工盯屏时代落幕,Agent 重构油田厂级生产监控体系
原创
人工盯屏时代落幕,Agent 重构油田厂级生产监控体系
原创
大盘鸡拌面
发布于 2026-09-13 21:08:06
发布于 2026-09-13 21:08:06
第一次进油田中控室的时候,我脑子里的想法是:这不就是电影里 NASA 的发射指挥中心吗?满墙的大屏,几十路视频监控画面,几百个数据点位在跳。但待了三天之后我就明白了一件事——这地方最累的不是机器,是人。
这篇文章聊聊我们这一年多在西北某采油厂做的事:把一套靠人盯屏的生产监控系统,改造成 Agent 驱动的自动化监控体系。有思路、有代码、有踩坑,尽量把"油田信息化"这层神秘面纱给掀了。
一、老中控室的日常:先说说痛点到底在哪
先给不了解油田生产的同学补个背景。
一个采油厂下面管着几百口油井,绝大部分是抽油机井——就是你在电影里看到的那个"磕头机",一头驴头一上一下地抽。每口井的数据(载荷、位移、电流、油压、套压)通过井口的 RTU 传回中控室。此外还有计量站、联合站、注水站这些站场,加起来监控点位轻松上万。
传统模式是这样的:
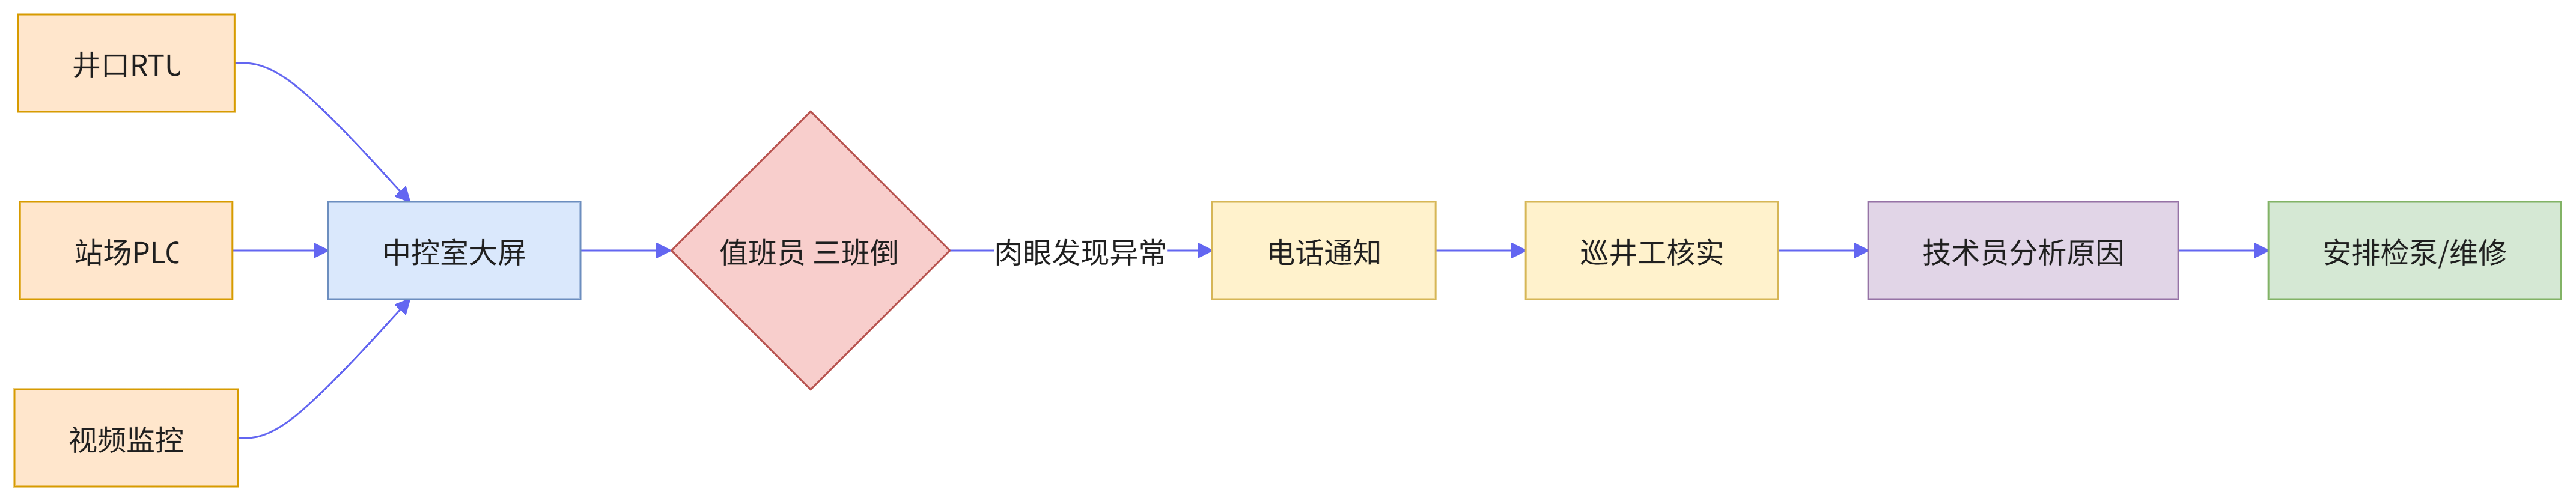
这套流程跑了几十年,问题在哪?
第一,人盯不过来。 一面墙的大屏,值班员一个人看几十路视频 + 上千个数据点。人的注意力撑死集中 20 分钟,剩下的时间就是"瞄一眼没爆红就行"。真出了缓变故障——比如泵效慢慢下降——大屏上根本不会有红色告警,等发现的时候产量已经掉了一周了。
第二,报警泛滥。 一口井停了,载荷、电流、位移十几条报警同时弹出来。一阵风刮过导致视频晃动,也是一片告警。值班员练就了"告警免疫",真正的故障反而被淹没在噪音里。
第三,诊断全靠老师傅。 屏幕上看到示功图不对,是凡尔漏了还是杆断?这得靠干了二十年的老师傅看图。老师傅一退休,经验直接断档。
第四,闭环太慢。 从发现异常到检泵作业队上井,中间隔着电话确认、派单、排队,平均 48 小时起。这期间产量损失都是真金白银。
二、改造思路:把"眼睛、大脑、手脚"都交给 Agent
我们的核心思路是:不是把大屏做得更好看,而是让系统自己会看、会想、会干活。
用多 Agent 架构来拆解这件事:
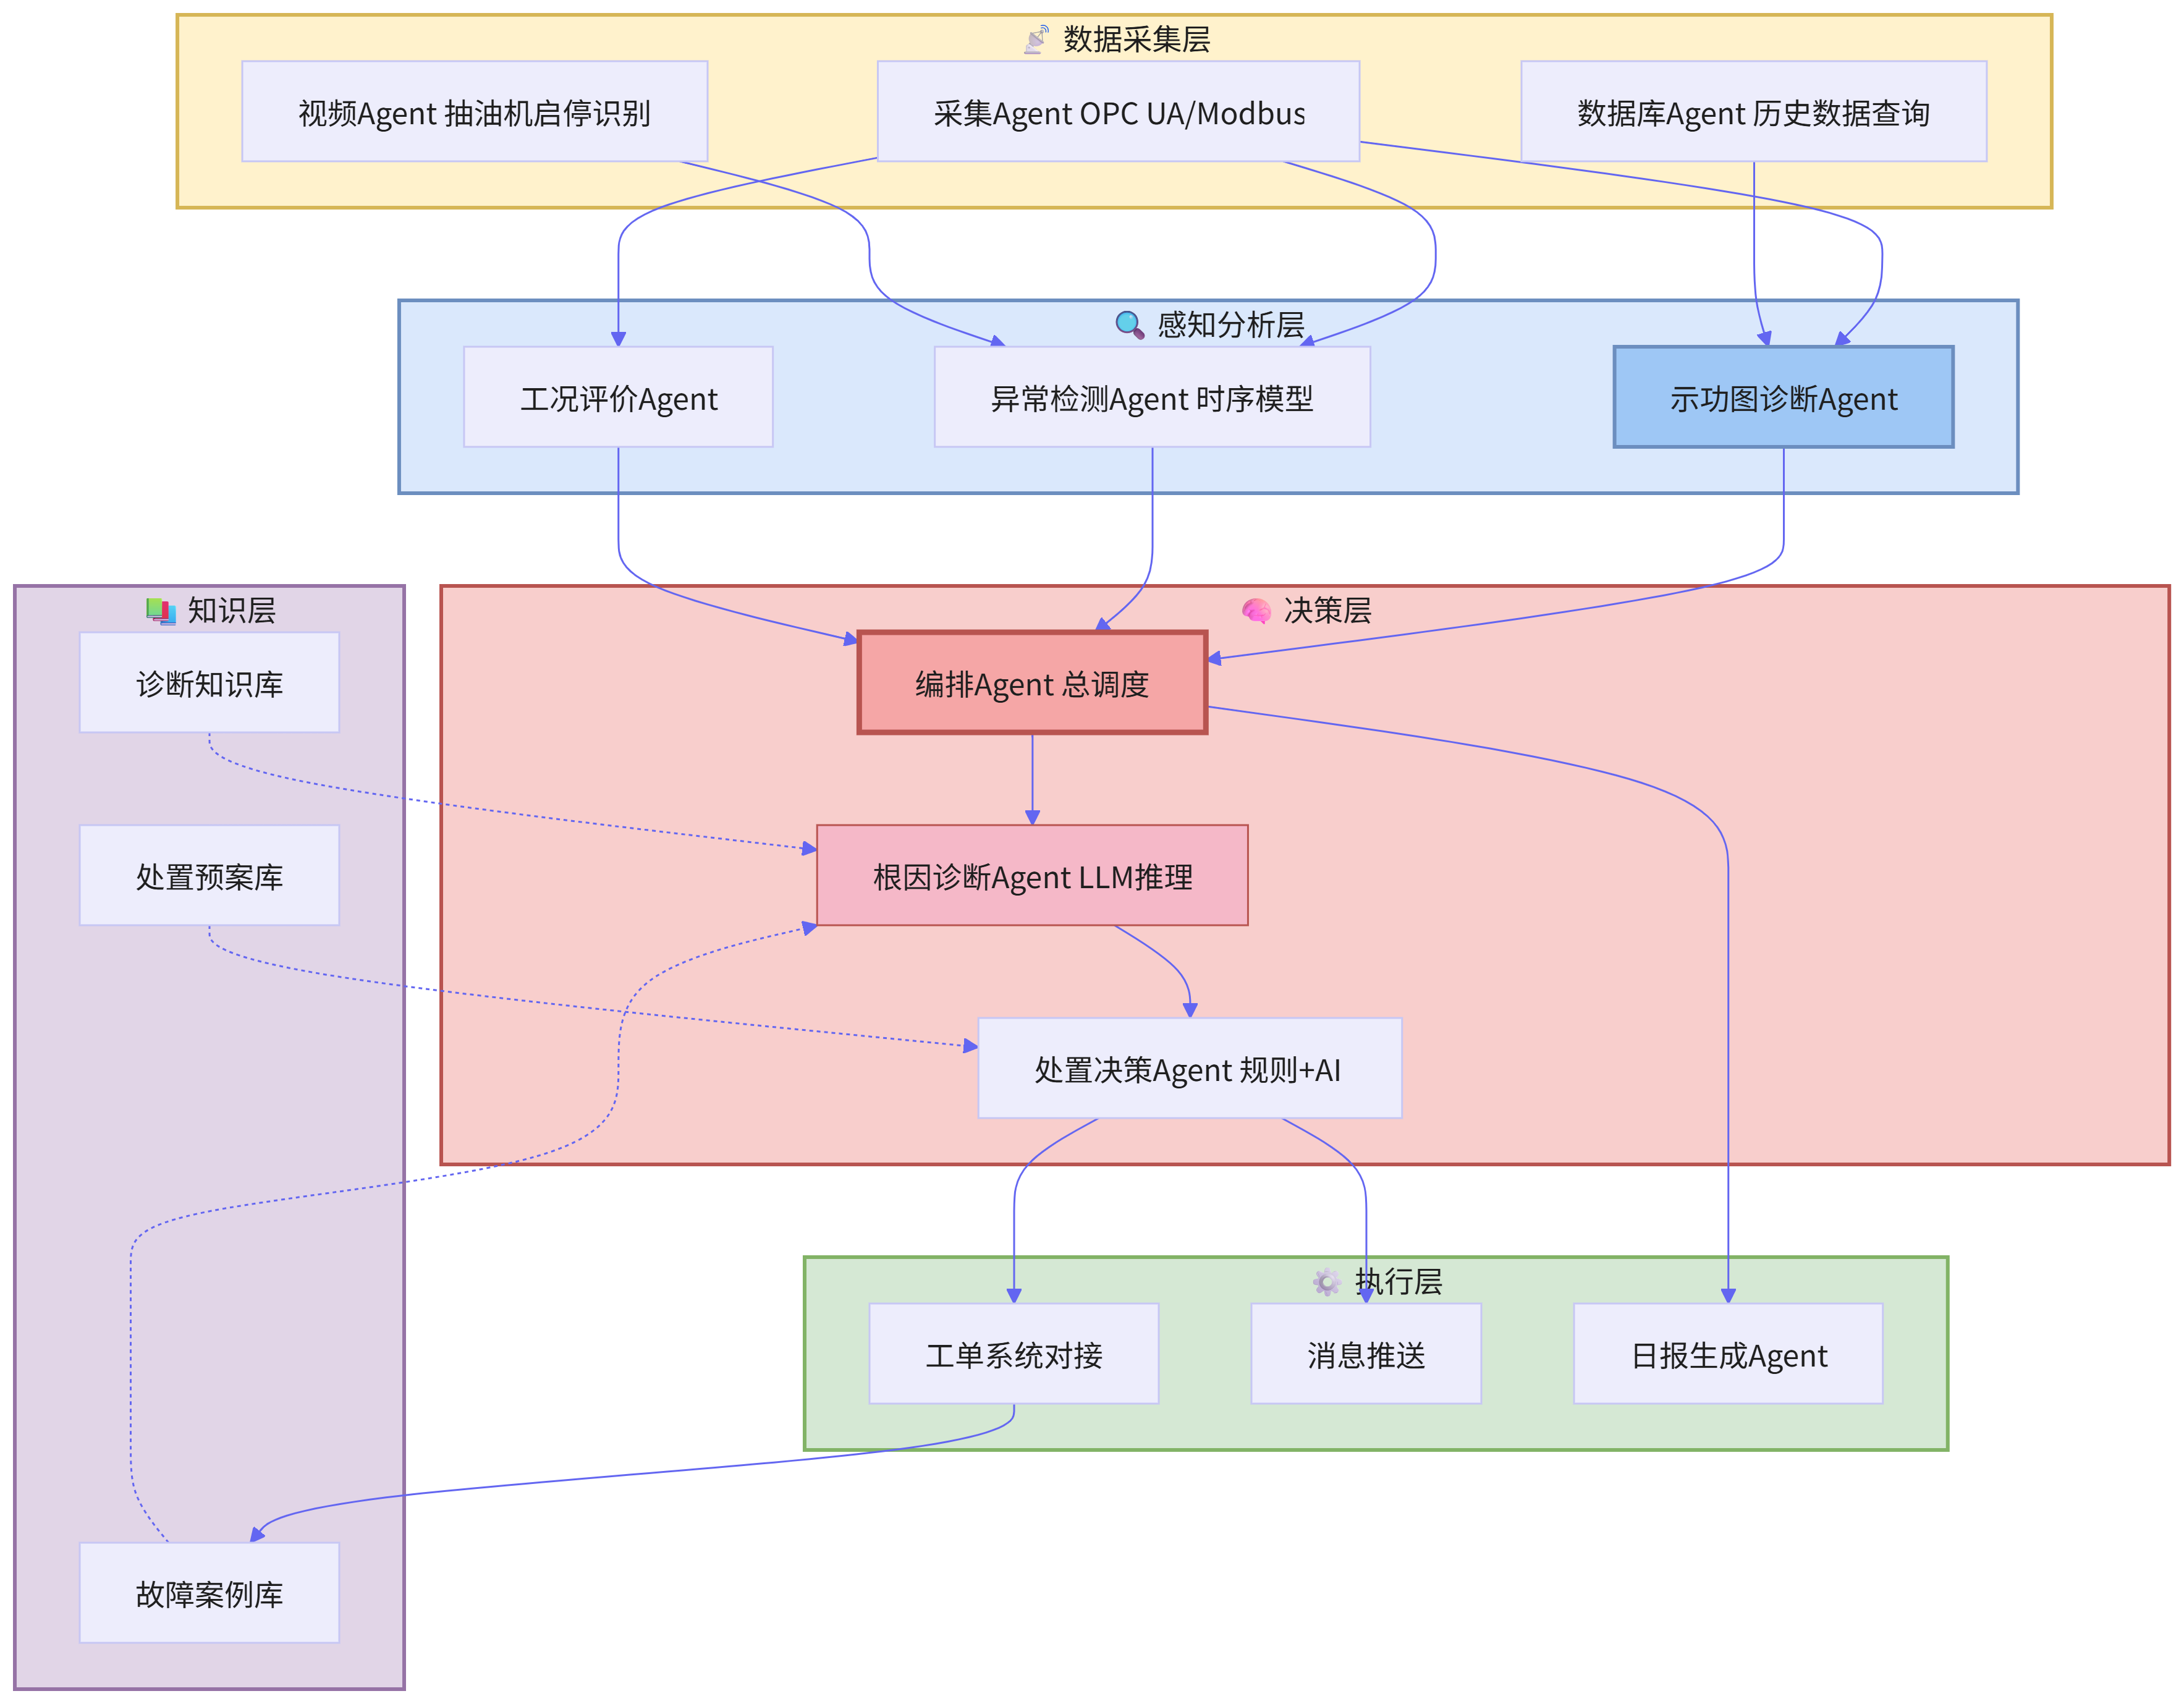
简单解释一下分工:
- 采集 Agent:跟井场设备打交道,OPC UA、Modbus 协议拉数据,坏了自动重连;
- 示功图诊断 Agent:抽油机井的"心电图医生",专门看示功图判断井下泵况;
- 异常检测 Agent:跑时序模型,抓缓变异常(这是人眼最不擅长的);
- 根因诊断 Agent:大模型 + 知识库,把各种数据线索拼起来推根因;
- 编排 Agent:总指挥,决定什么时候叫谁干活;
- 日报 Agent:每天自动写生产日报。
这个架构跑起来之后,中控室的角色就变了——从"人盯屏"变成"Agent 干活、人管 Agent"。
三、场景一:示功图智能诊断——老师傅的经验数字化
这是整个项目里技术含量最高的一块,也是油井监控的核心。
先科普一下:示功图是抽油机悬点载荷和位移的关系曲线,一个冲程画一个封闭圈。泵况好的时候是个饱满的"平行四边形";泵漏了、杆断了、气锁了,图形会出现各种畸变。老师傅就是靠看这些畸变的形状来判断井下的毛病的。
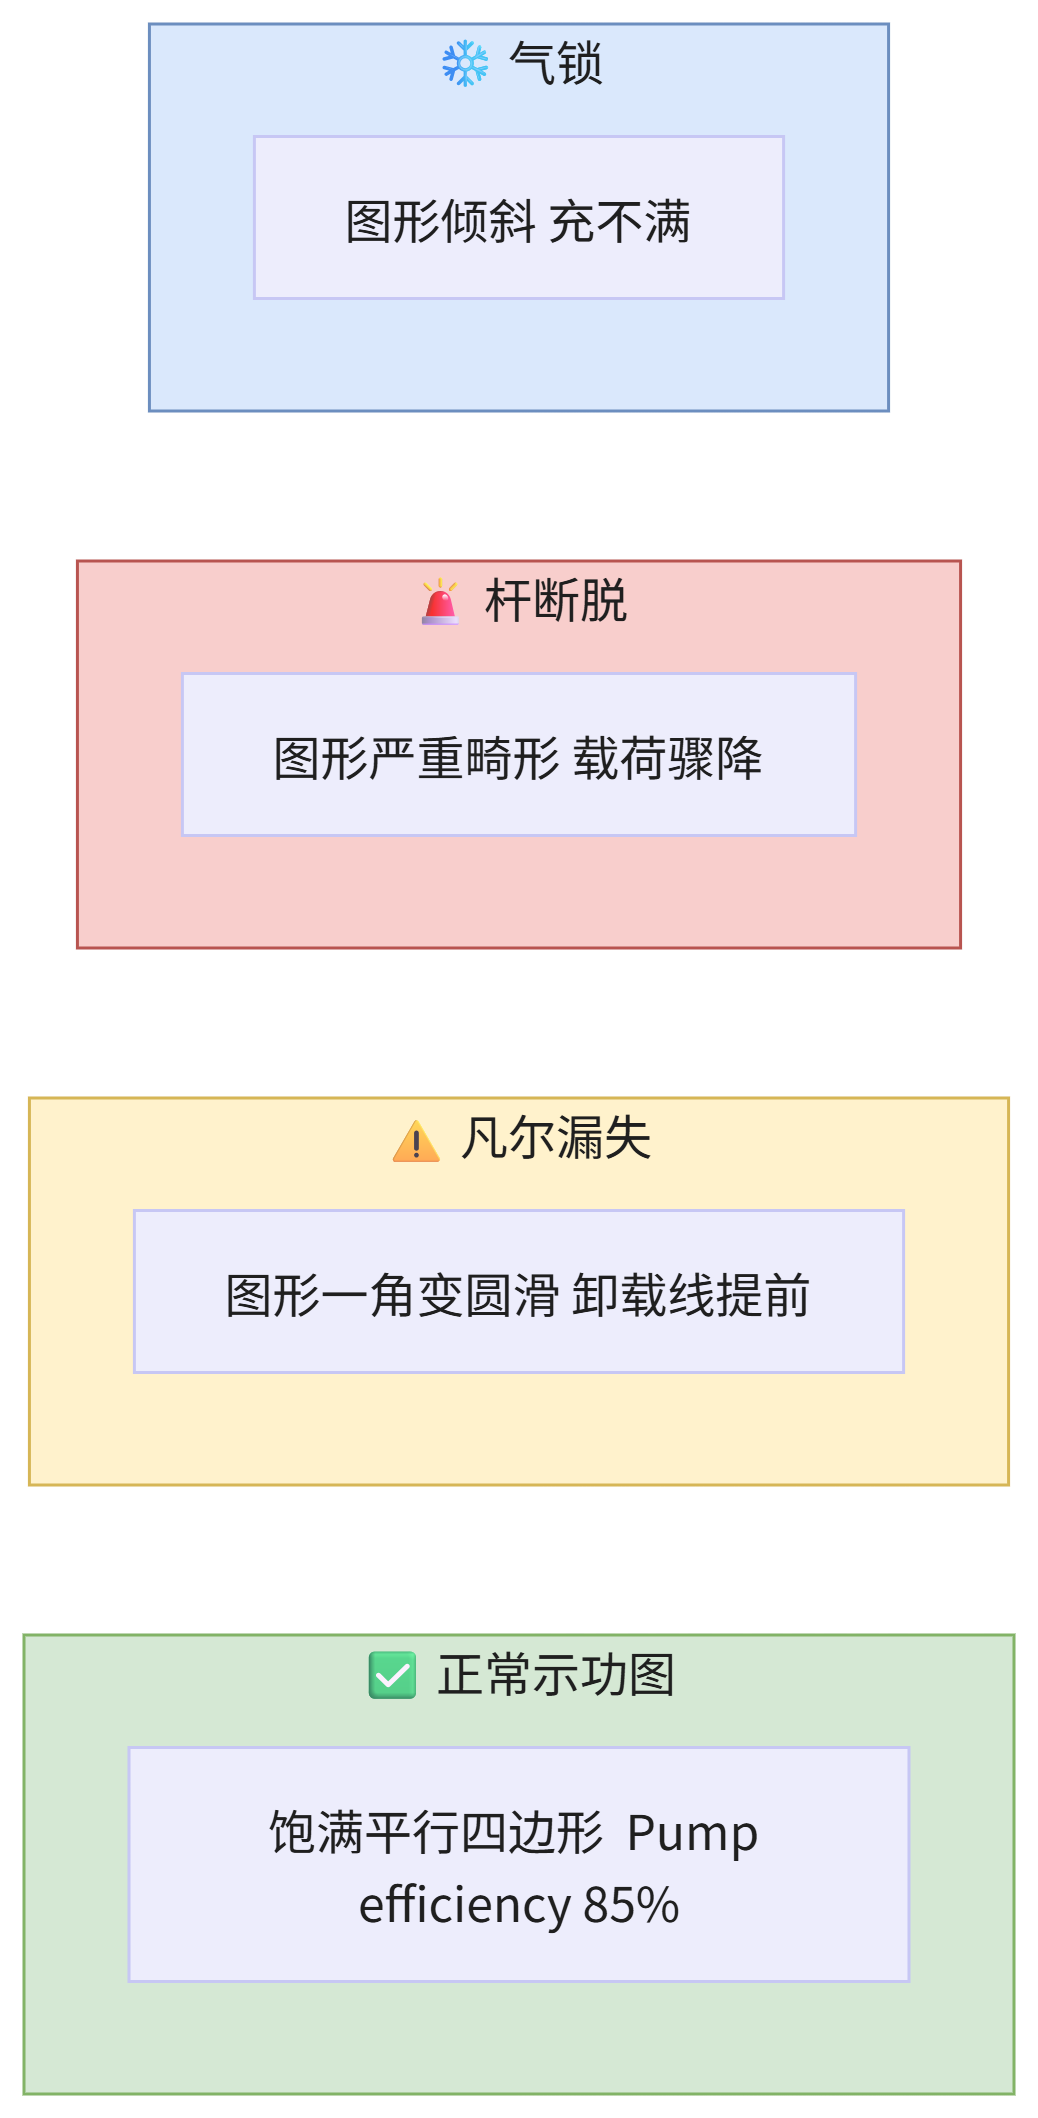
以前这些判断全在老师傅脑子里。我们的做法分两步:先用算法把图形特征提出来,再让大模型结合特征 + 井史数据做综合诊断。
import numpy as np
import json
import requests
from dataclasses import dataclass

@dataclass
class PumpDiagnosis:
    """泵况诊断结果"""
    well_id: str
    condition: str        # 正常/凡尔漏失/杆断/气锁/供液不足
    confidence: float     # 置信度
    evidence: list        # 诊断依据
    recommendation: str   # 处置建议
    urgency: str          # 紧急程度

class DynamometerCardAnalyzer:
    """示功图分析 Agent:特征提取 + AI 综合诊断"""

    def extract_features(self, load_data, displacement_data):
        """
        从示功图原始数据提取几何特征
        load_data: 悬点载荷序列 (kN)
        displacement_data: 悬点位移序列 (m)
        """
        load_arr = np.array(load_data)
        disp_arr = np.array(displacement_data)

        features = {}

        # 1. 基础载荷特征
        features["max_load"] = float(load_arr.max())
        features["min_load"] = float(load_arr.min())
        features["load_ratio"] = float(load_arr.min() / load_arr.max())

        # 2. 示功图面积(功的度量)——饱满程度
        #    用多边形面积公式计算封闭曲线围成的面积
        features["card_area"] = float(
            0.5 * abs(np.sum(
                load_arr[:-1] * disp_arr[1:]
                - load_arr[1:] * disp_arr[:-1]
            ))
        )

        # 3. 理论面积 vs 实际面积 → 泵效近似
        stroke = disp_arr.max() - disp_arr.min()
        theoretical_area = (load_arr.max() - load_arr.min()) * stroke
        features["area_fullness"] = float(
            features["card_area"] / theoretical_area
            if theoretical_area > 0 else 0
        )

        # 4. 上冲程/下冲程载荷变化斜率(检测凡尔漏失的关键)
        up_stroke = load_arr[:len(load_arr)//2]
        down_stroke = load_arr[len(load_arr)//2:]
        features["up_slope"] = float(np.polyfit(
            range(len(up_stroke)), up_stroke, 1)[0])
        features["down_slope"] = float(np.polyfit(
            range(len(down_stroke)), down_stroke, 1)[0])

        # 5. 图形畸变度:实际图形和标准平行四边形的偏差
        #    畸变度越大,井下问题越严重
        corners = self._detect_corners(load_arr, disp_arr)
        features["distortion"] = float(self._calc_distortion(corners))

        return features

    def _detect_corners(self, load, disp):
        """检测示功图的四个特征角点"""
        # 简化处理:实际项目用曲率检测算法
        max_idx = int(np.argmax(load))
        min_idx = int(np.argmin(load))
        return {"max_load_idx": max_idx, "min_load_idx": min_idx}

    def _calc_distortion(self, corners):
        """计算图形畸变度"""
        return 0.0  # 实际实现较复杂,这里省略

    def diagnose_with_ai(self, well_id, features, well_history):
        """调用大模型做综合诊断"""

        # 故障知识库(精简版,实际有几百条案例)
        fault_kb = {
            "凡尔漏失": "载荷比异常、图形角部圆滑、卸载线提前,"
                       "泵效持续下降,常伴随沉没度下降",
            "杆断脱": "载荷骤降、图形严重畸形、电流下降明显,"
                     "光杆功率下降超过50%",
            "气锁": "图形倾斜、充液不足、动液面高但泵效低,"
                   "套压异常升高",
            "供液不足": "图形呈现"刀把"状、泵效低、动液面深",
        }

        prompt = f"""你是抽油机井故障诊断专家,请根据以下数据判断泵况。

井号: {well_id}

示功图特征数据:
{json.dumps(features, ensure_ascii=False, indent=2)}

该井近期历史:
{json.dumps(well_history, ensure_ascii=False)}

故障知识库:
{json.dumps(fault_kb, ensure_ascii=False)}

请输出 JSON:
{{
  "condition": "正常/凡尔漏失/杆断/气锁/供液不足",
  "confidence": 0.0-1.0,
  "evidence": ["判断依据1", "判断依据2"],
  "recommendation": "处置建议",
  "urgency": "紧急/重要/一般"
}}

注意:
1. 必须基于特征数据推理,不能凭空猜测
2. 如果特征之间有矛盾,在 evidence 里说明
3. 置信度低于 0.7 时建议安排现场核实"""

        response = requests.post(
            "http://localhost:8000/v1/chat/completions",
            json={
                "model": "qwen2.5-32b",
                "messages": [{"role": "user", "content": prompt}],
                "temperature": 0.1,
            },
            timeout=60
        )
        return json.loads(response.json()["choices"][0]["message"]["content"])


# ===== 实战运行:诊断一口疑似凡尔漏失的井 =====
analyzer = DynamometerCardAnalyzer()

# 某井最近一次采集的示功图数据(简化示意)
load_data = [45.2, 52.1, 58.3, 61.0, 60.2, 55.8, 48.3, 42.1,
             38.5, 36.2, 35.8, 36.5, 38.9, 41.2, 44.6, 45.0]
disp_data = [0.0, 0.45, 1.02, 1.98, 2.95, 3.42, 3.50, 3.48,
             3.10, 2.55, 1.88, 1.10, 0.52, 0.08, 0.01, 0.0]

well_history = {
    "泵效趋势": [0.82, 0.79, 0.74, 0.68, 0.61],  # 近5次,持续下降
    "沉没度": "320m(上月450m,持续下降)",
    "上次检泵": "428天前",
    "产液量趋势": "15.2 → 11.8 t/d(近一个月下降22%)"
}

# Step 1: 提取特征
features = analyzer.extract_features(load_data, disp_data)
print("示功图特征:", json.dumps(features, indent=2))
# 输出示例:
# {
#   "max_load": 61.0, "min_load": 35.8,
#   "load_ratio": 0.587,           # 偏低(正常 >0.65)
#   "card_area": 88.4,
#   "area_fullness": 0.71,          # 图形欠饱满
#   "up_slope": 2.28, "down_slope": -1.66,
#   "distortion": 0.34
# }

# Step 2: AI 综合诊断
diagnosis = analyzer.diagnose_with_ai("W-2173", features, well_history)
print(json.dumps(diagnosis, ensure_ascii=False, indent=2))

# AI 输出示例:
# {
#   "condition": "凡尔漏失",
#   "confidence": 0.87,
#   "evidence": [
#     "载荷比 0.587 低于正常阈值 0.65,卸载过程异常",
#     "泵效从 82% 连续降至 61%,呈渐进性下降特征",
#     "沉没度从 450m 降至 320m,泵效下降与凡尔漏失特征吻合",
#     "图形饱满度 0.71,角部有圆滑趋势",
#     "检泵周期 428 天,接近该区块平均检泵周期上限"
#   ],
#   "recommendation": "建议2周内安排检泵作业,优先更换泵筒总成;"
#                    "期间加密示功图监测频次至每日2次",
#   "urgency": "重要"
# }这套东西上线之后最直接的效果:老师傅的经验被沉淀下来了。以前老师傅看图全凭感觉,说不清为什么但就是准。现在知识库里每个故障类型都有明确的特征定义,新来的技术员照着 Agent 的诊断依据也能学。这不是替代老师傅,是把老师傅的脑子"开源"了。
四、场景二:异常检测——抓住人眼看不见的缓变故障
示功图诊断是"定点深挖",但还有一种故障人眼根本看不出来:缓变异常。比如电机温度每天涨 0.5 度、泵效每天掉 0.5%,单看每一天都"正常",拉到 30 天尺度看就是一条不归路。
这种活儿交给时序异常检测 Agent,它不下班、不眨眼:
import numpy as np
from collections import deque
from dataclasses import dataclass
from datetime import datetime

@dataclass
class AnomalyEvent:
    """异常事件"""
    target_id: str        # 井号/设备号
    metric: str           # 异常指标
    anomaly_type: str     # 突变/缓变/离群
    severity: str         # critical/warning/info
    trend_desc: str       # 趋势描述
    detected_at: datetime

class SlowDriftDetector:
    """
    缓变异常检测 Agent
    核心思路:单点看正常,趋势看不正常
    用滑动窗口 + 线性回归检测持续性漂移
    """

    def __init__(self, window_days=30, min_days=14, drift_threshold=0.6):
        self.window = window_days      # 观察 30 天
        self.min_days = min_days       # 漂移至少持续 14 天才算
        self.drift_threshold = drift_threshold  # 趋势强度阈值
        self.metric_history = {}       # {target_id: {metric: deque}}

    def ingest(self, target_id, metric, value, timestamp=None):
        """喂数据:每天一次即可"""
        if target_id not in self.metric_history:
            self.metric_history[target_id] = {}
        if metric not in self.metric_history[target_id]:
            self.metric_history[target_id][metric] = deque(maxlen=self.window)

        self.metric_history[target_id][metric].append({
            "ts": timestamp or datetime.now(),
            "value": value
        })

    def detect(self, target_id, metric):
        """检测指定指标的缓变异常"""
        history = list(
            self.metric_history.get(target_id, {}).get(metric, []))

        if len(history) < self.min_days:
            return None  # 数据不够,先攒着

        values = np.array([h["value"] for h in history])
        days = np.arange(len(values))

        # 线性回归拟合趋势
        slope, intercept = np.polyfit(days, values, 1)

        # 计算趋势显著性:斜率相对于波动幅度
        residuals = values - (slope * days + intercept)
        std = np.std(residuals) if len(residuals) > 1 else 1

        # 趋势强度:30 天累计变化 / 波动幅度
        total_drift = slope * len(values)
        drift_ratio = abs(total_drift) / (std * 3) if std > 0 else 0

        if drift_ratio < self.drift_threshold:
            return None

        # 判断漂移方向和业务含义
        trend_desc = self._describe_trend(
            metric, slope, values[0], values[-1])

        return AnomalyEvent(
            target_id=target_id,
            metric=metric,
            anomaly_type="缓变",
            severity=self._assess_severity(metric, drift_ratio),
            trend_desc=trend_desc,
            detected_at=datetime.now()
        )

    def _describe_trend(self, metric, slope, start_val, end_val):
        """把数学趋势翻译成人话"""
        change = end_val - start_val
        direction = "上升" if slope > 0 else "下降"

        metric_desc = {
            "pump_efficiency": f"泵效 {start_val:.0%} → {end_val:.0%},"
                             f"持续{direction}",
            "motor_temp": f"电机温度 {start_val:.0f}°C → {end_val:.0f}°C,"
                         f"持续{direction}",
            "liquid_production": f"日产液 {start_val:.1f} → {end_val:.1f} t,"
                               f"持续{direction}",
        }
        return metric_desc.get(
            metric, f"{metric}: {start_val:.1f} → {end_val:.1f},持续{direction}")

    def _assess_severity(self, metric, drift_ratio):
        """评估严重程度"""
        critical_metrics = {"motor_temp"}  # 温度持续上涨必须重视
        if metric in critical_metrics and drift_ratio > 1.0:
            return "critical"
        if drift_ratio > 0.8:
            return "warning"
        return "info"


# ===== 实战:抓到一个隐藏的电机老化问题 =====
detector = SlowDriftDetector(window_days=30, min_days=14)

# W-3091 井电机温度:每天涨 0.3-0.5 度,肉眼看每天都是"正常范围"
simulated_temps = [
    62.1, 62.4, 62.2, 62.8, 62.6, 63.1, 62.9, 63.3, 63.0, 63.5,
    63.8, 63.4, 63.9, 64.1, 63.7, 64.4, 64.0, 64.6, 64.3, 64.8,
    65.1, 64.7, 65.3, 65.0, 65.6, 65.2, 65.8, 65.5, 66.0, 65.7
]

for i, temp in enumerate(simulated_temps):
    detector.ingest("W-3091", "motor_temp", temp)

event = detector.detect("W-3091", "motor_temp")
if event:
    print(f"检测到缓变异常!")
    print(f"  井号: {event.target_id}")
    print(f"  指标: {event.metric}")
    print(f"  类型: {event.anomaly_type}")
    print(f"  描述: {event.trend_desc}")
    print(f"  严重度: {event.severity}")

# 输出:
# 检测到缓变异常!
#   井号: W-3091
#   指标: motor_temp
#   类型: 缓变
#   描述: 电机温度 62°C → 66°C,持续上升
#   严重度: critical
#
# 后续处置:现场检查发现电机散热风扇轴承磨损,
# 转速不足导致散热效率下降。更换风扇后温度回落。
# 如果没抓到,再过一个月大概率电机烧毁 → 停井 → 产量损失
这种故障以前怎么发现的?要么等电机烧了跳闸报警,要么老师傅巡井时摸一下电机"哎这怎么烫手"。现在 Agent 天天算趋势,比人敏感得多。
五、场景三:诊断 + 处置的全自动闭环
发现异常只是第一步,真正的价值在闭环——从发现到派单到反馈,中间不落地。
这是整个系统的时序图:
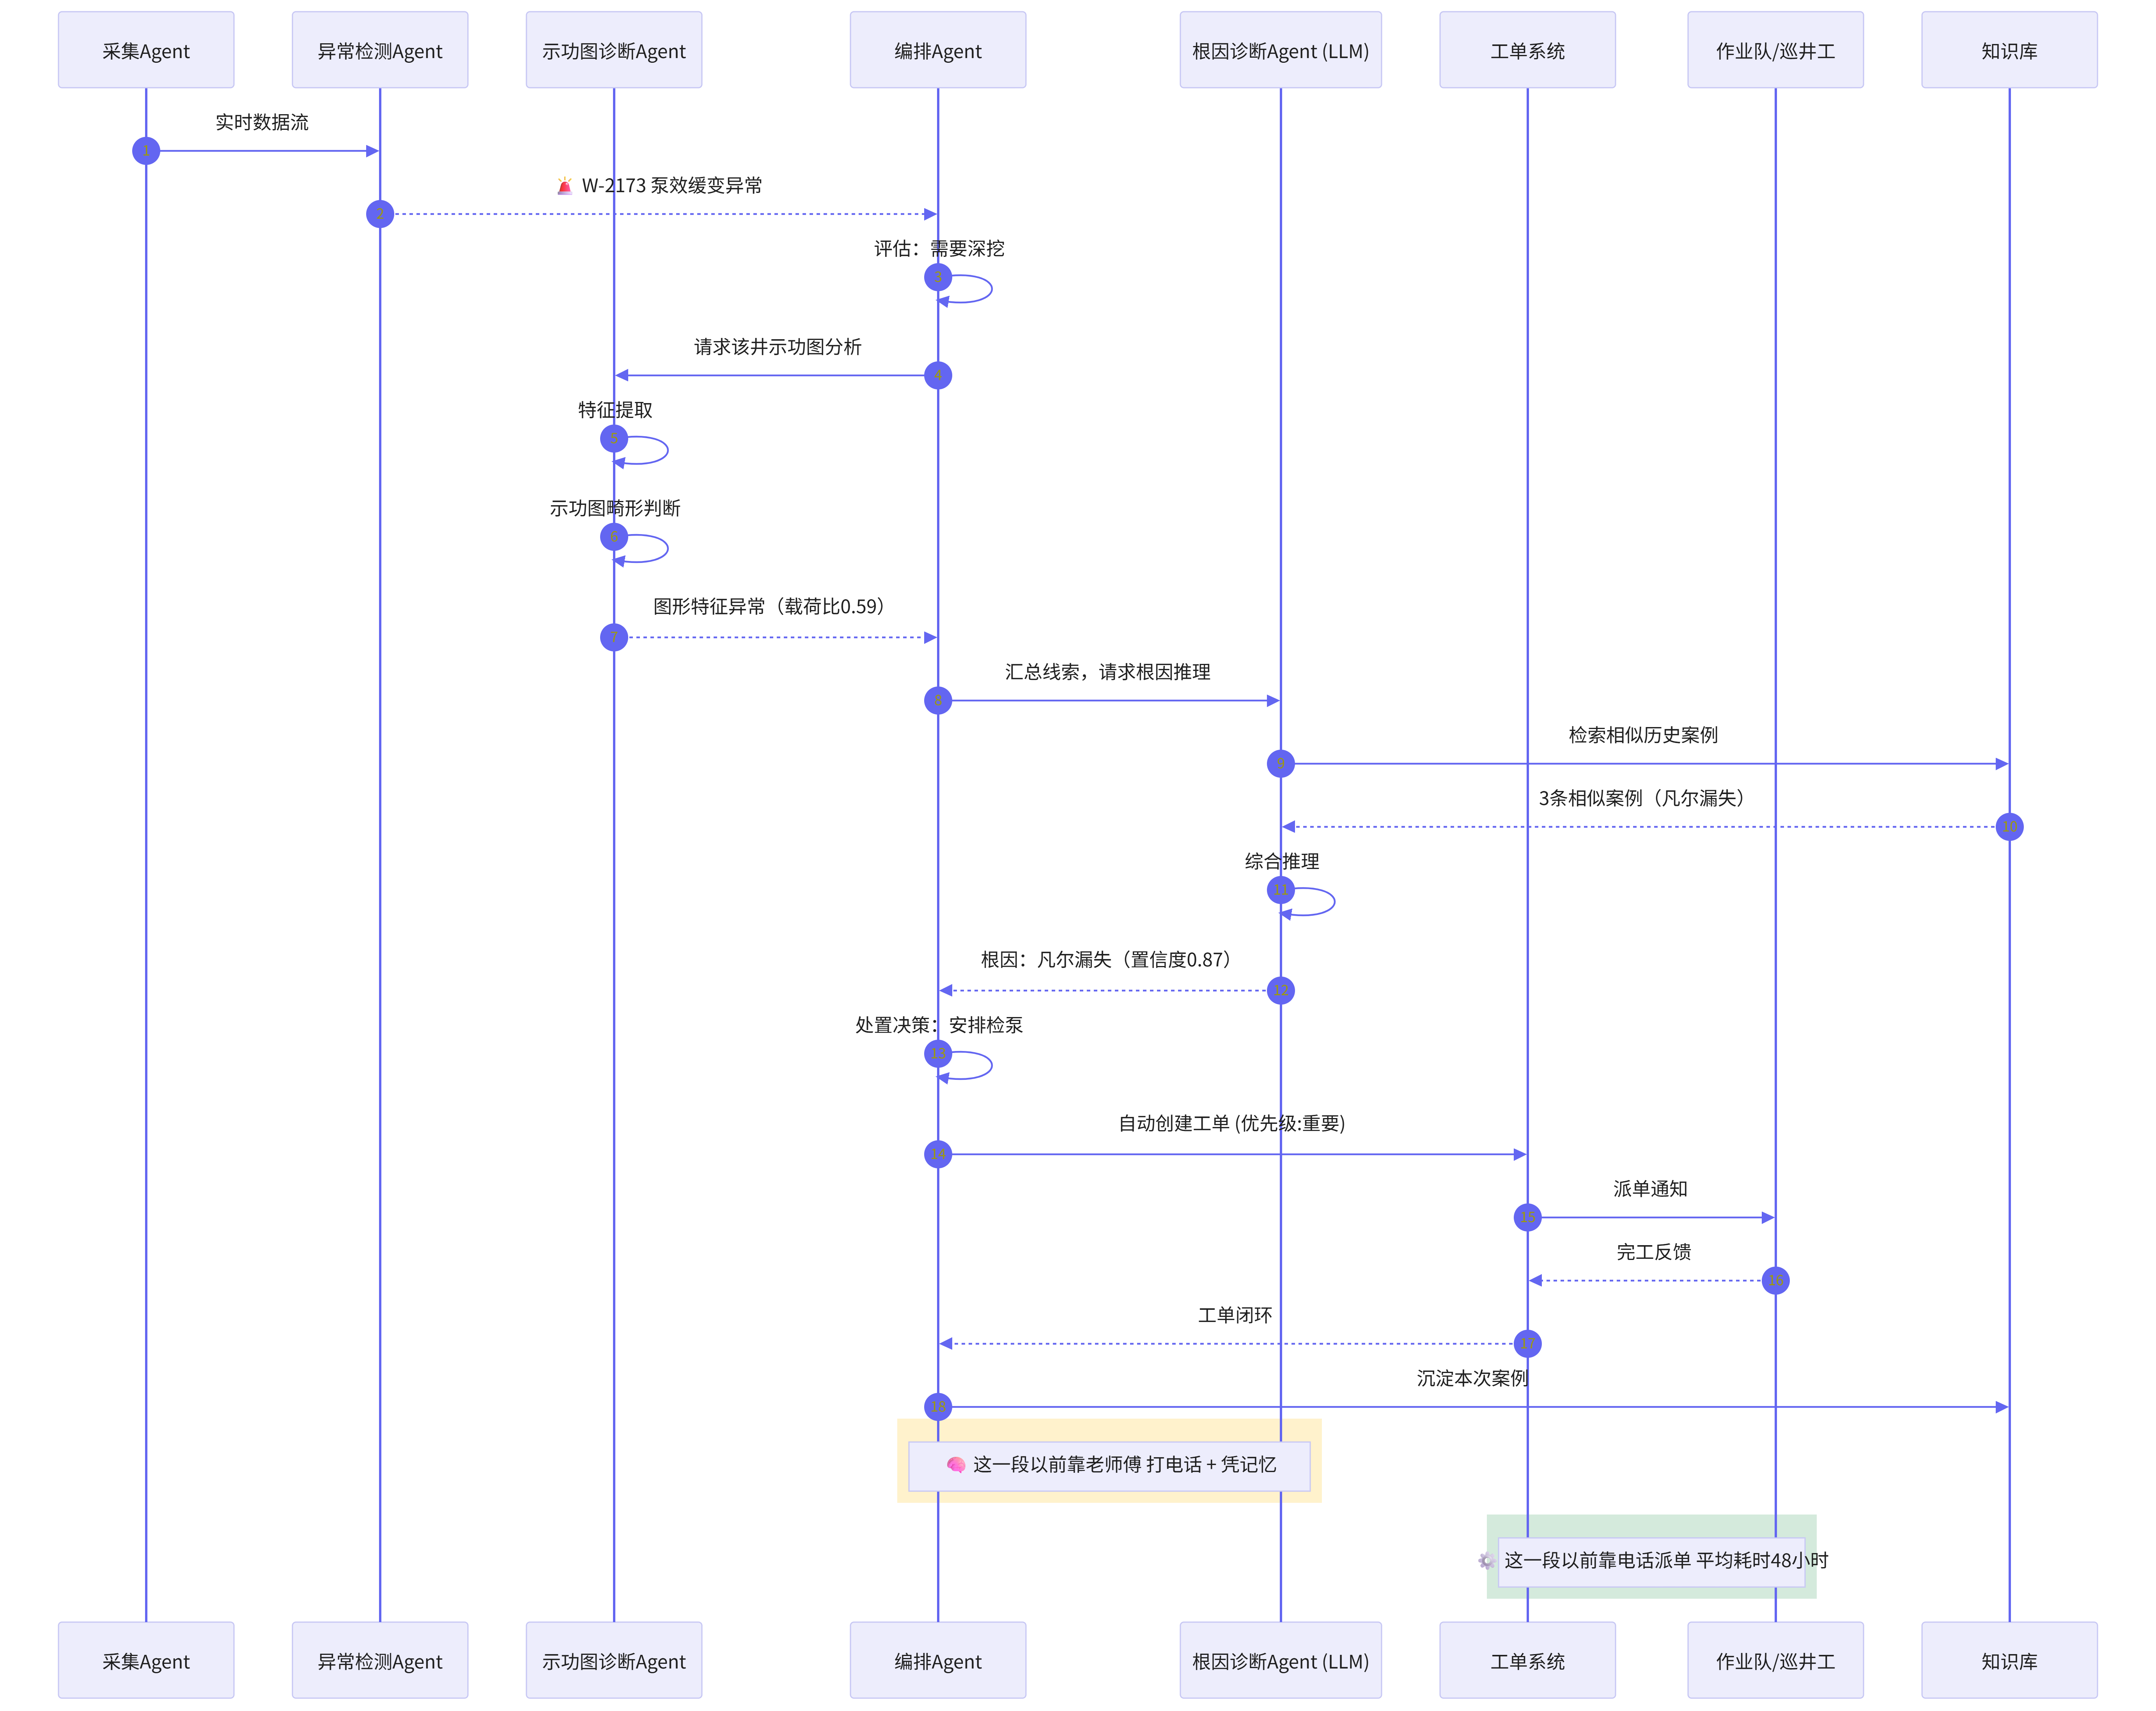
编排 Agent 的核心代码:
import json
import requests
from dataclasses import dataclass
from enum import Enum
from datetime import datetime

class Priority(Enum):
    CRITICAL = "紧急"
    HIGH = "重要"
    NORMAL = "一般"

@dataclass
class DiagnosisResult:
    well_id: str
    root_cause: str
    confidence: float
    evidence: list
    recommendation: str
    priority: Priority

class RootCauseDiagnosticAgent:
    """根因诊断 Agent:多源数据 + 知识库 + LLM 推理"""

    def __init__(self, llm_url, model_name):
        self.llm_url = llm_url
        self.model = model_name

    def diagnose(self, well_id, alarm_context):
        """
        alarm_context 包含多源线索:
        - 异常检测 Agent 的发现
        - 示功图诊断 Agent 的特征
        - 该井的历史工单和检泵记录
        """
        # 1. 检索相似历史案例
        similar_cases = self._search_similar_cases(
            well_id, alarm_context)

        # 2. 构建诊断 prompt
        prompt = f"""你是油田生产故障诊断专家。

井号: {well_id}
时间: {datetime.now().strftime('%Y-%m-%d %H:%M')}

多源异常线索:
{json.dumps(alarm_context, ensure_ascii=False, indent=2)}

历史相似案例:
{json.dumps(similar_cases, ensure_ascii=False, indent=2)}

请综合推理,输出 JSON:
{{
  "root_cause": "根因判断",
  "confidence": 0.0-1.0,
  "evidence": ["证据链"],
  "recommendation": "处置建议(具体到操作层面)",
  "priority": "紧急/重要/一般",
  "estimated_production_loss": "预计日产量损失(t/d)"
}}

推理要求:
1. 证据链要闭环:每条证据都指向根因
2. 如有多种可能,列出最可能的和需要排除的
3. 处置建议要考虑现场可行性"""

        # 3. 调用 LLM 推理
        response = requests.post(
            f"{self.llm_url}/v1/chat/completions",
            json={
                "model": self.model,
                "messages": [{"role": "user", "content": prompt}],
                "temperature": 0.2,
            },
            timeout=90
        )
        result = json.loads(
            response.json()["choices"][0]["message"]["content"])

        return DiagnosisResult(
            well_id=well_id,
            root_cause=result["root_cause"],
            confidence=result["confidence"],
            evidence=result["evidence"],
            recommendation=result["recommendation"],
            priority=Priority(result["priority"])
        )

    def _search_similar_cases(self, well_id, context):
        """从知识库检索相似案例(简化:按故障特征匹配)"""
        # 实际实现用向量检索
        return [
            {"case_id": "C-2025-0412", "well": "W-1998",
             "symptoms": "泵效持续下降+载荷比0.58+沉没度下降",
             "root_cause": "固定凡尔磨损",
             "solution": "检泵更换凡尔总成,恢复泵效85%"},
            {"case_id": "C-2025-0730", "well": "W-2201",
             "symptoms": "泵效渐进下降+图形角部圆滑",
             "root_cause": "游动凡尔漏失",
             "solution": "检泵作业,杆柱优化"},
        ]


class OrchestrationAgent:
    """编排 Agent:总调度,决定叫谁干活、怎么闭环"""

    def __init__(self, diagnostic_agent, ticket_system, notifier):
        self.diagnostic = diagnostic_agent
        self.tickets = ticket_system
        self.notifier = notifier

    def handle_anomaly(self, well_id, anomaly_event):
        """处理一个异常事件:从发现到闭环"""

        # Step 1: 评估严重度,决定处理深度
        if anomaly_event.severity == "info":
            # 低危:记录 + 观察,不惊动人
            self._log_only(anomaly_event)
            return

        # Step 2: 拉取多源数据,做根因诊断
        context = self._gather_context(well_id, anomaly_event)
        diagnosis = self.diagnostic.diagnose(well_id, context)

        # Step 3: 根据置信度和优先级决定自动/人工
        if (diagnosis.confidence >= 0.85 and
                diagnosis.priority != Priority.CRITICAL):
            # 高置信 + 非紧急 → 自动开单
            ticket_id = self.tickets.create(
                well_id=well_id,
                title=f"[AI诊断] {diagnosis.root_cause}",
                description=self._format_report(diagnosis),
                priority=diagnosis.priority.value
            )
            self.notifier.send_to_workgroup(
                f"🤖 自动派单: {well_id} 疑似{diagnosis.root_cause}\n"
                f"置信度: {diagnosis.confidence:.0%}\n"
                f"工单号: {ticket_id}\n"
                f"建议: {diagnosis.recommendation}")
        else:
            # 低置信或紧急 → 人工介入,AI 提供参考
            self.notifier.escalate_to_expert(
                well_id, diagnosis, anomaly_event)

        # Step 4: 记录到知识库(无论自动还是人工)
        self._archive_case(well_id, anomaly_event, diagnosis)

    def _gather_context(self, well_id, anomaly_event):
        """聚合多源上下文"""
        return {
            "anomaly": {
                "metric": anomaly_event.metric,
                "trend": anomaly_event.trend_desc,
                "severity": anomaly_event.severity,
            },
            "card_analysis": "载荷比0.59,图形饱满度0.71,角部圆滑",
            "recent_production": "产液量15.2→11.8 t/d(-22%)",
            "last_pump_check": "428天前",
            "current_status": "运行中,电流正常"
        }

    def _format_report(self, diagnosis):
        return (f"根因: {diagnosis.root_cause}\n"
                f"置信度: {diagnosis.confidence:.0%}\n"
                f"证据链:\n" +
                "\n".join(f"  - {e}" for e in diagnosis.evidence) +
f"\n建议: {diagnosis.recommendation}")这里有个设计决策值得展开说:为什么置信度 0.85 以上才自动派单? 因为误报的代价不对称。漏报一个故障,损失是产量;误派一次作业队,损失是钱 + 信任。前期宁可多让人确认,等系统跑稳了再逐步放开阈值。上线三个月后我们把阈值从 0.9 降到了 0.85,误派率稳定在 2% 以下才敢这么干。
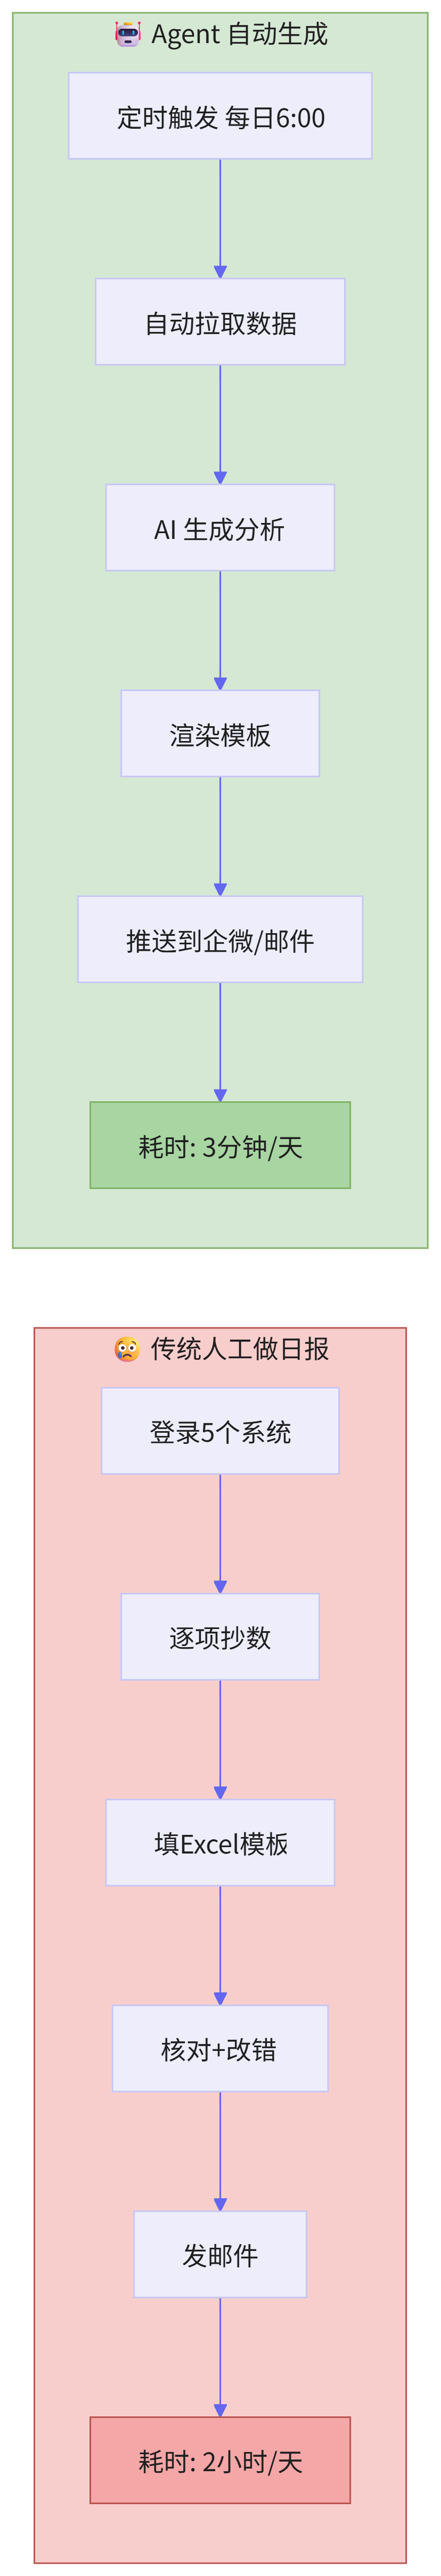
六、场景四:日报自动生成——把"表哥表姐"解放出来
以前中控室每天早上要手工填生产日报:产量数据、异常井况、作业进度,从五个系统里抄数,一干就是俩小时,还容易抄错。
import requests
from datetime import datetime, timedelta

class DailyReportAgent:
    """生产日报生成 Agent"""

    def __init__(self, llm_url, model_name):
        self.llm_url = llm_url
        self.model = model_name

    def generate(self, report_date=None):
        report_date = report_date or datetime.now()

        # Step 1: 拉数据(实际从多个数据源聚合)
        prod_data = self._fetch_production_data(report_date)
        anomaly_data = self._fetch_anomaly_summary(report_date)
        workover_data = self._fetch_workover_status(report_date)

        # Step 2: AI 生成分析结论
        analysis = self._ai_analyze(
            prod_data, anomaly_data, workover_data)

        # Step 3: 渲染报告
        return self._render_report(
            report_date, prod_data, anomaly_data,
            workover_data, analysis)

    def _ai_analyze(self, prod, anomaly, workover):
        prompt = f"""根据以下油田生产数据,生成日报分析要点。

当日产量: 全厂 {prod['total_liquid']:.0f} t/d 液量,"
          {prod['total_oil']:.0f} t/d 油量
环比变化: 液量 {prod['liquid_change']:+.1f}%,油量 {prod['oil_change']:+.1f}%
开井数: {prod['wells_open']}/{prod['wells_total']}

当日异常: {anomaly['count']} 起
{chr(10).join(f'  - {a}' for a in anomaly['details'])}

作业进度:
{chr(10).join(f'  - {w}' for w in workover['details'])}

请输出(总共不超过200字):
1. 今日核心结论(1-2句话,抓重点)
2. 需要关注的事项(按优先级,最多3条)
3. 明日风险预警(如有)

风格要求:直接、专业、不废话。像发给厂长的微信,不是写论文。"""

        response = requests.post(
            f"{self.llm_url}/v1/chat/completions",
            json={
                "model": self.model,
                "messages": [{"role": "user", "content": prompt}],
                "temperature": 0.3,
            },
            timeout=60
        )
        return response.json()["choices"][0]["message"]["content"]

    def _fetch_production_data(self, date):
        """拉取产量数据(示意)"""
        return {
            "total_liquid": 2847, "total_oil": 623,
            "liquid_change": -1.8, "oil_change": -2.4,
            "wells_open": 286, "wells_total": 301,
        }

    def _fetch_anomaly_summary(self, date):
        """拉取异常汇总(示意)"""
        return {
            "count": 5,
            "details": [
                "W-2173 泵效缓降,AI诊断凡尔漏失,已派单待检泵",
                "W-3091 电机温度缓升,已处理(更换散热风扇)",
                "W-1187 间歇出液,疑似供液不足,加密观察中",
                "注水站P-2泵压力波动,已切换备用泵",
                "W-2244 视频识别停机,确认电网瞬时波动,已自动重启",
            ]
        }

    def _fetch_workover_status(self, date):
        """拉取作业进度(示意)"""
        return {
            "details": [
                "W-1998 检泵作业完成,恢复生产,泵效回升至83%",
                "W-2201 检泵中,预计明日完工",
                "计量站M-15 流量计标定,影响计量4小时",
            ]
        }

    def _render_report(self, date, prod, anomaly, workover, analysis):
        """渲染最终报告"""
        return f"""
📅 采油三厂生产日报 {date.strftime('%Y-%m-%d')}

━━━ 产量概况 ━━━
液量: {prod['total_liquid']:.0f} t/d({prod['liquid_change']:+.1f}%)
油量: {prod['total_oil']:.0f} t/d({prod['oil_change']:+.1f}%)
开井: {prod['wells_open']}/{prod['wells_total']}

━━━ AI 分析要点 ━━━
{analysis}

━━━ 异常与处置 ━━━
{chr(10).join('• ' + a for a in anomaly['details'])}

━━━ 作业进度 ━━━
{chr(10).join('• ' + w for w in workover['details'])}

—— 本报告由生产监控 Agent 自动生成
"""


# ===== 每天早上 6 点自动执行 =====
agent = DailyReportAgent("http://localhost:8000", "qwen2.5-32b")
report = agent.generate()
print(report)

# 输出示例:
# 📅 采油三厂生产日报 2026-09-13
#
# ━━━ 产量概况 ━━━
# 液量: 2847 t/d(-1.8%)
# 油量: 623 t/d(-2.4%)
# 开井: 286/301
#
# ━━━ AI 分析要点 ━━━
# 1. 核心结论: 油量环比下降2.4%,主因W-2201检泵停井及W-2173
#    泵效下降,合计影响约15 t/d,属计划内波动。
# 2. 需关注: W-1187间歇出液趋势需持续观察,若48小时内泵效
#    再降10%建议安排功图核实。
# 3. 明日风险: W-2201检泵完工后需关注复产井泵效恢复情况。
七、落地效果:半年后的数字
上了这套系统半年,几个关键指标的变化:
指标 | 改造前 | 改造后 | 变化 |
|---|---|---|---|
异常发现到派单耗时 | 平均 48 小时 | 平均 15 分钟 | ↓ 99% |
缓变故障漏检率 | 高(基本靠运气) | < 5% | 质变 |
中控室值班人数/班 | 3 人 | 1 人(管 Agent) | ↓ 67% |
日报制作耗时 | 2 小时/天 | 3 分钟(人只审核) | ↓ 97% |
示功图分析覆盖 | 每月抽检 20% | 每日全量 100% | 质变 |
检泵周期平均延长 | — | +38 天 | 提效 |
最值钱的是最后两行:全量分析 + 检泵周期延长。以前检泵是"坏了才修",现在能提前两周预判,作业计划可以排产优化,一年下来检泵作业费省了小几百万。
八、踩过的坑,给你排个雷
坑 1:井场数据质量远比想象的差。 RTU 断线、传感器漂移、时间戳乱跳,第一天上线就有 20% 的数据是脏的。后来专门加了个数据质量 Agent,先洗数据再喂给下游。垃圾进垃圾出,这条在油田尤其成立。
坑 2:示功图诊断不能全信 AI。 AI 说"凡尔漏失 置信度 0.87",但实际检泵发现是杆柱偏磨。老师傅的经验里有很多"只可意会"的东西,AI 需要持续喂案例才能逼近。我们的做法是每次检泵结果都回填到知识库,让系统越用越准。
坑 3:老师傅一开始是抵触的。 有人觉得"这是要替代我"。后来我们发现让老师傅当 Agent 的"教练"——审核 AI 诊断、标注对错——他的经验反而更值钱了。定位很重要:AI 是徒弟,老师傅是师傅,别把关系搞反了。
坑 4:告警还是要收敛。 就算有了 Agent,告警风暴照样会发生。编排 Agent 里做了告警合并:同一口井 5 分钟内所有告警合并成一个事件再诊断,值班员手机终于安静了。
坑 5:无人值守≠没有人。 现场设备总要有人的时候——换皮带、处理跑冒滴漏这些活儿 Agent 干不了。我们做到的是"少人值守 + 远程决策",宣传的时候别吹大了,否则验收的时候很难受。
回头看这一年,最大的感悟是:Agent 重构监控体系,本质不是替换人,而是重新分工。 以前中控室的人干的是"眼睛"的活——盯屏、抄数、打电话;现在这些活儿交给了 Agent,人去干"大脑"的活——审 AI 的诊断、定处置的策略、沉淀经验的知识库。
盯屏时代落幕了,但监控这个事情本身没有落幕——它只是从"人肉循环"升级成了"数据循环"。屏幕还在那儿,只是不用人盯着了。
油田这个行业看着传统,其实数字化的空间大得很。谁能把这些重经验的场景一个个啃下来,谁就能真正把技术落地成生产力。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号