同样的重构需求,两个 AI 编程工具 Token 差了 70 倍,问题不在模型
原创
同样的重构需求,两个 AI 编程工具 Token 差了 70 倍,问题不在模型
原创
GavinGeng
发布于 2026-09-15 14:39:30
发布于 2026-09-15 14:39:30
我之前一直有个错觉,以为 AI 编程贵不贵,全看选了哪个模型。
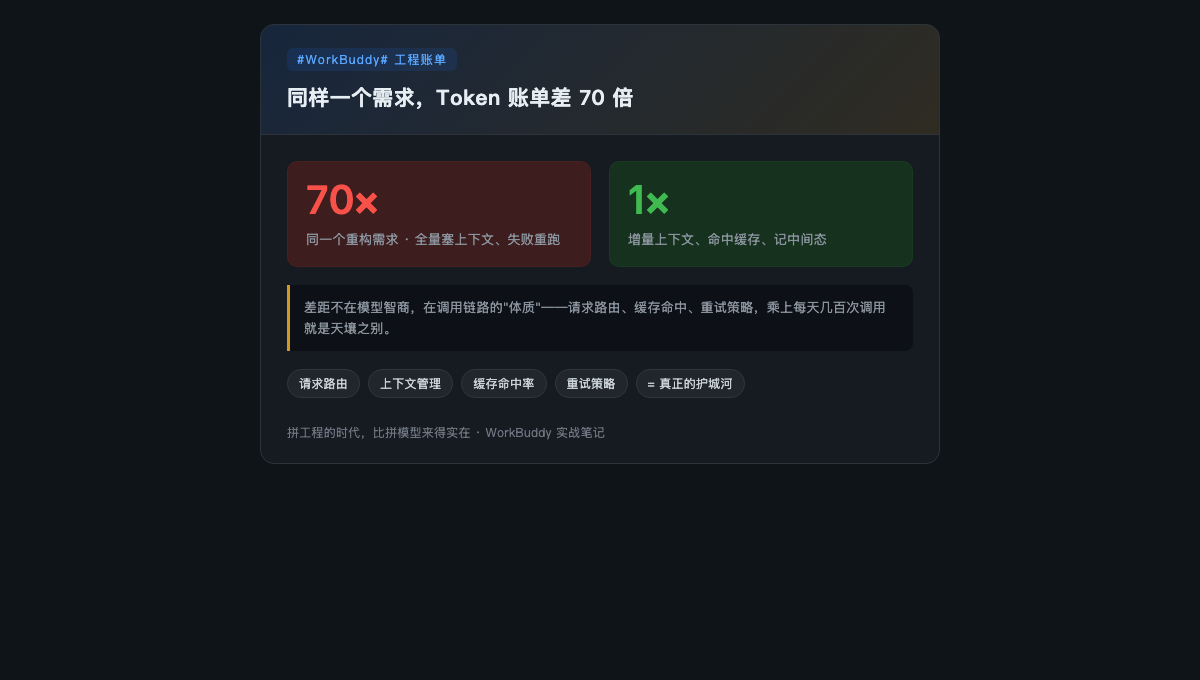
直到上周我拿一个几乎相同的重构需求,跑了两个不同的编程工具,账单出来我愣了——同样的活儿,Token 消耗差了快 70 倍。不是模型能力差了 70 倍,是工程细节差了 70 倍。
差距藏在哪?不在模型,在这些看起来很"底层"的地方:请求路由怎么走、上下文怎么管、缓存命中率多少、失败怎么重试。
一个工具把整个对话历史每次全量塞进 prompt,另一个只在必要时带增量;一个每次失败都从头重跑,另一个记住了中间态;一个对重复提问照样再算一遍,另一个命中了上次的缓存直接返回。这些单看都是"小事",但乘上每天几百次调用,就是账单的天壤之别。
所以我现在的判断很直接:对成本影响最大的,往往不是你选了多聪明的模型,而是你这套调用系统的"体质"。我们老盯着模型智商比来比去,其实真正吃钱的是请求链路有没有被精细化管理。
甚至我怀疑,不少公司上 AI 之后没赚到预期的钱,不是模型选错了,是工程化能力跟不上,被隐形成本一点点吃掉——账单上每一笔都合理,加起来却远超预算,还找不到是哪一笔。
(这个坑挺隐蔽,建议先收藏,后面我把"省 Token 的工程清单"单独整理一篇。)
我押一个观点:接下来拼的不是谁模型更猛,是谁把工程链路管得更细。模型会越来越便宜,但乱调用的代价不会自己消失。
你有没有被某次 AI 账单吓到过?是模型真贵,还是调用方式的问题?评论区说说你的经历——我挑几个典型的,整理一份"省 Token 工程清单"发出来,看看大家踩坑的重灾区到底在哪。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号