集群、分布式与微服务关系解析与选型决策路径
原创
集群、分布式与微服务关系解析与选型决策路径
原创
数据库研究员
发布于 2026-09-15 15:28:51
发布于 2026-09-15 15:28:51
搜索「集群与分布式区别」的人,真正想解决的问题往往是「这套系统,到底该加机器,还是该拆」。本文先把结论放在前面,再逐个回答常见问题。
一、结论前置
集群是「物理形态」——多台机器抱团、对外像一台;分布式是「工作方式」——把任务和数据拆到多节点协作;微服务是分布式思想在「应用层」的一种落地。三者不在同一个维度,却经常叠加出现。
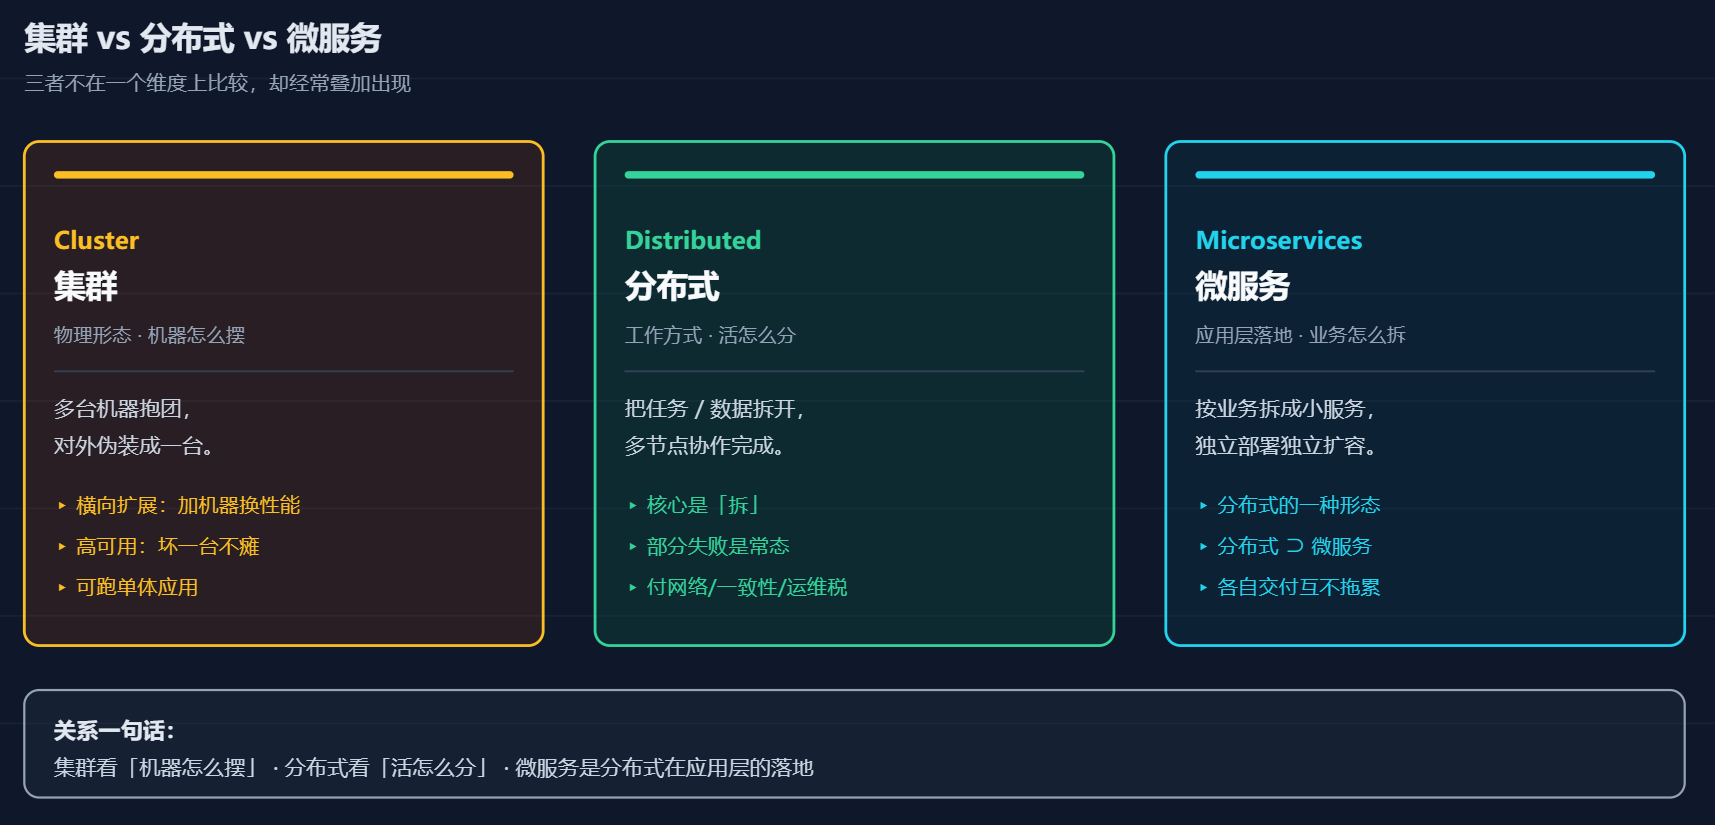
维度 | 集群 | 分布式 | 微服务 |
|---|---|---|---|
关注点 | 机器怎么摆 | 活/数据怎么拆 | 业务怎么拆 |
核心目标 | 横向扩展、高可用 | 协作完成单机完不成的任务 | 独立开发、独立部署、独立扩容 |
是否拆数据 | 通常不拆 | 通常拆 | 按业务拆服务 |
典型形态 | 主备、主从、共享存储 | 分库分表、分布式数据库 | 微服务架构 |
打个比方 | 一条流水线多招几人 | 把大项目拆给几个小组 | 每个小组只负责一个独立模块 |
二、什么是集群?
集群(Cluster) 是多台独立计算机通过网络互联,协同工作、对外呈现为单一逻辑系统的计算架构。价值主要有两点:
- 横向扩展:用「加机器」替代「换更贵机器」;
- 高可用:一台节点挂了,别的节点能接住,系统不瘫。
关键认知:集群里跑的可以是单体应用。一个一主一备的数据库集群,应用还是原来那套单机程序,只是多了个兜底的备机。
国产数据库在集群这块的落地已经挺成熟了——例如金仓 KingbaseES 的共享存储集群和读写分离集群,自动故障转移、防脑裂、数据强一致都是开箱即用,政务和金融项目里跑得比较多。这也是「集群」思想在信创场景下的典型实践。
三、什么是分布式?
分布式系统(Distributed System) 是一组通过网络通信协作的自治节点,共同完成统一任务。本质是「拆」——把数据、计算或功能拆到多个节点上。代价也很明确:部分失败是常态、网络延迟无上界、节点时钟对不齐,所以分布式系统的所有架构决策,本质上都是一系列权衡(CAP、BASE 这些理论就是为这些权衡服务的)。
四、集群与分布式有什么区别?
这是最核心的一问。区别不在「好坏」,在「维度」:
- 集群描述部署形态:几台机器、怎么连、谁兜底;
- 分布式描述协作方式:任务拆不拆、数据拆不拆、节点间怎么协调。
对比项 | 集群 | 分布式 |
|---|---|---|
本质 | 物理部署形态 | 逻辑协作模式 |
解决什么 | 机器够不够、会不会瘫 | 数据和活能不能拆 |
数据 | 通常不拆,多节点冗余 | 通常拆,按分片分布 |
节点间通信 | 较少,重点是故障切换 | 频繁,需协调一致 |
典型例子 | 主从复制、主备 | 分库分表、分布式事务 |
一句话:集群看「机器怎么摆」,分布式看「活怎么分」。两者经常叠加——一个分库分表的集群,既是分布式又是集群。
五、什么是微服务?微服务和分布式什么关系?
微服务(Microservices) 是按业务边界,把一个应用拆成一组独立开发、独立部署、独立扩缩容的小服务。它的关系是:微服务是「分布式思想」在应用层的一种具体落地,分布式是个更大的筐,还装得下分布式数据库、分布式计算、分布式缓存等;微服务只是「应用拆服务」这一种形态。
所以「微服务 = 分布式」是错的,但「微服务一定是分布式架构的一种实现」是对的。
六、选型决策树:该集群还是该分布式
按下面这棵树走,基本不会跑偏:
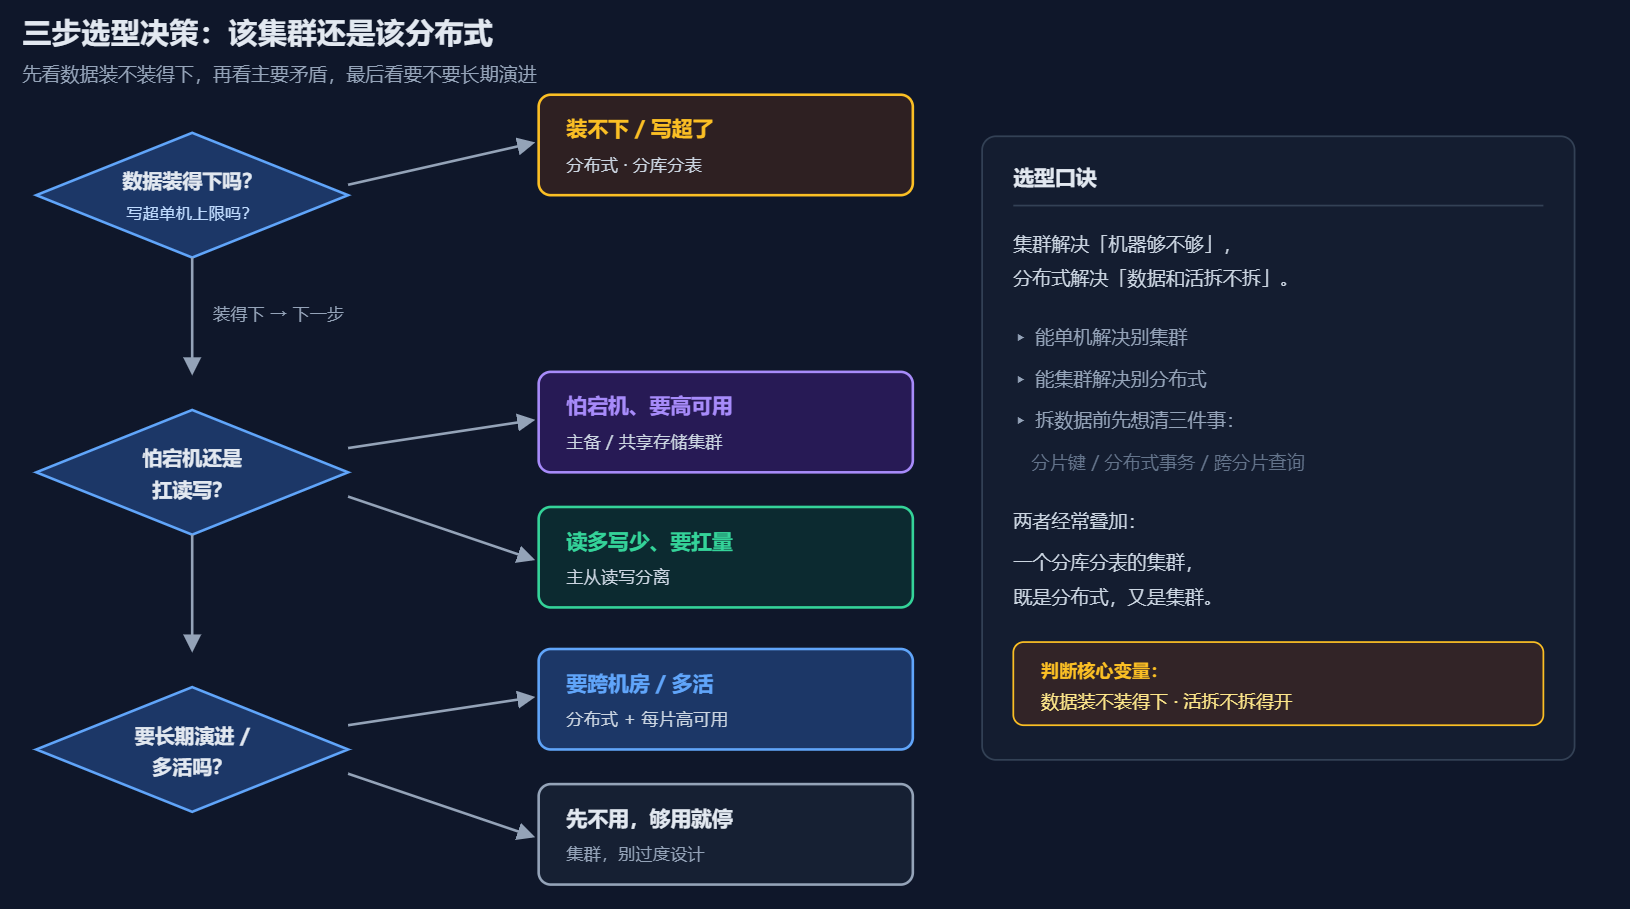
第一步:数据装得下吗?写入超单机上限了吗?
  ├─ 装得下、没超 → 第二步
  └─ 装不下 / 写入超了 → 走分布式(分库分表)

第二步:主要矛盾是「怕宕机」还是「扛读写」?
  ├─ 怕宕机、要高可用 → 主备 / 共享存储集群
  └─ 读多写少、要扛量 → 主从读写分离

第三步:要不要长期演进、跨机房多活?
  ├─ 要 → 分布式 + 每片高可用(集群叠加)
  └─ 不要 → 先集群,够用就停
七、FAQ:高频长尾问题速答
Q1:集群与分布式哪个更高级?
A:没有高级低级之分,只有合不合适。分布式要付网络、一致性、运维三重成本,能用集群解决的别硬上分布式。
Q2:主从复制算分布式吗?
A:不算。主从是集群的常见形态,数据没拆、节点间没有多节点协作计算,属于「多机冗余 + 读写分离」。
Q3:一个集群里可以跑单体应用吗?
A:可以,而且很常见。一主一备数据库 + 单体应用,就是「集群但不是分布式」。
Q4:分布式系统可以只部署在一台机器上吗?
A:可以。开发测试时,多个逻辑分片、多个服务可以落在同一台机器上,设计上仍是分布式。
Q5:CAP 定理跟集群、分布式什么关系?
A:CAP 是分布式系统的理论约束——分区容错(P)不可放弃,实际是在 C(一致性)和 A(可用性)之间选边。集群如果不拆数据、不强一致多节点写,通常不直接面对 CAP 的选择。
Q6:上分布式之前,最该先想清楚什么?
A:三件事——数据怎么拆(分片键)、跨节点事务怎么处理(2PC/TCC/SAGA)、跨分片查询怎么做。想不清这三件,别拆。
八、速查表:照着对号入座
我的场景 | 选哪个 |
|---|---|
单机 CPU/内存/连接数不够,数据装得下 | 集群(加节点) |
怕宕机、要故障自动切换 | 主备 / 共享存储集群 |
读多写少,读压力大 | 主从读写分离 |
数据装不下、写入超单机上限 | 分布式(分库分表) |
应用要独立开发部署、按业务拆 | 微服务 |
拆完还要防单点 | 分布式 + 每片高可用 |
记住一句话:集群解决机器够不够,分布式解决数据和活拆不拆,微服务解决业务怎么拆。选型时先看数据装不装得下、活拆不拆得开,答案自然就出来了。
本文基于生产环境实战总结,欢迎交流。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号