集群与分布式三个关键边界:从一次数据库扩容实战谈起
原创
集群与分布式三个关键边界:从一次数据库扩容实战谈起
原创
数据库研究员
发布于 2026-09-16 10:00:22
发布于 2026-09-16 10:00:22
昨天讲了集群、分布式和微服务 之前的关系与区别,今天想给大家再补充一点。
数据库扩容时,一个常见误区是「加机器就能解决一切」。曾有一个订单库,峰值写入把单机 IO 打满,加了两台机器做主从复制后,写入依然卡顿——因为瓶颈不在机器数量,而在「所有写都压在同一张主库上」,从库再多也只能摊薄读。
这件事引出一个关键判断:集群与分布式这两个词,多数人背得下结论,但没搞清楚它们之间的边界。本文用一次真实的扩容过程,把三个边界讲透。
一、先纠正一个流行说法
网上流传最广的一句话是:「集群是一堆人干同一件事,分布式是一堆人干不同的事。」
这句话好记,但不准确,而且会误导架构决策——它把「集群」和「分布式」描述成两个并列、二选一的东西。真实系统里,这两者经常是叠加的:一个分库分表的数据库集群,既是分布式(数据拆了),又是集群(多节点对外一体)。
更准确的表述是:
集群是「部署形态」——多台机器怎么摆;分布式是「协作方式」——任务和数据怎么拆。两者不在一个维度上比较。
二、三个真正要命的边界
边界一:物理形态 ≠ 工作方式
一个集群里,跑的可以是单体应用。不少生产系统就是「一主一备的数据库 + 一个单体应用」:它是集群(多机器),但不是分布式(没拆活、没拆数据)。
反过来,一个分布式系统也可以先在单机上跑起来——本地搭的分库分表 demo,几个逻辑分片落在同一台机器上,设计上依然是分布式。
判断一个系统是不是分布式,不看它有几台机器,看它有没有「拆」。
边界二:集群解决「可用性和机器」,分布式解决「数据和协作」
这是架构选型的根:
- 集群能给的,是横向扩展和高可用——加机器、坏一台不瘫;
- 分布式能给的,是把装不下的数据、拆不完的活,摊到多节点上协作完成。
回到开头那个订单库:瓶颈是「单库写入上限」,这是数据层面的墙,加机器做主从(集群思路)越不过这堵墙。最后是分了库、分了表,把写入拆到多张表、多个节点上(分布式思路),才真正解决。
边界三:分布式要付「三重税」
分布式不是升级,是换一套代价:
- 网络税:节点间要通信,网络不可靠、延迟无上界,这是分布式系统一切复杂性的来源;
- 一致性税:数据拆开了,跨节点的强一致要么贵、要么慢,CAP 就是在逼你选边;
- 运维税:节点变多,故障概率指数上升,脑裂、主从延迟、跨分片查询这些新问题全都冒出来。
能用集群解决的,别上分布式;非拆不可的,才值得付这三重税。
三、真实案例:一次扩容是怎么从「集群」走到「分布式」的
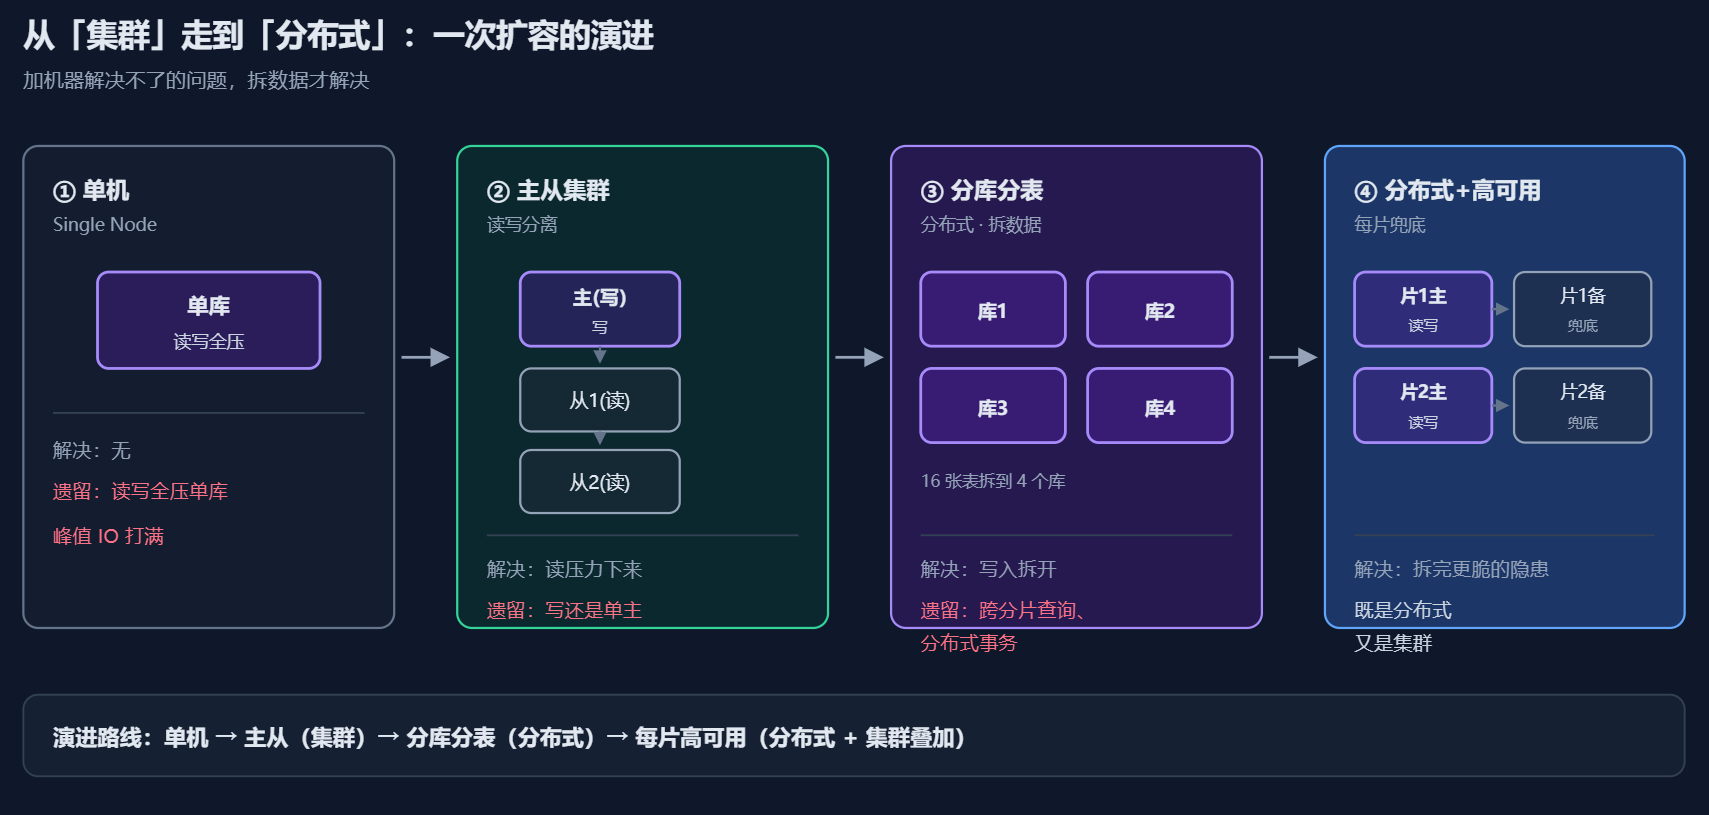
那次订单库扩容的完整演进路径如下:
阶段一:单机扛不住,先做主从(集群)
一主两从,读写分离,读压力下来了。但写还是打在单张主库上,峰值一上来照样卡。这一步解决的是「读多写少」的摊薄,没解决「写」的瓶颈。
阶段二:写入还是爆,上分库分表(分布式)
把订单表按「用户 ID」哈希拆成 16 张表、落到 4 个库。写入压力被拆开了,单库终于不再 100%。但新问题立刻冒出来:跨分片查询不能直接 JOIN,得改查询逻辑或上中间件;订单和用户分属不同库,原来一个事务能搞定的操作,现在要上分布式事务——2PC 太重,最后按业务场景用了 TCC,为关键的扣库存、生成订单两个动作做了 Try/Confirm/Cancel。
阶段三:分片之后还要高可用(分布式 + 集群叠加)
每个分片库都配了主备,防止「拆完更脆」——一个分片挂了,至少还有备机接。这时候这套系统,就同时是「分布式」(数据拆了)又是「集群」(每片都多节点高可用)。
国产数据库在集群这块的落地已经比较成熟——例如金仓数据库 KingbaseES 的共享存储集群、读写分离集群,自动故障转移、防脑裂、数据强一致都是默认能力,政务和金融项目用得比较多,不需要再像这套系统当年那样逐块拼接。
四、什么时候上集群,什么时候上分布式
把边界落到判断标准上,一般这样问:
先上集群,如果:
- 数据量单机装得下,只是 CPU/内存/连接数不够;
- 读压力大、写压力一般 → 主从读写分离;
- 要的是高可用,怕单点宕机 → 主备 / 共享存储集群。
必须上分布式,如果:
- 单机/单库装不下数据,或写入吞吐超过单机上限 → 分库分表;
- 业务本身能按边界拆成多个独立服务 → 微服务化;
- 跨机房、跨地域要多活 → 分布式 + 就近访问。
先别上分布式,如果:
- 业务量还小、增长可预期——过度设计是最大的坑;
- 团队还没准备好处理分布式事务、跨分片查询、脑裂这些新问题。
判断的核心变量始终是两个:数据装不装得下、活拆不拆得开。
五、踩坑清单
「集群转分布式」过程中的高频踩坑点:
- 误以为加机器能解决一切:写瓶颈、热点问题,加机器无效,得拆;
- 拆完数据忘了高可用:分片越多、单点越多,每个分片都要兜底,否则拆完更脆;
- 分布式事务没想清就上线:2PC 一把梭导致性能问题,最后改 TCC/SAGA 返工;
- 跨分片查询没规划:拆完才发现核心报表要全表扫,又得上数据仓库或宽表;
- 主从延迟没当回事:读写分离后从库读到旧数据,一致性敏感场景要做「强制走主库」;
- 脑裂没防:主备切换时网络闪断出现双主,靠 Quorum 机制 + fencing 才压住。
现象/信号 | 大概原因 | 先查什么 |
|---|---|---|
加机器后写还卡 | 单库/单表写入上限 | 写 QPS、单库 IO、热点表 |
分片后查询变慢 | 跨分片 JOIN | 查询是否跨分片键、中间件路由 |
读写分离读到旧数据 | 主从延迟 | 延迟监控、敏感场景强制走主 |
切换时出现双主 | 脑裂 | Quorum、fencing、心跳网络 |
分片后事务失败 | 跨节点事务 | 分布式事务方案(TCC/SAGA/2PC) |
六、复盘:一句话记住这件事
集群解决「机器够不够」,分布式解决「数据和活拆不拆」,而架构设计的功夫,在于知道什么时候该停在集群、什么时候必须往前走一步。
那次订单库最终活下来的方案,不是「一步到位的分布式」,而是「主从 → 分库分表 → 每片高可用」这样一步步被业务逼出来的。这大概也是集群和分布式最诚实的打开方式——它不是一个概念选择题,是一张随着业务一起长大的路线图。
本文基于生产环境实战总结,欢迎交流。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号