集群与分布式怎么选?三步决策清单从瓶颈识别到架构落定
原创
集群与分布式怎么选?三步决策清单从瓶颈识别到架构落定
原创
李白客
发布于 2026-09-17 14:42:54
发布于 2026-09-17 14:42:54
集群和分布式怎么选,是数据库架构设计绕不开的第一问。本文给一套可直接执行的判断方法:先用三个硬指标判断「该不该上分布式」,再用三步清单把架构落定,最后看清三条技术路线各自的边界。
一、先判断:该不该上分布式
在谈架构之前,先用三个硬指标过滤:
维度 | 集中式大概率够用 | 认真考虑分布式 |
|---|---|---|
数据量 | 单表千万级以内、总量 10TB 以内 | 单表上亿、总量 50TB 以上 |
并发 | QPS 万级以内 | QPS 5 万以上且持续增长 |
高可用 | 可接受分钟级恢复 | RPO=0、RTO 秒级 |
规则很简单:三个问题至少两个回答「是」,才值得认真考虑分布式。 多数场景连第一个「是」都够不着。
二、三步决策清单
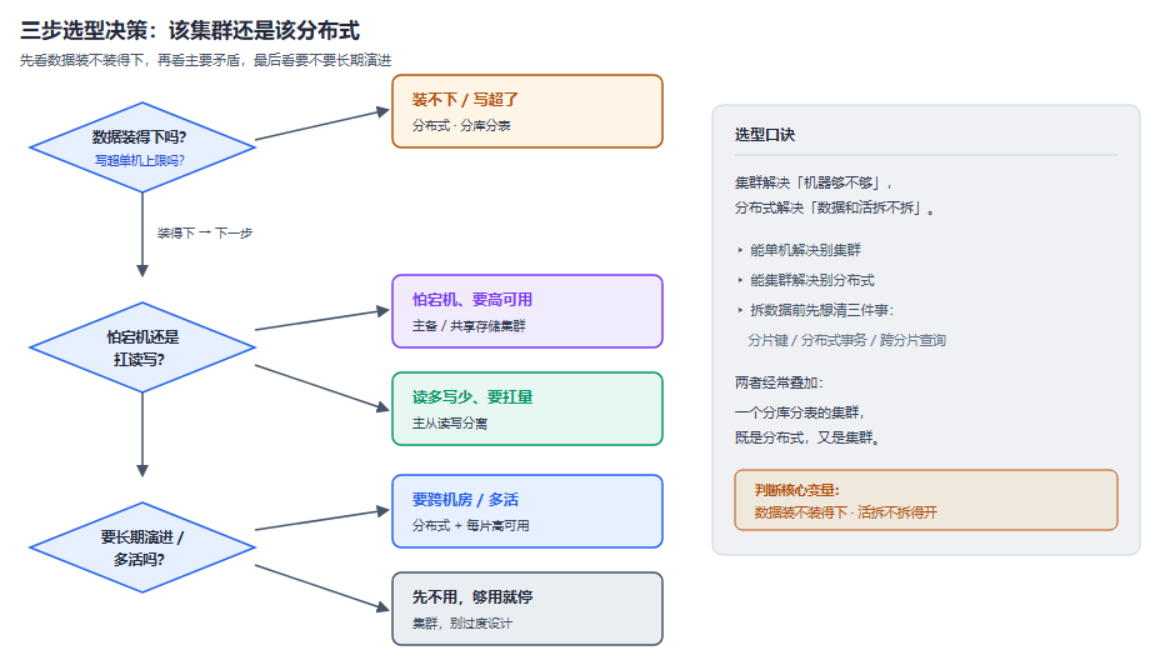
第一步:瓶颈是「机器扛不住」还是「数据扛不住」?
- 单机 CPU/内存/连接数不够,数据装得下 → 走集群,加节点/加备机。
- 数据量大到单机装不下,写入吞吐超单机上限 → 走分布式,拆数据。
第二步:第一目标是「高可用」还是「高吞吐」?
- 怕宕机、要自动切换 → 主备 / 共享存储,盯 RPO/RTO。
- 要扛海量读写 → 主从读写分离(读多)或分片(写多)。
第三步:数据要不要拆?
- 不拆 → 主备 / 主从 / 共享存储里选一个。
- 拆 → 分片,并准备好接分布式事务、跨分片查询这两个新麻烦。
三、三条技术路线怎么落
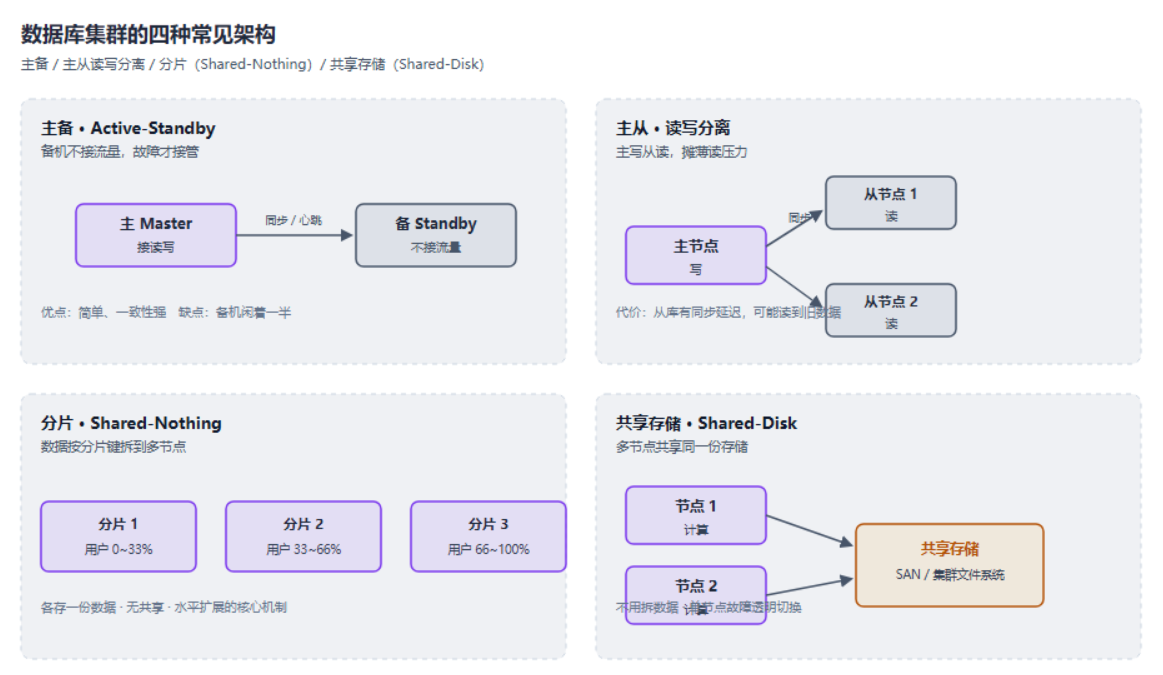
- 分库分表中间件(如 ShardingSphere、MyCat):成本低、平滑起步,但分布式事务、跨片查询要自己扛。
- 原生分布式数据库:强一致、弹性好,靠 Paxos/Raft 做到 RPO=0,门槛和成本最高;信创侧金仓数据库 KES Sharding属此类。
- 共享存储集群:不拆数据、强一致、故障透明切换,适合 TB 级强一致 OLTP;金仓数据库共享存储集群、Oracle RAC 走这条线。
四、落地避坑:三个最常见的翻车点
判断和路线都定了,落地才是真正开始。三个坑,几乎每个上分布式的团队都会遇到:
坑一:分片键选错,扩了等于没扩。 分片键必须跟真实查询模式对齐——按用户 ID 拆,却天天按订单号跨片查,就是典型反例。先摸清访问模式,再定分片键,并把跨片查询压到最少。
坑二:跨分片 JOIN 把性能吃光。 数据拆开后,原来一条 SQL 能做的关联,现在要跨节点拉数据。能冗余的字段就冗余,能压成宽表的就压宽表,把 JOIN 留在分片内解决。
坑三:分布式事务方案没提前选。 跨分片写入绕不开 2PC、TCC、SAGA 的取舍——2PC 强一致但阻塞重,TCC 性能好但侵入业务,SAGA 最终一致但要有补偿。上线前先定方案,别等出了脏数据再补。
五、选型口诀与落地清单
选型核心不是「够不够快」,而是 「扩不扩得动、稳不稳得住」。上线前过一遍这份清单:
- 三个硬指标至少两个「是」,才上分布式
- 分片键与真实查询模式对齐
- 跨片 JOIN 已降到最少(或已冗余 / 宽表化)
- 分布式事务方案已定(2PC / TCC / SAGA)
- 能单机解决的别集群,能集群解决的别分布式
把瓶颈识别清楚,架构自然落定。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号